

오픈AI, 실험실 데이터 벤치마크 공개
오픈AI가 리고와 함께 웻랩 과제 100개로 AI 에이전트의 실험 데이터 해석 능력을 재는 BioBasicsBench 를 내놓았다. GPT-6 Astra 가 66.7%로 1위였지만 콜로니 선택과 개수 세기에서 틀린 사례도 함께 공개됐다.
50
태그
오픈AI가 리고와 함께 웻랩 과제 100개로 AI 에이전트의 실험 데이터 해석 능력을 재는 BioBasicsBench 를 내놓았다. GPT-6 Astra 가 66.7%로 1위였지만 콜로니 선택과 개수 세기에서 틀린 사례도 함께 공개됐다.
오픈AI가 취약점 탐색과 익스플로잇 검증 성능을 끌어올리고 범위 준수 훈련을 더한 GPT-6 Cyber를 데이브레이크 레드 고객 일부에게 공개했다. 익스플로잇짐 점수는 48.5%로 전작보다 상대적으로 51% 높고, 범위 밖 서비스 회피율은 99.93%였다.
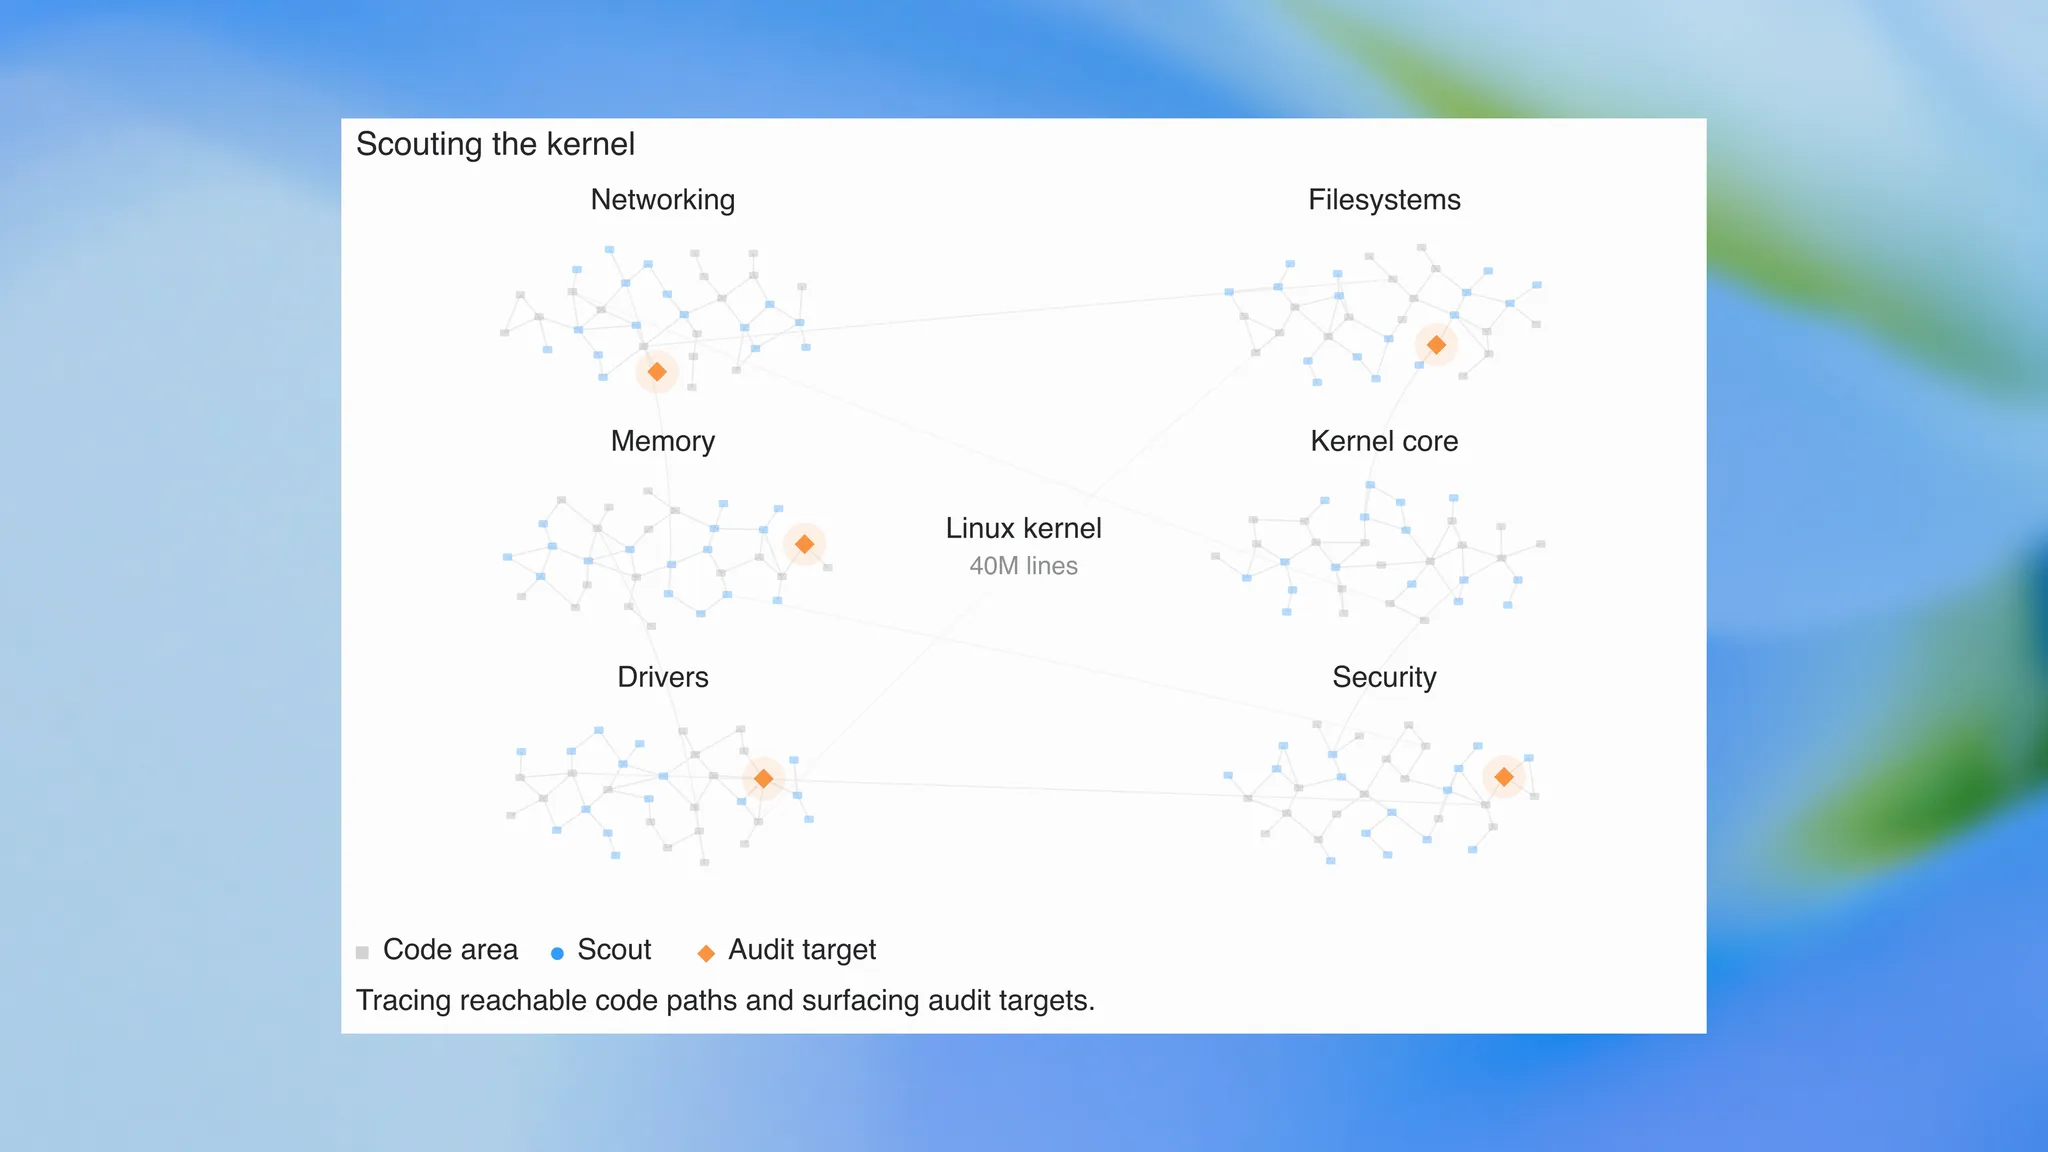
차세대 사이버 모델로 돌린 자율 파이프라인이 권한 상승 취약점 948건을 검증하고 패치를 만들었다. 전체 API 비용은 121만 달러, 건당 1,279달러였다.
오픈AI가 육아·행정·가계 관리 같은 생활 과제를 AI가 얼마나 해내는지 재는 LifeVal을 공개했다. GPT-5.2의 49.3%에서 GPT-6 Astra의 80.6%까지 1년간의 점수 변화도 함께 냈다.
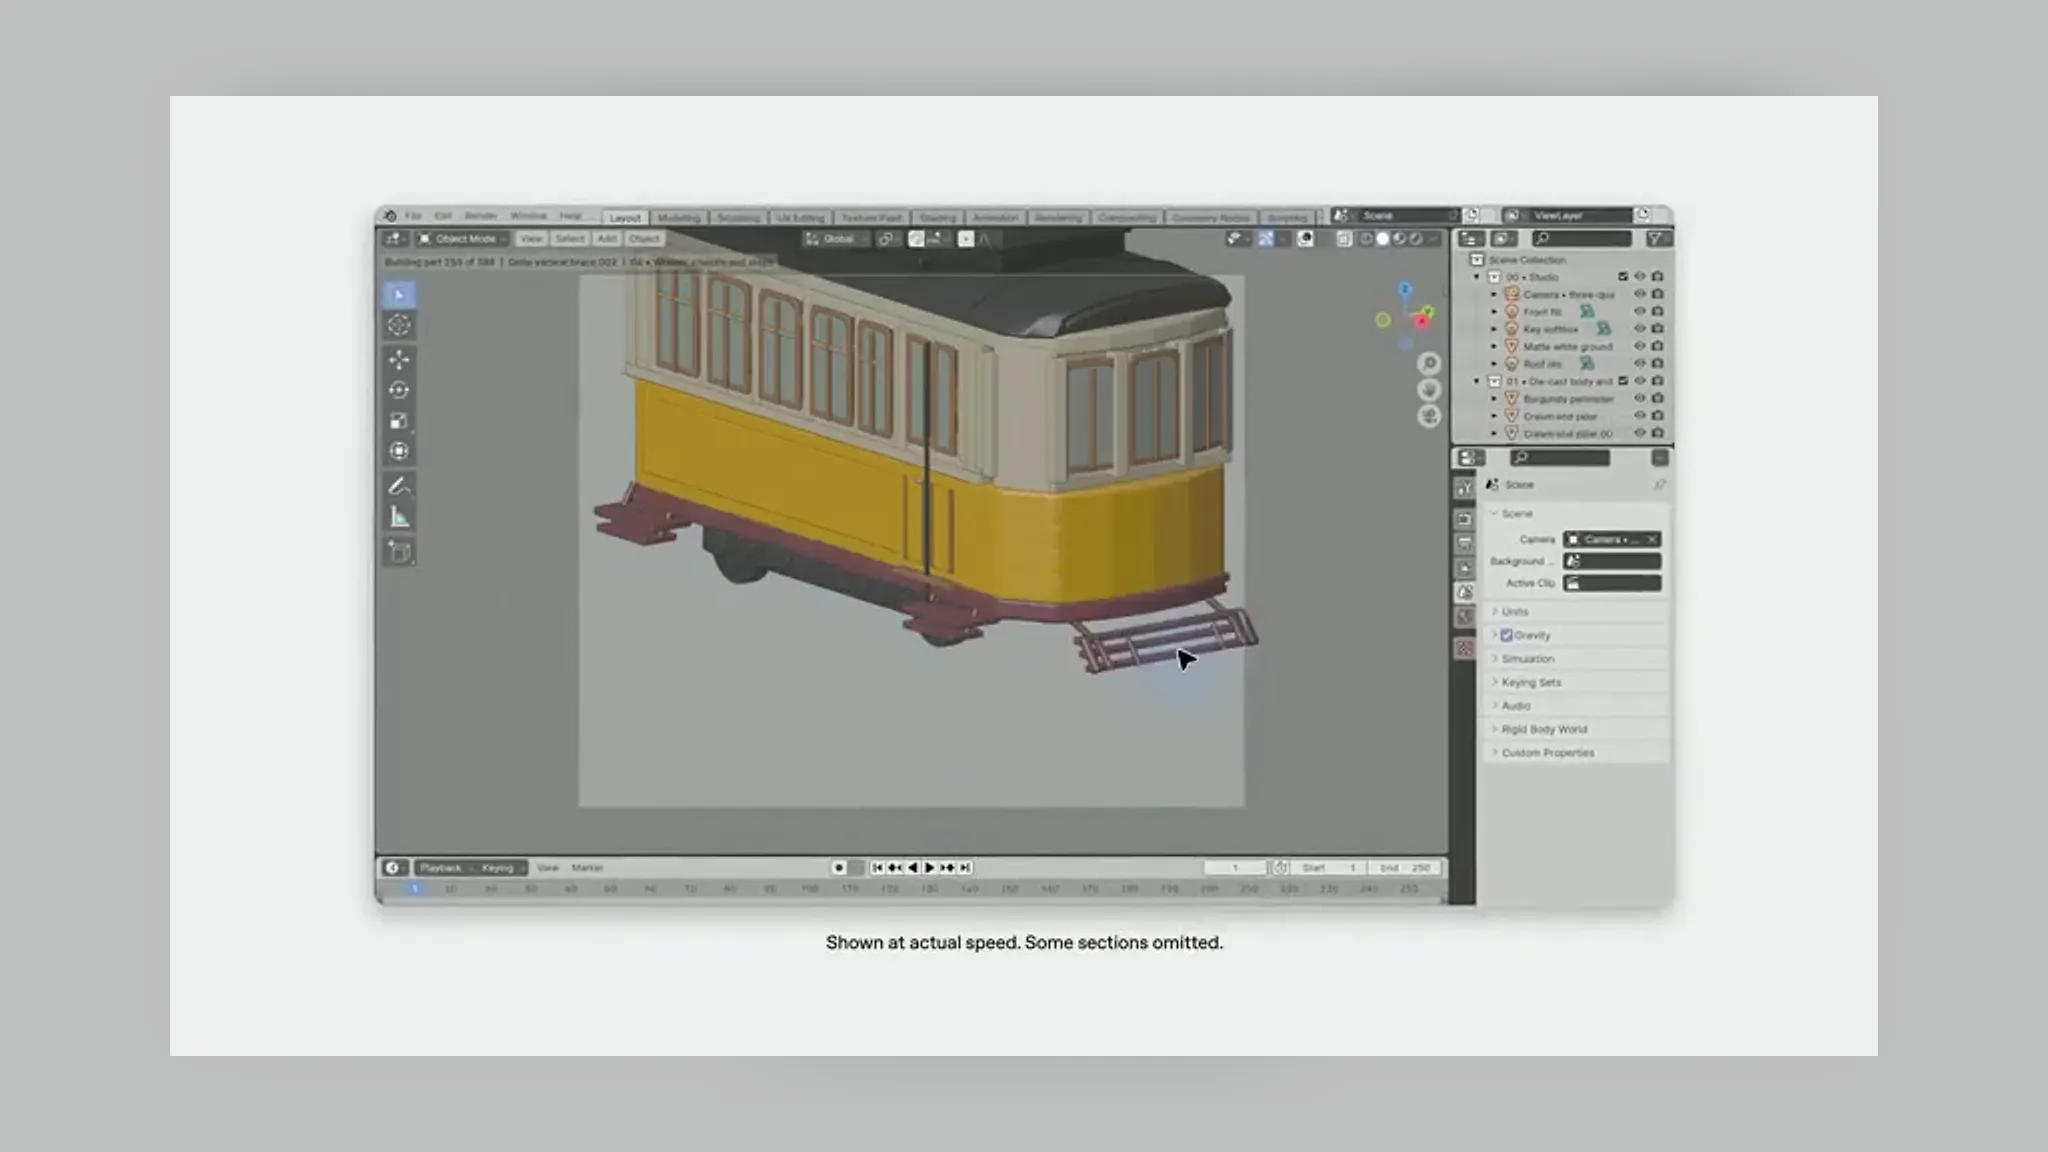
오픈AI가 화면을 읽고 소프트웨어를 조작하는 중형 모델 GPT-6.1 Terra를 공개했다. 표준 API 요금을 전작의 절반으로 내리고 ChatGPT Work와 Codex, API에 함께 배포했다.
오픈AI가 패치 더 플래닛 프로그램으로 PHP 엔진의 치명적 취약점 두 건에 대한 공동 대응을 이끌었다고 발표했다. 위즈와 캘리프가 AI 모델로 찾아낸 이 결함은 PHP 5.4 이후 거의 모든 버전에 영향을 준다.
오픈AI가 COBOL과 Fortran 같은 저자원 프로그래밍 언어에서 최신 모델의 코딩 평가 결과를 공개했다. COBOL 이전 평가에서 GPT-6.1 Sol은 86.6%를 기록했고, 추론 강도를 높이자 97.9%에 이르렀다.
오픈AI가 블록과 센티넬원의 데이브레이크 도입 사례를 공개했다. 센티넬원은 4~6주 걸리던 악성코드 역분석을 약 8시간으로 줄였고, 블록은 분기마다 분석가 약 1100시간 분량의 조사를 AI로 수행한다.
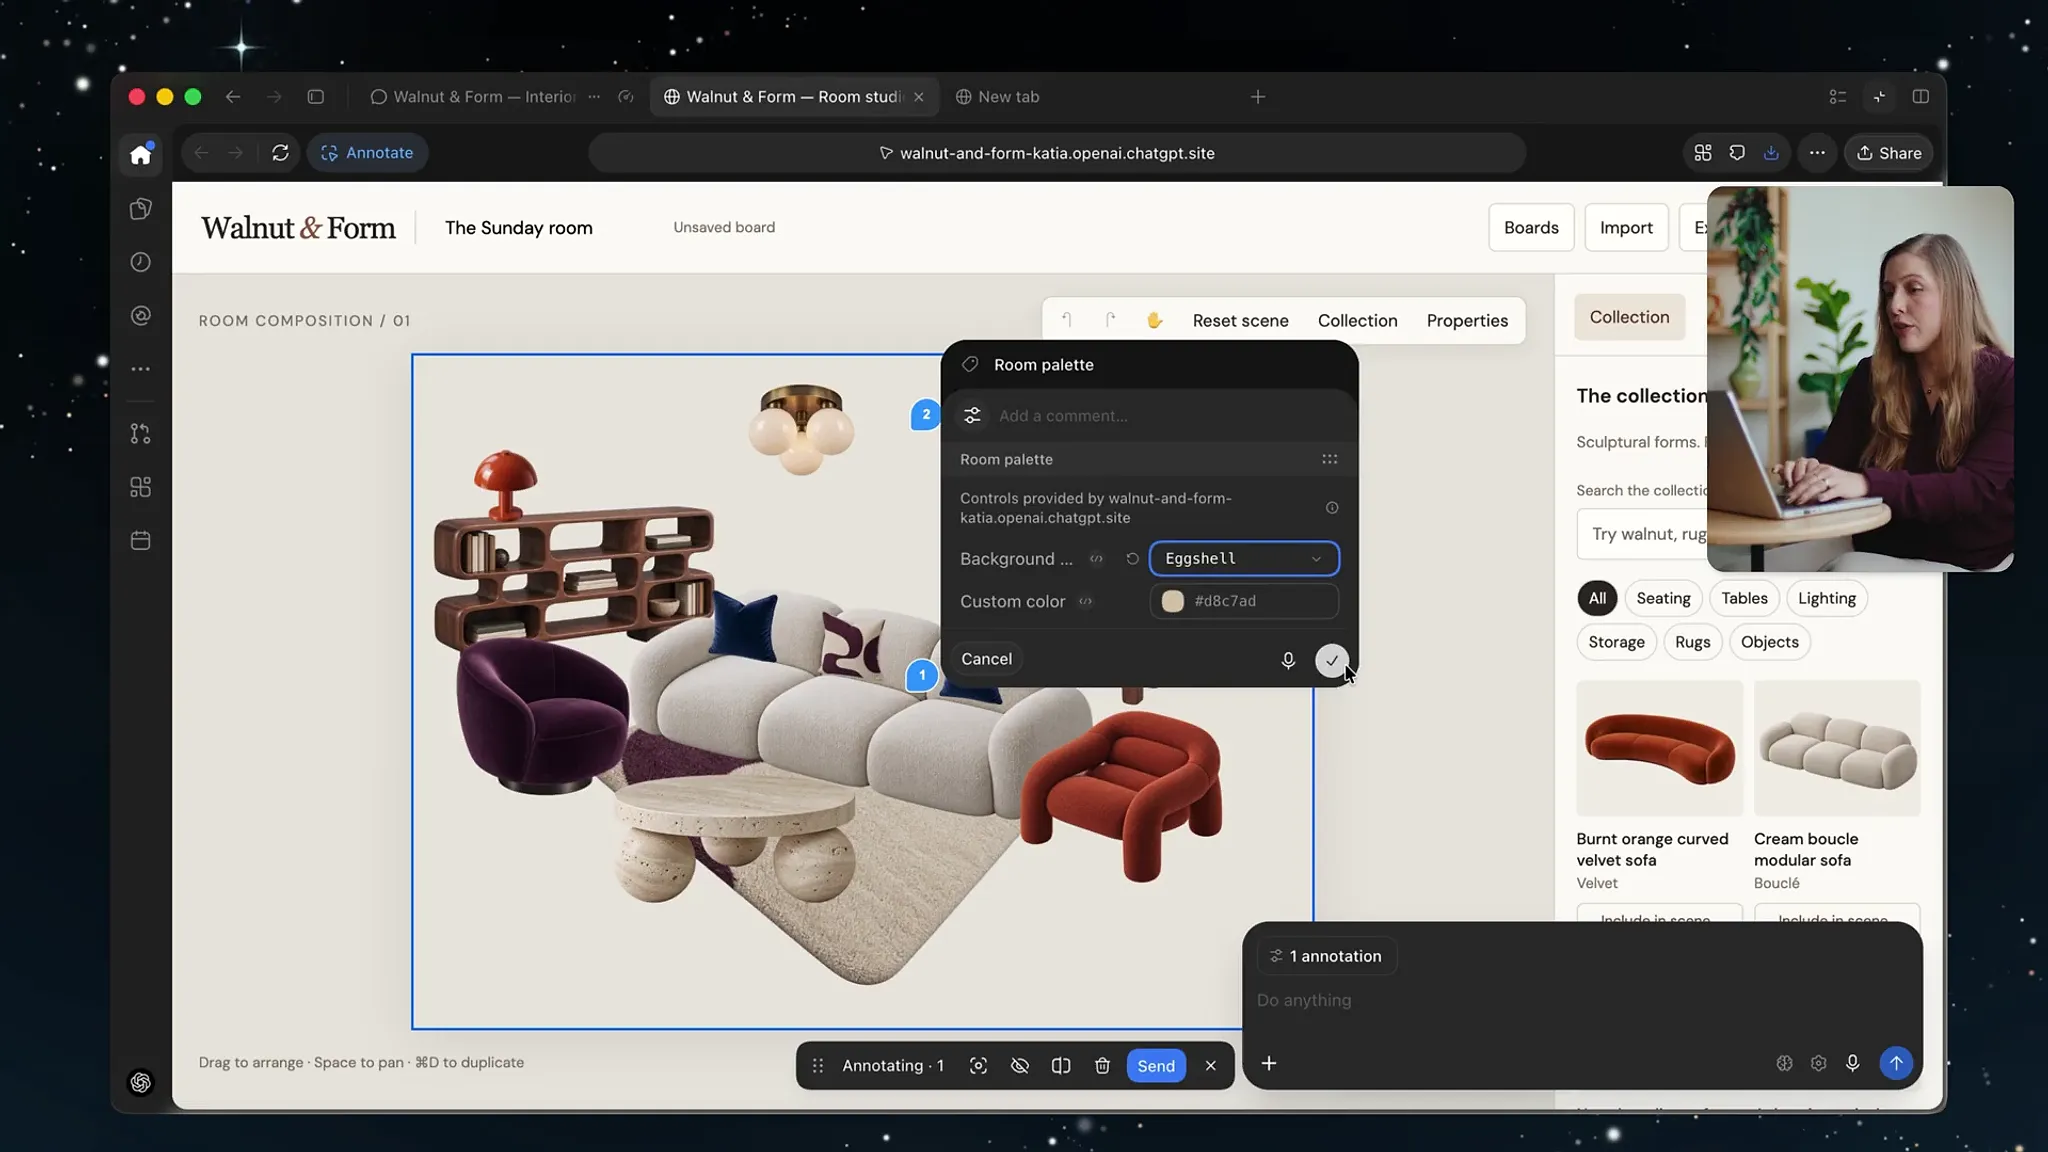
오픈AI가 ChatGPT 데스크톱 앱 내장 브라우저의 주석 기능에 맞춤 컨트롤과 추천 프롬프트를 더했다. WebMCP 도구와 짝을 이뤄 에이전트가 사용자가 가리킨 대상과 의도를 더 많이 알고 웹사이트의 동작을 실행하게 하는 구조다.
오픈AI가 사용자 2600만 명의 생성 영상 플랫폼 폴로 AI의 도입 사례를 공개했다. 폴로 AI는 라우팅에 GPT-5.6, 어려운 서사 작업에 GPT-6 Astra, 이미지에 GPT-Image-2.5를 나눠 쓰고, 사용자의 모델 선택 시간이 50% 넘게 줄었다고 밝혔다.
오픈AI가 GPT-6를 주간 사용자 12억 명 이상의 ChatGPT 전체로 넓히고 답을 그래픽·버튼·폼으로 조립하는 Intelligent UI를 함께 내놓았다. 웹 검색 질문에서는 GPT-5.6 Instant보다 평균 44% 빨리 답을 시작한다.
회계 AI 스타트업 베이시스가 50개 탭 세무 워크북을 GPT-6 Astra로 GPT-5.6 Sol의 절반 시간에 완성했다. 작업 중 추론량을 바꿔도 캐시가 유지되고, 내부 평가 점수는 약 20% 올랐다.