

이미지: 영상 갈무리
요약
- 오픈AI는 11월 2일 시간사용조사와 3,995명 설문을 바탕으로 만든 일상 과제 벤치마크 LifeVal을 공개했다.
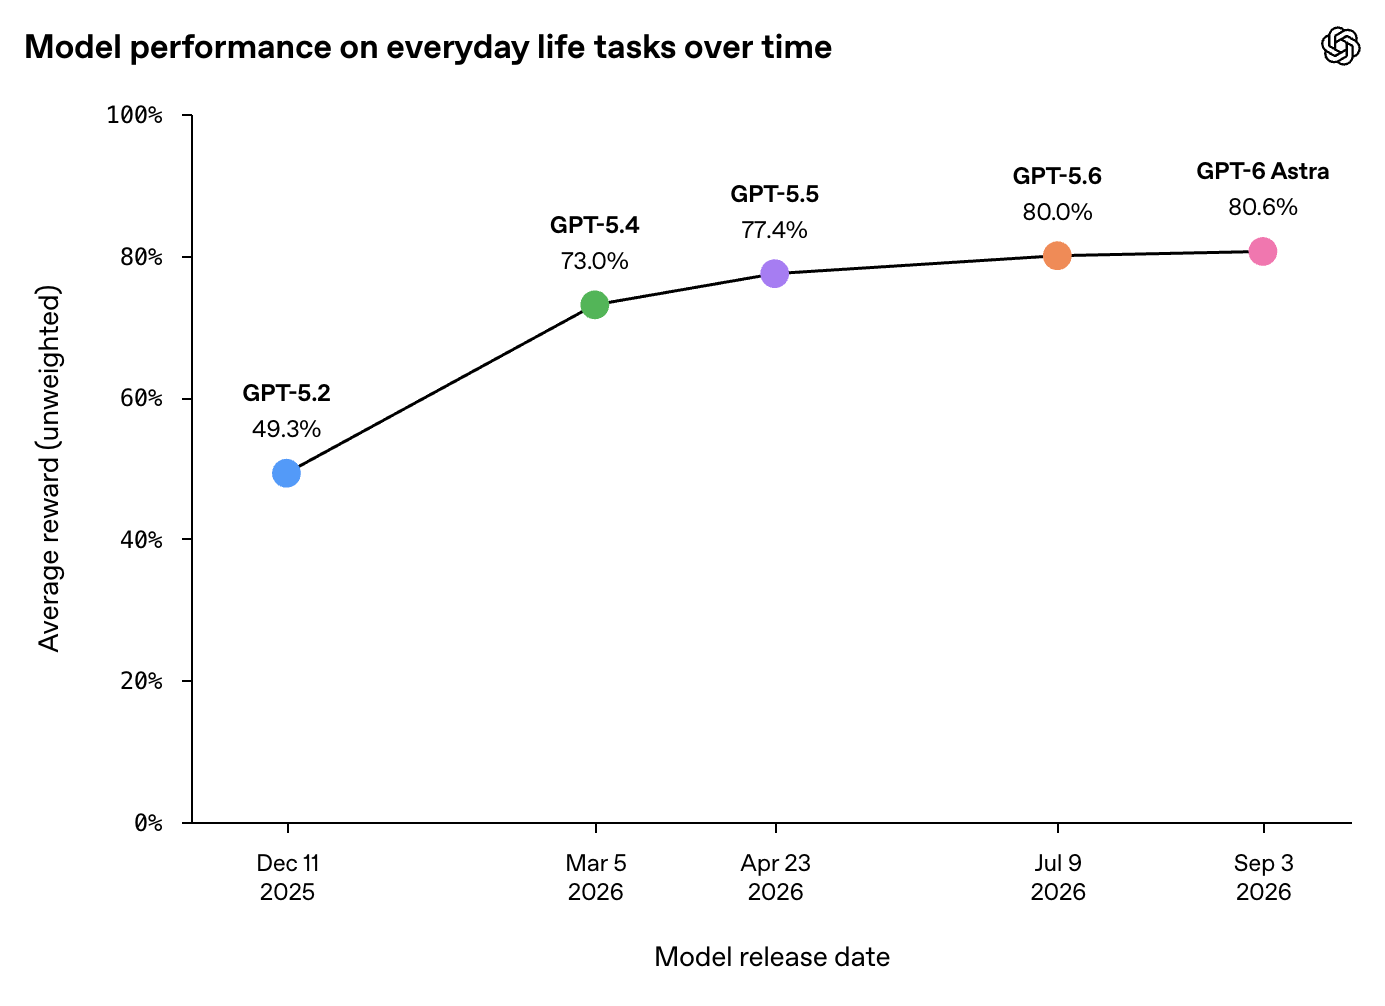
- 평균 점수는 GPT-5.2 49.3%에서 GPT-5.4 73.0%, GPT-5.6 80.0%를 거쳐 GPT-6 Astra 80.6%로 올랐다.
- 유치원 고르기 93.1%, 조건에 맞는 집 찾기 100%, 당뇨 부모 식단 90.4% 등 사례별 점수도 나왔지만 과제 목록과 채점 기준은 공개되지 않았다.
- 발표
- 2026년 11월 2일 · 오픈AI 리서치 발표문 「LifeVal」 · X 게시물(60초 영상)
- 목적
- 일상 생활 과제에서의 모델 성능을 시간에 따라 측정·개선
- 기반 자료
- 미국 시간사용조사(ATUS) · 다국가 시간사용연구(MTUS) · 3,995명 대상 인구 대표 설문
- 영역
- 돌봄 · 건강 · 교육 · 가사 행정 · 개인 재무 · 쇼핑 · 공공서비스 이용
- 사례 점수
- 유치원 비교 93.1% · 홍수 대비 자원봉사 98.0% · 집 찾기 100% · 원격 경기 관람 96.3% · 당뇨 식단 90.4%
- 세대별 평균
- GPT-5.2 49.3% · GPT-5.4 73.0% · GPT-5.5 77.4% · GPT-5.6 80.0% · GPT-6 Astra 80.6%(가중치 없는 평균 보상)
- 속도
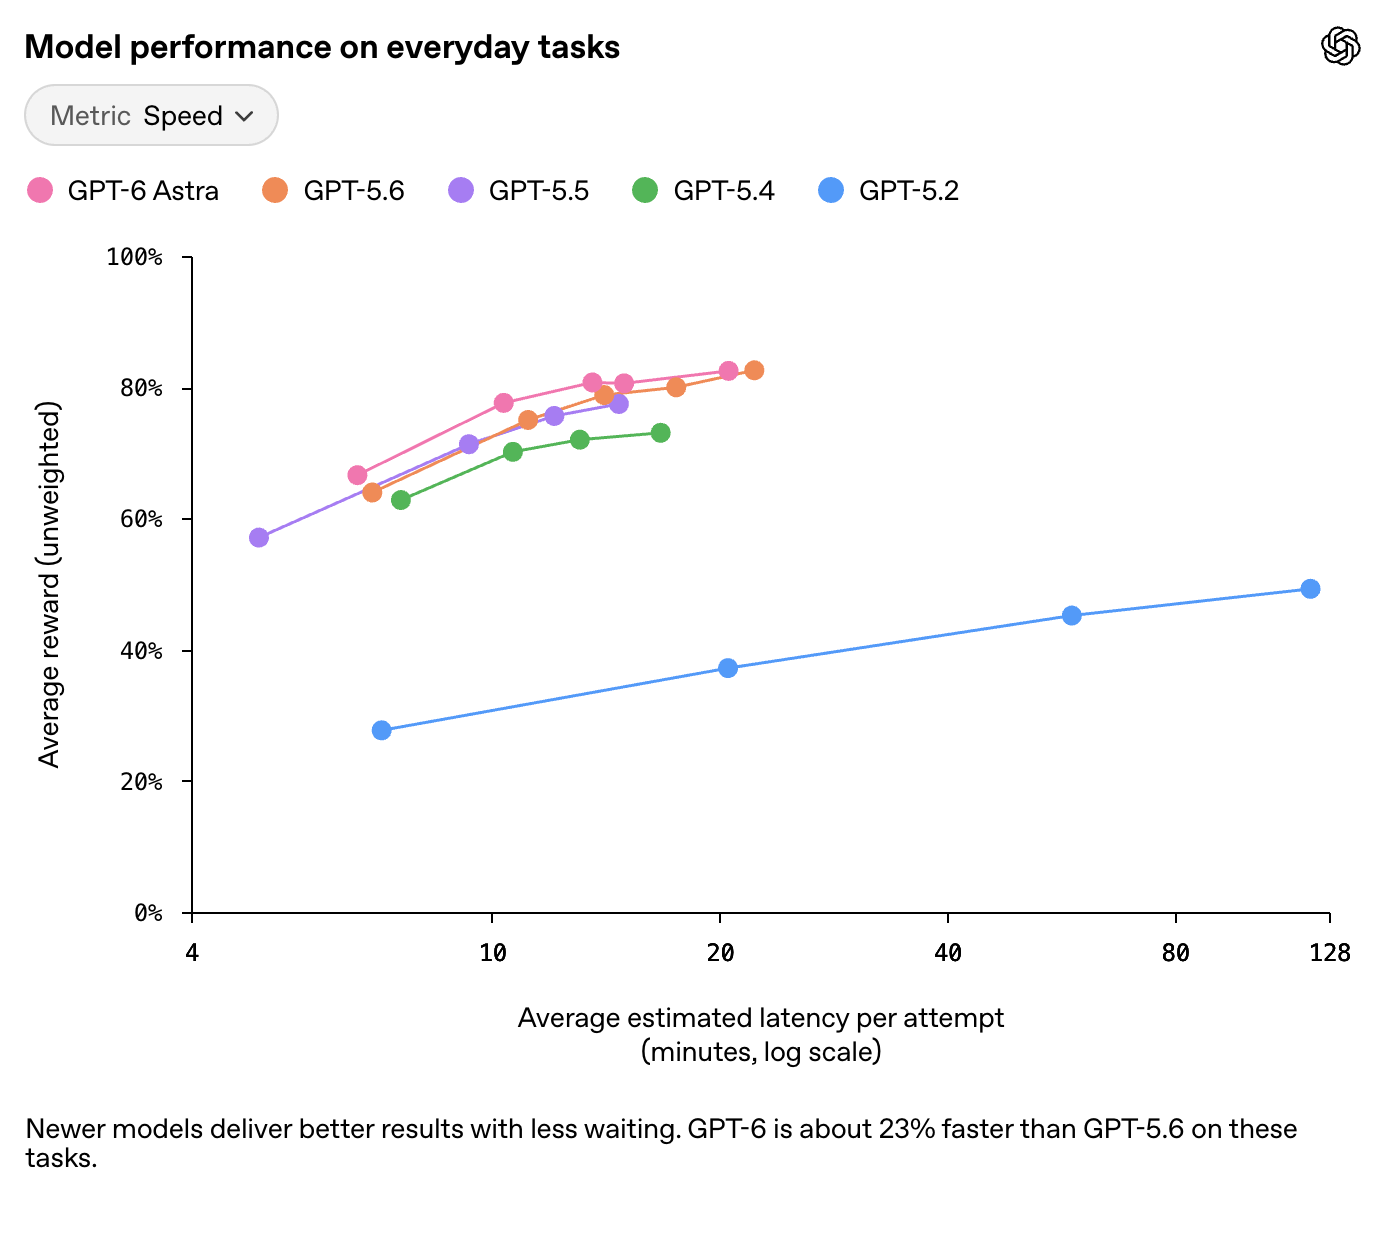
- GPT-6이 GPT-5.6보다 약 23% 빠름
- 훈련
- 브라우저 사용 · 컴퓨터 사용 · 커넥터 과제
- ChatGPT 주간 사용자
- 10억 명 이상
- 공개 범위
- 과제 목록·채점 기준·공개 리더보드 없음(발표문 기준)
오픈AI가 11월 2일 육아, 행정, 가계 관리처럼 사람들이 매일 부딪히는 일을 AI가 얼마나 잘 해내는지 재는 일상 과제 벤치마크 LifeVal을 공개했다. 오픈AI는 발표문에서 "진정으로 도움이 되는 개인 비서가 되려면 ChatGPT는 실제로 일을 끝내는 행동을 할 수 있어야 한다"고 밝혔다. 회사는 지난 1년 동안 이 평가로 모델의 일상 과제 성능을 추적하고 개선해 왔다고 설명했다. 메탈이 확인한 발표문의 도표에 따르면 2025년 12월 출시된 GPT-5.2의 평균 점수는 49.3%였고, 2026년 9월 출시된 GPT-6 Astra는 80.6%를 기록했다.
출발점은 학술 시험이 아니라 사람들의 하루였다. 오픈AI는 미국인의 시간 사용을 추적하는 미국 시간사용조사(ATUS)와 여러 나라 자료를 묶은 다국가 시간사용연구(MTUS)를 바탕으로 일상 과제 목록을 만들었다. 보도에 따르면 MTUS는 100개가 넘는 국가 단위 조사에서 모은 100만 일 이상의 생활 일지를 한 형식으로 정리한 자료로, 30개국의 55년치 기록을 담고 있다. 오픈AI는 여기에 인구 구성을 반영한 3,995명 대상 설문을 새로 더해, 과제마다 사람들이 개인 비서의 도움을 가장 원하는 영역이 어디인지 물었다.
그렇게 추린 영역은 돌봄, 건강, 교육, 가사 행정, 개인 재무, 쇼핑, 공공서비스 이용 일곱 갈래다. 오픈AI는 X 게시물에서 "AGI가 인류 전체에 이로우려면 사람들에게 가장 중요한 일상 과제를 도와야 한다"고 적었다. 1분 길이 영상을 붙인 이 게시물은 공개 15시간 만에 조회수 60만 회를 넘겼다. 회사는 ChatGPT를 매주 쓰는 사람이 10억 명이 넘는다는 점을 들어, 어린이집 찾기와 예산 짜기, 장보기, 운동 계획까지 생활의 실무를 돕는 AI가 목표라고 설명했다.
발표문은 현재 모델이 실제 생활 과제에서 받은 점수 다섯 개를 공개했다. 이사 뒤 새 집 근처 유치원을 비교해 입학 후보를 추리는 과제는 93.1%, 홍수에 대비해 이웃 네 집의 침수 방지 작업을 도울 자원봉사자를 조직하는 과제는 98.0%였다. 루저른 카운티에서 예산과 별채, 통근 조건에 맞는 집을 찾아 양도세까지 계산하는 과제는 100%를 받았다. 멀리 사는 할머니와 경기를 함께 보는 환경을 마련하는 과제는 96.3%, 당뇨 진단을 막 받은 부모의 첫 주 식단과 돌봄 계획을 짜는 과제는 90.4%였다.
모델 세대별 기록은 가파른 상승 뒤 완만해지는 곡선을 그린다. 도표에서 GPT-5.4는 73.0%, GPT-5.5는 77.4%, GPT-5.6은 80.0%를 받았다. 49.3%에서 73.0%로 뛴 첫 구간 이후 세 모델이 더한 점수는 7.6%포인트다. 점수는 과제별 가중치를 두지 않은 평균 보상이다. 오픈AI는 속도, 생성 토큰 수, API 비용을 함께 비교한 도표도 냈는데, GPT-6이 이 과제들에서 GPT-5.6보다 약 23% 빠르다고 밝혔다.
오픈AI는 지난 1년 동안 모델이 브라우저 사용, 컴퓨터 사용, 커넥터 과제에서 더 빠르고 유능하며 의도에 맞게 움직이도록 훈련했다고 설명했다. 이 기능이 ChatGPT에 붙으면서 도울 수 있는 과제의 범위가 넓어지고, ChatGPT가 대화 도구를 넘어 행동하는 개인 비서로 옮겨 간다는 것이 회사의 설명이다. 메탈은 오픈AI가 ChatGPT 전체에 GPT-6을 배포한 소식을 보도한 바 있으며, LifeVal은 그 모델 세대가 생활 과제에서 어디까지 왔는지를 회사 스스로 매긴 성적표다.
사회학의 렌즈로 보면 이 벤치마크가 무엇을 일로 세는지가 눈에 띈다. 보도에 따르면 미국 시간사용조사는 임금 노동뿐 아니라 육아와 자원봉사, 사교에 쓰는 시간까지 재는 자료다. LifeVal의 공개 사례 다섯 개 가운데 유치원 고르기, 부모 식단, 할머니와의 경기 관람 세 건이 가족을 돌보는 일이다. 학술 평가가 모델의 머릿속 지식을 쟀다면, 이번 평가는 가정과 동네에서 누군가 떠맡아 온 임금 밖의 노동을 AI의 과제로 옮겨 적었다.
메탈이 확인한 발표문에는 과제 전체 목록이나 채점 기준, 외부 연구자가 돌려 볼 수 있는 공개 리더보드 계획이 담겨 있지 않다. 점수는 오픈AI가 자기 모델을 자기 평가로 잰 결과이고, 다섯 개 사례도 회사가 고른 장면이다. 오픈AI는 "모델 지식에 대한 학술적 평가를 넘어 AI가 사람들의 결정과 일상의 책임을 얼마나 잘 돕는지 실제로 측정해야 한다"고 밝혔다.
LifeVal이 남긴 질문은 생활의 일을 누가 정의하느냐다. 오픈AI는 3,995명의 설문으로 그 정의를 사용자에게서 가져왔다고 말한다. 집을 계약하고 부모의 식단을 짜는 일에서 80%대 점수가 무엇을 뜻하는지는 결국 나머지 20%가 어떤 실수였는지에 달려 있다. 오픈AI는 LifeVal이 일상의 사람들에게 중요한 것을 재는 방향으로 가는 한 걸음이 되기를 바란다고 밝혔다.
댓글