

이미지: METAL
요약
- 오픈AI는 11월 6일 리고와 만든 웻랩 과제 100개짜리 벤치마크 BioBasicsBench 를 공개했다.
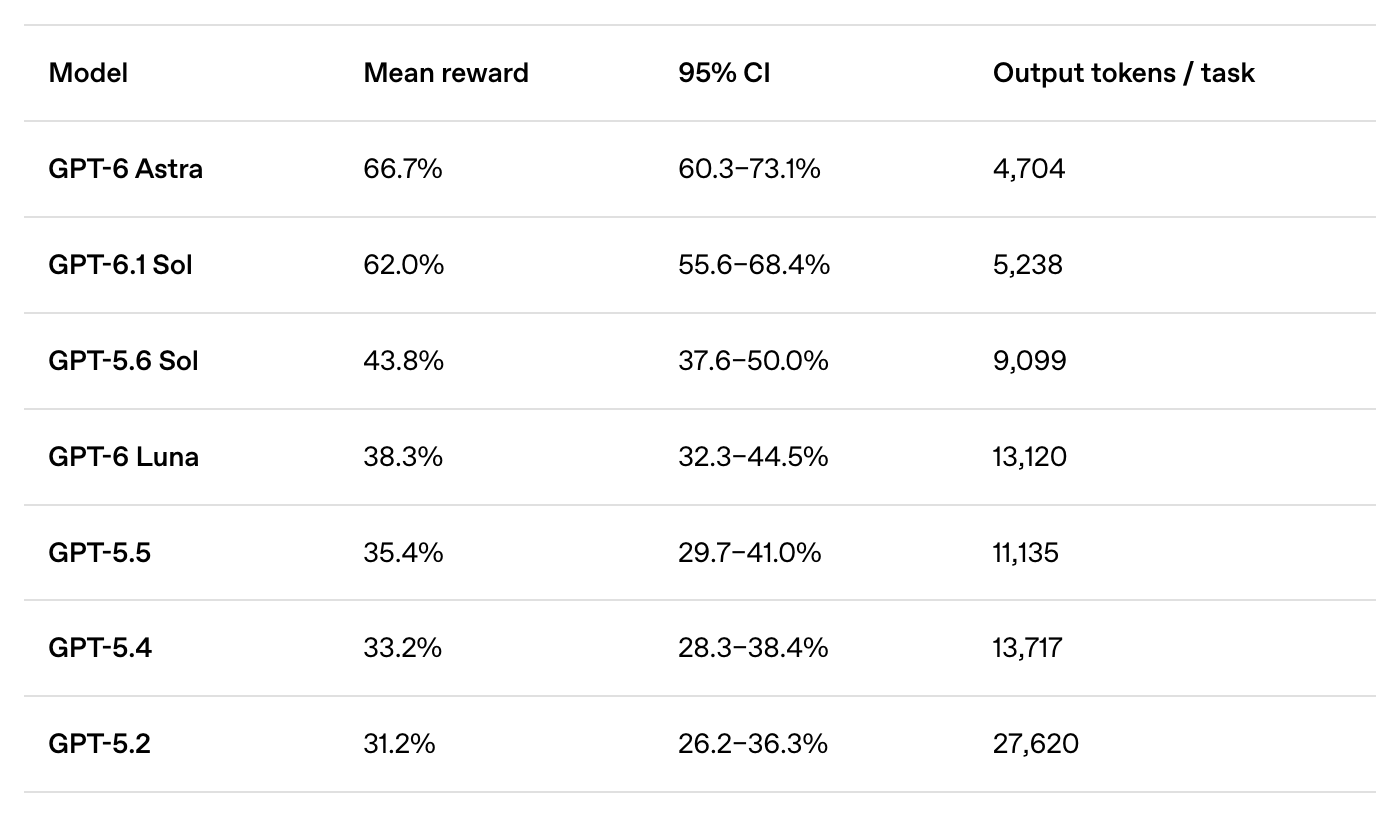
- xhigh 설정에서 GPT-6 Astra 는 배점의 66.7%를 얻어 GPT-5.6 Sol(43.8%)을 앞섰고 출력 토큰은 절반 남짓만 썼다.
- Astra 는 대조군 배지의 항생제 라벨을 읽어 냈지만 콜로니 PCR 에서 엉뚱한 레인을 고르고 콜로니를 약 12% 많게 셌다.
- 발표
- 2026년 11월 6일 · 오픈AI 「Measuring how AI agents handle everyday wet-lab science」
- 공동 개발
- 효소 설계 기업 리고(Ligo)
- 구성
- 과제 100개 · 단백질 실험법 · 이미징·세포 계측 · 정량·분석법 · 핵산 실험법 · 분자 클로닝
- 검토
- 리고 과학자 내부 검토 → 외부 박사급 웻랩 과학자 검토 → 최종 내부 검토
- 입력 자료
- 겔·블롯 31 · 프로토콜·노트 27 · 표·장비 파일 20 · 실험대 사진 18 · 현미경 14 · 프로토콜 영상 7(과제 수)
- 평가 규모
- 7개 모델 · 37개 설정 · 과제당 5회 · 결과 1만 8,500건
- xhigh 점수
- GPT-6 Astra 66.7% · GPT-6.1 Sol 62.0% · GPT-5.6 Sol 43.8% · GPT-6 Luna 38.3% · GPT-5.5 35.4% · GPT-5.4 33.2% · GPT-5.2 31.2%
- 출력 토큰
- Astra 과제당 4,704개 · GPT-5.6 Sol 9,099개
- 성공 사례
- 「LB Kan50」 라벨로 대조군 배지 기각 · 525~540nm 파장 겹침 지적 · z-스택 인식
- 실패 사례
- 콜로니 PCR 4·6·7·8번 선택(정답 5·9·10번) · 밝은 액포 누락 · 콜로니 약 12% 과다 계수
오픈AI가 11월 6일 AI 에이전트가 실험실의 날것 그대로인 실험 데이터를 얼마나 제대로 읽는지 재는 벤치마크 BioBasicsBench 를 공개했다. 효소 설계 기업 리고(Ligo)와 함께 만든 이 벤치마크는 일상적인 웻랩 과제 100개로 구성된다. 가장 높은 추론 설정인 xhigh 에서 GPT-6 Astra 는 배점의 평균 66.7%를 얻었고 GPT-5.6 Sol 은 43.8%에 그쳤다. 오픈AI는 발표문에서 "벤치마크 점수가 높아졌다고 해서 모델이 실험실에서 믿을 만한 판단을 내릴 수 있다는 뜻은 아직 아니다"라고 밝혔다.
웻랩은 생물 시료를 직접 다루며 실험하는 공간이다. 오픈AI에 따르면 이곳의 일상은 실패한 실험과 애매한 이미지, 서로 어긋나는 관찰로 채워져 있다. 논문에 실리려고 골라 낸 차트와 이미지로 만든 기존 벤치마크는 이 모호함과 그것을 풀어 가는 문제 해결 과정을 놓칠 수 있다는 것이 오픈AI의 설명이다. 그래서 과제는 데이터를 해석하는 능력만이 아니라 오류를 찾아내고, 증거가 결론을 받쳐 주지 못할 때 그 사실을 알아차리는 능력까지 묻는다.
과제는 단백질 실험법, 이미징과 세포 계측, 정량과 분석법, 핵산 실험법, 분자 클로닝의 다섯 분야에 걸쳐 있다. 과학자들이 자기 실험 데이터로 문제를 만들고 전문가가 쓴 채점 기준을 붙였다. 과제마다 작성자가 아닌 리고 과학자의 내부 검토, 외부 웻랩에서 일하는 박사급 과학자의 검토, 마지막 내부 검토를 거쳤다. 입력 자료는 겔과 블롯 이미지가 31개 과제로 가장 많고, 프로토콜·실험 노트·사양서가 27개, 표와 장비 내보내기 파일이 20개, 실험대·장비·시약 사진이 18개, 현미경 이미지가 14개 과제에 들어갔다. 손으로 쓴 메모를 찍은 사진도 자료로 쓰였고, 실험 과정을 담은 프로토콜 영상은 7개 과제에 들어갔다.
평가 규모도 크다. 오픈AI는 GPT-5.2, GPT-5.4, GPT-5.5, GPT-5.6 Sol, GPT-6.1 Sol, GPT-6 Luna, GPT-6 Astra 일곱 모델을 37개 모델·추론 설정 조합으로 돌렸고, 설정마다 100개 과제를 다섯 번씩 풀게 해 결과 1만 8,500건을 모았다. xhigh 기준으로 GPT-6.1 Sol 은 62.0%, GPT-6 Luna 는 38.3%, GPT-5.5 는 35.4%, GPT-5.4 는 33.2%, GPT-5.2 는 31.2%였다. Astra 는 과제당 출력 토큰 4,704개로 GPT-5.6 Sol 의 9,099개의 절반 남짓만 쓰고도 더 높은 점수를 냈다. 오픈AI는 더 강한 네이티브 멀티모달 능력이 일상적인 웻랩 분석 성능을 끌어올리는 열쇠일 수 있다고 봤다.
메탈이 확인한 발표문의 사례는 그 차이가 어디서 나오는지 보여 준다. DNA 클로닝 과제에서 GPT-5.6 Sol 은 음성 대조군 배지에 콜로니가 하나도 없다는 관찰을 근거로 결론을 내렸다. Astra 는 배지 테두리에 손글씨로 적힌 「LB Kan50」 표시를 읽고, 그 배지가 실험에 쓴 암피실린이 아니라 카나마이신 배지라는 점을 짚어 믿을 수 있는 대조군이 아니라고 판단했다. 세포 염색 과제에서는 Sol 이 사멸 세포 염료의 신호만 보고 세포를 죽었다고 분류했지만, Astra 는 검출 파장이 525~540나노미터에서 겹쳐 두 번째 염료의 빛이 섞일 수 있다는 점을 알아채고 신호를 가를 대조 실험을 요구했다. 초점이 들락날락하는 현미경 영상을 두고 Sol 이 세포가 사라지는 생물학적 이유를 찾는 동안, Astra 는 깊이를 바꿔 찍은 z-스택이라는 것을 알아봤다.
틀린 사례도 발표문에 함께 실렸다. 콜로니 PCR 과제에서 Astra 는 밴드를 두 무리로 정확히 나눴지만 더 큰 PCR 산물이 클로닝 성공을 뜻한다고 가정하고 4·6·7·8번 레인을 골랐다. 대조군 비교에 따른 정답은 5·9·10번이었다. 오픈AI는 이 판단대로라면 엉뚱한 플라스미드를 정제하게 된다고 설명했다. 액포가 대체로 주변보다 어둡다고 일반화하면서 같은 이미지 속 밝은 액포를 결론에서 빼 버린 사례도 있었고, 배지의 콜로니를 세는 과제에서는 붙어 있는 콜로니를 구분하지 못하고 빈 한천을 세어 기준값보다 약 12% 많게 셌다. 오픈AI에 따르면 이 오차는 DNA 도입 효율 추정치를 같은 비율만큼 부풀린다.
메탈은 오픈AI가 면역학자와 Codex 의 세포 연구 과정을 담은 영상을 공개한 소식을 보도한 바 있다. 이번 벤치마크도 과학 연구를 겨눈 오픈AI의 흐름 위에 있다. 보도에 따르면 샘 올트먼(Sam Altman) 오픈AI 최고경영자(CEO)는 11월 3일 팟캐스트에서 회사의 최근 수학 성과를 두고 "과학적 발견을 해내는 기계라는 이정표에 생각보다 더 가까이 왔다고 느끼게 했다"고 말했다. 실험실 데이터 소프트웨어 기업 벤칠링(Benchling)도 클로닝 실험 계획을 묻는 자체 평가를 만들었고, 그 평가에서도 Astra 가 가장 높은 점수를 받은 것으로 전해졌다. 니컬러스 라루스스톤(Nicholas Larus-Stone) 벤칠링 AI 총괄은 지난 8월 "적절한 하네스와 사람의 개입이 있으면 대형 언어 모델은 웻랩에서 일할 수 있다"고 말했다.
과학사회학의 눈으로 보면 이 벤치마크가 재는 것은 지식보다 실험실의 관행이다. 대조군을 의심하고, 라벨을 다시 읽고, 증거가 부족하면 결론을 미루는 태도는 교과서보다 선배 연구자 옆에서 몸으로 익히는 기술이다. 채점 기준이 정답 여부만이 아니라 증거 부족을 알아차렸는지에도 점수를 주는 것은 그 암묵지를 측정 가능한 항목으로 옮기려는 시도다. Astra 의 오답 사례가 공통으로 보여 주는 것은 관찰은 맞았는데 익숙한 가정이 결론을 끌고 간 장면이다. 사람 연구자에게도 흔한 이 실수가 기계에서 같은 모양으로 나타난다는 점은, 실험실에 들어올 AI의 검토 책임이 여전히 사람의 대조 실험 습관에 기대고 있다는 뜻이다.
오픈AI는 BioBasicsBench 가 원시 데이터 해석과 대조군 점검, 뒷받침되지 않는 결론의 식별을 개선 목표로 삼게 해 준다고 밝혔다. 이런 과제에서 진전이 이어지면 과학자가 문제 해결에 쓰는 시간을 줄이고 다음에 어떤 실험을 할지 정하는 데 더 많은 시간을 쓸 수 있다는 것이다. 오픈AI는 이 능력의 발전을 추적하는 일이 생물 안전과 생물 보안에 미칠 영향을 이해하는 데도 쓰일 것이라고 덧붙였다.
댓글