

구글, 동남아 12개 언어 벤치마크 DEEPSEA 공개
구글 리서치가 동남아시아 12개 언어로 LLM의 수학·과학 추론, 질의응답, 요약, 번역을 재는 벤치마크 DEEPSEA를 공개했다. 프런티어 모델은 저자원 언어에서도 버텼지만 작은 오픈 웨이트 모델은 크게 무너졌고, 모델 대부분이 영어를 거칠 때 더 잘 풀었다.
40
Google Research
구글의 기초연구 조직. DeepMind와 별개로 논문·모델을 낸다.
현재 순위 (1M)
16위
최근 30일 순위 추이
2026.09.30 – 2026.10.29 · 최고 14위 · 최저 31위 · 현재 16위
구글 리서치가 동남아시아 12개 언어로 LLM의 수학·과학 추론, 질의응답, 요약, 번역을 재는 벤치마크 DEEPSEA를 공개했다. 프런티어 모델은 저자원 언어에서도 버텼지만 작은 오픈 웨이트 모델은 크게 무너졌고, 모델 대부분이 영어를 거칠 때 더 잘 풀었다.
구글이 부다페스트에서 열리는 EMNLP 2026에서 논문 31편을 공개하고, 수어 AI를 처음 소비자 제품에 넣은 SL2T를 부스에서 시연한다. 기조연설과 주요 논문은 AI 에이전트 정렬과 평가의 허점을 겨눴다.
구글 리서치가 흉부 엑스레이 결핵 판독 AI를 6개국 약 40개 의료 시설과 지하 4킬로미터 금광까지 보급한 과정을 공개했다. 인도네시아는 MedGemma로 해마다 5000만 명을 선별하는 국가 사업을 준비한다.
구글 딥마인드가 WRI·IIASA와 함께 지구의 모든 땅을 10m 칸마다 여섯 범주로 가른 숲 유형 지도 ForTy 2020과 2017~2025년 시계열을 공개했다. 숲과 숲이 아닌 땅을 95% 구분했지만 조림지 판별은 가장 약했다.
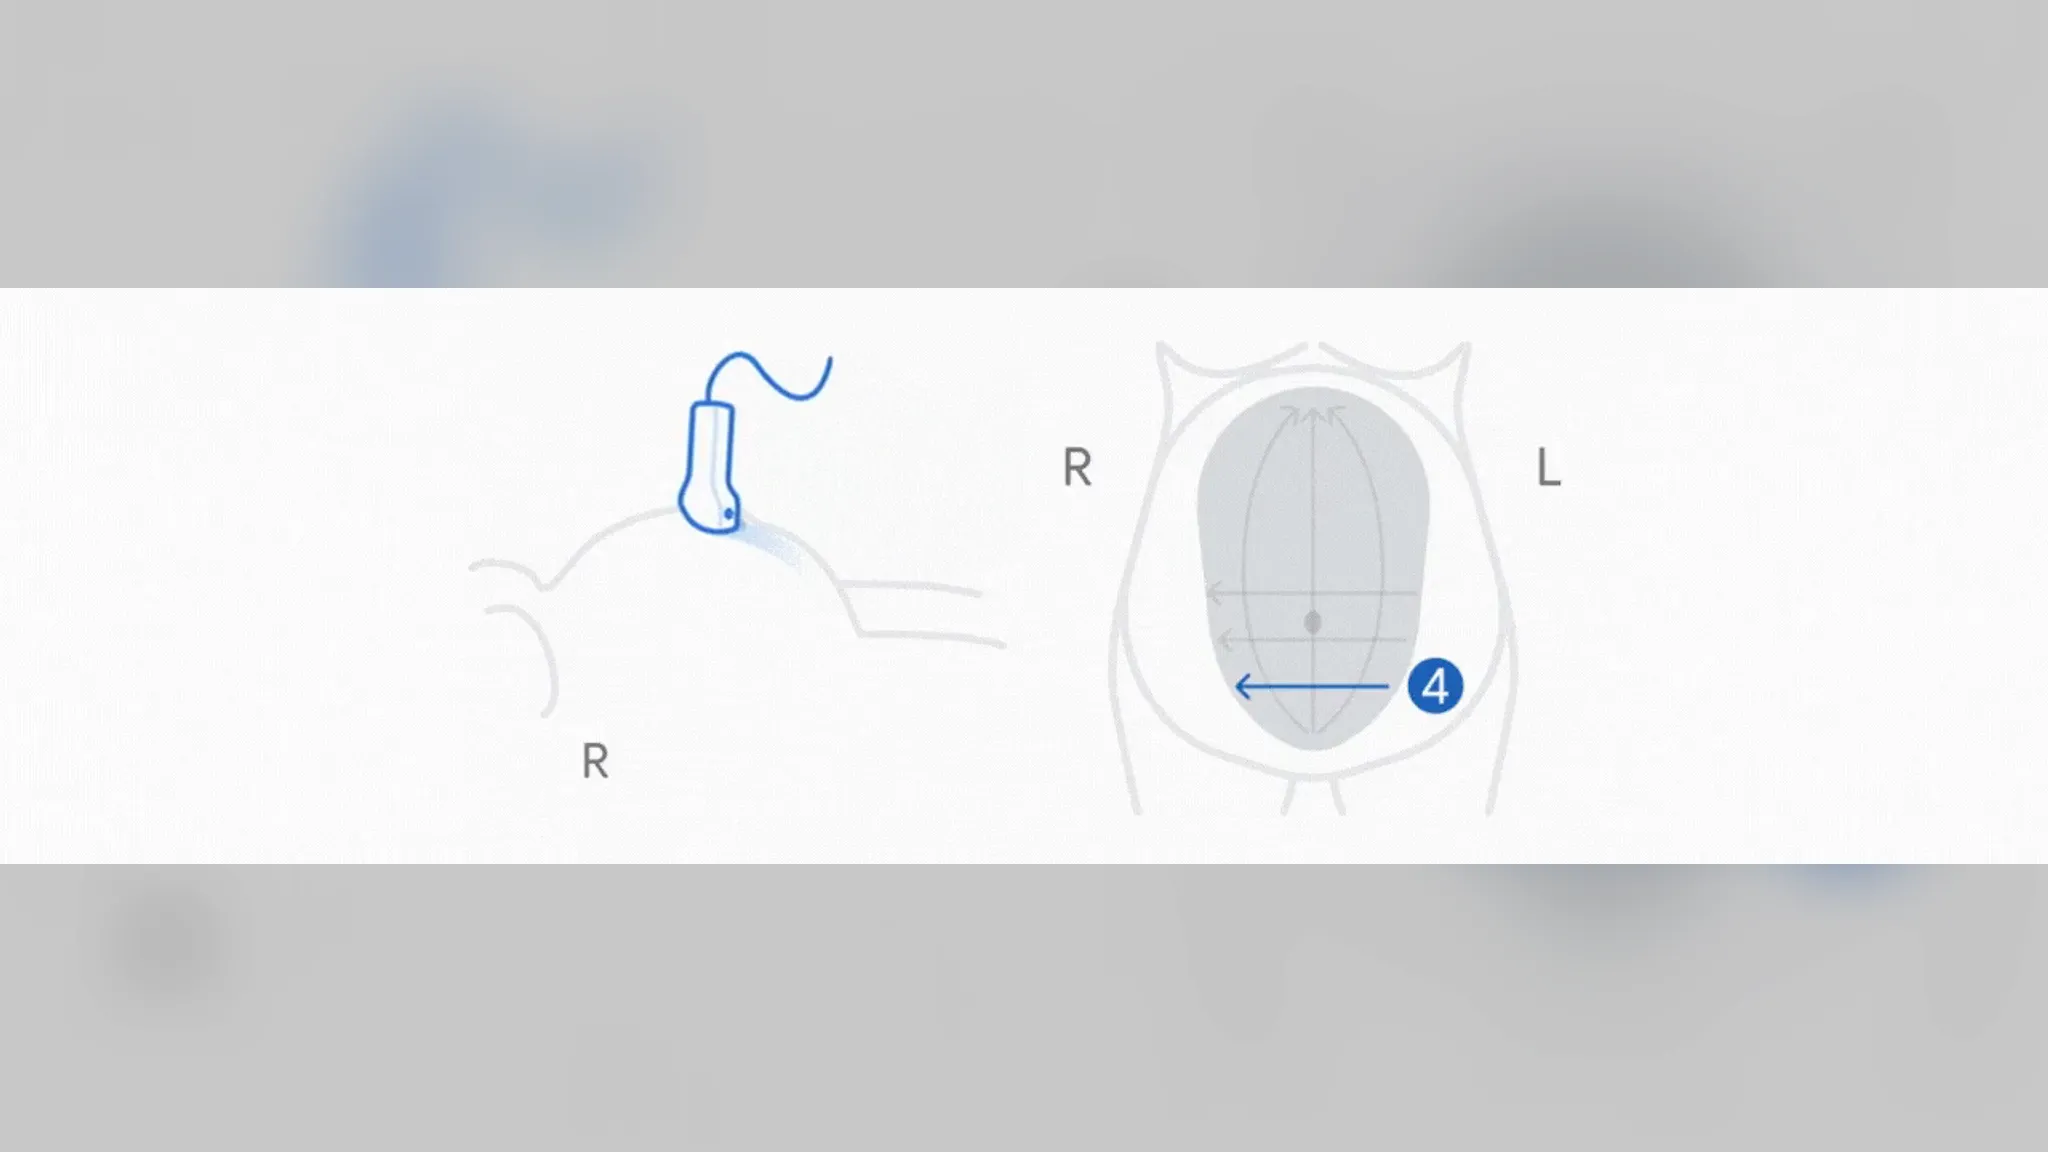
초음파 훈련을 받지 않은 사람이 휴대용 탐촉자로 배를 훑기만 해도 AI가 숙련 초음파사 수준으로 임신 주수를 판정했다. 시카고와 나이로비 임산부 385명에서 AI 오차는 4.18일, 표준 방식은 4.48일이었다.
구글 리서치가 위성·기상·인구 모델을 묶은 지리공간 추론 에이전트의 기술 보고서를 공개하고 실험 접근을 넓혔다. 전문가 과제에서 도구 없는 모델은 0점, 에이전트는 62.7점을 받았다.
구글 리서치가 연례 행사 리서치앳 2026에서 학회 원고 1만6000편 넘게 검토한 논문 검증 에이전트 딥 리뷰를 일반에 열었다. AI 학회 원고가 3년 만에 세 배로 불어난 상황에서 검증 노동을 AI로 나누겠다는 구상이다.
구글 어스 AI의 인구 동태 파운데이션 모델을 홍역 백신, 심혈관질환, 뎅기열, 산후우울증, 콜레라 예측에 붙인 사례 5건의 결과가 나왔다. 기존 역학 모델에 입력 하나를 더하자 통계가 늦거나 국경에서 끊기는 곳에서 성능이 올랐다.
구글 리서치가 AI 에이전트의 프라이버시와 보안에서 풀리지 않은 연구 과제 51개를 정리한 116쪽 워크숍 보고서를 공개했다. 맥락적 무결성 이론을 바탕으로 에이전트 행동을 맥락에 비춰 걸러 내는 정책 엔진을 제안했다.
구글 리서치가 서버의 신뢰 실행 환경 안에서만 기기 데이터를 풀고 그 코드를 공개 로그로 검증하게 한 연합학습 시스템을 공개했다. 지보드 영어 모델은 3배 작은 프라이버시 예산으로 3주 만에 학습됐다.
구글의 AI 연구 도구 ERA로 만든 독감 입원 예측 모델이 CDC 시즌 평가에서 39개 모델 중 가장 좋은 점수를 냈다. 2위와의 차이는 0.02이고 주별 순위는 엇갈렸다.
구글 리서치가 원본 이미지 생성 모델을 얼려 둔 채 작은 보조망으로 생성 방향을 바로잡는 제어 프레임워크 Diffusion Controller를 공개했다. 파라미터 1,200만 개의 회색 상자 방식이 LoRA보다 높은 선호 승률을 냈다.