

이미지: @OpenAI (X) 영상 갈무리
요약
- 오픈AI가 COBOL·Fortran·Visual Basic 같은 저자원 프로그래밍 언어용 평가 두 가지를 만들어 최신 모델의 코딩 평가 결과를 공개했다.
- SQLite 호환 엔진을 20개 언어로 짓는 MultiLangBench에서 GPT-6 Astra는 평균 87.4%를 통과해 GPT-5.6 Sol의 26.8%를 크게 넘었고, COBOL은 72.1%로 가장 어려운 언어였다.
- COBOL 이전 평가에서 GPT-6.1 Sol은 낮은 추론 강도로 86.6%(GPT-5.6 Sol 5.4%)를 39% 적은 비용으로 기록했고, 높은 강도에서 97.9%에 이르렀다.
- 발표
- 2026년 10월 19일(현지시간) · 오픈AI 발표문 「Advancing coding in low-resource programming languages」 + X 게시물(영상)
- 대상 언어
- COBOL · Fortran · Visual Basic · OCaml 등 학습 자료가 적은 저자원 언어
- COBOL 쓰임새(오픈AI 인용)
- 온라인 뱅킹 시스템 40% 이상 · 대면 신용카드 거래 80% · ATM 거래 95%
- MultiLangBench
- SQLite 호환 DB 엔진을 20개 언어로 처음부터 구축 · 평가 설정·테스트 모음 깃허브 공개
- GPT-6 Astra(최대 추론)
- 평균 87.4%(GPT-5.6 Sol 26.8%) · COBOL 72.1% · OCaml 85.8% · Fortran 83.5% · Visual Basic 89.4% · 19개 언어 83% 초과
- GPT-6 Luna(최대 추론)
- 평균 40.3% · 표본당 예상 API 비용 GPT-5.6 Sol 대비 약 78% 낮음
- COBOL 이전 평가
- C++·Java·Kotlin·Python·Rust로 이전 · 숨은 테스트 바이트 단위 일치 · 전부 통과해야 성공
- GPT-6.1 Sol
- 낮은 추론 강도 86.6%(GPT-5.6 Sol 5.4%) · 비용 39% 적음 · 높은 강도 97.9%
오픈AI(OpenAI)가 19일(현지시간) COBOL과 Fortran, Visual Basic 같은 저자원 프로그래밍 언어에서 자사 최신 AI 모델의 코딩 평가 결과를 공개했다. 새로 만든 평가 두 가지에서 최신 모델은 이전 세대보다 크게 높은 점수를 냈다. COBOL 프로그램을 다른 언어로 옮기는 평가에서 GPT-6.1 Sol은 낮은 추론 강도로 86.6%의 정확도를 기록했고, 같은 설정에서 GPT-5.6 Sol은 5.4%에 그쳤다. 추론 강도를 높이자 정확도는 97.9%까지 올라 평가가 거의 포화 상태에 이르렀다.
저자원 언어는 Python이나 JavaScript보다 모델이 배울 코드와 문서가 적은 언어를 가리킨다. 그런데도 이 언어들은 세계 곳곳의 핵심 기반 시설과 필수 서비스를 떠받친다. 오픈AI가 발표문에 인용한 수치에 따르면 COBOL은 온라인 뱅킹 시스템의 40% 이상, 대면 신용카드 거래의 80%, ATM 거래의 95%를 지탱한다. Fortran은 일기예보와 원자로 안전 해석에 쓰인다. 보도에 따르면 COBOL 수치는 IBM의 추산이다.
오픈AI는 X 게시물에서 "이 언어들은 은행과 정부, 기업이 의존하는 소프트웨어를 움직인다"며 "여기서의 진전은 수십 년 쌓인 비즈니스 로직을 이해하고, 잘 돌아가는 것은 지키면서 개발자가 그 시스템을 현대화하도록 돕는 것을 뜻한다"고 밝혔다. 회사는 이번 작업이 코딩 모델이 이런 언어에서 자주 헤맨다는 개발자와 기업 고객의 피드백에서 출발했다고 설명했다. 문서가 불완전하고, 원래 개발자가 회사를 떠났고, 중요한 업무 규칙이 코드 안에만 남아 있는 경우가 많다는 것이다. 메탈이 확인한 이 X 게시물의 조회수는 20일 오후 기준 50만 9천여 회, 좋아요는 4,600여 개였다.
첫 번째 평가 MultiLangBench는 모델에게 SQLite와 호환되는 데이터베이스 엔진을 20개 프로그래밍 언어로 처음부터 만들게 한다. 모델은 코드베이스를 짜고, 상태를 관리하고, 오류를 처리하고, 기존 기능을 깨뜨리지 않으면서 새 기능을 더해야 한다. 언어가 달라도 같은 잣대로 재기 위해 오픈AI는 데이터베이스 파일을 공통 접점으로 삼았다. 후보 프로그램이 초기 데이터베이스와 SQL 질의를 받아 수정된 데이터베이스를 내놓으면, 원본 SQLite 구현으로 결과물이 기대한 내용을 담았는지 확인한다. 시험 문항은 SQLite의 기존 테스트 모음을 이 형식에 맞게 고친 것이다.
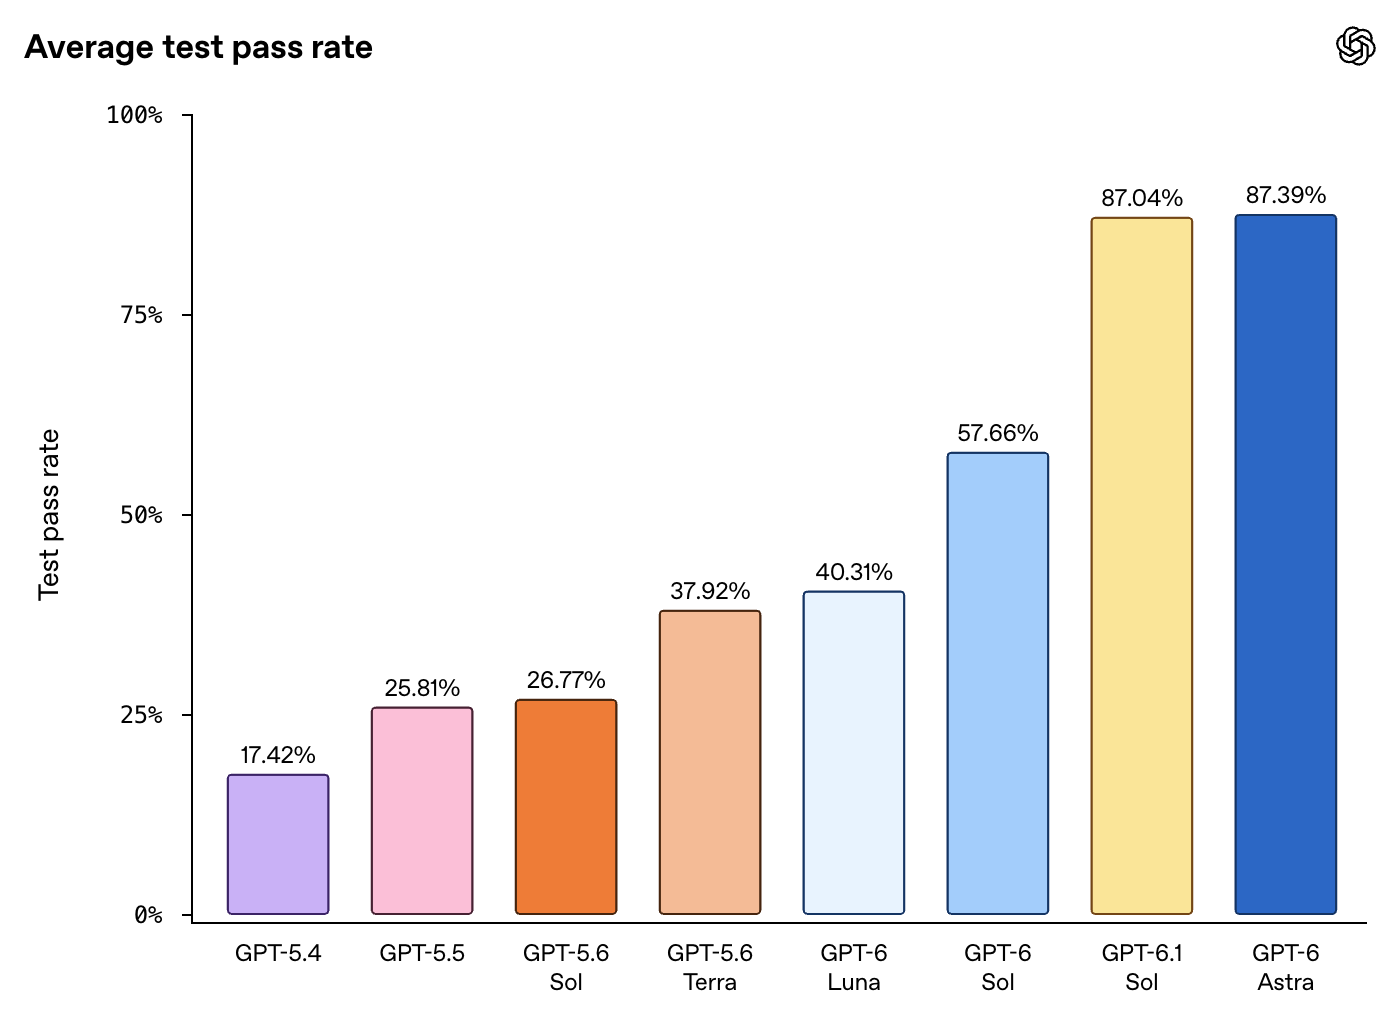
최대 추론 강도에서 GPT-6 Astra는 20개 언어 평균 87.4%의 테스트 통과율을 기록했다. GPT-5.6 Sol의 26.8%에서 크게 오른 수치이고, 시험한 모든 언어에서 점수가 올랐다. COBOL은 10.9%에서 72.1%로, OCaml은 25.6%에서 85.8%로, Fortran은 21.4%에서 83.5%로, Visual Basic은 27.5%에서 89.4%로 뛰었다. Astra는 20개 언어 가운데 19개에서 83%를 넘었고, COBOL만 72%로 가장 어려운 언어로 남았다. 공개된 도표에서 GPT-6.1 Sol의 평균 통과율은 87.04%로 Astra의 87.39%와 거의 같았고, GPT-6 Sol은 57.66%였다.
비용을 낮춘 선택지도 함께 나왔다. GPT-6 Luna는 최대 추론 강도에서 평균 40.3%를 기록해 모든 언어에서 GPT-5.6 Sol을 앞섰다. 언어별로는 COBOL 17.1%, OCaml 34.1%, Fortran 31.4%, Visual Basic 41.6%다. 오픈AI는 Luna의 표본당 예상 API 비용이 GPT-5.6 Sol보다 약 78% 낮다고 밝혔다. 회사는 MultiLangBench의 평가 설정과 테스트 모음, 언어별 결과를 깃허브에 공개해 개발자가 자기가 쓰는 언어의 성능을 직접 살피고 빈틈을 찾을 수 있게 했다.
두 번째 평가는 COBOL 프로그램을 C++, Java, Kotlin, Python, Rust 가운데 하나로 옮기면서 프로그램이 하던 일을 그대로 지키는지 본다. 이전이 성공하려면 프로그램의 업무 논리와 COBOL 고유의 언어 동작을 함께 이해해야 한다. 오픈AI가 든 예는 고정소수점 산술이다. COBOL은 반올림을 명시적으로 요청하지 않으면 남는 소수 자릿수를 버리는데, 이를 반올림하도록 옮긴 코드는 오류 없이 돌아가면서도 다른 금융 결과를 낸다. 그래서 평가는 관찰 가능한 출력이 바이트 단위까지 같아야 하는 숨은 테스트를 쓰고, 모든 테스트를 통과해야만 이전 성공으로 친다.
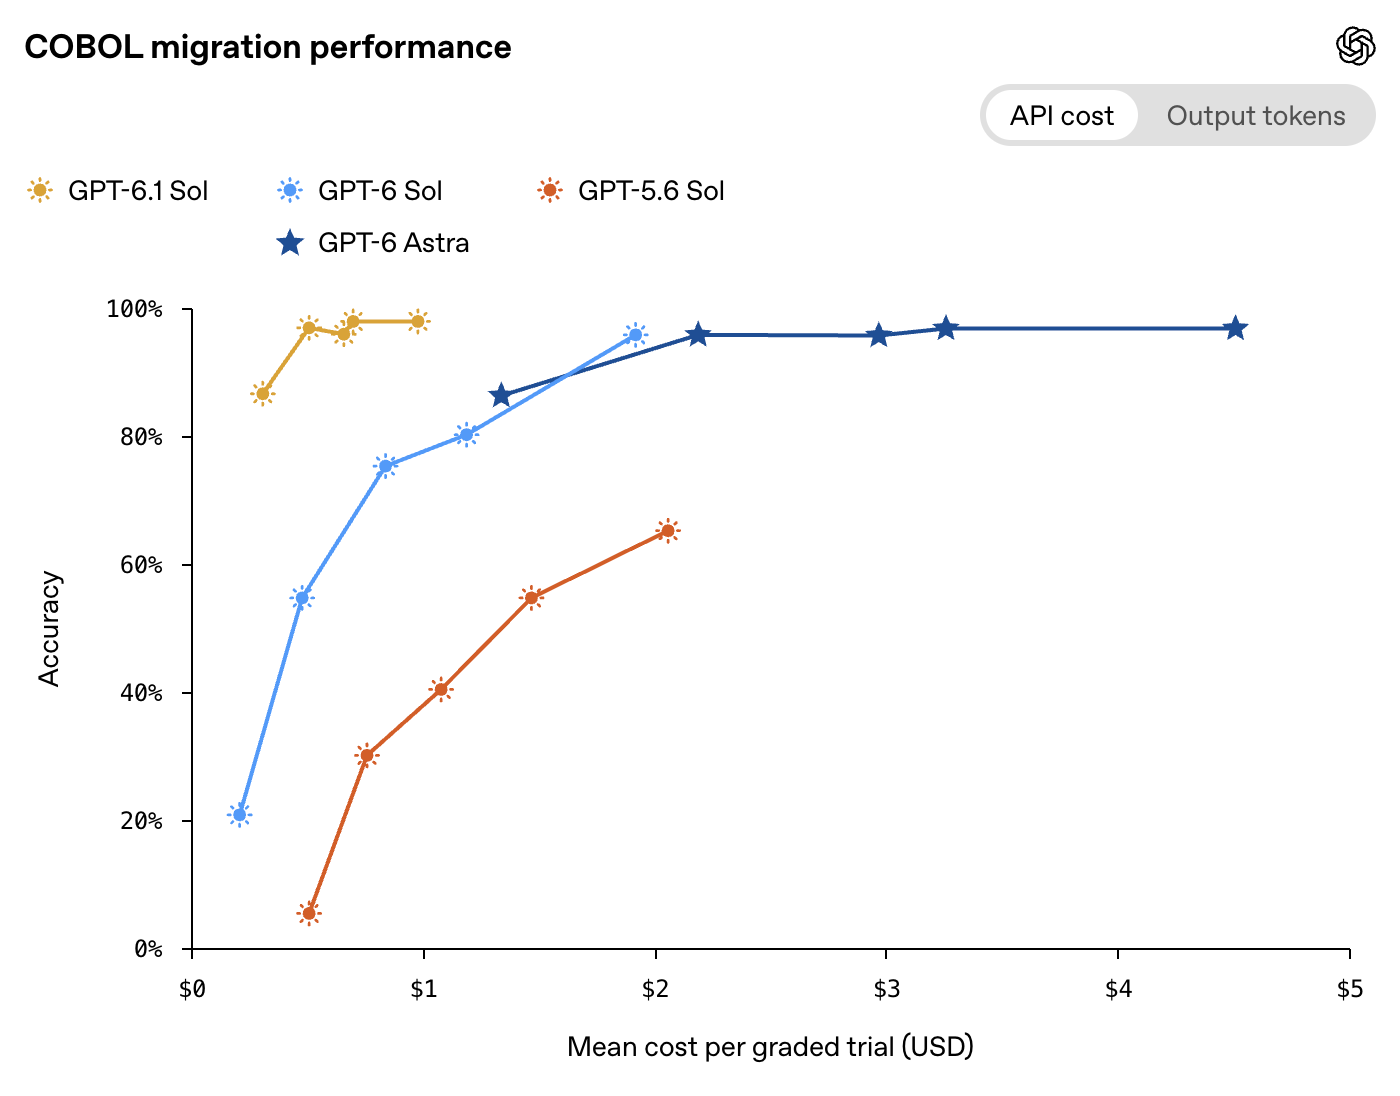
이 평가에서 GPT-6.1 Sol은 낮은 추론 강도로 86.6%를 기록했다. 같은 설정의 GPT-5.6 Sol은 5.4%였고, GPT-6.1 Sol이 쓴 API 비용은 그 61% 수준으로 39% 적었다. 추론 강도를 높이자 정확도는 97.9%에 이르렀다. 공개된 도표에서 GPT-6 Sol과 GPT-6 Astra도 90%대 중반까지 올라갔지만, 같은 정확도에 드는 시도당 평균 비용은 GPT-6.1 Sol이 가장 낮았다.
오픈AI는 발표문에서 "이런 동작 보존 능력은 오래된 시스템을 유지하고 현대화하는 팀에 유용하다"면서도 "운영 중인 소프트웨어에 적용하려면 여전히 전문가 검토와 시스템의 업무 규칙, 의존성에 맞춘 시험이 필요하다"고 밝혔다. 보도에 따르면 이번 발표는 별도 제품 출시가 아니라 기존 모델의 역량을 알리는 업데이트이고, 개발자는 API로 최신 모델을 자기 언어의 코딩 작업에 써 볼 수 있다.
평가 설계도 눈여겨볼 대목이다. 두 평가는 새 소프트웨어를 짓는 능력과 기존 소프트웨어가 하던 일을 지키는 능력을 따로 잰다. 데이터베이스 파일이라는 공통 접점과 바이트 단위 일치라는 기준은 언어마다 다른 문법을 건너뛰어 결과만으로 판정하게 해 준다. 오픈AI는 다음 목표로 낯선 저장소를 이해하고, 변경을 계획하고, 빌드 도구를 쓰고, 테스트를 돌리고, 실패를 디버깅하는 소프트웨어 공학 능력을 더 많은 언어로 넓히는 일을 꼽았다.
메탈은 오픈AI가 GPT-6 모델 가이드를 공개한 소식을 보도한 바 있으며, 이번 발표는 그 GPT-6 계열이 Python 바깥의 오래된 언어에서 어디까지 왔는지를 숫자로 보여 준다. 회사는 X 게시물 끝에서 다음에 다룰 언어와 작업 흐름을 알려 달라고 개발자들에게 요청했다. 은행 창구와 ATM 뒤에서 수십 년째 돌아가는 코드를 누가, 어떤 검증을 거쳐 옮길지가 남은 질문이다.
댓글