

이미지: 영상 갈무리
요약
- 오픈AI는 10월 26일 컴퓨터 사용과 시각 추론을 강화한 GPT-6.1 Terra를 ChatGPT Work·Codex·API에 공개했다.
- Agents' Last Exam에서 GPT-5.6 Terra보다 15%포인트 높은 점수를 약 3분의 1 비용으로 냈고, Terminal-Bench 4.0 점수는 21.5%에서 50.3%로 올랐다.
- 어려운 질문의 사실 오류율은 낮은 추론에서 53.6%에서 16.7%로 떨어졌고, 사이버보안 항목은 준비 프레임워크의 Critical 기준에 해당했다.
- 발표
- 2026년 10월 26일(현지 시각) · 오픈AI 「Introducing GPT-6.1 Terra」
- 배포
- ChatGPT Work·Codex(Plus·Pro·Enterprise·Edu) · API gpt-6.1-terra
- 요금
- 표준 API 요금 GPT-5.6 Terra·GPT-6.1 Sol 대비 50% 낮음
- Agents' Last Exam
- 중간 추론 GPT-5.6 Terra 대비 +15%p · 비용 약 3분의 1 · GPT-6 Astra와 비슷(토큰당 가격 10분의 1)
- Opus 5.5 비교
- 최대 추론 토큰 효율 3배 이상 · 토큰당 가격 4분의 1 · 과제당 비용 약 9배 낮음
- 속도
- GPT-6 Astra·GPT-6.1 Sol보다 3배 이상 빠름
- OSWorld 2.1
- 중간 추론으로 GPT-5.6 Terra 최고 점수 초과
- 사실 오류율
- 낮은 추론 53.6%→16.7% · 최대 추론 4.3%(-18%p)
- Terminal-Bench 4.0
- 최대 추론 50.3% · GPT-5.6 Terra 21.5%
- Terminal-Bench-Science 0.1
- GPT-6.1 Sol 초과 · Opus 5.5와 5점 이내 · 추정 비용 5분의 1 미만
- API 사양
- 컨텍스트 105만 토큰 · 최대 출력 12만 8,000토큰 · 지식 기준일 2026년 6월 1일 · 미세 조정 미지원
- 안전
- 준비 프레임워크 사이버보안 Critical 기준 · GPT-6 Astra 보호 장치 유지
오픈AI가 화면을 읽고 소프트웨어를 직접 조작하는 중형 모델 GPT-6.1 Terra를 10월 26일(현지 시각) 공개했다. 표준 API 요금은 전작 GPT-5.6 Terra와 상위 모델 GPT-6.1 Sol의 절반으로 내렸다. 오픈AI는 발표문에서 GPT-6.1 Terra를 "빠르고 효율적인 모델"이라고 소개하며 정밀한 시각 추론과 컴퓨터 사용, 더 자연스러운 글쓰기를 한 모델에 묶었다고 밝혔다. 같은 날 ChatGPT Work와 Codex의 Plus·Pro·Enterprise·Edu 사용자 전원에게 배포됐고, 개발자는 API에서 gpt-6.1-terra라는 이름으로 부를 수 있다.
오픈AI가 내세운 근거는 비용 대비 성능이다. 건축 도면을 3D 모델로 옮기거나 애니메이션 영화를 한 컷씩 검토해 복원팀용 타임코드 기록을 만드는 전문 업무 벤치마크 Agents' Last Exam에서, 중간 추론 강도의 GPT-6.1 Terra는 GPT-5.6 Terra보다 15%포인트 높은 점수를 약 3분의 1 비용으로 냈다. 최상위 모델 GPT-6 Astra와는 토큰당 가격 10분의 1로 비슷한 점수를 기록했다고 회사는 밝혔다. 최대 추론에서는 앤스로픽 Claude Opus 5.5보다 토큰 효율이 3배 넘게 높고 토큰당 가격은 4분의 1이어서, 과제당 비용이 약 9배 낮다는 것이 오픈AI의 계산이다. 과제 처리 속도도 GPT-6 Astra와 GPT-6.1 Sol보다 3배 이상 빨랐다.
데스크톱 앱을 여러 단계로 다루는 능력을 재는 OSWorld 2.1에서도 비슷한 흐름이 나왔다. 중간 추론의 GPT-6.1 Terra가 GPT-5.6 Terra의 최고 점수를 넘었고, 과제당 비용은 그 일부에 그쳤다. 시각 추론 벤치마크 MMMU-Pro에서는 모든 추론 설정에서 전작을 앞섰고, GPT-6 Astra와 GPT-6.1 Sol의 점수에 근접했다. 오픈AI가 예로 든 쓰임새는 들어오는 청구서를 읽고 회계 소프트웨어에 내용을 입력하는 일처럼 양이 많고 반복되는 작업이다.
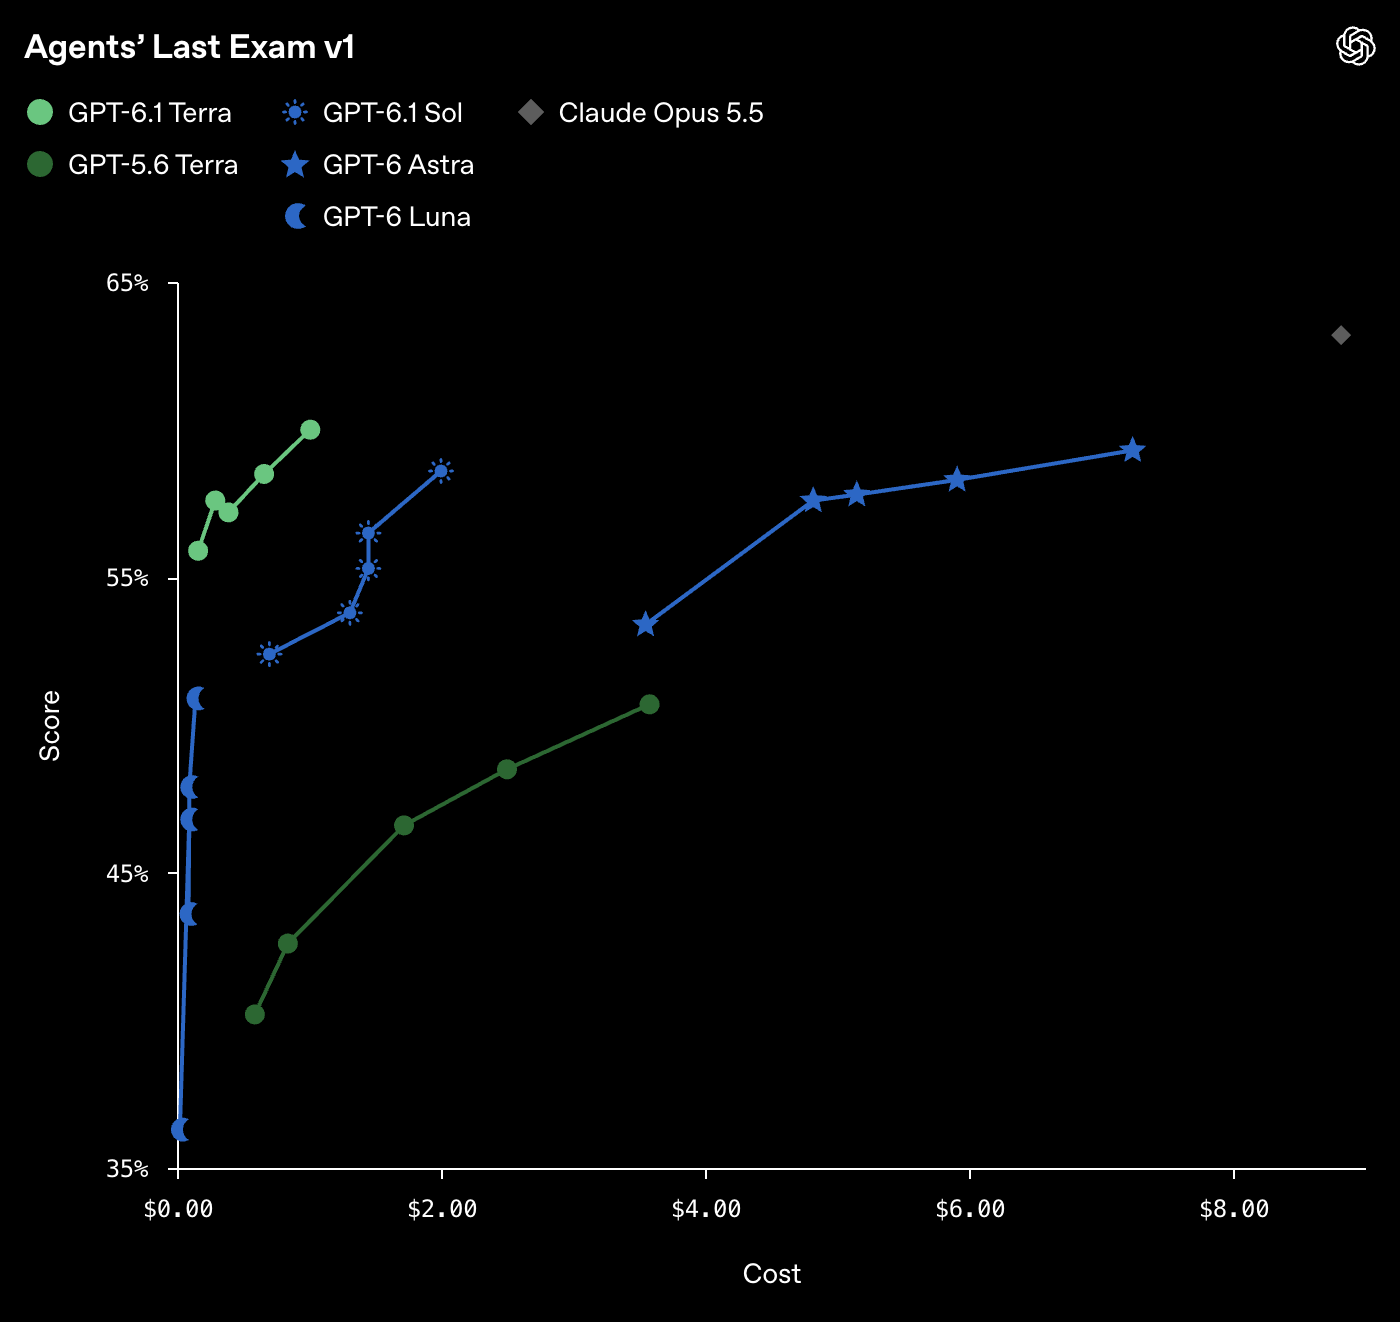
사실 오류도 크게 줄었다. 오류를 유도하도록 설계한 오픈AI 내부 벤치마크에서 낮은 추론 강도의 오류율은 GPT-5.6 Terra의 53.6%에서 16.7%로 37%포인트 가까이 떨어졌다. 최대 추론에서는 18%포인트 내려간 4.3%로, GPT-6 Astra와 GPT-6.1 Sol 수준에 가까워졌다. 오픈AI는 "올해 모델의 환각과 사실 오류를 줄이는 데 크게 투자했다"고 밝혔다.
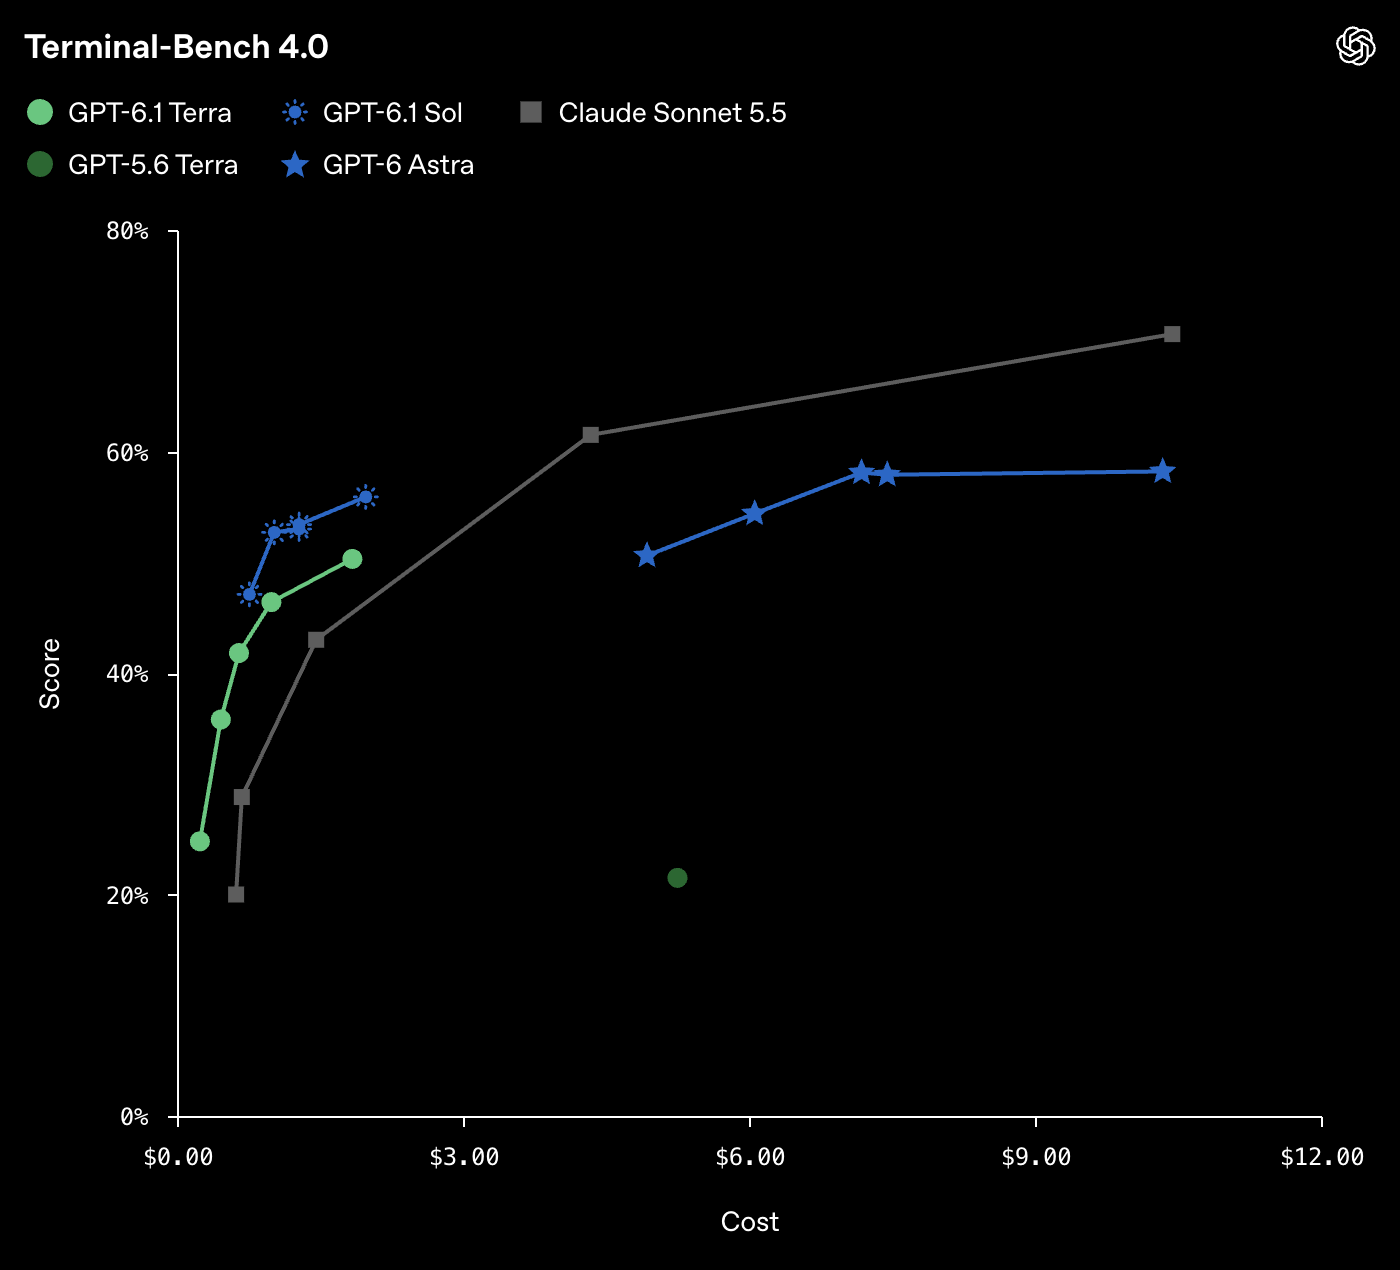
코딩 성적은 전작의 두 배를 넘었다. 명령줄에서 문제를 푸는 능력을 재는 Terminal-Bench 4.0에서 최대 추론의 GPT-6.1 Terra는 과제의 50.3%를 풀었고, GPT-5.6 Terra가 공개한 점수는 21.5%였다. 독립 평가 기관 아티피셜 애널리시스는 X에서 이 벤치마크에서 약 20점이 올라 최대 추론에서 GPT-6.1 Sol에 맞설 수준이 됐다고 평가했다. 이 기관은 GPT-6.1 Terra가 GPT-5.6 이후 첫 Terra급 모델이며 "3분의 1도 안 되는 비용으로 더 똑똑하다"고 밝혔다. 다만 오픈AI는 가장 복잡한 코딩 과제에는 여전히 GPT-6.1 Sol과 GPT-6 Astra가 낫다고 선을 그었다. 과학 연구 과제를 코드로 수행하는 Terminal-Bench-Science 0.1에서는 최대 추론의 GPT-6.1 Terra가 GPT-6.1 Sol을 더 낮은 비용으로 앞섰고, 추정 비용 5분의 1 미만으로 Opus 5.5와 5점 이내 차이를 보였다.
메탈이 확인한 API 모델 문서에 따르면 GPT-6.1 Terra의 컨텍스트 창은 105만 토큰, 최대 출력은 12만 8,000토큰이다. 지식 기준일은 2026년 6월 1일이고, 입력은 텍스트와 이미지, 출력은 텍스트만 받는다. 추론 강도는 none부터 max까지 여섯 단계로 고를 수 있고, 컴퓨터 사용·웹 검색·MCP·호스티드 셸 같은 도구를 Responses API에서 쓸 수 있다. 미세 조정은 지원하지 않는다. 오픈AI 개발자 계정은 X에서 "Terra로 이미지를 해석하고 소프트웨어를 탐색하며 행동하는 앱과 에이전트를 만들 수 있다"며 "대량 워크플로에 맞는 빠른 컴퓨터 사용을 더 낮은 비용으로 쓸 수 있다"고 밝혔다.
안전 등급은 높게 매겨졌다. 오픈AI는 GPT-6.1 Terra가 준비 프레임워크의 사이버보안 항목에서 Critical 기준에 해당하며, GPT-6 Astra를 위해 만든 보호 장치를 그대로 유지한다고 밝혔다. 회사 평가에서 GPT-6.1 Terra는 GPT-5.6 Terra보다 맡은 범위 안에 머물고 한계와 걸림돌을 사용자에게 정직하게 알릴 가능성이 높았고, 사용자의 과제에서 벗어나게 만드는 프롬프트 인젝션 시험에서도 강한 저항력을 보였다. 세부 내용은 시스템 카드에 담겼다.
메탈은 오픈AI가 GPT-6.1 Sol Ultrafast를 출시한 소식을 보도한 바 있다. 그때 경쟁 축이 응답 속도였다면, 이번 GPT-6.1 Terra는 컴퓨터 사용을 한 번 돌릴 때 드는 비용을 겨눈다. 이번 발표에서 눈여겨볼 숫자는 최고 점수가 아니라 단가다. 같은 사용량으로 처리할 수 있는 과제 수가 GPT-5.6 Terra보다 많고 GPT-6.1 Sol이나 GPT-6 Astra보다 훨씬 많다고 오픈AI는 밝혔다. 청구서 입력이나 양식 작성처럼 사람이 하루 종일 붙잡던 화면 업무가 자동화 견적표에 오르는 문턱이 그만큼 낮아졌다.
댓글