

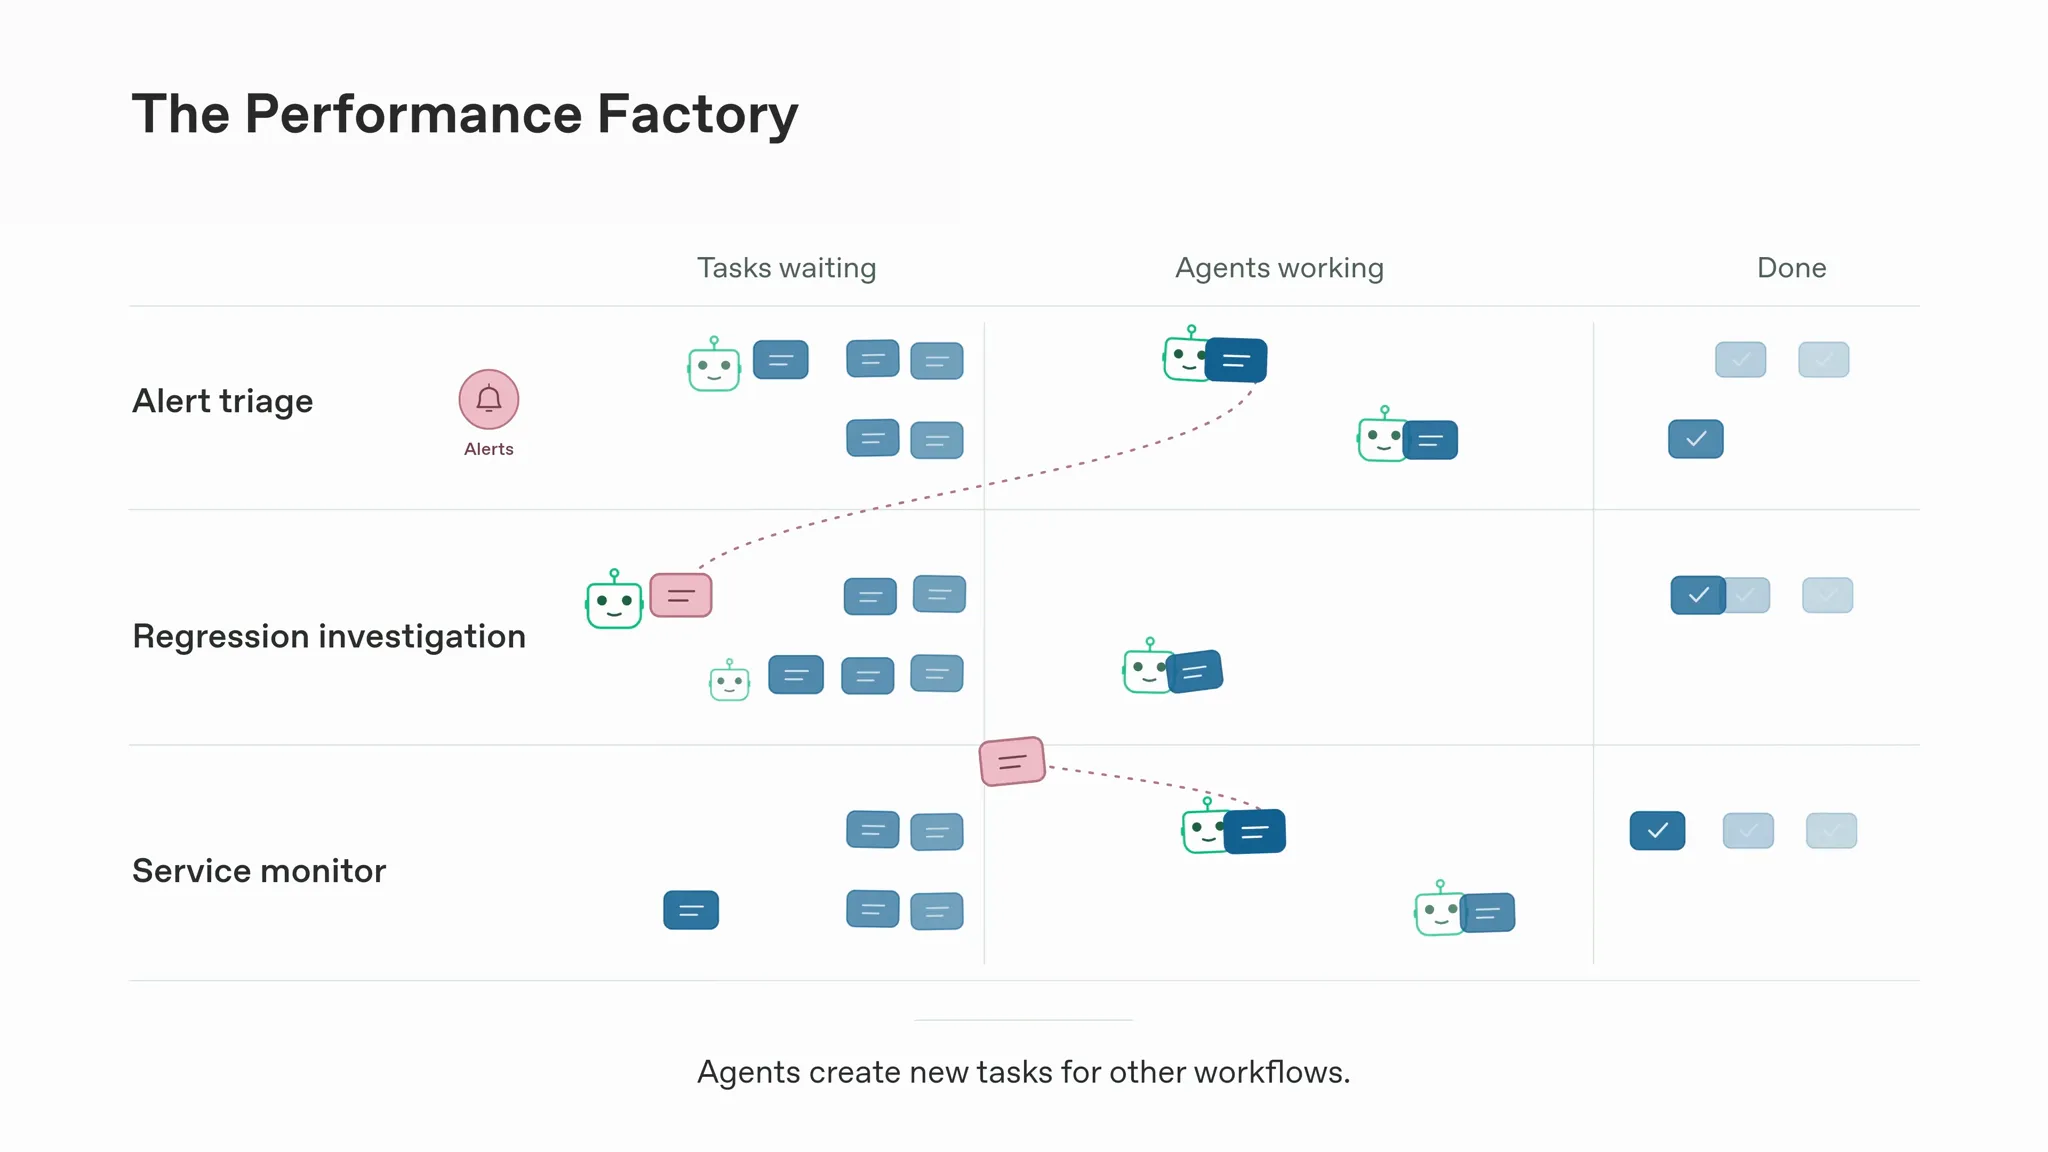
이미지: 영상 갈무리
요약
- 오픈AI는 11월 19일 성능 경보부터 원인 조사, 수정안 작성, 배포 뒤 회복 확인까지 Codex 에이전트가 맡는 내부 시스템 Performance Factory를 공개했다.
- 첫 워크플로인 회귀 워크플로는 석 달 남짓 동안 1,700건이 넘는 조사를 추적해 600건 넘는 근본 원인을 찾았고, 사람이 검토한 근본 원인 제안 100건 가운데 70%가 정확했다.
- 진단과 수정안마다 반박만 맡는 별도 Codex 세션이 붙고, 수정안 병합은 여전히 엔지니어가 결정한다.
- 발표
- 2026년 11월 19일 · 오픈AI 엔지니어링 블로그 · 오케이 제드·사이러스 포브스(기술 스태프)
- 실적
- 회귀 워크플로 석 달 남짓 · 조사 1,700건 이상 · 근본 원인 600건 이상 · 하루 17건꼴
- 정확도
- 근본 원인 제안 100건 수동 검토 · 70% 정확 · 30% 보완 필요
- 구성
- 작업 서비스(설정 파일·마크다운 프롬프트) · 디스패치 루프 · 클라우드 Codex 실행 API · 구독(깃허브 리뷰 댓글·배포 완료)
- 회귀 단계
- 감지 → 근본 원인(에이전트) → 수정안(에이전트) → 검토·배포(엔지니어) → 회복 확인(에이전트) → 해결
- 도구
- 성능 도구 30개 이상 · 공유 스킬 perf-forensics · 서비스 계정으로 실행
- 검증
- 진단·수정안 적대적 검토 · 과거 장애 백테스트 · 매일 도구 실패·권한 오류 점검
- 다음 단계
- 경보 없는 능동 감시 · 서비스 적정 규모 스킬 · 저위험 수정 자동 배포 검토
오픈AI가 11월 19일 ChatGPT의 성능 저하를 Codex 에이전트가 찾아 고치는 내부 시스템 Performance Factory를 공개했다. 성능 경보가 울리면 에이전트가 느려진 원인을 조사해 기록하고 엔지니어가 검토할 수정안을 낸다. 배포가 끝나면 다른 에이전트가 같은 작업을 이어받아 성능이 원래 수준으로 돌아왔는지 확인한다. 첫 워크플로인 회귀 워크플로는 석 달 남짓 동안 1,700건이 넘는 조사를 추적했고 600건 넘는 사례의 근본 원인을 찾았다. 하루 17건꼴로 자동 조사가 돌아간 셈이다.
글을 쓴 오케이 제드와 사이러스 포브스 오픈AI 기술 스태프는 "에이전트 개발의 엄청난 속도가 전통적인 성능 엔지니어링 방식을 더는 지속할 수 없게 만들었다"고 밝혔다. Codex로 제품을 만드는 속도가 빨라질수록 코드 변경이 늘고, 그만큼 응답을 늦추는 회귀도 잦아진다는 설명이다. 오픈AI 개발자 공식 계정은 같은 날 X에 23초짜리 흐름도 영상을 올리고 "Codex는 이미 ChatGPT를 더 빨리 만들도록 돕고 있고, 이제는 ChatGPT를 빠르게 유지하도록 돕고 있다"고 적었다.
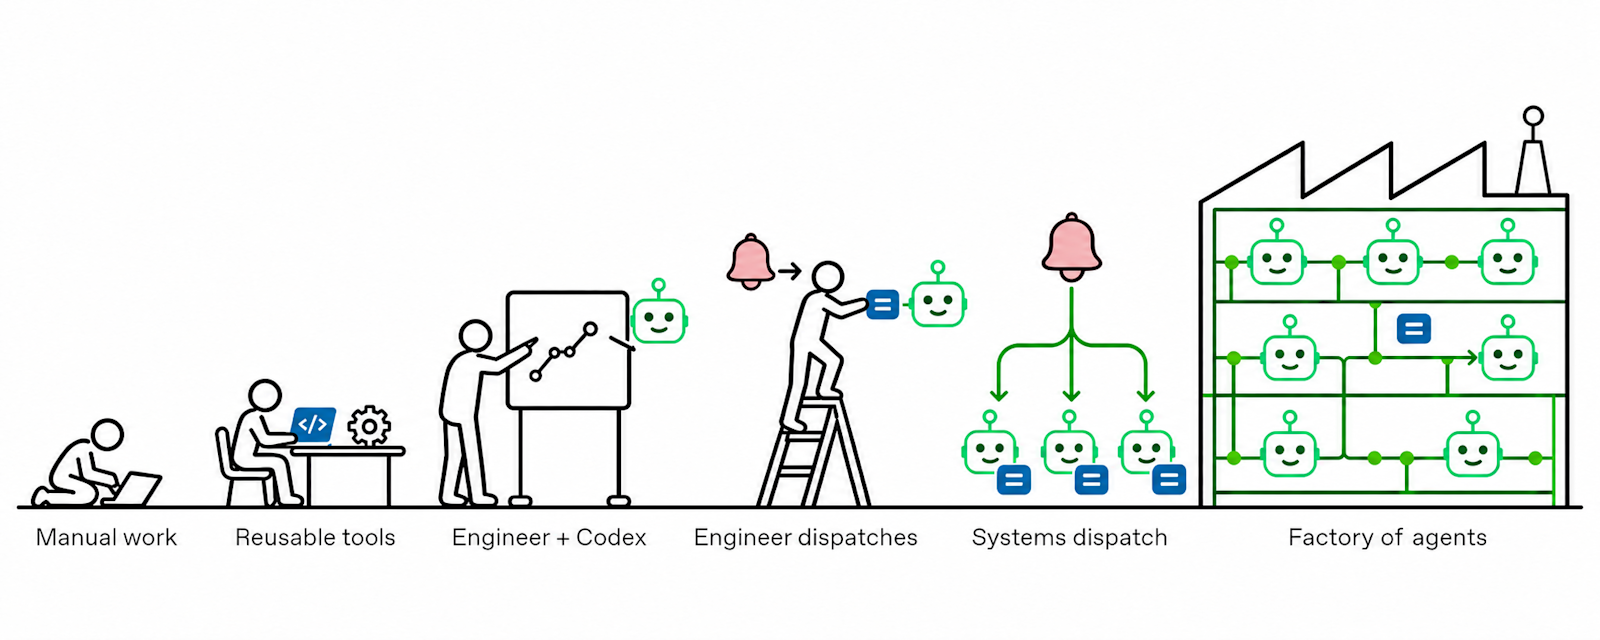
오픈AI는 이 시스템에 이르기까지 여섯 단계를 거쳤다고 설명했다. Codex 이전에는 엔지니어가 지표와 로그, 트레이스를 직접 비교하고 실서버를 디버깅하며 코드를 읽었다. 첫 토큰 지연 같은 문제가 되풀이되자 CPU 프로파일러와 메모리 할당 프로파일러 같은 도구를 만들었고, 그렇게 쌓인 성능 도구가 30개를 넘었다. 다음 단계에서 엔지니어는 Codex에 왜 느려졌는지 묻고 함께 조사했지만, 어떤 도구를 쓸지는 여전히 사람이 이끌었다. 팀은 조사 절차를 perf-forensics라는 공유 스킬에 담았고, 과거 회귀로 만든 평가로 이를 다듬은 끝에 경보 하나만 건네면 한 번의 실행으로 진단이 돌아오게 됐다.
그러자 엔지니어는 경보를 Codex에 붙여 넣고 결과를 다시 슬랙에 옮기는 사람 중계기가 됐다고 오픈AI는 적었다. 조사를 클라우드로 옮기자 경보가 Codex 세션을 자동으로 시작했지만, 진단 이후의 수정과 배포 뒤 확인은 여전히 사람 몫이었다. 마지막 단계가 공장, 곧 Performance Factory다. 작업마다 상태와 발견 내용을 따로 보관하기 때문에 일이 에이전트와 엔지니어 사이를 오가고, 코드 리뷰나 배포를 기다린 뒤에도 이어서 진행된다.
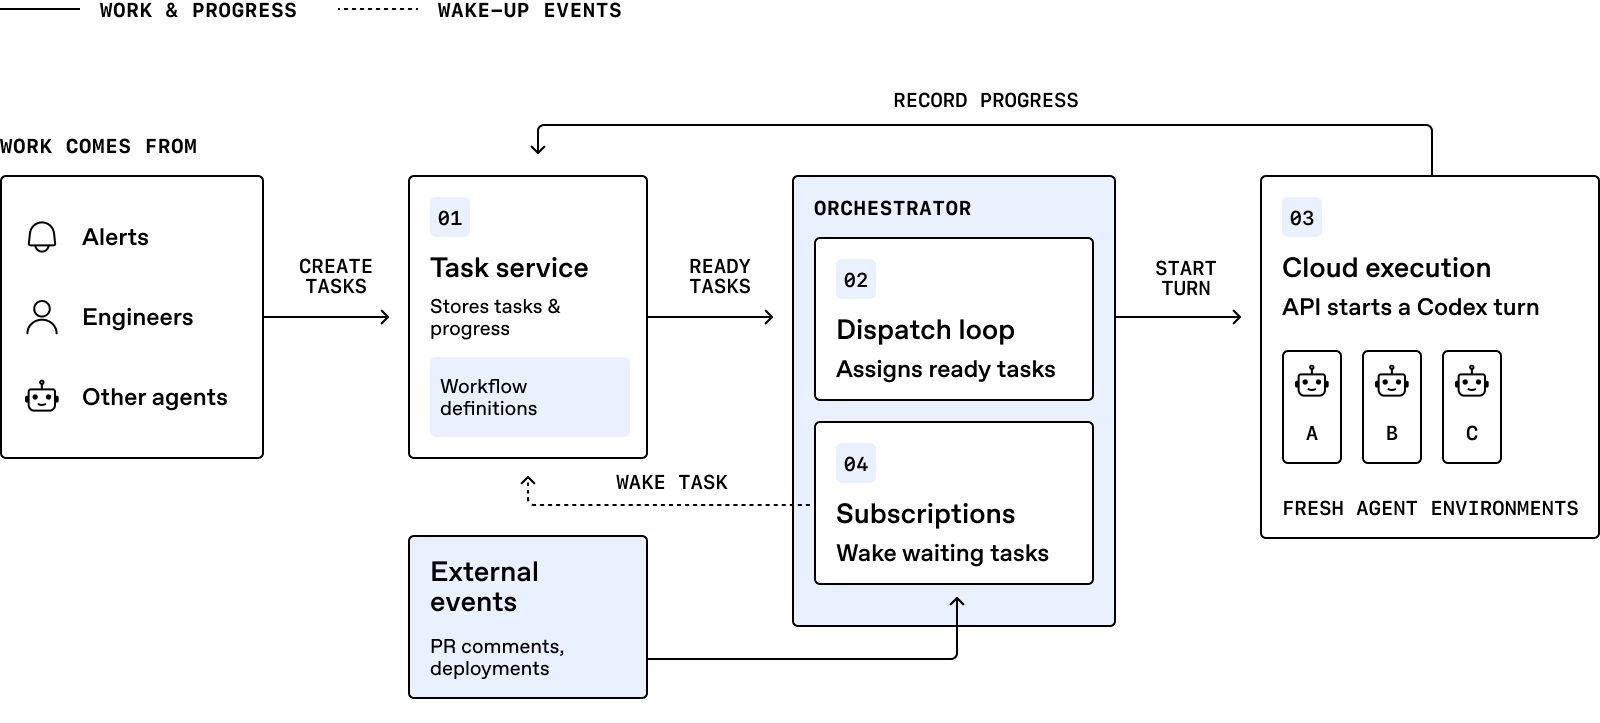
구조는 네 부분이다. 엔지니어가 설정 파일과 마크다운 프롬프트로 워크플로를 정의하는 작업 서비스, 다음 단계가 준비된 작업에 에이전트를 배정하는 디스패치 루프, 클라우드에서 Codex 턴을 실행하는 내부 API, 깃허브 리뷰 댓글이나 배포 완료 같은 사건이 생기면 기다리던 작업을 깨우는 구독 기능이다. Codex 턴은 사내 네트워크 안의 환경에서 코드 저장소와 지표, 로그, 트레이스, CPU 프로파일, 메모리 스냅샷에 접근한다. 에이전트는 서비스 계정으로 돌아가므로 권한 범위를 좁히고 어떤 조치가 성능 에이전트에서 나왔는지 가려낼 수 있다. 엔지니어의 노트북이 켜져 있지 않아도 여러 작업을 병렬로 돌릴 수 있다는 점도 클라우드로 옮긴 이유다.
회귀 워크플로에서 에이전트는 먼저 어떤 지표가 언제부터 나빠졌는지 거슬러 올라간다. 경보는 지표가 기준선을 넘을 때 울리지만 성능 저하는 몇 시간 전에 시작됐을 수 있기 때문이다. 이어 비슷한 요청이 실제로 느려졌는지, 아니면 원래 느린 요청이 더 많이 들어왔는지를 가른다. 두 경우는 원인이 다르다. 그다음 배포와 기능 플래그 변경을 살피고 관련 코드를 읽은 뒤, 로그와 트레이스로 그 변경이 실제로 영향을 받은 요청에 닿았는지 검증한다.
오픈AI는 초기 에이전트가 처음 찾은 그럴듯한 설명에서 멈추곤 했고 그중 일부는 틀렸다고 밝혔다. 그래서 진단을 반박하는 일만 맡는 별도 Codex 세션, 곧 적대적 검토를 붙였다. 한 조사에서 에이전트는 실패한 ChatGPT 대화를 이미지 다운로드 오류로 추적하고 원인을 찾았다고 표시했다. 검토 에이전트는 파일 위치를 찾는 내부 서비스가 이미 복구됐는데도 이미지 요청이 계속 실패한다는 점을 짚어 조사를 다시 열었다. 근본 원인 제안 100건을 사람이 직접 검토한 결과 70%가 정확했고, 30%는 보완이 필요하거나 인과를 다 입증하지 못했다.
진단이 검토를 통과하면 Codex가 수정 코드를 짜 풀 리퀘스트를 연다. 엔지니어는 회귀의 영향과 근본 원인, 수정안을 지표 시계열과 CPU 플레임 그래프, 트레이스와 함께 요약한 보고서를 받아 병합 여부를 정한다. 제드와 포브스는 "수정을 제대로 하는 일이 원인을 찾는 일보다 어려웠다"고 밝혔다. 에이전트의 수정안이 필요 이상으로 복잡하거나 새 문제를 낳은 사례가 있었고, 캐시를 붙이면 빨라지지만 오래된 데이터가 남는 것처럼 서비스를 아는 엔지니어가 저울질해야 하는 변경도 있다는 설명이다. 오픈AI는 수정안에도 적대적 검토를 붙였다. 배포 뒤 에이전트는 성능이 기준선으로 돌아왔는지 확인하고, 일부만 회복되면 원래 작업을 닫은 뒤 남은 저하에 새 작업을 연다.
메탈이 확인한 오픈AI 엔지니어링 블로그 원문은 에이전트 자체를 평가하는 방식도 적었다. 조사 능력은 과거 운영 장애를 시험 문제로 바꿔 다시 돌려 보는 백테스트로 잰다. 시험을 치르는 에이전트는 이전 조사에서 쌓은 기억이나 장애 보고서, 이전 실행 결과를 볼 수 없고, 오픈AI는 실행 기록을 뒤져 답이 새어 나갔는지도 확인한다. 문제가 언제 시작됐는지와 원인이 된 배포를 맞혔는지는 따로 채점한다. 시점을 맞히고도 엉뚱한 배포를 지목할 수 있어서다. 매일 한 번은 에이전트가 최근 실행의 도구 실패와 권한 오류를 훑고, 같은 오류가 여러 조사를 막으면 그 도구를 고치는 작업을 스스로 연다.
메탈은 오픈AI가 Codex 에이전트를 가두는 샌드박스 설계를 공개한 소식과 Codex를 장애 대응에 쓴 Ultrafast 사례를 보도한 바 있다. 이번 글은 같은 Codex를 회사 내부 운영, 그것도 ChatGPT의 응답 속도를 지키는 일에 붙인 사례다.
AI 엔지니어의 눈으로 보면 이 글의 핵심은 모델 성능보다 상태 기계다. 작업마다 허용된 상태와 전환, 사람이 맡을 단계를 설정 파일로 못 박아 두었기 때문에 에이전트 하나의 맥락이 끊겨도 일은 끊기지 않는다. 진단과 반박, 수정과 확인을 서로 다른 Codex 턴에 나눠 맡긴 것도 같은 설계에서 나왔다. 오픈AI는 지금 병목이 엔지니어가 수정안을 검토하고 병합하는 단계라며, 위험이 낮은 수정은 사람 없이 내보내는 방안을 검토하고 있다고 밝혔다. 경보가 울리지 않아도 CPU·메모리 프로파일과 힙 덤프, 요청 트레이스를 릴리스별로 비교해 작은 저하를 찾는 능동 감시, 필요 이상으로 많은 복제본을 띄운 자동 확장 설정을 찾는 서비스 적정 규모 스킬이 다음 워크플로 후보다. 제드와 포브스는 "다음에 ChatGPT를 쓰다 느려졌다고 느낀다면 Performance Factory가 이미 그 이유를 찾고 있을 가능성이 크다"고 적었다. 코드를 쓰는 에이전트가 늘어날수록 그 코드를 지키는 에이전트도 함께 늘어야 한다는 것이 오픈AI가 내놓은 답이다.
댓글