

이미지: METAL
요약
- 구글 리서치 연구진 4명이 10월 19일 동남아 12개 언어·5개 과제로 LLM을 평가하는 벤치마크 DEEPSEA 논문을 공개하고 데이터와 코드를 오픈소스로 풀었다.
- Gemini 3.7 Flash는 수학 추론에서 영어 99.2점, 저자원 언어 96.4점을 받았고, Qwen2.5 7B는 93.2점에서 36.2점으로 60% 넘게 떨어졌다.
- 모델은 목표 언어보다 영어로 생각하거나 영어 요약을 거칠 때 더 높은 점수를 냈고, 라오어 토큰 수는 GPT-5 토크나이저에서 영어의 7배 가까이 됐다.
- 발표
- 2026년 10월 19일 arXiv 2610.26155 · 10월 26일 구글 리서치 X 안내
- 저자
- 주저우 한(인턴) · 아비셰크 비제이 미슈라 · 트레버 콘 · 슈밤 미탈 — 구글 리서치
- 시연
- EMNLP 2026 구글 부스(D5) · 슈밤 미탈 실시간 데모
- 대상 인구
- 동남아시아 7억 명
- 고자원 4개
- 태국어 · 인도네시아어 · 베트남어 · 필리핀어
- 저자원 8개
- 세부아노어 · 일로카노어 · 자바어 · 크메르어 · 라오어 · 말레이어 · 순다어 · 미얀마어
- 과제 5개
- MGSM 수학 · IndoMMLU 과학(생물·화학·물리) · XQuAD 질의응답 · CrossSum 요약 · WMT24++ 번역
- 저자원 평가 세트
- 질의응답 9,520 · 번역 7,976 · 과학 5,880 · 요약 3,569 · 수학 2,000
- 공백
- 순다어·일로카노어·세부아노어 사용자 합계 6,000만 명 · 전 세계 벤치마크에 없음
- 번역 품질
- Auto-MQM 평균 0.86(기준 0.80) · 원어민 표본 검수 정확도 93.93%
- Gemini 3.7 Flash
- 수학 영어 99.2 → 저자원 96.4 · 과학 86.5 → 86.1
- Claude Sonnet 5
- 수학 영어 98.8 · 고자원 96.4 · 저자원 95.4
- SEA-LION v4 27B
- 저자원 수학 83.8
- Qwen2.5 7B
- 수학 영어 93.2 · 고자원 78.3 · 저자원 36.2
- Gemma 3
- 저자원 과학 27B 71.5 · 12B 63.6
- GPT-5.6 Luna
- 질의응답 F1 73.8 · 68.1 · 65.8(지시 불이행·의역)
- 영어 경유
- 영어 사고가 모국어 사고와 같거나 높음 · 영어 요약 후 번역 시 SEA-LION v4 저자원 chrF +4.4(고자원 +1.0)
- 토큰 효율
- 라오어 GPT-5 토크나이저 영어 대비 7배 근접 · Gemini 3 Pro 2.3배
- 공개
- github.com/google-research/deep-sea 오픈소스
구글 리서치가 동남아시아 12개 언어로 대형언어모델(LLM)을 시험하는 벤치마크 DEEPSEA를 공개했다. 10월 19일 아카이브에 올라온 논문에 따르면 프런티어 모델은 저자원 언어에서도 점수를 거의 잃지 않았지만, 70억~80억 파라미터급 오픈 웨이트 모델은 저자원 언어 묶음에서 수학 점수가 영어의 절반 아래로 떨어졌다. 모델이 목표 언어보다 영어를 거쳐 생각할 때 더 잘 푼다는 결과도 함께 나왔다. 구글 리서치는 10월 26일 X에서 EMNLP 2026 행사장 구글 부스(D5)에서 공동 저자 슈밤 미탈(Shubham Mittal)이 DEEPSEA 실시간 시연을 연다고 알렸다.
논문이 겨냥한 공백은 동남아 인구 7억 명이 쓰는 언어의 대부분이 기존 평가에서 빠져 있다는 점이다. 연구진은 SeaEval·SeaBench 같은 지역 벤치마크가 인도네시아어·베트남어·태국어 같은 국가 공용어에 몰려 있고, SEA-HELM은 다섯 개 언어만 다룬다고 지적했다. 순다어·일로카노어·세부아노어는 사용자를 합치면 6,000만 명인데, 연구진이 살펴본 전 세계 지식·추론 벤치마크 어디에도 들어 있지 않았다. DEEPSEA는 태국어·인도네시아어·베트남어·필리핀어를 고자원, 세부아노어·일로카노어·자바어·크메르어·라오어·말레이어·순다어·미얀마어를 저자원으로 나눴다.
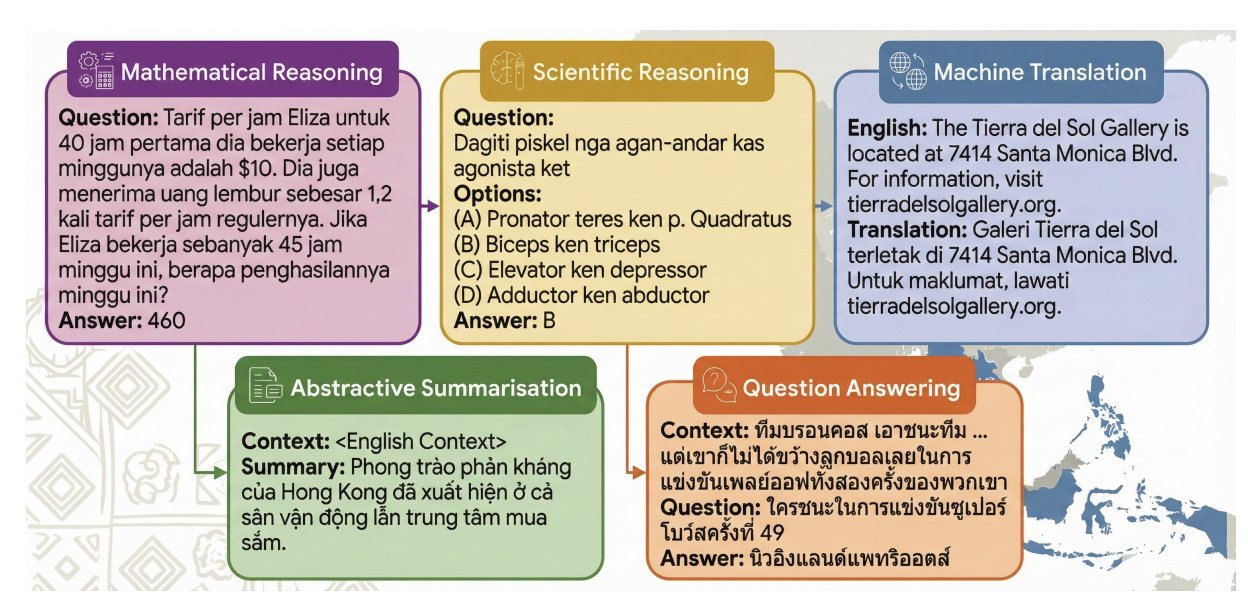
과제는 다섯 가지다. 수학 추론(MGSM), 생물·화학·물리 과학 추론(IndoMMLU), 지문 속 답 찾기(XQuAD), 영어 기사를 목표 언어로 요약하는 과제(CrossSum), 영어에서 목표 언어로 옮기는 번역(WMT24++)이다. 기존 데이터에 해당 언어가 없으면 전문 원어민 번역가에게 맡겼다. 저자원 8개 언어 평가 세트만 해도 질의응답 9,520건, 번역 7,976건, 과학 추론 5,880건이다. 메탈이 확인한 논문 부록에 따르면 자동 번역 품질 평가(Auto-MQM) 평균은 0.86으로 연구진이 전문가 수준으로 정한 0.80을 넘었고, 원어민이 문장의 5~10%를 뽑아 본 정확도는 93.93%였다.
성적표의 맨 위는 Gemini 3.7 Flash였다. 수학 추론에서 영어 99.2점, 저자원 언어 96.4점을 받아 차이가 2.8점에 그쳤다. 과학 추론은 86.5점에서 86.1점으로 거의 그대로였다. Claude Sonnet 5도 수학에서 영어 98.8점, 저자원 95.4점으로 바짝 붙었다. 오픈 웨이트 가운데 가장 높은 SEA-LION v4 27B는 저자원 수학에서 83.8점이었다. 다만 이 벤치마크를 만든 곳이 구글 리서치이고 1위가 구글 모델이라는 점은 독자가 함께 알아야 할 사실이다. 연구진은 평가를 온도 0의 제로샷으로 고정해 결과가 매번 같게 나오도록 했다.
격차가 벌어진 곳은 작은 모델이다. Qwen2.5 7B는 수학 추론에서 영어 93.2점, 고자원 78.3점, 저자원 36.2점으로 60% 넘게 떨어졌다. Llama 3.1 8B는 과학 추론 저자원 점수가 24.5점이었다. 연구진은 "작은 언어 모델은 목표 언어에 특화되지 않는 한 다국어 능력에서 뒤처진다"고 썼다. 같은 Gemma 3라도 27B는 저자원 과학 추론 71.5점, 12B는 63.6점으로 크기가 클수록 언어 간 전이가 강해졌다. GPT-5.6 Luna는 질의응답 F1이 저자원 65.8점으로 다른 과제보다 크게 낮았는데, 연구진은 지문 속 문구를 그대로 뽑으라는 지시를 따르지 않고 말을 바꿔 답한 탓이라고 분석했다.
가장 사회적인 함축을 지닌 결과는 언어 사이의 위계다. 연구진은 같은 수학·과학 문제를 영어로 생각하게 했을 때와 그 나라 말로 생각하게 했을 때를 비교했는데, 영어 쪽 정확도가 같거나 높았다. 요약도 영어로 먼저 요약한 뒤 번역시키면 SEA-LION v4 27B의 저자원 점수가 chrF 4.4점 올랐고 고자원은 1.0점에 그쳤다. 연구진은 "모델은 목표 언어보다 영어를 거칠 때 추론과 요약을 더 잘 해냈다"며 이를 영어 표현에 대한 결정적 의존이라고 불렀다. 모델이 동남아 언어를 말하는 것처럼 보여도 속으로는 영어로 계산하고 있다는 뜻이다.
오류의 결도 언어마다 달랐다. 일로카노어에서 「lawas」는 「주」를 뜻하지만 이웃 세부아노어에서는 「몸」이다. 실패한 풀이 일부에서 모델은 시간 단위가 나오는 문제를 몸과 건강 이야기로 풀어 나갔다. 미얀마어와 크메르어에서는 Gemini 3 Pro를 뺀 네 모델이 지문에 없는 답을 내놓는 비율이 치솟았고, 고유 숫자 표기를 쓰는 문서에서 모델이 아라비아 숫자를 내놓는 일이 잦았다. 토크나이저 분석에서는 라오어 문장을 쪼갤 때 GPT-5가 영어보다 7배 가까운 토큰을 썼고 Gemini 3 Pro는 2.3배였다. 같은 문장에 더 많은 토큰을 쓰면 계산 비용과 응답 시간이 그만큼 커진다.
메탈은 앞서 구글이 EMNLP 2026에 논문 31편을 낸 소식을 보도한 바 있으며, DEEPSEA는 그 가운데 동남아 언어만 따로 떼어 숫자로 보여 준 작업이다. 연구진은 영어나 인도네시아어 원문을 번역해 만든 데이터라 번역투가 섞일 수 있고, 수백 개 방언 가운데 12개만 다뤘다고 적었다. 데이터와 코드는 깃허브에 오픈소스로 공개됐다. 7억 명이 쓰는 언어를 모델이 얼마나 알아듣는지를 처음으로 한 표에 모은 이 벤치마크는, 큰 모델과 작은 모델 사이의 거리가 결국 어느 언어 사용자가 어떤 품질의 AI를 받느냐의 거리라는 사실을 드러냈다.
댓글