

이미지: METAL
요약
- 문샷 AI는 10월 26일 Kimi K3.1 Pro 구독 요금제의 속도 제한과 불필요한 사용량 소모를 사과하고 모든 구독자의 월간 사용량 25%를 한 차례 복구했다.
- 회사는 요금제 매개변수를 조정하고 불필요한 서브에이전트 호출과 출력 길이를 줄이고 있다고 밝혔다.
- K3.1 Pro는 Terminal-Bench 4.0에서 65.7%를 기록한 3T급 오픈 웨이트 모델로, 전체 가중치는 11월 4일까지 공개된다.
- 발표
- 2026년 10월 26일 · Kimi 공식 X 계정 사과문
- 보상
- 모든 요금제 구독자 월간 사용량 25% 1회 복구(일주일 치) · 25% 미만 사용자는 0으로 초기화
- 반영 시점
- 미국 태평양 표준시 10월 26일 하루가 끝나기 전
- 조치
- 요금제 매개변수 조정 · 불필요한 서브에이전트 호출과 출력 길이 축소
- 조회
- 사과 글 33만 회 이상
- 모델
- Kimi K3.1 Pro · K3.1 계열 첫 모델 · 3T급 오픈 웨이트 · 100만 토큰 컨텍스트 · Highspeed 2~3배 속도
- 가중치 공개
- 11월 4일까지
- Terminal-Bench 4.0
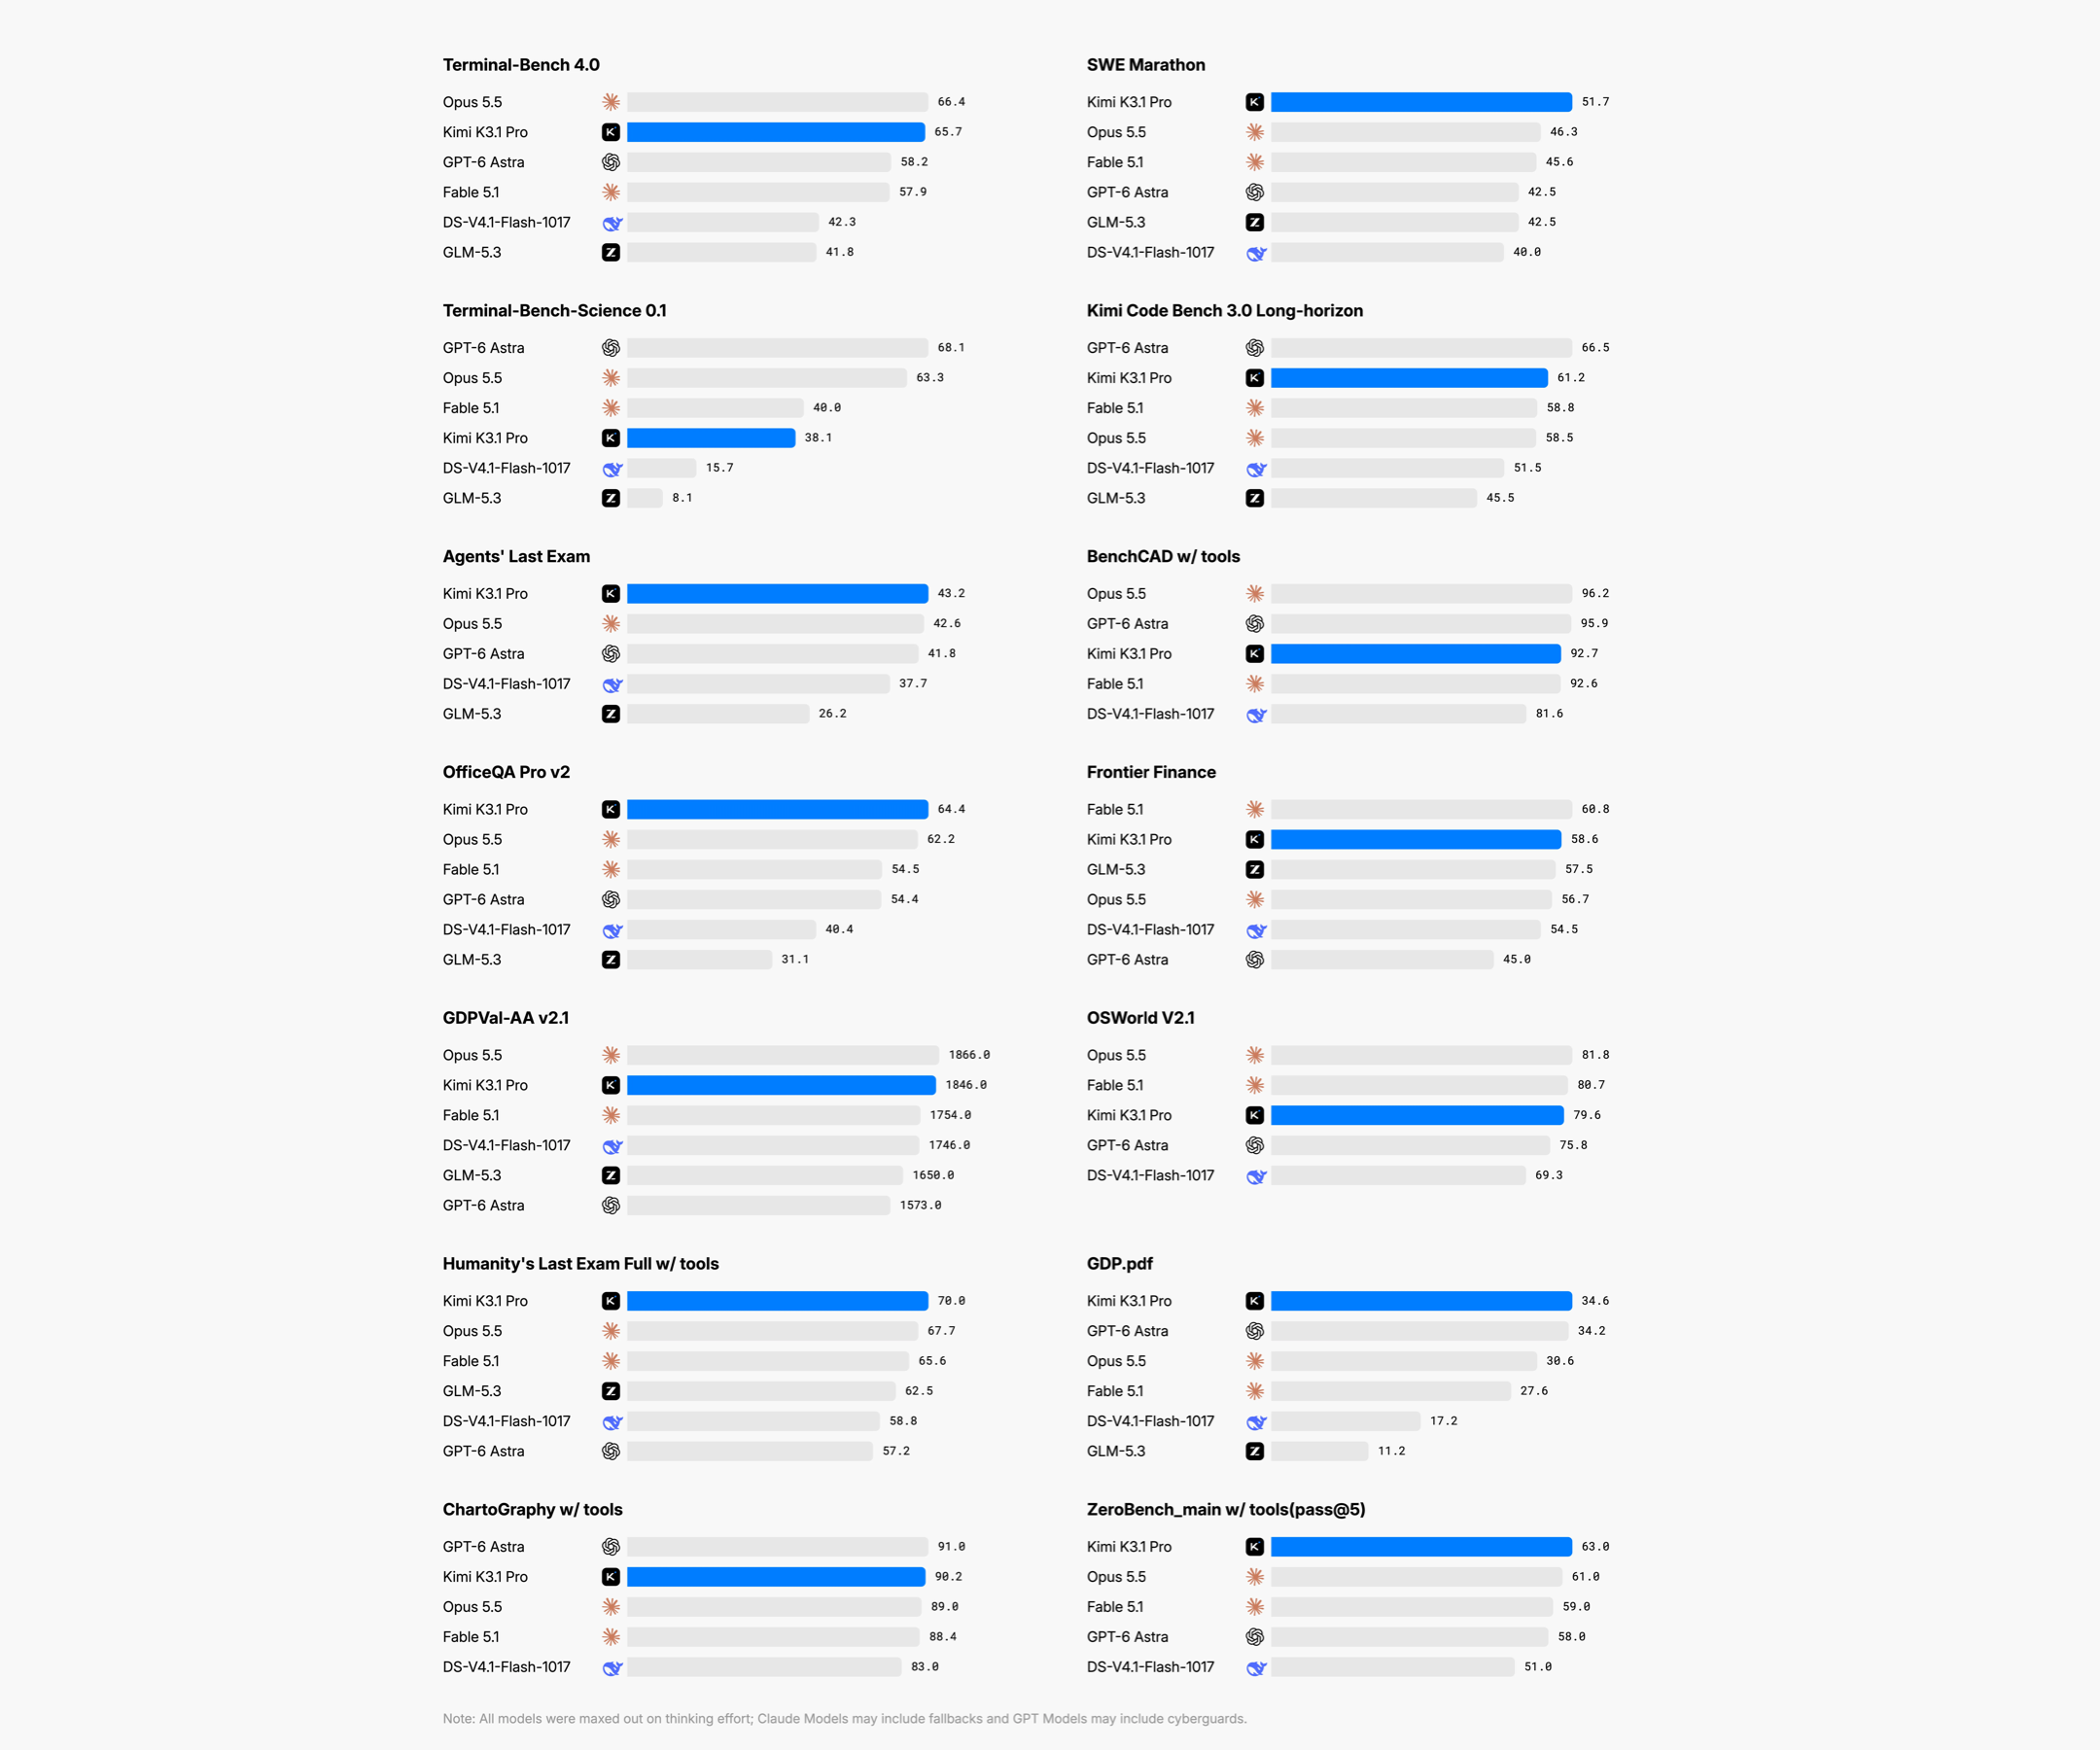
- K3.1 Pro 65.7% · GPT-6 Astra 58.2% · Claude Opus 5.5 66.4%
- Kimi Code Bench 3.0 Long-horizon
- K3.1 Pro 61.2% · K3 55.95%
- BenchCAD(도구 사용)
- K3.1 Pro 92.7% · Claude Opus 5.5 96.2% · GPT-6 Astra 95.9%
- OfficeQA Pro v2
- 64.4 · 회사 발표 최고 기록
- 환각 평가(어려운 문항)
- 주장 단위 환각 비율 K3 23.4% → K3.1 Pro 8.3%
- 아티피셜 애널리시스
- K3.1 Pro 55 · Claude Opus 5.5 58 · Claude Fable 5.1·GPT-6 Astra·Gemini 4 Argon 53
- 사이버 데이터 제거
- xdev-bench-hard 미조치 체크포인트 90.5% → 최종 81.0%
중국 AI 스타트업 문샷 AI가 새 모델 Kimi K3.1 Pro를 내놓은 지 이틀 만에 구독자에게 공개 사과했다. 회사는 10월 26일 Kimi 공식 X 계정에 K3.1 Pro 구독 요금제에서 생긴 속도 제한과 불필요한 사용량 소모를 두고 "이건 우리 문제였고, 더 빨리 고쳤어야 했다"고 밝혔다. 보상으로 모든 요금제의 모든 구독자에게 월간 사용량의 25%를 한 차례 복구해 주기로 했다. 회사는 이 양이 일주일 치 사용량에 해당한다고 설명했다.
복구 방식은 단순하다. 이미 쓴 사용량에서 월 한도의 25%만큼을 되돌리고, 사용량이 25%에 못 미친 구독자는 0으로 초기화한다. 회사에 따르면 사용량 막대에는 미국 태평양 표준시 기준 26일 하루가 끝나기 전에 조정이 반영된다. 사과 글은 메탈이 확인한 시점까지 33만 회 넘게 조회됐다.
문샷은 원인 쪽도 손봤다. 회사는 요금제의 매개변수를 조정했고, 불필요한 서브에이전트 호출과 출력 길이를 줄이고 있어 같은 한도로 더 오래 쓸 수 있게 된다고 밝혔다. 보도에 따르면 서브에이전트 호출은 여러 AI 에이전트가 작업을 나눠 맡는 과정을, 출력 길이는 질문 하나에 모델이 생성하는 토큰의 총량을 가리킨다. 같은 보도는 문샷이 직전 모델 K3를 냈을 때도 컴퓨팅 용량 문제를 겪었고, 중국 AI 연구소들이 미국의 반도체 수출 통제 이후 연산 자원 부족에 시달리고 있다고 전했다.
사용자가 몰린 이유는 모델 성능에 있었다. 메탈이 확인한 문샷의 기술 블로그에 따르면 Kimi K3.1 Pro는 새 K3.1 계열의 첫 모델이자 회사가 지금까지 낸 가장 강력한 3T급 오픈 웨이트 모델이고, 100만 토큰 컨텍스트를 지원한다. K3를 바탕으로 사후 학습 연산을 크게 늘렸고, 수백 개 분야를 아우르는 대규모 강화학습을 돌리기 위해 학습 프레임워크부터 샌드박스 인프라까지 손봤다고 회사는 설명했다. 속도가 2~3배 빠른 K3.1 Pro Highspeed도 함께 나왔고, 두 모델은 Kimi.ai와 Kimi Work, Kimi Code, Kimi API에서 바로 쓸 수 있다. 전체 모델 가중치는 11월 4일까지 공개한다.
공식 벤치마크는 미국 프런티어 모델과 겨룰 수준을 보여 준다. 실제 터미널 작업을 엄격한 테스트로 채점하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%로 GPT-6 Astra의 58.2%를 넘었고 Claude Opus 5.5의 66.4%에 바짝 붙었다. 사내 장기 코딩 평가인 Kimi Code Bench 3.0 Long-horizon에서는 61.2%로 K3의 55.95%보다 높았다. 다중 시점 렌더링을 보고 CAD 코드로 3D를 재구성하는 BenchCAD에서는 도구를 쓸 때 92.7%를 받아 Claude Opus 5.5의 96.2%, GPT-6 Astra의 95.9%에 다가섰다. 실제 재무 문서를 분석하는 OfficeQA Pro v2에서는 64.4로 최고 기록을 냈다고 회사는 밝혔다.
긴 작업 능력을 보여 주는 사례도 블로그에 실렸다. 뼈 부품 296개와 근육 부품 402개로 이뤄진 오픈소스 인체 모델 위에서 K3.1 Pro가 걷기 시뮬레이터를 만든 실험이다. 모델은 167개 임무와 420회의 독립 검토를 거치며 몇 초 만에 쓰러지던 가상 인체를 11.2초 동안 번갈아 걷게 만들었고, 그 과정에서 어깨 근육 계산 오류 36개를 스스로 찾아 고쳤다. 사내 환각 평가의 어려운 문항에서 주장 단위 환각 비율은 K3의 23.4%에서 8.3%로 내려갔다. 회사는 이 수치가 일부러 오류를 유도하도록 만든 문항의 결과이고 일상 사용의 오류율이 아니라고 적었다.
외부 평가도 비슷한 그림이다. 개발자 사이먼 윌리슨은 자신의 블로그에서 독립 평가 기관 아티피셜 애널리시스가 K3.1 Pro에 55점을 매겨 Claude Fable 5.1과 GPT-6 Astra, Gemini 4 Argon(모두 53점)을 앞섰고 Claude Opus 5.5(58점)에만 뒤졌다고 전했다. 그는 "곧 오픈 웨이트가 될 모델이 프런티어와 견줘 이만큼 높은 점수를 받은 것은 처음"이라고 평가했다. 메탈은 미국 코딩 에이전트 회사 코그니션이 직전 모델 Kimi K3 위에 SWE-2를 세운 소식을 보도한 바 있다. 중국 오픈 웨이트 모델이 미국 제품의 바탕이 되는 흐름이 한 세대 만에 점수표 위로 올라온 셈이다.
공개 범위는 보안 능력과 맞물려 정해졌다. 문샷은 사후 학습 규모를 키울수록 취약점 연구 능력이 꾸준히 오르는 것을 관찰했고, 그 원천을 추적해 중간 학습 말뭉치와 강화학습 환경 양쪽에서 사이버 관련 데이터를 걷어 냈다. 자체 공격 평가인 xdev-bench-hard에서 이 조치를 하지 않은 체크포인트는 문제의 90.5%를 풀었고, 최종 K3.1 Pro는 81.0%를 풀었다. 회사는 "사이버 능력의 절대적 최전선을 넓히는 오픈 웨이트는 공개하지 않는 것을 목표로 한다"고 밝혔다. 기업용 Kimi Enterprise에서는 관리자가 켜야만 K3.1 Pro를 쓸 수 있게 출시 시점의 접근을 기본으로 꺼 두었다.
이번 사과는 에이전트 시대 구독 요금제의 계산법이 어디서 어긋나는지 드러낸다. 엔지니어링 관점에서 사용량을 가장 크게 움직인 변수로 회사가 직접 지목한 것은 모델의 답 한 번이 아니라 서브에이전트 호출 횟수와 출력 길이였다. 강화학습으로 긴 작업을 끝까지 밀어붙이도록 길러진 모델일수록 한 요청이 여러 하위 작업과 긴 출력으로 불어나고, 그만큼 구독자의 한도가 빨리 닳는다. 문샷은 일주일 치 사용량을 되돌리고 호출 구조를 줄이는 것으로 출시 첫 주의 불만에 답했다. 11월 4일 가중치가 풀리면 같은 모델을 자기 인프라에서 돌리는 팀이 생기고, 사용량의 계산은 문샷의 서버 밖으로도 넘어간다.
댓글