

구글, 동남아 12개 언어 벤치마크 DEEPSEA 공개
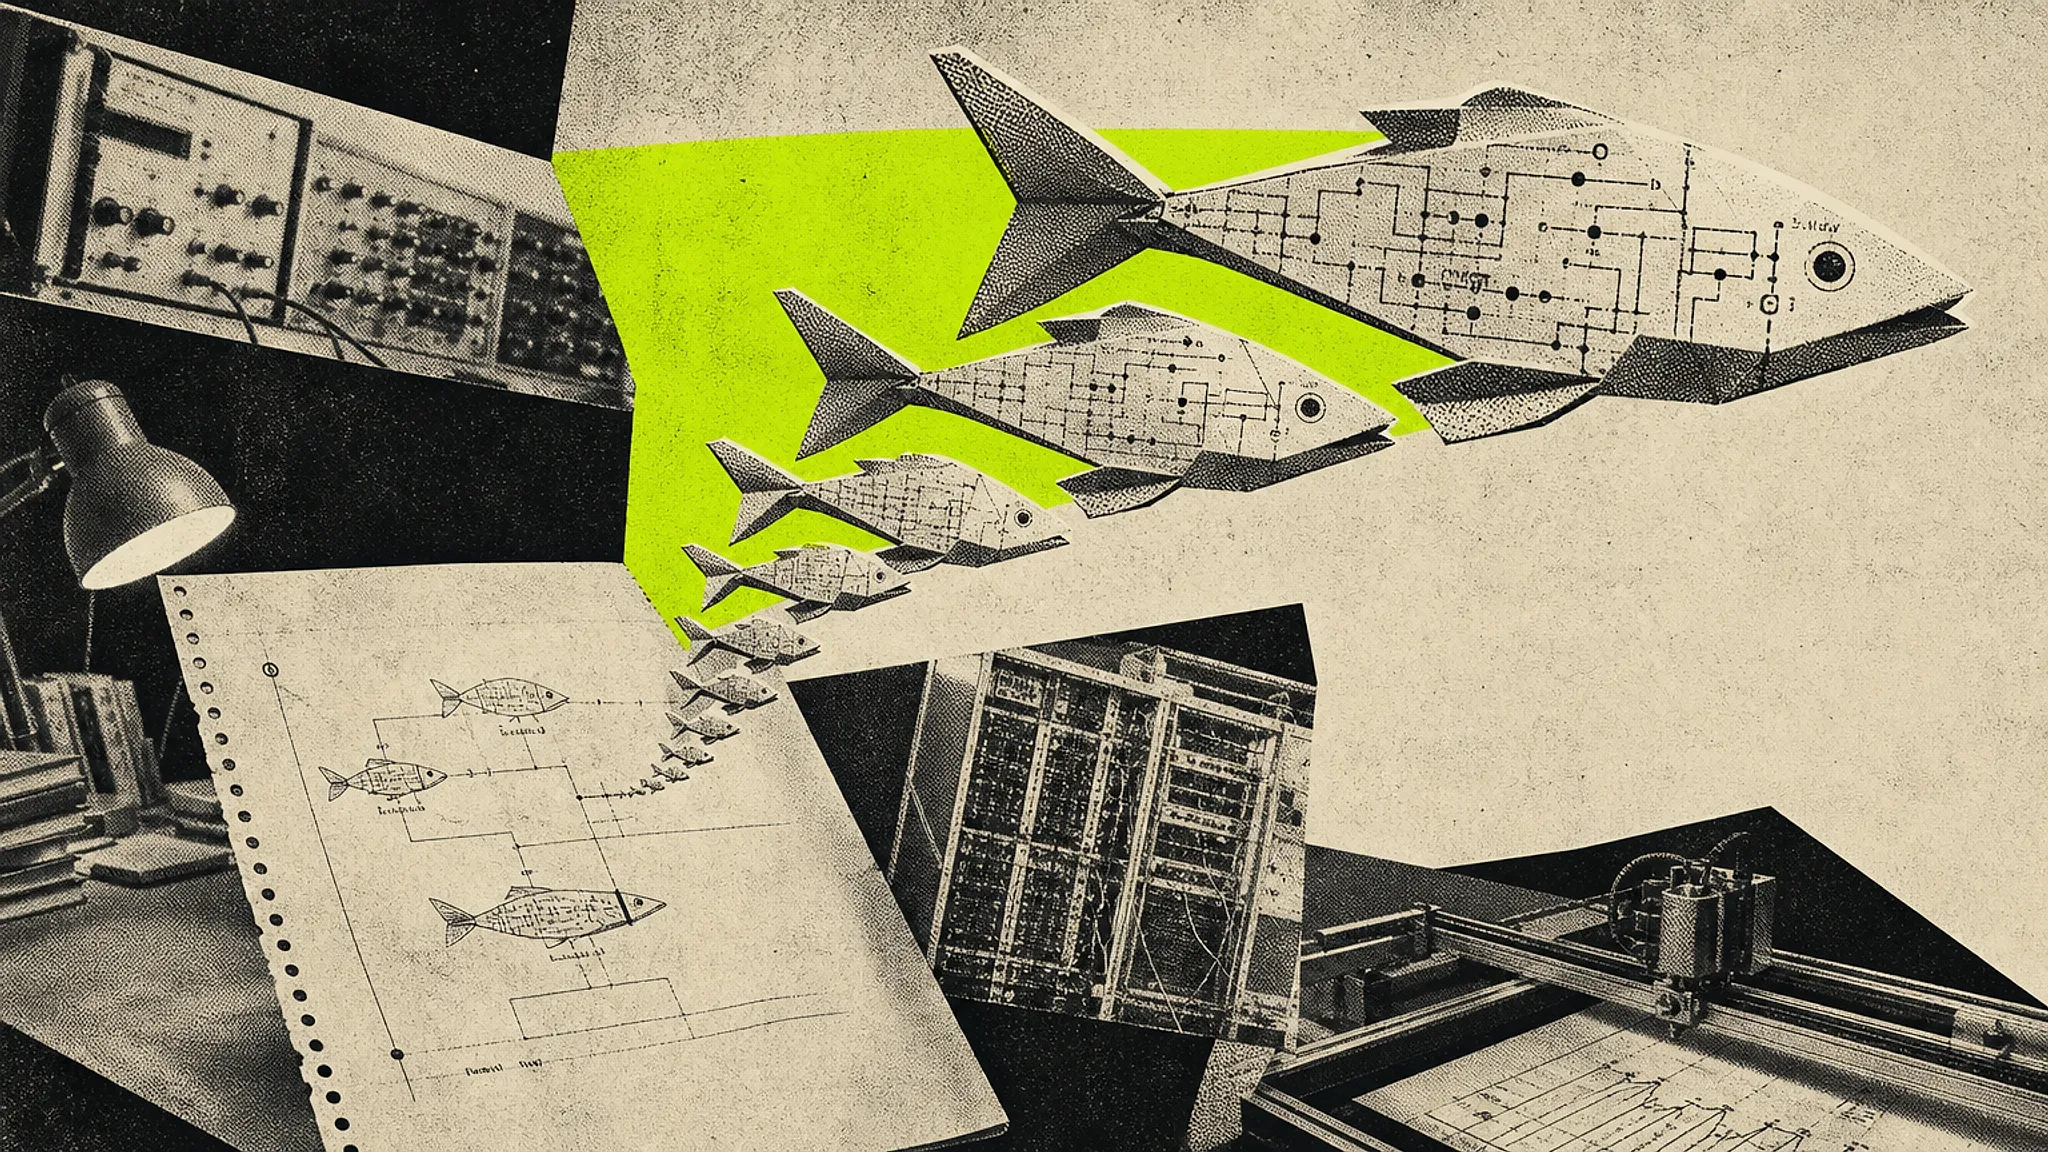
구글 리서치가 동남아시아 12개 언어로 LLM의 수학·과학 추론, 질의응답, 요약, 번역을 재는 벤치마크 DEEPSEA를 공개했다. 프런티어 모델은 저자원 언어에서도 버텼지만 작은 오픈 웨이트 모델은 크게 무너졌고, 모델 대부분이 영어를 거칠 때 더 잘 풀었다.
50
태그
구글 리서치가 동남아시아 12개 언어로 LLM의 수학·과학 추론, 질의응답, 요약, 번역을 재는 벤치마크 DEEPSEA를 공개했다. 프런티어 모델은 저자원 언어에서도 버텼지만 작은 오픈 웨이트 모델은 크게 무너졌고, 모델 대부분이 영어를 거칠 때 더 잘 풀었다.
구글 리서치가 위성·기상·인구 모델을 묶은 지리공간 추론 에이전트의 기술 보고서를 공개하고 실험 접근을 넓혔다. 전문가 과제에서 도구 없는 모델은 0점, 에이전트는 62.7점을 받았다.
사카나AI가 논문 속 모순을 AI 심사 시스템이 얼마나 잡는지 재는 벤치마크와 심사 보조 시스템 MLR을 담은 논문을 공개했다. MLR은 핵심 주장을 뒤집은 모순의 73.43%를 잡았고 기존 시스템은 11~15%에 그쳤다.
오픈AI가 퀀트 트레이딩 회사 점프 트레이딩이 GPT-6 Astra로 며칠짜리 시장 연구를 에이전트에게 맡기는 사례를 공개했다. 에이전트가 낸 거래 신호도 틀릴 수 있는 입력으로 보고 사람이 마지막에 검증한다.
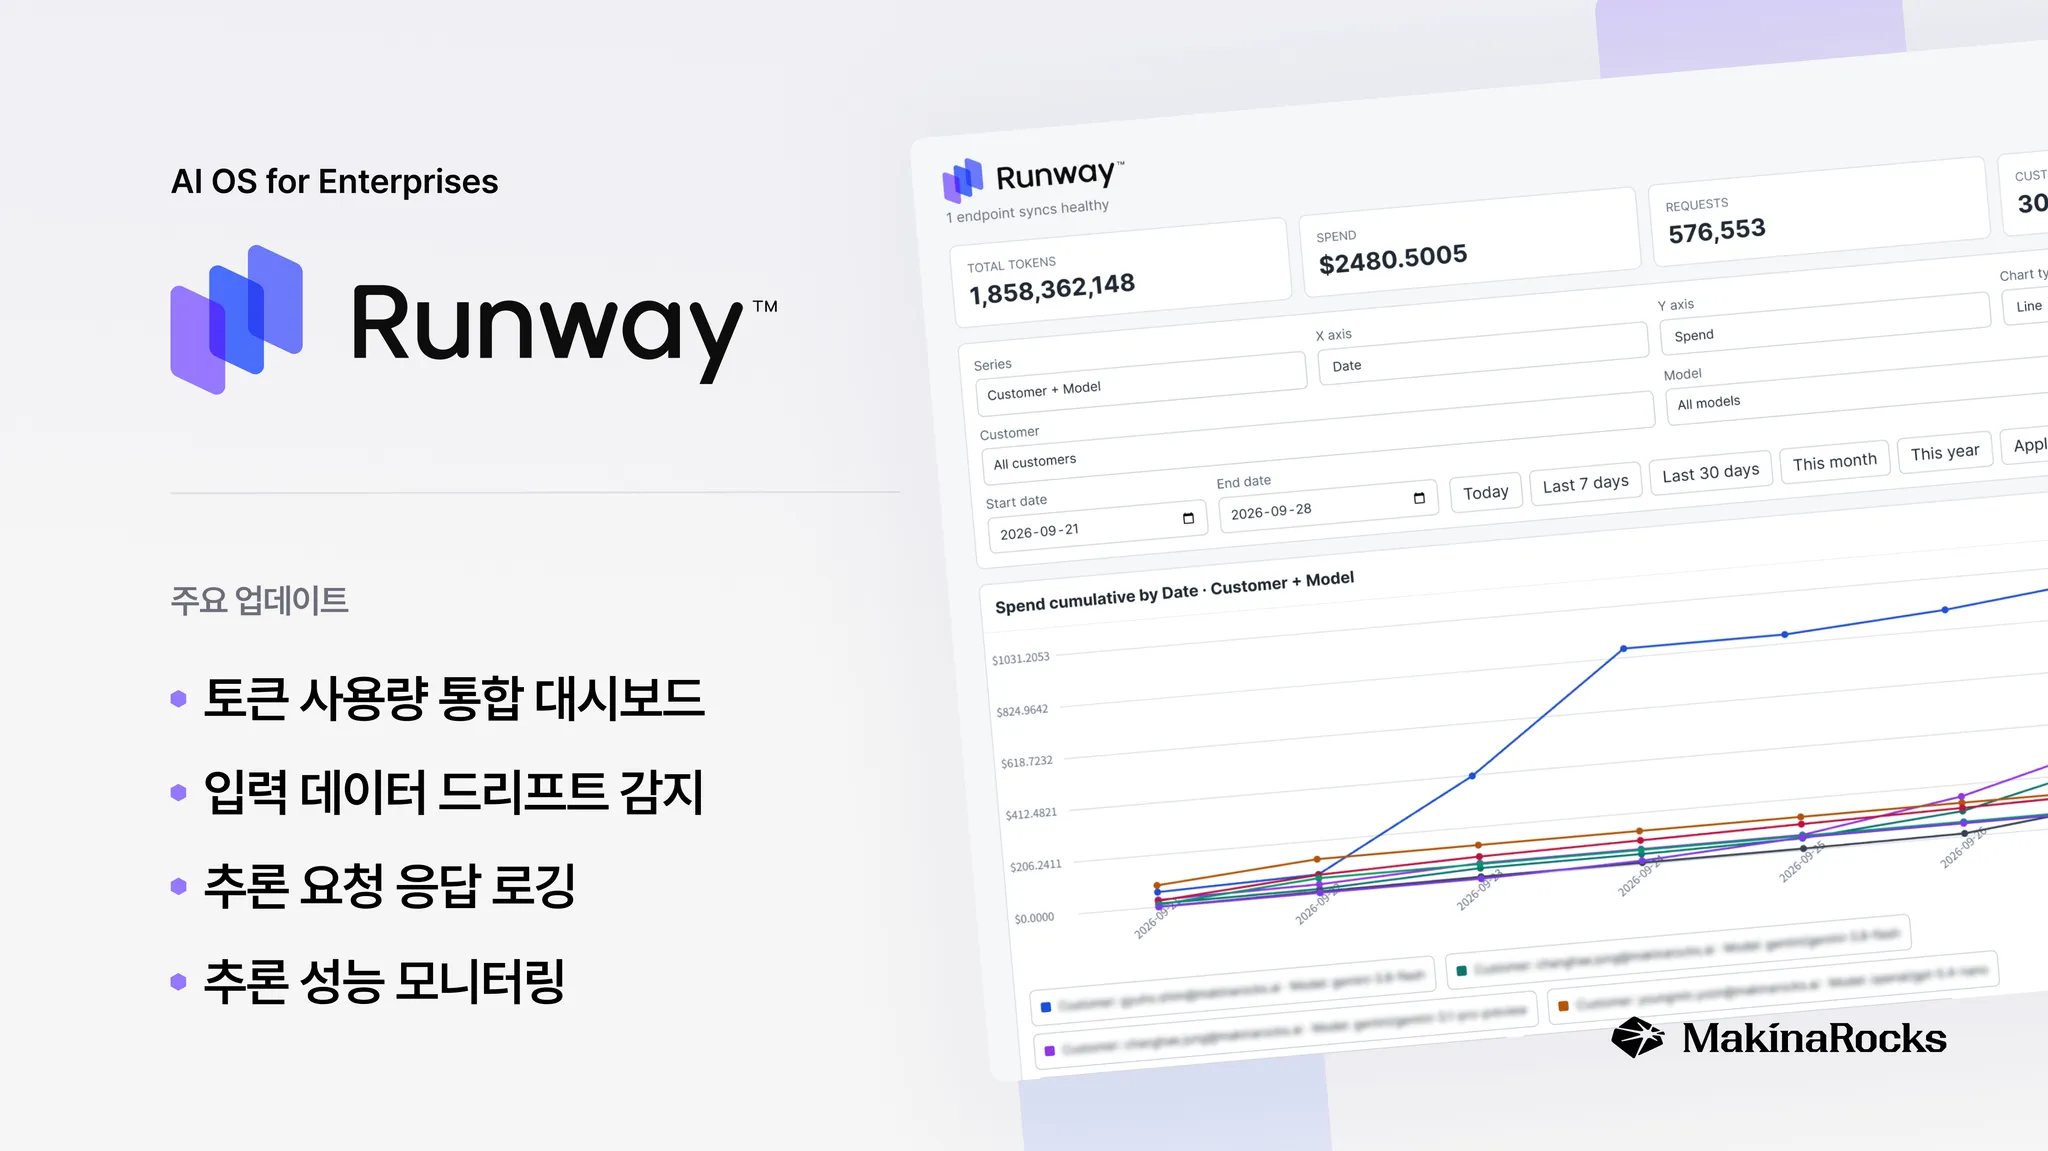
LLM 토큰 사용량 대시보드로 편리하게 관리...데이터 드리프트 감지 등 운영, 관측 기능 고도화
메타 학습과 세계 모델 연구의 선구자가 도쿄의 재귀적 자기개선 연구실에 합류해요. 1987년 학위 논문의 아이디어가 39년 만에 한 회사의 로드맵이 됐어요.
마이크로소프트 리서치가 GitHub Copilot 코딩 에이전트의 실제 사용 기록을 분석한 논문을 9월 14일 Research Focus 에서 소개했어요. LLM 호출 7억6,100만 건 중 87%는 에이전트가 스스로 시작한 것이었고, 도구가 실패하면 연산이 최대 4배로 불어났어요.