


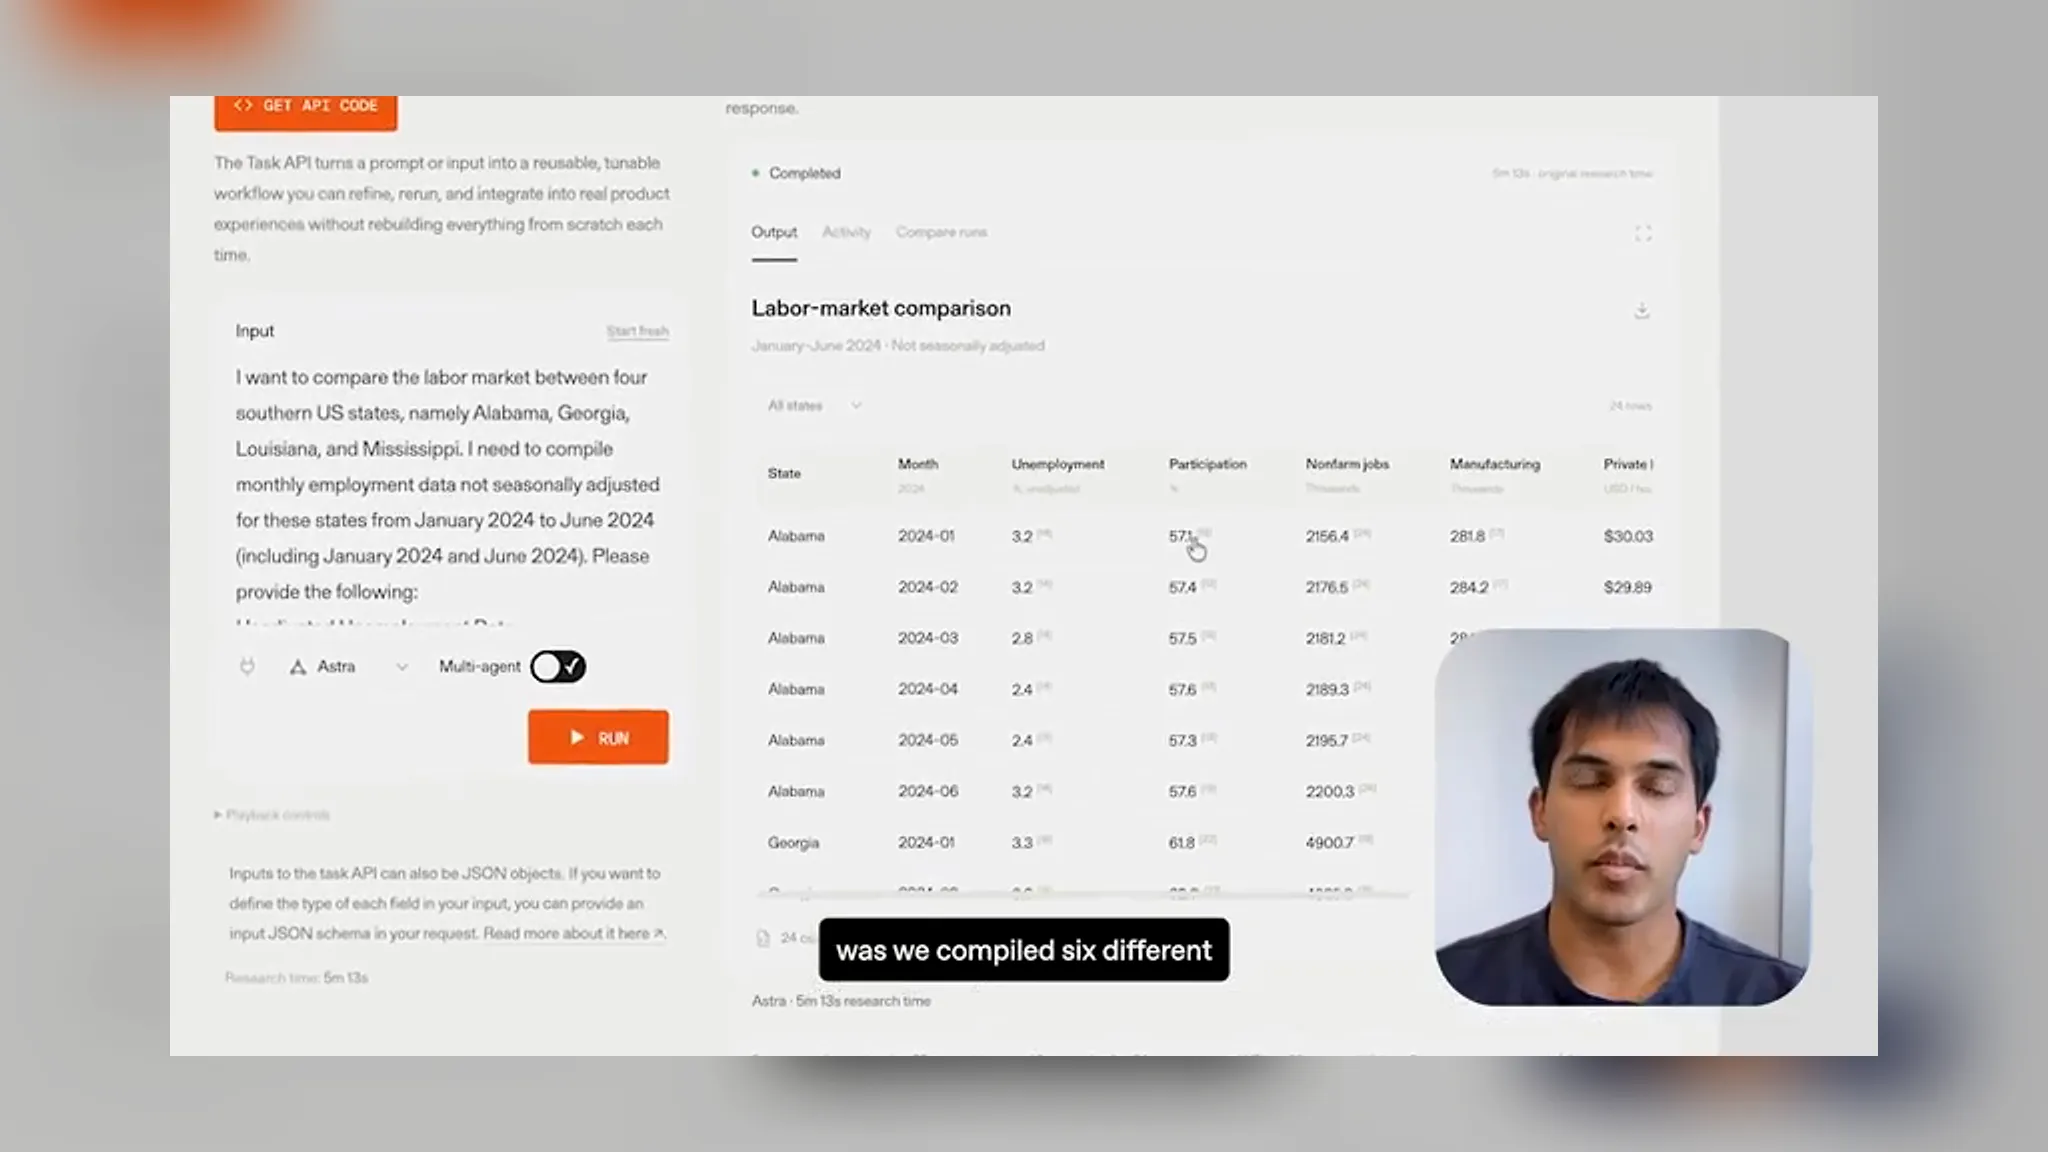
이미지: 영상 갈무리
요약
- 오픈AI가 9월 22일 패러렐의 GPT-6 Astra 도입 사례를 공개했어요.
- 노동시장 통계 리서치 시험에서 Astra는 이전 모델의 절반 시간에 끝냈고 코드 비용은 약 50% 줄었어요.
- 패러렐의 검색 역량 리더보드에서도 Astra는 검색 지능 70.3으로 24개 모델 중 1위였어요.
- 발표
- 2026년 9월 22일 · 오픈AI 고객 사례
- 회사
- 패러렐(Parallel Web Systems) · 북미 스타트업 · API 사용
- 사업
- 웹 기반 지식 노동 에이전트용 개발자 인프라
- 시험 과제
- 4개 주 · 6개월치 노동시장 통계 6가지 조사·보고서 작성
- 결과
- 작업 시간 절반 · 코드 비용 약 50% 절감 · 품질 동일
- 관찰
- 더 좁힌 검색 · 더 적은 단계 · 하위 에이전트 분담
- 영상
- 사례 페이지 54초 · 데빈 굽타 기술 스태프
- 리더보드
- 9월 16일 공개 · 모델 24개 · 9월 15일 기준
- 검색 지능 1위
- GPT-6 Astra 70.3
- 검색 효율 1위
- GPT-5.6 Luna 55.0 · 비용 Astra의 13분의 1
- 검색 효과 최대
- DeepSeek V4.1 Flash +45점 · 검색 지능 65.3
- 비공개
- 비교 대상 이전 모델 이름 · 시험 횟수
오픈AI가 9월 22일 AI 에이전트용 웹 리서치 인프라를 만드는 스타트업 패러렐의 GPT-6 Astra 도입 사례를 공개했어요. 패러렐은 긴 리서치 작업에 Astra를 붙인 뒤 작업 시간이 이전 모델의 절반으로 줄었고, 코드 비용은 약 50% 내려갔다고 밝혔어요. 결과물의 품질은 그대로였다는 게 회사의 설명이에요.
패러렐은 웹을 뒤져 지식 노동을 하는 에이전트에게 도구를 파는 회사예요. 오픈AI의 사례 페이지에 따르면 이 회사의 도구는 음성 에이전트에 웹 근거를 대 주는 일부터 금융기관과 법률 고객을 위한 리서치까지 쓰이고, 프런티어 모델과 웹 검색을 묶는 방식으로 돌아가요. 사례 페이지는 회사 규모를 스타트업, 지역을 북미, 쓰는 제품을 API로 적었어요.
문제는 가장 오래 걸리는 리서치였어요. 그동안 이런 작업에서 좋은 답을 얻으려면 더 큰 모델에 긴 추론을 걸어야 했고, 그만큼 시간과 자원이 들었어요. 패러렐의 데빈 굽타 기술 스태프는 "Astra로 같은 수준의 리서치를 훨씬, 훨씬 빠르게, 더 적은 리서치 호출과 더 적은 토큰으로 얻을 수 있다는 걸 보여 줬다" 고 말했어요.
시험 과제는 노동시장 통계였어요. 패러렐은 에이전트에게 네 개 주에 걸친 6개월치 노동시장 통계 여섯 가지를 조사하게 했고, 에이전트는 여러 웹사이트를 검색해 정보를 모은 뒤 보고서 한 편으로 묶어야 했어요. Astra는 이전 모델의 절반 시간에 이 일을 끝냈어요.
엔지니어의 눈에 더 흥미로운 대목은 속도의 이유예요. 패러렐은 Astra가 더 좁혀진 검색을 하고 쓸 만한 결과에 이르기까지 단계를 덜 밟았다고 관찰했어요. 굽타는 "Astra는 더 겨냥한 검색어를 던졌고, 이전 모델보다 세계 지식을 끌어와 최종 과제에 더 집중했다" 고 설명했어요. 검색 호출이 줄면 호출마다 붙는 지연과 토큰이 함께 줄어들기 때문에, 시간과 비용이 나란히 절반으로 떨어진 결과와 맞아떨어지는 설명이에요.
효율이 오르자 설계도 바뀌었어요. 오픈AI에 따르면 Astra는 특정 리서치 작업을 하위 에이전트에게 나눠 맡길 수 있고, 패러렐은 그 덕분에 한 줄로 이어지던 검색을 여러 에이전트가 동시에 처리하는 구조를 더 현실적으로 쓸 수 있게 됐어요. 순차 검색의 대기 시간을 병렬 작업으로 바꾸는 방식이에요.
메탈이 확인한 사례 페이지의 54초 영상에서 굽타는 같은 시험을 두고 여러 주에 걸친 통계라고 말하고, 절감 항목도 토큰 비용으로 표현해요. 글에는 네 개 주와 코드 비용 절감으로 적혀 있어요. 두 숫자 모두 약 50%라는 점은 같아요.
패러렐이 Astra를 높게 본 근거는 자체 측정에도 있어요. 이 회사는 9월 16일 웹 검색을 쓰는 애플리케이션용 모델을 고르는 데 쓰라며 검색 역량 리더보드를 내놨고, 첫 판에서 공개·비공개 모델 24개를 비교했어요. 세 가지 공개 벤치마크 묶음에서 정확도를 재는 검색 지능 점수에서 GPT-6 Astra가 70.3으로 가장 높았어요. 9월 15일 기준 결과예요.
같은 표는 비용 쪽 사정도 보여 줘요. 중간값 이상의 정확도를 낸 모델을 비용 순으로 줄 세운 검색 효율 순위에서는 GPT-5.6 Luna가 55.0점으로 1위였고, 비용은 Astra의 13분의 1 수준이었어요. DeepSeek V4.1 Flash는 검색을 붙였을 때 점수가 45점 올라 모든 모델 가운데 상승 폭이 가장 컸고, 검색 지능 65.3으로 3위, 검색 효율 2위에 올랐어요. 패러렐은 더 높은 정확도가 더 큰 비용을 정당화하는지는 애플리케이션에 달렸다고 적었어요.
Astra 고객 사례는 이번이 처음이 아니에요. 메탈은 오픈AI가 전날 AI 영상 도구 회사 힉스필드의 Astra 도입 사례를 공개했다고 보도한 바 있으며, 앞서 9월 17일에는 자체 법률 검색 색인을 붙인 Astra for Law가 정확성 검사 통과율 54.0%로 웹 검색만 쓴 Astra의 38.7%를 앞섰다고 전했어요. 사례 페이지 하단에는 9월 16일 헥스, 9월 21일 V7 사례가 함께 올라 있어요.
TPM의 관점에서 이 사례가 주는 메시지는 모델 교체만으로 파이프라인의 단가가 바뀐다는 점이에요. 패러렐은 큰 모델에 긴 추론을 거는 대신 검색을 덜 하고 더 정확히 하는 모델로 같은 품질을 절반의 시간과 비용에 얻었다고 밝혔어요. 다만 사례 페이지에는 비교 대상이 된 이전 모델의 이름과 시험 횟수가 적혀 있지 않아요. 패러렐의 리더보드가 보여 주듯 정확도 1위와 효율 1위가 다른 모델인 만큼, 에이전트를 만드는 팀에게 남는 질문은 어떤 작업에 Astra를 쓰고 어떤 작업을 더 싼 모델에 맡길지예요.


댓글