

이미지: @NousResearch (X) 영상 갈무리
요약
- 메이퇀은 11월 1일 이미지와 텍스트를 한 토큰 형식으로 다루는 MoE 모델 LongCat-2.5를 공개했고, 깃허브·허깅페이스 가중치는 공개 예정이다.
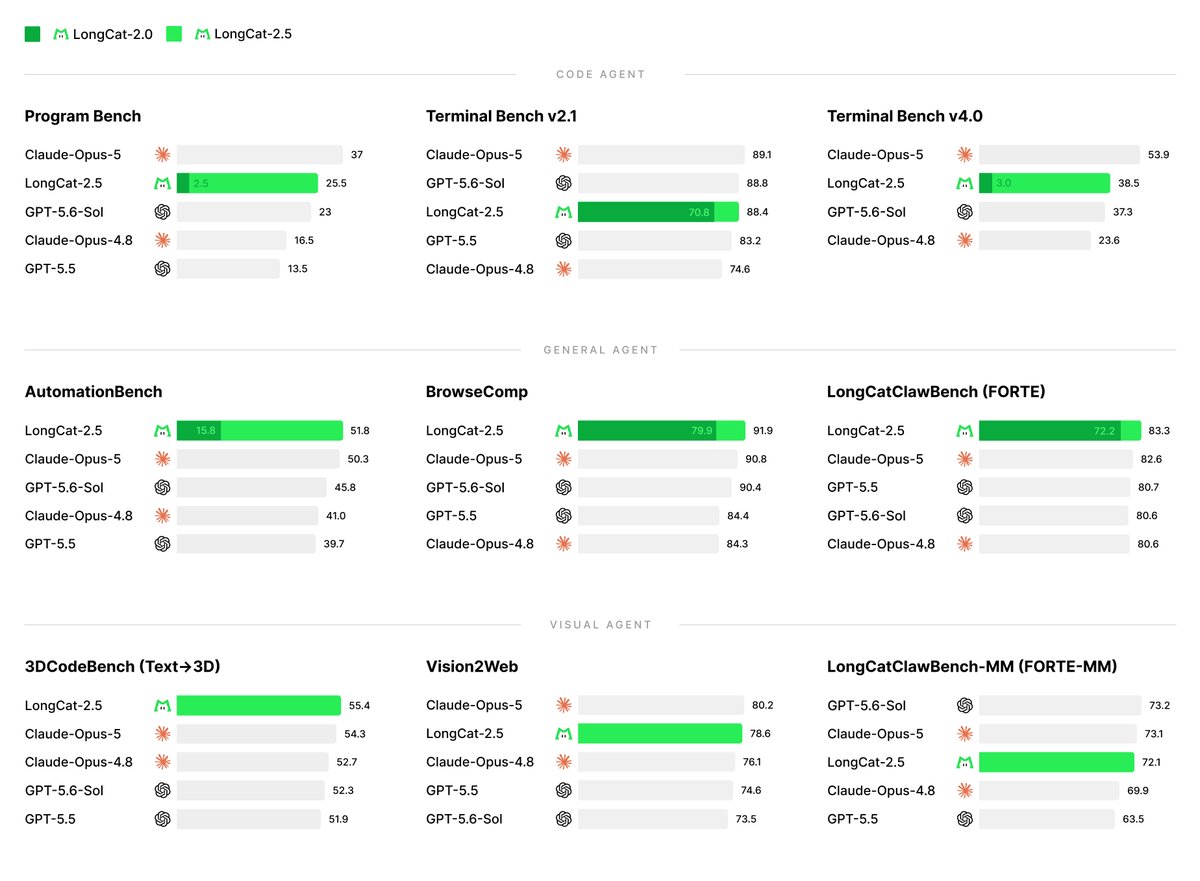
- 회사 평가표에서 브라우즈컴프 91.9점·오토메이션벤치 51.8점으로 GPT·Claude 네 모델을 앞섰지만 터미널 벤치 v4.0은 38.5점으로 Claude Opus 5(53.9점)에 뒤졌다.
- 중국산 가속기에서 학습했고, W4A4 추론은 8비트 기준보다 입력 처리량 43.3%·출력 처리량 42.77%를 높였다. 누스리서치는 11월 6일 누스 포털에서 일주일 무료 개방을 발표했다.
- 발표
- 2026년 11월 1일 · 메이퇀 LongCat 블로그 · 11월 2일 @Meituan_LongCat X
- 규모
- 전체 매개변수 1조 6,000억 개 · 토큰당 활성 약 480억 개 · MoE
- 전작
- LongCat-2.0(6월 30일 출시) · 프리뷰판 9월 25일 API 등록(보도)
- 시각 처리
- 이미지를 다층 이산 토큰으로 표현 · 잔차 벡터 양자화 · 이미지 토큰 사전 계산
- 강화학습
- 깃허브 PR·이슈 기반 과제 합성 · 실패 궤적을 검증 가능한 과제로 전환 · 네트워크 차단·깃 기록 삭제·LLM 심판 감사
- 학습 인프라
- 중국산 AI 가속기(대당 80GB 미만) · 긴 시퀀스 미세 조정 장치당 처리량 86% 향상
- W4A4 추론
- 8비트 대비 입력 처리량 +43.3% · 출력 처리량 +42.77% · 첫 토큰 지연 −15.91% · 토큰 간 지연 −19.72%
- 앞선 평가
- 브라우즈컴프 91.9(Claude Opus 5 90.8) · 오토메이션벤치 51.8(50.3) · 3D코드벤치 55.4(54.3)
- 뒤진 평가
- 터미널 벤치 v2.1 88.4(Claude Opus 5 89.1) · 터미널 벤치 v4.0 38.5(53.9)
- 전작 대비
- 터미널 벤치 v4.0 3.0 → 38.5 · 프로그램 벤치 2.5 → 25.5
- 공개 범위
- 채팅 서비스·API · 깃허브·허깅페이스 공개 예정 · 문맥 100만 토큰·최대 출력 12만 8,000토큰(보도)
- 누스 포털
- 11월 6일부터 일주일 무료
- X 반응
- 메이퇀 발표 글 조회수 25만 9,000회 · 좋아요 2,124개
중국 생활 서비스 기업 메이퇀이 11월 1일 자체 AI 모델 LongCat-2.5를 공개했다. 전체 매개변수 1조 6,000억 개 가운데 토큰 하나를 처리할 때 약 480억 개만 쓰는 전문가 혼합(MoE) 구조이고, 이미지와 텍스트를 한 가지 토큰 형식으로 함께 다루는 네이티브 멀티모달 모델이다. 메이퇀은 X에서 이 모델을 두고 "수많은 단계를 오래 이어 가야 하는 에이전트 작업을 위해 만들었다"고 밝혔다. 회사가 공개한 평가표에서 LongCat-2.5는 터미널 벤치 v2.1 88.4점, 브라우즈컴프 91.9점을 기록했다. 11월 6일에는 누스리서치가 자사 모델 서비스 누스 포털에서 이 모델을 일주일 동안 무료로 열었다.
LongCat-2.5는 전작 LongCat-2.0을 바탕으로 했다. 보도에 따르면 6월 30일 나온 LongCat-2.0도 전체 1조 6,000억 개, 활성 약 480억 개 규모의 MoE 모델이었고, 이미지 이해 기능을 단 프리뷰판은 9월 25일 API 플랫폼에 먼저 올라왔다. 이번 판의 변화는 두 갈래다. 하나는 시각 이해이고, 다른 하나는 코드베이스 전체를 다루는 장기 에이전트 코딩이다. 메이퇀은 블로그에서 두 능력을 합쳐 시각 코딩 성능을 끌어올렸고 창작 디자인과 3D 작업까지 지원한다고 설명했다.
시각 처리 방식이 특이하다. 메이퇀은 이미지를 여러 층의 이산 토큰으로 바꿔 언어 모델이 단어를 다루듯 처리하게 했다. 원래 해상도의 이미지 특징에 잔차 벡터 양자화를 적용해 정보 손실을 줄였고, 토크나이저가 고정돼 있어 이미지 토큰을 미리 계산해 저장해 둘 수 있다. 그 덕분에 학습 과정에서 시각 인코더를 계산 그래프에서 빼낼 수 있었다고 회사는 밝혔다. 활성 매개변수 약 30억 개짜리 작은 MoE 모델로 먼저 검증한 결과, 시각 임베딩과 텍스트 임베딩이 같은 의미 공간 안에서 서로 섞여 분포하는 모습이 나왔다는 설명도 붙였다.
장기 작업 능력은 강화학습의 규모로 끌어올렸다. 메이퇀은 깃허브의 풀 리퀘스트와 연결된 이슈를 걸러 에이전트가 과제를 주석 달고 실행 환경을 합성하게 했고, 실패하던 테스트가 통과로 바뀌는지와 통과하던 테스트가 계속 통과하는지로 결과를 검증했다. 블로그는 "실제 에이전트의 실패 궤적을 재현 가능하고 검증 가능한 훈련 과제로 바꾼다"고 적었다. 보상을 편법으로 따내는 행동을 막으려고 과제 환경의 네트워크를 끊고 깃 기록과 캐시 파일을 지웠으며, 별도의 언어 모델 심판이 궤적을 감사하게 했다. 같은 추론을 되풀이하거나 같은 도구를 반복해 부르는 행동에는 벌점을 줬다.
학습과 추론은 중국산 AI 가속기에서 돌렸다. 메이퇀은 가속기 한 대당 메모리가 80GB에 못 미치는 조건에서 병렬화 방식을 슈퍼노드 구조에 맞췄고, 긴 시퀀스 미세 조정에서 장치당 처리량이 기존 분산 방식보다 86% 높아졌다고 밝혔다. 추론에서는 전문가 가중치와 활성값을 모두 4비트로 줄이는 W4A4 방식을 개발했다. 8비트 기준과 비교한 실시간 부하 시험에서 입력 처리량은 43.3%, 출력 생성 처리량은 42.77% 늘었고 첫 토큰까지의 지연은 15.91%, 토큰 사이 지연은 19.72% 줄었다. 회사는 평가한 모든 하위 과제에서 양자화하지 않은 모델과 비슷한 성능을 냈다고 설명했다.
메탈이 확인한 블로그 평가표는 LongCat-2.5를 GPT-5.5, GPT-5.6-Sol, Claude Opus 4.8, Claude Opus 5와 나란히 놓았다. 브라우즈컴프에서는 91.9점으로 Claude Opus 5의 90.8점과 GPT-5.6-Sol의 90.4점을 앞섰고, 오토메이션벤치 51.8점과 텍스트로 3D를 만드는 3D코드벤치 55.4점에서도 GPT와 Claude 네 모델을 모두 앞섰다. 반면 터미널 벤치 v2.1에서는 88.4점으로 Claude Opus 5의 89.1점에 조금 못 미쳤고, 더 어려운 터미널 벤치 v4.0에서는 38.5점으로 Claude Opus 5의 53.9점과 차이가 컸다. 전작과의 격차는 뚜렷하다. LongCat-2.0은 터미널 벤치 v4.0에서 3.0점, 프로그램 벤치에서 2.5점에 그쳤는데 LongCat-2.5는 각각 38.5점과 25.5점을 받았다.
평가표에는 해석할 때 따져 볼 조건이 붙어 있다. 메이퇀은 별표가 붙은 다른 모델의 점수는 공개 기술 보고서와 블로그, 공식 리더보드에서 가져왔고 나머지는 자체 측정이라 참고용이라고 밝혔다. LongCat-2.5의 점수는 사고 모드를 켜고 온도 1.0으로 얻었다. 보도에 따르면 출시 시점까지 외부 평가 기관이 LongCat-2.5를 독립적으로 검증한 결과는 나오지 않았다. 메이퇀은 실시간 유체 시뮬레이션과 3D 디지털 전시, 도시 디오라마, 사업 분석 보고서 등 시연 8건을 함께 공개하며 "아래 모든 사례는 LongCat-2.5가 처음부터 끝까지 만들었다"고 적었다.
배포는 단계적이다. 블로그의 깃허브와 허깅페이스 항목에는 아직 공개 예정이라고 적혀 있어, 지금은 메이퇀의 채팅 서비스와 API로만 쓸 수 있다. 보도에 따르면 API 문서는 문맥 길이 100만 토큰, 최대 출력 12만 8,000토큰을 표기했고 오픈AI 호환 형식과 앤스로픽 호환 형식을 모두 지원한다. 메이퇀의 X 발표 글은 닷새 남짓 만에 조회수 25만 9,000회, 좋아요 2,124개를 모았다. 메탈은 누스 포털이 업스테이지의 Solar Pro 4를 일주일 무료로 연 소식을 보도한 바 있으며, 이번 LongCat-2.5 무료 개방도 같은 방식이다.
AI 엔지니어의 눈으로 보면 이번 발표에서 성적표보다 오래 남을 대목은 학습 파이프라인이다. 실패한 에이전트 궤적을 검증 가능한 과제로 되돌려 넣는 순환, 보상 편법을 막으려고 네트워크와 깃 기록을 끊은 환경, 학습과 추론 사이의 수치 차이를 비트 단위로 맞춘 인프라는 모두 수백 단계짜리 작업에서 모델이 길을 잃지 않게 하려는 장치다. 이미지를 처음부터 이산 토큰으로 다루는 선택은 시각 인코더를 학습 그래프에서 덜어 내 대규모 분산 학습의 부하를 고르게 만드는 공학적 계산이기도 하다. 가중치가 공개되면 이 설계가 평가표만큼 작동하는지 외부에서 직접 재 볼 수 있게 된다.
댓글