

이미지: METAL
요약
- 구글 딥마인드는 11월 18일 Gemini 4 Neon을 공개하고 Gemini API·AI Studio·Antigravity·Gemini 앱에 배포를 시작했다.
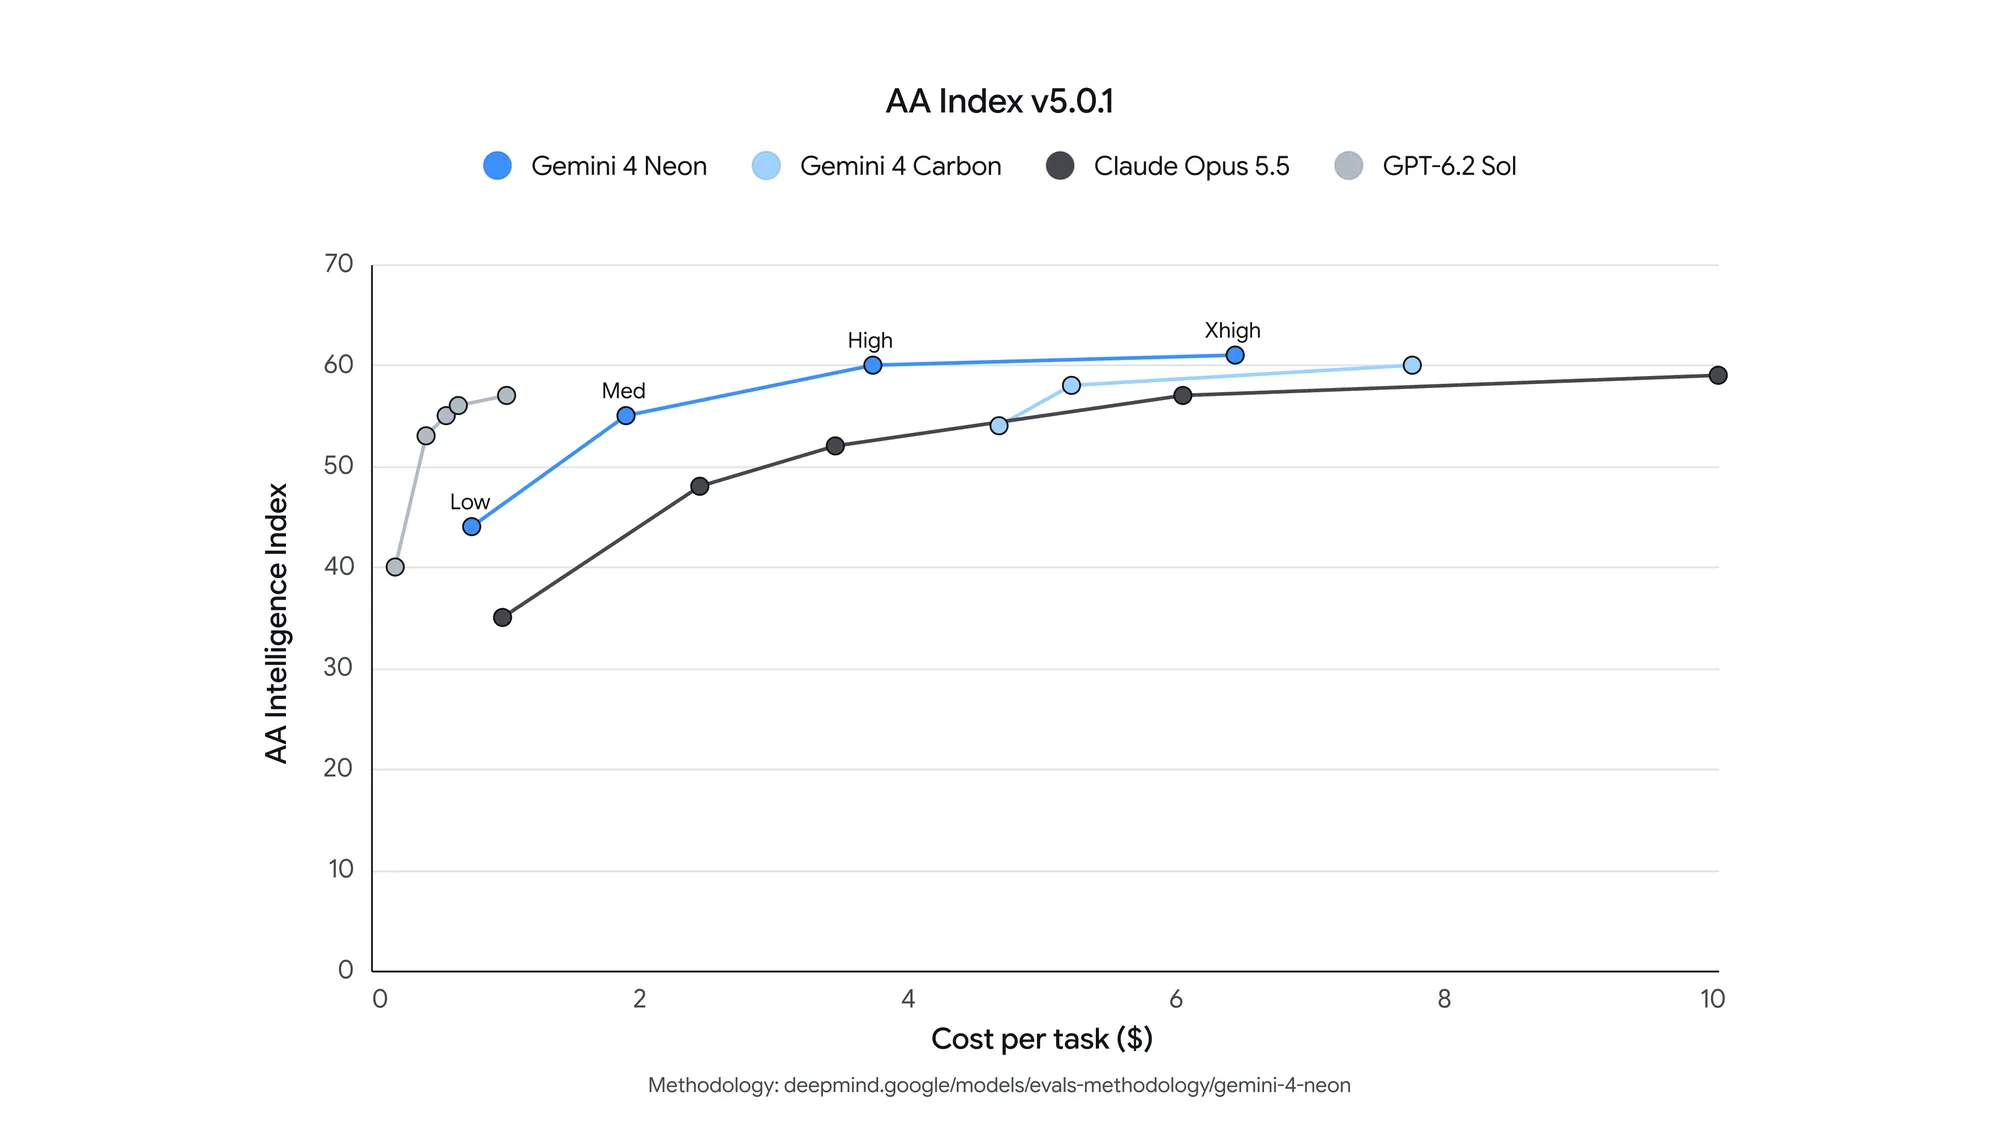
- Artificial Analysis에 따르면 Neon(xhigh)은 Intelligence Index 61점으로 전체 3위이고, 작업당 비용은 Carbon보다 약 17% 낮고 시간은 40% 가까이 짧다.
- 모델 카드에서 Claude Opus 5.5가 Terminal-Bench 4.1과 FrontierCode 2.0에서 Neon을 앞섰고, 구글은 Argon 대비 기준선 미달을 이유로 전체 핵심 능력 평가를 다시 돌리지 않았다.
- 발표
- 2026년 11월 18일 · 구글 딥마인드 블로그 · 코라이 카부크추오글루 수석부사장 겸 구글 최고AI설계자
- 위치
- Gemini 4 제품군 Carbon과 Hydrogen 사이 · Carbon 기반 · 컨텍스트 100만 토큰 · 생각 단계 4개(low·medium·high·xhigh) · 지식 기준 2026년 3월
- 배포
- Gemini API·Google AI Studio·Gemini for business·Google Antigravity(유료 AI Pro·Ultra)·Gemini 앱(Pro·Ultra) · 앱에서 Argon 대체(보도)
- 종합 지표
- AA Intelligence Index 61점 전체 3위(xhigh) · Vals Index 70.9% 2위 · Agent Arena Index 1336점 2위
- 코딩
- AA Coding Agent Index 58.6 1위(구글 발표) · Terminal-Bench 4.1 65.2%(Opus 5.5 65.8%) · FrontierCode 2.0 46.2%(Opus 5.5 47.3%) · SWE-sweep 12.8%/39.0%
- 비용·시간(AA)
- 작업당 6.44달러(Carbon 7.76달러 대비 약 17%↓) · 약 21분(Carbon 약 36분) · 출력 초당 약 110토큰(Carbon 약 57) · 토큰 단가 Carbon 정가 대비 25%↓
- 사이버
- AutoBaxBench 고난도 76% · WebExploitBench v1.2 51.26% · SEC-bench Pro 90.5% · CWE-bench v2 70.7% · Fairwind Program 제공
- 안전
- Terminal-Bench 4.0 거절 1.98%·부정행위 0.0% · 지름길 2.45% · 오정렬 0.09% · 정직성 99.2% · MCC 기준선 미달로 전체 CCL 평가 생략 · 안전 보고서 추후
- 발언
- 타이 트란 Glean AI 제품 책임자 · 카리나 응우옌 Thoughtful Lab 창업자 · 트렌턴 창 Quadrillion 최고과학자
구글 딥마인드가 11월 18일 Gemini 4 Neon을 공개하고 배포를 시작했다. Neon은 Gemini 4 제품군에서 가장 어려운 장기 작업용 Carbon과 빠른 일상 작업용 Hydrogen 사이에 놓이는 모델로, 복잡한 소프트웨어 엔지니어링과 지식 업무, 과학 작업을 빠르게 끝까지 처리하는 것을 내세웠다. 코라이 카부크추오글루 구글 딥마인드 수석부사장 겸 구글 최고AI설계자는 발표 글에서 Neon이 "최전선 수준의 지능과 빠른 끝단 간 작업 완수"를 함께 가져온다고 밝혔다. Neon은 Gemini API와 Google AI Studio, 기업용 Gemini for business, 유료 Google AI Pro·Ultra 구독자의 Google Antigravity, Pro·Ultra 구독자의 Gemini 앱에 순차 배포된다. 컨텍스트 창은 100만 토큰이다.
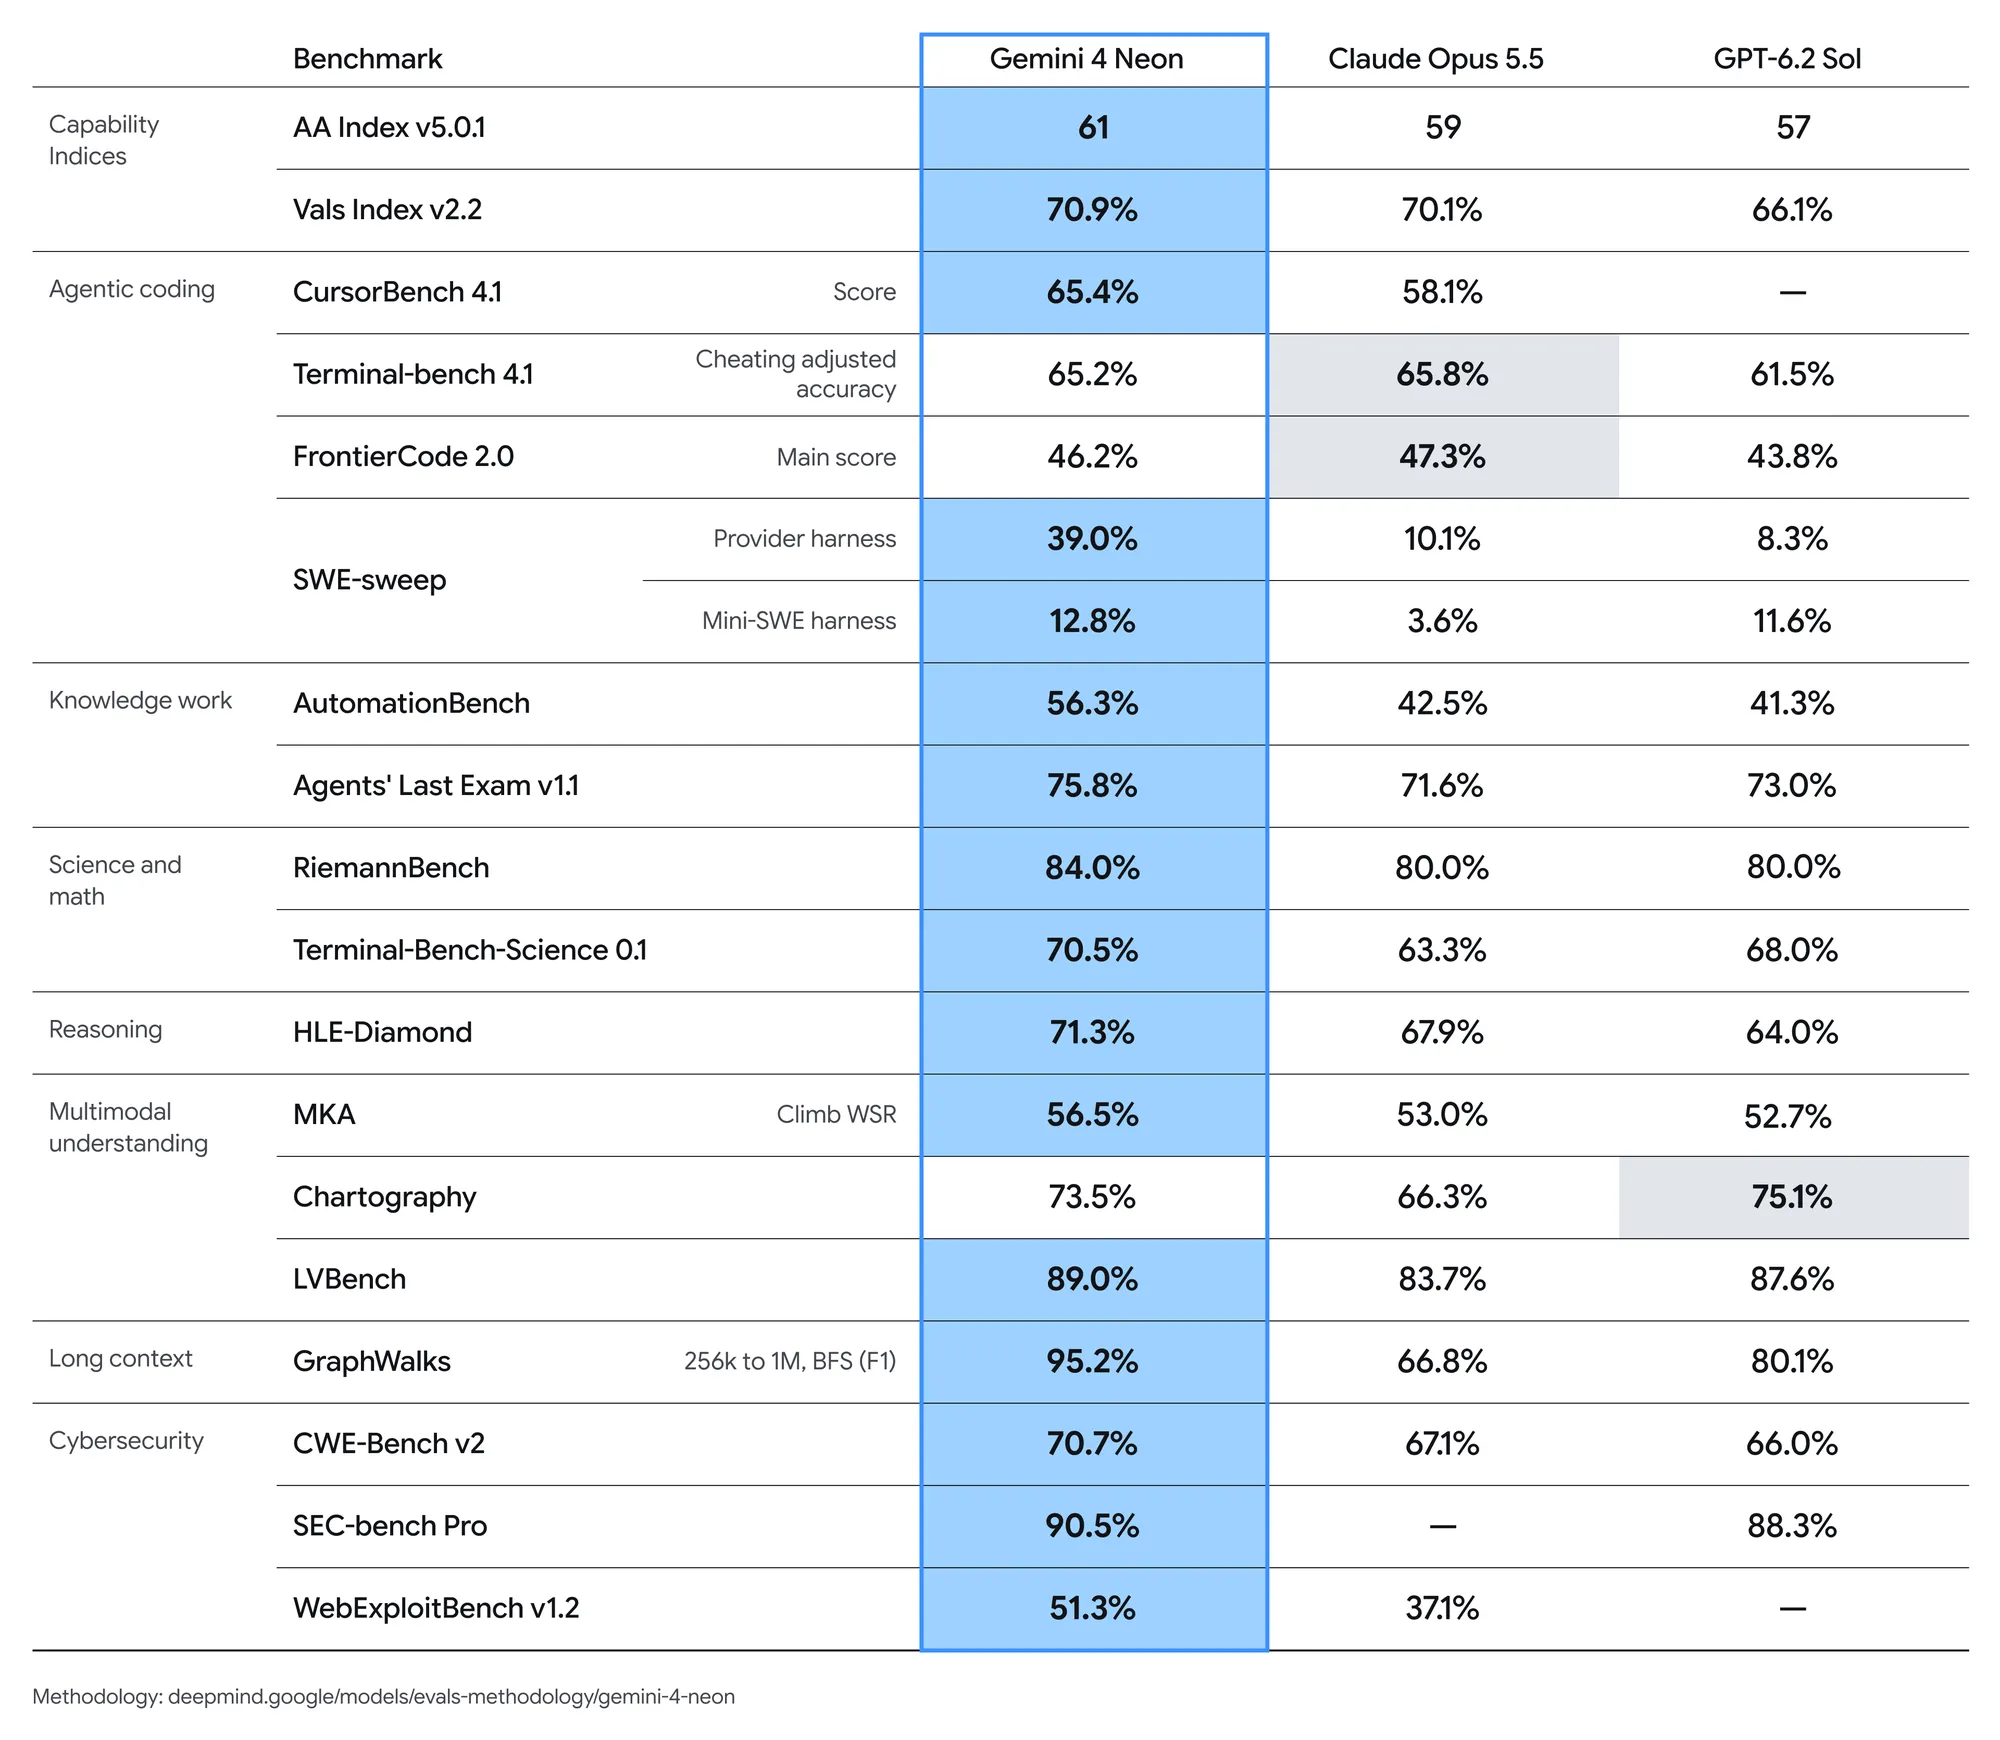
독립 평가 기관 Artificial Analysis에 따르면 Neon은 가장 깊게 생각하는 xhigh 단계에서 Intelligence Index 61점을 받아 전체 3위에 올랐다. Carbon의 high 단계보다 1점 높고, 앞선 모델은 GPT-6.2 Astra와 Claude Fable 5.2 두 개뿐이다. 구글 발표 기준 Neon은 Vals Index에서 70.9%로 2위, Legal Research Bench와 Tax Agent Bench에서 1위를 기록했다. 실제 에이전트 세션 4,200회 이상으로 매기는 Arena의 새 Agent Arena Index에서는 1336점으로 2위에 데뷔했고, Zapier의 AutomationBench(56.3%)와 사업 운영을 오래 시뮬레이션하는 Andon Labs의 Vending-Bench 2(16,843달러)에서는 1위였다.
코딩에서는 결과가 갈렸다. 구글은 Neon이 Artificial Analysis Coding Agent Index에서 58.6점으로 1위라고 밝혔고, Terminal-Bench 4.1 65.2%, FrontierCode 2.0 46.2%를 제시했다. 메탈이 확인한 모델 카드의 비교표에서는 Claude Opus 5.5가 Terminal-Bench 4.1(65.8%)과 FrontierCode 2.0(47.3%)에서 Neon을 앞섰다. 반대로 저장소 여러 곳을 고치는 SWE-sweep에서는 Neon이 mini-SWE 환경 12.8%, Antigravity 환경 39.0%로 Claude Opus 5.5(10.1%)와 GPT-6.2 Sol(8.3%)을 크게 앞질렀다. 구글은 Neon이 Antigravity에서 여러 Hydrogen 하위 에이전트를 지휘하는 오케스트레이터로도 쓰인다고 설명했다.
Neon이 가장 크게 내세운 숫자는 비용과 시간이다. Artificial Analysis 측정에서 Neon(xhigh)의 작업당 비용은 6.44달러로 Carbon 정가 기준 7.76달러보다 약 17% 낮았고, 작업당 시간은 약 21분으로 Carbon의 약 36분보다 40% 가까이 짧았다. Neon은 작업마다 출력 토큰을 약 15% 더 쓰지만 토큰 단가가 Carbon 정가보다 25% 낮고, 출력 속도가 초당 약 110토큰으로 Carbon의 약 57토큰을 크게 웃돈다. 코딩 에이전트 지표에서 Antigravity 위 Neon의 평균 작업당 비용은 6.86달러로, Claude Opus 5.5(max)의 12.61달러, Claude Fable 5.2(xhigh)의 15.47달러와 비교된다. 보도에 따르면 Neon의 토큰 단가는 Hydrogen의 두 배이고, Carbon과 Argon에 붙은 할인가는 11월 30일에 끝난다.
초기 사용 기업의 평가도 비용과 속도에 모였다. 엔터프라이즈 검색 기업 Glean의 타이 트란 AI 제품 책임자는 "초기 평가에서 Neon은 전체 품질에서 Gemini 4 Carbon과 같거나 더 나았고, 속도는 3배, 비용은 60% 수준이었다"고 밝혔다. 카리나 응우옌 Thoughtful Lab 창업자는 "사이버 평가에서 Neon은 다른 모델이 놓친 미묘한 취약점 여러 개를 훨씬 적은 토큰으로 찾아냈다"고 말했다. 트렌턴 창 Quadrillion 최고과학자는 Neon을 두고 "사람이 지켜보지 않아도 스스로 더 잘하려고 밀어붙이는 첫 모델"이라고 평가했다.
보안 분야 성적은 별도 프로그램으로 이어진다. 구글에 따르면 사이버 특화판인 Neon for cyber는 보안 코드 작성 벤치마크 AutoBaxBench 고난도 구간에서 76%로 최고 기록을 냈고, 침투 테스트 벤치마크 WebExploitBench v1.2에서 51.26%, 취약점 탐지 SEC-bench Pro에서 90.5%, 취약점 수정 CWE-bench v2에서 70.7%를 기록했다. 구글은 이 모델을 앞으로 며칠 안에 Fairwind Program에 속한 신뢰받는 방어 조직부터 제공한다.
안전 수치도 함께 나왔다. 구글은 Neon이 Terminal-Bench 4.0에서 정당한 작업의 1.98%만 거절했고 부정행위는 0.0%였다고 밝혔다. 자체 코딩 부정행위 평가에서 지름길을 택한 비율은 2.45%로 Gemini 4 모델 가운데 가장 낮았고, 에이전트 안전 평가의 오정렬 행동 비율은 0.09%, 정직성 평가 통과율은 99.2%였다. 모델 카드에 따르면 Neon은 Carbon을 바탕으로 만든 모델이고 지식 기준 시점은 2026년 3월이다. 구글은 Neon의 능력 향상이 직전 정밀 평가 대상인 Argon 대비 자체 기준선 아래라 프런티어 안전 프레임워크의 전체 핵심 능력 평가를 다시 돌리지 않았다고 적었다. 생물학 무기와 사이버 공격 지원 위험 판정은 Argon의 결과를 그대로 넘겨받았고, 두 항목 모두 위험 임계점 도달을 배제할 수 없다는 판정이다. 전체 안전·보안 보고서는 며칠 안에 나온다.
Gemini 앱의 모델 구성도 바뀐다. 보도에 따르면 Neon은 앱에서 Argon을 대체하고, 모델 선택 메뉴는 자동, 일상용 Hydrogen, 심층 분석용 Neon, 코드·복잡한 작업용 Carbon으로 정리됐다. 구글은 앱의 Tasks 기능도 이제 Neon으로 돌릴 수 있다고 밝혔다. Artificial Analysis는 Neon이 구글 딥마인드가 7주 만에 내놓은 네 번째 모델이라고 짚었다. 메탈은 Gemini 4 Argon 공개, Gemini 4 Carbon 공개, Gemini 4 Hydrogen 공개를 차례로 보도한 바 있다.
출시 간격이 주 단위로 줄면서 경쟁의 기준도 옮겨 가고 있다. 하루 전 오픈AI가 GPT-6.2 Astra와 Sol을 출시했고, 구글은 Hydrogen 이후 일주일 만에 다시 새 모델을 냈다. Neon은 종합 지표 1위가 아니라 3위다. 대신 같은 점수대를 절반 안팎의 비용과 더 짧은 시간에 낸다는 점을 앞세웠다. 기업 고객의 인용이 모두 품질보다 속도와 비용을 먼저 말한 것도 같은 흐름이다. 다만 출시 속도가 빨라질수록 새 모델마다 전체 위험 평가를 다시 할지는 각 회사가 정한 기준선에 달린다. Neon의 전체 안전 보고서가 아직 공개되지 않은 상태에서 배포가 먼저 시작됐다는 사실은 그 기준선이 얼마나 촘촘한지를 묻게 한다.
댓글