

이미지: METAL
요약
- 오픈AI는 11월 17일 법률 특화 구성 Astra for Law를 GPT-6.2 Astra 기반으로 업데이트하고 ChatGPT Enterprise 고객 전체에 신뢰 접근 프로그램 신청을 열었다.
- LAB-AA에서 과제 20.8%를 만점 통과해 GPT-6.2 Astra 15.0%, Muse Wonder Full 13.1%를 앞섰고, 출력 토큰은 과제당 약 6만 4,000개로 Muse Wonder Full보다 54% 적었다.
- 중대 환각은 과제당 0.03건으로 Claude Opus 5.5의 0.59건보다 약 20배 적었고, 법률 검색 색인은 9월 이후 34% 늘어 URL 3억 1,000만 개를 넘었다.
- 발표
- 2026년 11월 17일(미국 시간) · 오픈AI 「Astra for Law leads in legal intelligence」
- 구성
- GPT-6.2 Astra + 확장 법률 검색 색인 + 조사·근거 비교·작성 지시 · 모델명 gpt-6.2-astra-law
- LAB-AA 만점 통과율
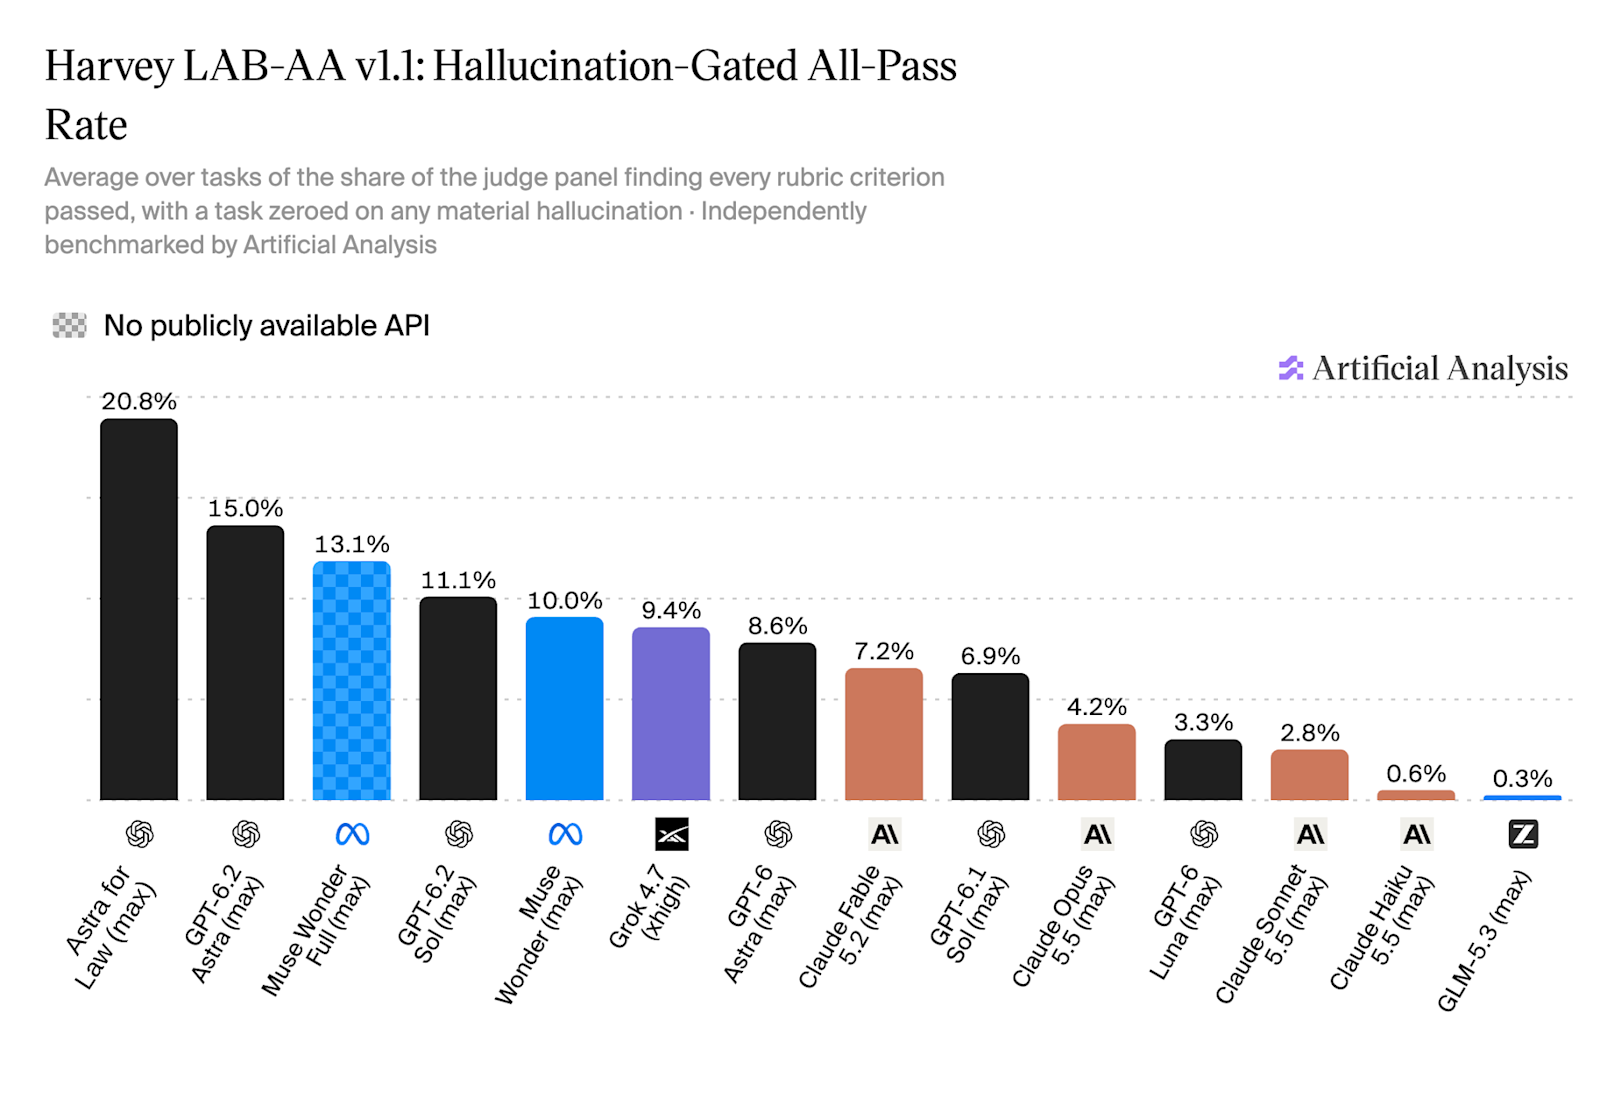
- Astra for Law 20.8% · GPT-6.2 Astra 15.0% · Muse Wonder Full 13.1% · GPT-6.2 Sol 11.1% · Muse Wonder 10.0% · Grok 4.7 9.4% · Claude Fable 5.2 7.2% · Claude Opus 5.5 4.2%
- LAB-AA 구성
- 하비 개발 과제 120개 · 24개 법 분야 · 아티피셜 애널리시스 평가 · 만점 = 요구 전부 충족 + 중대 환각 0
- 출력 토큰
- 과제당 약 6만 4,000개 · Muse Wonder Full 13만 9,000개 · 54% 적음
- 환각(과제당)
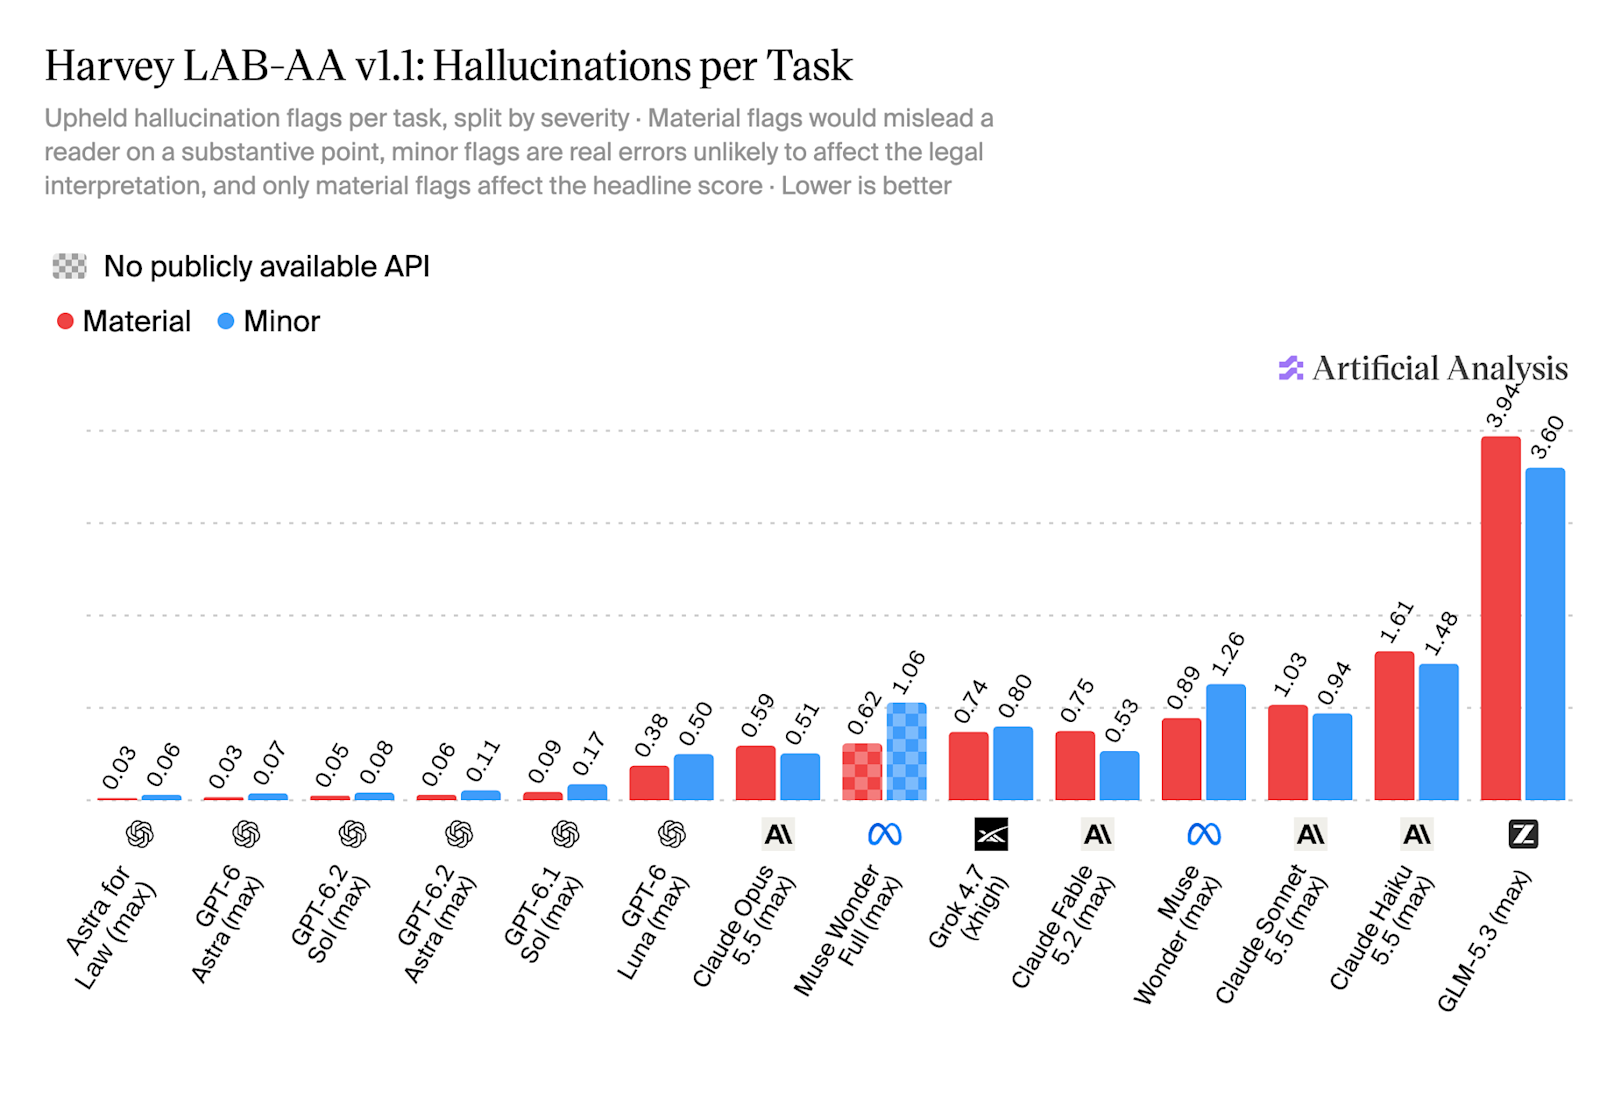
- 중대 0.03 · 경미 0.06 · Claude Opus 5.5 중대 0.59·경미 0.51 · GPT-6.2 Astra 중대 0.06
- 하비 LAB
- GPT-6 Astra 4.6% → GPT-6.2 Astra 14.6% → Astra for Law 16.2%
- Vals AI Legal Research Bench
- 11월 16일 평가 208문항 중 112문항(53.8%) 만점 · 9월 약 46% · 부분 점수 포함 90.9%
- 법률 검색 색인
- 9월 이후 34% 확대 · URL 8,000만 개 이상 추가 · 총 3억 1,000만 개 이상 · 영국·호주·캐나다 · 미국 선례 판례 99.9% 이상 (9월 2억 3,000만 개 이상)
- 첫 공개
- 2026년 9월 17일 · GPT-6 Astra 기반 · 쿨리·롭스 앤드 그레이·설리번 앤드 크롬웰 등 · 파트너 플러그인 26개
- 접근
- ChatGPT Enterprise 관리 콘솔 신뢰 접근 프로그램 신청 · API 접근은 별도 신청서 · 자격 로펌 API 데이터 무보존
오픈AI가 11월 17일(미국 시간) 법률 특화 모델 구성 Astra for Law를 업데이트해 공개하고, ChatGPT Enterprise 고객 전체에 접근 신청을 열었다. Astra for Law는 오픈AI의 최신 프런티어 모델 GPT-6.2 Astra에 확장된 법률 검색 색인과, 질문을 조사하고 권위 있는 근거를 저울질해 답을 쓰는 지시를 얹은 구성이다. 오픈AI에 따르면 이번 구성은 법률 AI 기업 하비가 만든 과제로 아티피셜 애널리시스가 평가한 LAB-AA에서 과제의 20.8%를 만점으로 통과해 1위에 올랐다. 2위인 GPT-6.2 Astra의 15.0%보다 만점 비율이 40% 가까이 높다.
LAB-AA는 모델이 법률 과제를 처음부터 끝까지 해내는지를 본다. 24개 법 분야에 걸친 과제 120개로 이뤄졌고, 증언 녹취 개요 작성부터 상업용 임대차 계약 검토, 인수 과정의 지분 구조 변경 전략까지 다룬다. 만점을 받으려면 과제의 요구 사항을 모두 채우면서 원문 자료가 뒷받침하지 않는 중대한 주장, 곧 환각을 하나도 내지 않아야 한다. 오픈AI가 아닌 모델 가운데 최고점은 Muse Wonder Full의 13.1%였고, Astra for Law는 이보다 약 59% 더 자주 만점을 받았다. 메탈이 확인한 원문 도표에 따르면 GPT-6.2 Sol 11.1%, Muse Wonder 10.0%, Grok 4.7 9.4%, Claude Fable 5.2 7.2%, Claude Opus 5.5 4.2%가 뒤를 이었고, Muse Wonder Full은 공개 API가 없는 구성으로 표시됐다.
점수와 함께 출력량도 줄었다. Astra for Law는 과제당 평균 출력 토큰이 약 6만 4,000개로, Muse Wonder Full의 13만 9,000개보다 54% 적었다. 출력 토큰에는 모델이 추론하며 생성하는 텍스트와 최종 답이 모두 들어간다. 오픈AI는 사용량에 따라 비용을 내는 법무팀에게 이 차이가 예산 안에 머무느냐 넘어서느냐를 가를 수 있다고 주장했다. 도표에 실린 구성 가운데 Astra for Law보다 적은 출력으로 같은 점수를 낸 구성은 없었다.
환각 수치의 격차는 더 컸다. Astra for Law의 중대 환각은 과제당 0.03건으로 GPT-6와 함께 가장 낮았고, 오픈AI 외 모델 중 가장 낮은 Claude Opus 5.5는 0.59건으로 약 20배였다. 독자를 오도할 가능성이 작은 경미한 오류도 0.06건 대 0.51건으로 8.5배 차이가 났다. 일반 GPT-6.2 Astra의 중대 환각 0.06건과 견줘도 절반이다. 오픈AI는 만점 조건을 채운 과제에서는 중대 환각이 한 건도 없었다고 밝혔고, 지어낸 인용 하나가 의뢰인의 신뢰와 법정에서의 신뢰도, 수년간 쌓은 평판을 한꺼번에 잃게 할 수 있다며 환각 감소를 우선 과제로 삼았다고 설명했다.
과제를 낸 하비 쪽 평가도 같은 방향이다. 하비의 훌리오 페레이라 법률 연구 책임자는 "Astra for Law 6.2는 우리 벤치마크 전반에서 이전 Astra 모델보다 실질적으로 개선됐다"고 말했다. 그는 "더 포괄적이고 논리가 탄탄한 서면을 쓰며, 우리 쌍대 비교 심사에서 GPT-6 Astra의 서면보다 90% 가까이 더 선호됐다"며 깊이가 늘면서도 정확도는 후퇴하지 않았다고 덧붙였다. 하비 자체 LAB에서 모든 요구를 채운 과제 비율은 GPT-6 Astra 4.6%, GPT-6.2 Astra 14.6%로 세 배 넘게 올랐고, 법률 구성을 더하자 16.2%로 11% 더 늘었다.
제3자 평가도 붙었다. 현직 변호사들이 미국 연방법과 주법 질문을 내는 Vals AI의 Legal Research Bench에서 Astra for Law는 11월 16일 평가 208문항 중 112문항, 53.8%를 만점으로 통과했다. 9월의 약 46%에서 두 달이 안 돼 약 8%포인트 오른 수치이고, 부분 점수까지 합치면 배점의 90.9%를 얻었다. 답이 필요한 논점을 모두 다루고 출처 검증까지 통과해야 만점이다.
성능을 끌어올린 축 가운데 하나는 검색 색인이다. 오픈AI는 9월 이후 법률 검색 색인을 34% 키워 URL 8,000만 개 이상을 더했고, 영국과 호주, 캐나다 같은 해외 관할도 넣었다고 밝혔다. 지금 색인은 URL 3억 1,000만 개가 넘고, 공개된 미국 선례 판례의 99.9% 이상을 덮는다. 9월 첫 공개 때 색인 규모는 2억 3,000만 개 이상이었고, 판례 범위는 비영리 단체 프리 로 프로젝트가 운영하는 코트리스너의 판례 모음에서 왔다.
Astra for Law는 9월 17일 GPT-6 Astra를 바탕으로 처음 나왔다. 당시 오픈AI는 쿨리, 롭스 앤드 그레이, 설리번 앤드 크롬웰 등 일부 로펌에 먼저 제공하고, 로펌이 쓰는 전문 도구를 ChatGPT에 잇는 파트너 플러그인 26개를 함께 냈다. 발표문에 실린 비교에서 같은 계약 분쟁 질문을 받은 Claude Fable 5.1은 항소심에서 뒤집힌 판결을 가장 가까운 선례로 내놓았다. 설리번 앤드 크롬웰의 존 사바 파트너는 "소송과 거래 사안 모두에서 모델은 인상적인 조사 깊이와 법적 권위에 대한 민감성을 보여 줬다"고 평가했다. 메탈은 오픈AI의 GPT-6.2 Astra와 Sol 출시와 하비의 GPT-6 Astra 활용 사례를 보도한 바 있다.
오픈AI는 사내 법무팀의 사용 방식도 소개했다. 경쟁법 변호사는 법령 해석을 맡긴 뒤 입법 경위와 판결, 다른 언어로 된 법 조문을 근거로 반대편 논리를 펴게 한다. 정책 변호사는 감독 법안을 검토하며 독립 검토자가 수정을 권고하면 개발사가 반드시 따라야 하는지, 의무 조항마다 쉬운 설명과 법안 원문을 나란히 놓고 판단한다. 법무 프로그램 매니저는 규제 절차와 사내 정책을 접수 사건 처리 흐름으로 바꿔, 추가 자료 요청과 종결, 변호사 이관 시점을 자동화했다.
접근은 신뢰 접근 프로그램을 거친다. ChatGPT Enterprise 고객은 관리 콘솔에서 Astra for Law를 신청할 수 있고, 이미 권한이 있는 팀은 ChatGPT에서 gpt-6.2-astra-law를 고르면 된다. 자사 도구에 넣으려는 고객은 별도 신청서로 API 접근을 요청한다. 9월 발표에 따르면 자격을 갖춘 로펌에는 API의 데이터 무보존이 적용되고, ChatGPT Enterprise 사용분은 기본적으로 사람의 검토에서 빠진다.
테크 변호사의 눈으로 보면 이번 발표에서 가장 무게가 실리는 숫자는 순위보다 과제당 0.03건이라는 중대 환각률이다. 법률 업무에서 AI 도입을 가로막아 온 것은 답의 수준보다 존재하지 않는 판례를 그럴듯하게 인용하는 위험이었고, 오픈AI도 그 지점을 정면으로 겨냥했다. 다만 LAB 과제를 만든 하비는 9월 발표에서 Astra for Law 위에 제품을 지을 API 고객으로 이름을 올린 회사이기도 하다. 120개 과제와 208개 질문에서 나온 수치가 실제 사건 서류에서도 유지되는지는 결국 서면에 서명하는 변호사의 검증으로 확인된다. 법률 AI 경쟁의 기준이 얼마나 잘 쓰느냐에서 얼마나 지어내지 않느냐로 옮겨 가고 있다는 것이 이번 업데이트가 보여 준 방향이다.
댓글