


이미지: METAL
요약
- 사카나AI가 10월 9일 TMLR 게재가 확정된 논문 「Beyond Imitation」을 공개했다. 논문 257편에 모순 1164건을 심은 벤치마크와 클로드 기반 심사 보조 시스템 MLR을 함께 내놨다.
- MLR은 리뷰 4개 조건에서 핵심 주장을 뒤집은 모순의 73.43%를 잡았지만, LLM-Review의 모델만 클로드로 바꿔도 거리 0 적발률이 14.56%에서 35.40%로 뛰어 격차의 상당 부분은 모델에서 나왔다.
- 실제 철회 논문에서는 적발률이 26.07%로 낮아졌고, 리뷰 한 건 비용은 약 0.5달러, 연구자 38회 세션의 의견 동의율은 81%였다.
- 공개
- 2026년 10월 9일 · 사카나AI X · arXiv 10월 8일 게시
- 게재
- TMLR 게재 확정 · 액션 에디터 7월 8일 소폭 수정 후 게재 권고
- 저자
- 레이철 테오 · 야마다 유타로 · 샤샹크 코티얀 · 이마주쿠 유키 · 타린 클라누왓
- 벤치마크
- 논문 257편(ACL·AISTATS·CVPR·ICML 2025, NeurIPS 2024) · 모순 1164건
- 심각도
- 제미나이 2.5 Pro 지식 그래프 · 핵심 주장과의 거리
- 채점
- o3 10회 평균 · 특이도 99.9% · 민감도 86.8%
- MLR 구성
- 부록 에이전트(클로드 Haiku 3.5) · 문헌 조사·심사 에이전트(클로드 Sonnet 4) · 세 번 읽기
- 거리 0 적발
- MLR 73.43%(리뷰 4개) · 60.79%(리뷰 1개) · 기존 11.17~14.81%
- 전체 적발
- MLR 40.95%(리뷰 4개) · 28.32%(리뷰 1개)
- 모델 교체
- LLM-Review 클로드 전환 시 전체 6.39%→16.43%
- 철회 논문
- MLR 유사 26.07% · 정확 16.11%
- 점수 상관
- 피어슨 ICLR 0.586 · NeurIPS 0.451 · ICML 0.429
- 조작 탐지
- 탈락 논문 50편 중 8건
- 비용
- 리뷰 1건 약 0.5달러 · 실험 전체 약 3500달러
- 사용자 연구
- 38회 세션 · 의견 378건 중 305건 동의(81%) · 약점 68%
- ICLR 물량
- 2020년 2594편 → 2026년 1만9525편 · 2026년 리뷰 7만6139건
사카나AI가 10월 9일 AI가 논문 심사위원을 돕는 방식을 다룬 논문 「Beyond Imitation」을 공개했다. 논문은 논문 속 모순을 AI 심사 시스템이 얼마나 잡아내는지 재는 벤치마크와, 사카나AI가 설계한 심사 보조 시스템 「다층 리뷰(MLR)」를 함께 내놨다. MLR은 논문의 핵심 주장과 정면으로 부딪히는 모순을 73.43% 잡아냈고, 비교 대상인 기존 AI 심사 시스템 세 개는 11~15%에 그쳤다. 논문은 머신러닝 학술지 TMLR 게재가 확정됐다.
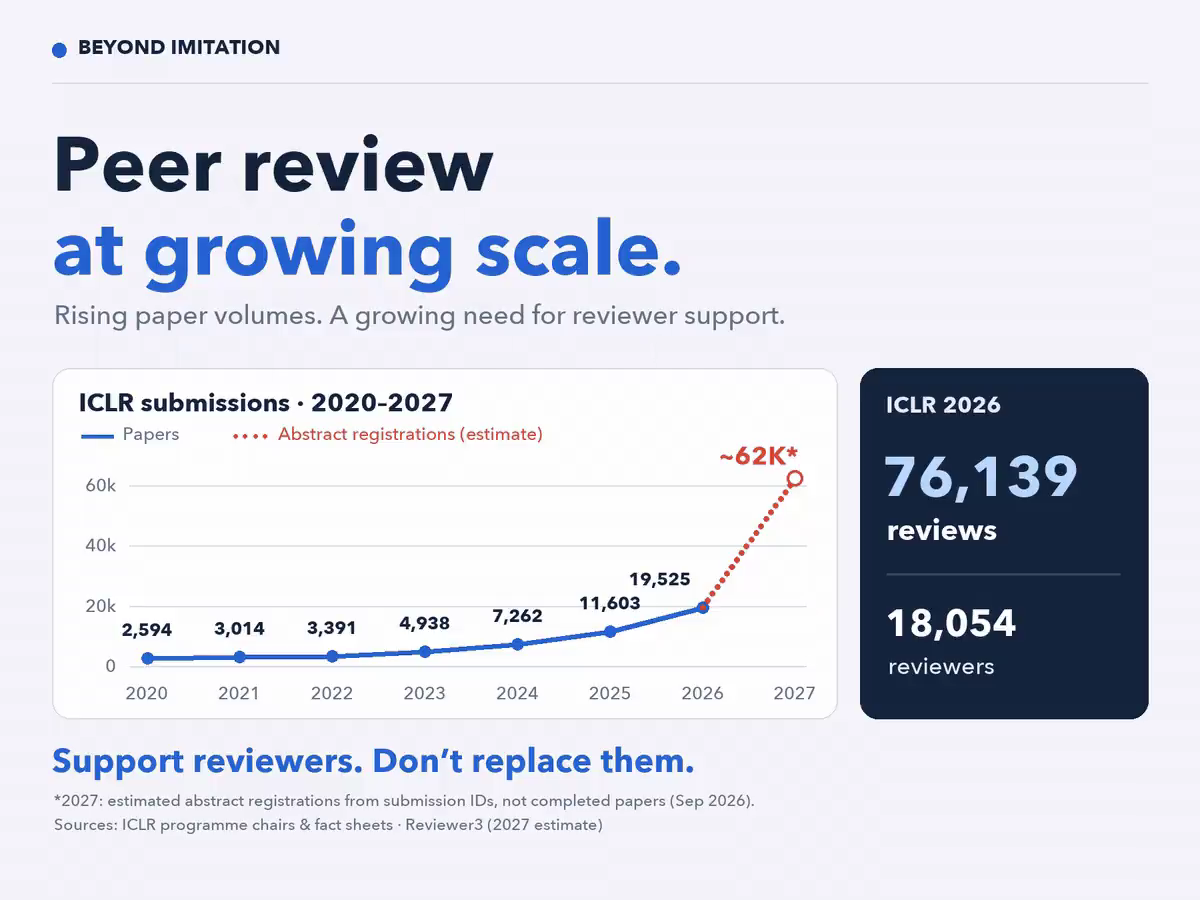
출발점은 심사 물량이다. 사카나AI가 논문과 함께 공개한 그래픽에 따르면 국제학회 ICLR 제출 논문은 2020년 2594편에서 2026년 1만9525편으로 늘었고, 2027년 초록 등록은 약 6만2000건으로 추정된다. ICLR 2026에서는 심사위원 1만8054명이 리뷰 7만6139건을 썼다. 사카나AI는 X에서 "동료 심사에 필요한 것은 대체재가 아니라 지원"이라며 "AI 심사 시스템 개발과 평가의 상당 부분이 사람의 리뷰를 얼마나 비슷하게 흉내 내는지에 맞춰져 있다"고 밝혔다. 논문 제목의 「흉내를 넘어서」는 여기서 나왔다.
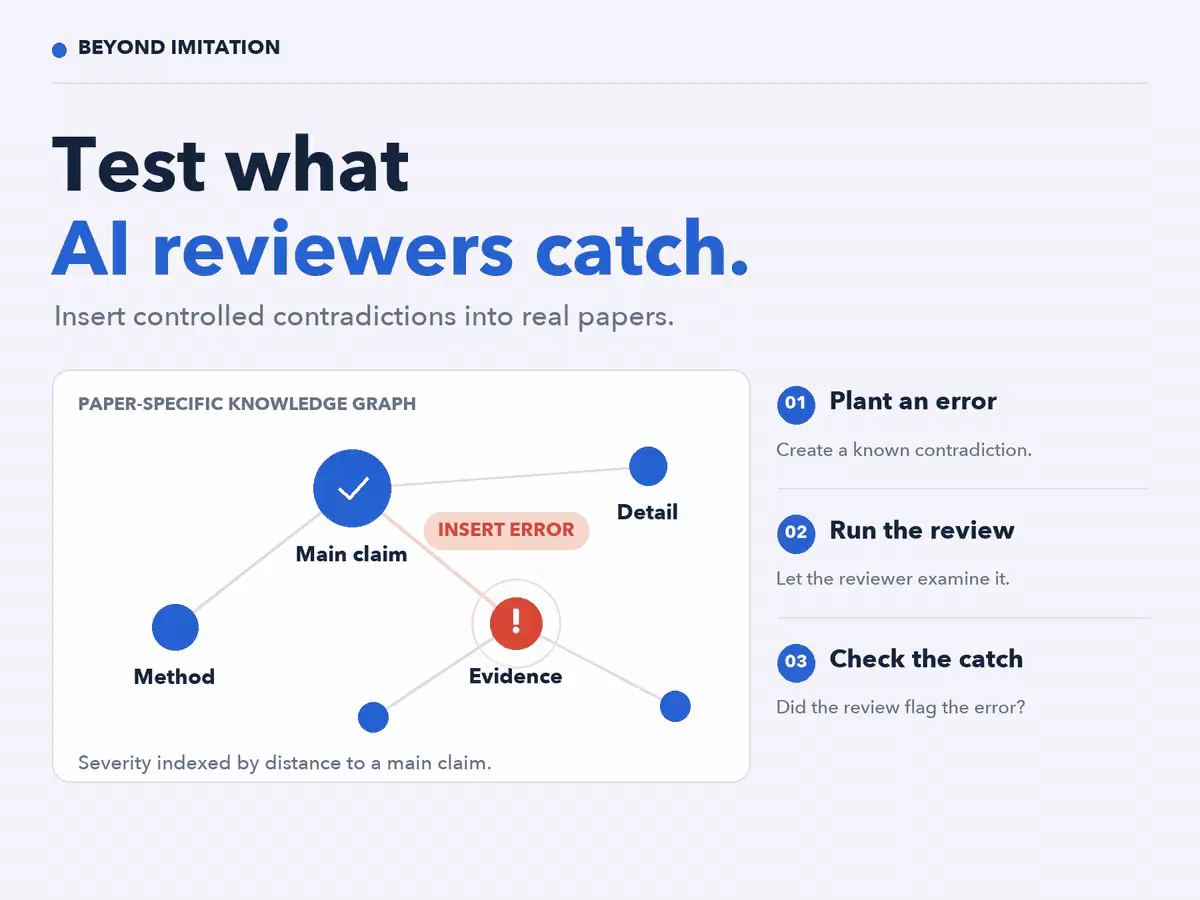
벤치마크는 일부러 틀린 논문으로 만들었다. 연구진은 2025년 ACL·AISTATS·CVPR·ICML과 2024년 NeurIPS에 실린 논문 257편을 모았다. 수정·재배포가 허용되는 크리에이티브 커먼즈 라이선스 논문만 골랐다. 제미나이 2.5 Pro로 논문마다 주장·근거·방법론·구현을 잇는 지식 그래프를 그린 뒤, 핵심 주장에서 떨어진 거리별로 한 곳씩 골라 원문과 어긋나는 문장을 심었다. 거리가 0이면 핵심 주장 자체를 뒤집은 가장 심각한 오류다. 이렇게 모순 1164건이 나왔다. 채점은 오픈AI의 o3가 10번 반복해 평균을 냈는데, 오류가 없는 원본 논문에서 「없다」고 맞힌 비율이 99.9%, 실제로 잡힌 모순을 「잡았다」고 인정한 비율이 86.8%였다.
MLR은 에이전트 셋으로 움직인다. 부록 에이전트(클로드 Haiku 3.5)가 부록을 요약하고, 문헌 조사 에이전트(클로드 Sonnet 4)가 웹 검색으로 선행 연구를 정리한다. 본문은 최대 10쪽까지 심사 에이전트(클로드 Sonnet 4)가 맡아 세 번 읽는다. 첫 번째는 개요, 두 번째는 근거와 약점, 세 번째는 앞의 결과를 합친 리뷰 작성이다. 연구 논문을 세 단계로 읽으라는 2007년 케샤브의 방법론을 옮긴 설계다. 사카나AI는 "생각은 단순하다"며 "판단하기 전에 먼저 논문을 이해한다"고 설명했다.
결과는 거리 0에서 갈렸다. 리뷰 4개를 겹쳐 하나라도 오류를 지적하면 성공으로 친 조건에서 MLR은 거리 0 모순의 73.43%, 전체 40.95%를 잡았다. 비교 대상은 LLM-Review가 14.56%, AI Reviewer는 11.17%, AgentReview는 14.81%였다. 리뷰 하나만 써도 MLR은 거리 0에서 60.79%, 전체 28.32%를 기록했다. 모든 시스템에서 핵심 주장과 멀어질수록 적발률이 떨어졌고, 연구진은 이것이 지식 그래프 거리로 매긴 심각도가 제대로 작동한다는 증거라고 밝혔다.
이 격차 가운데 상당 부분은 모델에서 나왔다. 비교 대상 세 시스템은 모두 오픈AI GPT 계열을 쓰고 MLR만 클로드를 쓴다. 연구진이 LLM-Review의 모델만 클로드 Sonnet 4로 바꿔 돌리자 단일 리뷰 적발률이 전체 6.39%에서 16.43%로, 거리 0에서 14.56%에서 35.40%로 뛰었다. 세 번 읽기 대신 하나의 프롬프트로 합친 MLR 변형도 497편 부분집합에서 24.81%를 기록해 원래 단일 리뷰의 28.32%와 큰 차이가 없었다. 연구진은 OpenReview 답변에서 세 단계 구조가 오류 적발에도 점수 상관에도 실질적 영향이 크지 않았다고 인정했다. 다만 거리 3 이상의 찾기 어려운 오류에서는 차이가 벌어졌다. 심사를 맡은 액션 에디터 콴밍 야오는 7월 8일 「소폭 수정 후 게재」를 권고하며 "벤치마크와 검증 중심의 관점은 시의적절하고 유용하다"고 평가했다.
실제 철회 논문에서는 숫자가 낮아졌다. 오류로 철회된 arXiv 논문을 모은 WithdrarXiv-Check에서 MLR은 철회 사유와 비슷한 문제를 짚은 비율이 26.07%, 정확히 일치한 비율이 16.11%였다. 차순위는 각각 AgentReview 18.48%, AI Reviewer 9.00%였다. 철회 사유에 「증명」이 들어간 논문만 추리면 MLR은 15.2%와 8.7%로 떨어졌다. 사람 평가자 감사에서는 심은 모순 50건 중 34%가 앞뒤 문장 흐름이 부자연스럽다는 평가를, 8%가 AI가 쓴 티가 난다는 평가를 받았다. 연구진은 "모순이 인위적으로 만들어진 만큼 실제 실수보다 찾기 쉬운 것이 맞다"고 답했다. 그만큼 기존 시스템이 쉬운 오류조차 놓친다는 해석도 함께 내놨다.
사람 심사와의 거리도 쟀다. ICLR 2025 논문에서 MLR 리뷰로 예측한 점수와 실제 사람 점수의 피어슨 상관계수는 0.586이었고, NeurIPS 2024에서 0.451, ICML 2025에서 0.429였다. ICML에서는 AI Reviewer가 0.439로 근소하게 앞섰다. 반면 리뷰가 무엇을 짚는지는 사람과 달랐다. 사람이 글의 명료성과 참신성을 자주 지적할 때 MLR은 타당성에 무게를 실었고, 사람 리뷰와의 초점 분포 차이(KL 발산 평균)는 0.240으로 비교 대상 가운데 AI Reviewer의 0.266 다음으로 컸다.
공격에도 시험했다. 연구진은 대부분 ICLR 2025에 냈던 탈락 논문 50편의 결론 뒤에 AI 심사위원의 판단을 흔드는 숨은 문장을 넣었다. 모든 시스템이 이 문장에 크게 흔들렸고, MLR은 50건 중 8건에서 조작 문장의 존재를 알아챘다. 비용은 리뷰 한 건에 약 0.5달러였다. MLR의 입력 토큰은 18만9062개로 AI Reviewer의 40만3654개의 절반 수준이다. 연구진은 논문 전체 실험의 API 비용을 약 3500달러로 추산했다.
실제 연구자 반응은 약점 항목에서 가장 박했다. 연구자들이 자기 원고를 올려 MLR 전체 시스템을 써 본 38회 세션에서 리뷰 의견 378건 중 305건(81%)에 동의를 받았다. 종합 권고는 94%, 강점은 92%였지만 약점은 68%로 가장 낮았다. 비판 강도 점수는 5점 만점에 2.88로 중립에 가까웠고, 비판이 셀수록 유용성 평가가 떨어지는 약한 음의 상관(r=-0.29)이 나왔다.
메탈이 확인한 58쪽 논문 원문과 OpenReview 심사 기록에 따르면 저자는 사카나AI의 레이철 테오·야마다 유타로·샤샹크 코티얀·이마주쿠 유키·타린 클라누왓 연구원 5명이다. 논문은 10월 8일 arXiv에 올라왔고, 심사위원 3명이 모두 모델과 설계의 효과를 분리하라고 요구해 그 결과가 본문 그래프에 들어갔다. 메탈은 사카나AI가 역전파 없는 학습법 PC-ALM을 공개한 소식과 위르겐 슈미트후버를 수석 과학 고문으로 영입한 소식을 보도한 바 있다.
엔지니어의 눈으로 보면 이 논문이 남기는 것은 MLR보다 벤치마크다. 적발률 상승의 상당 부분이 모델 교체에서 나왔고 세 번 읽기 구조의 효과는 어려운 오류에 국한됐다. 반면 지식 그래프로 오류의 무게를 매겨 심는 파이프라인은 새 학회 논문으로 계속 늘릴 수 있다. 사카나AI는 "사람의 전문성과 판단을 중심에 둔 채 심사위원이 연구를 점검하도록 돕는 것"이 목표라고 밝혔다.
댓글