


이미지: METAL
요약
- 오픈AI가 10월 5일 EU 인공지능법 대응으로 유럽연합 챗GPT·코덱스 출력에 보이지 않는 워터마크 textGrain을 몇 주에 걸쳐 도입한다고 발표했다.
- 전 세계 API 고객은 일부 모델에서 워터마크를 직접 켤 수 있고 기본값은 꺼짐이며, 판별기는 심사를 거친 연구자와 전문 기관에만 연다.
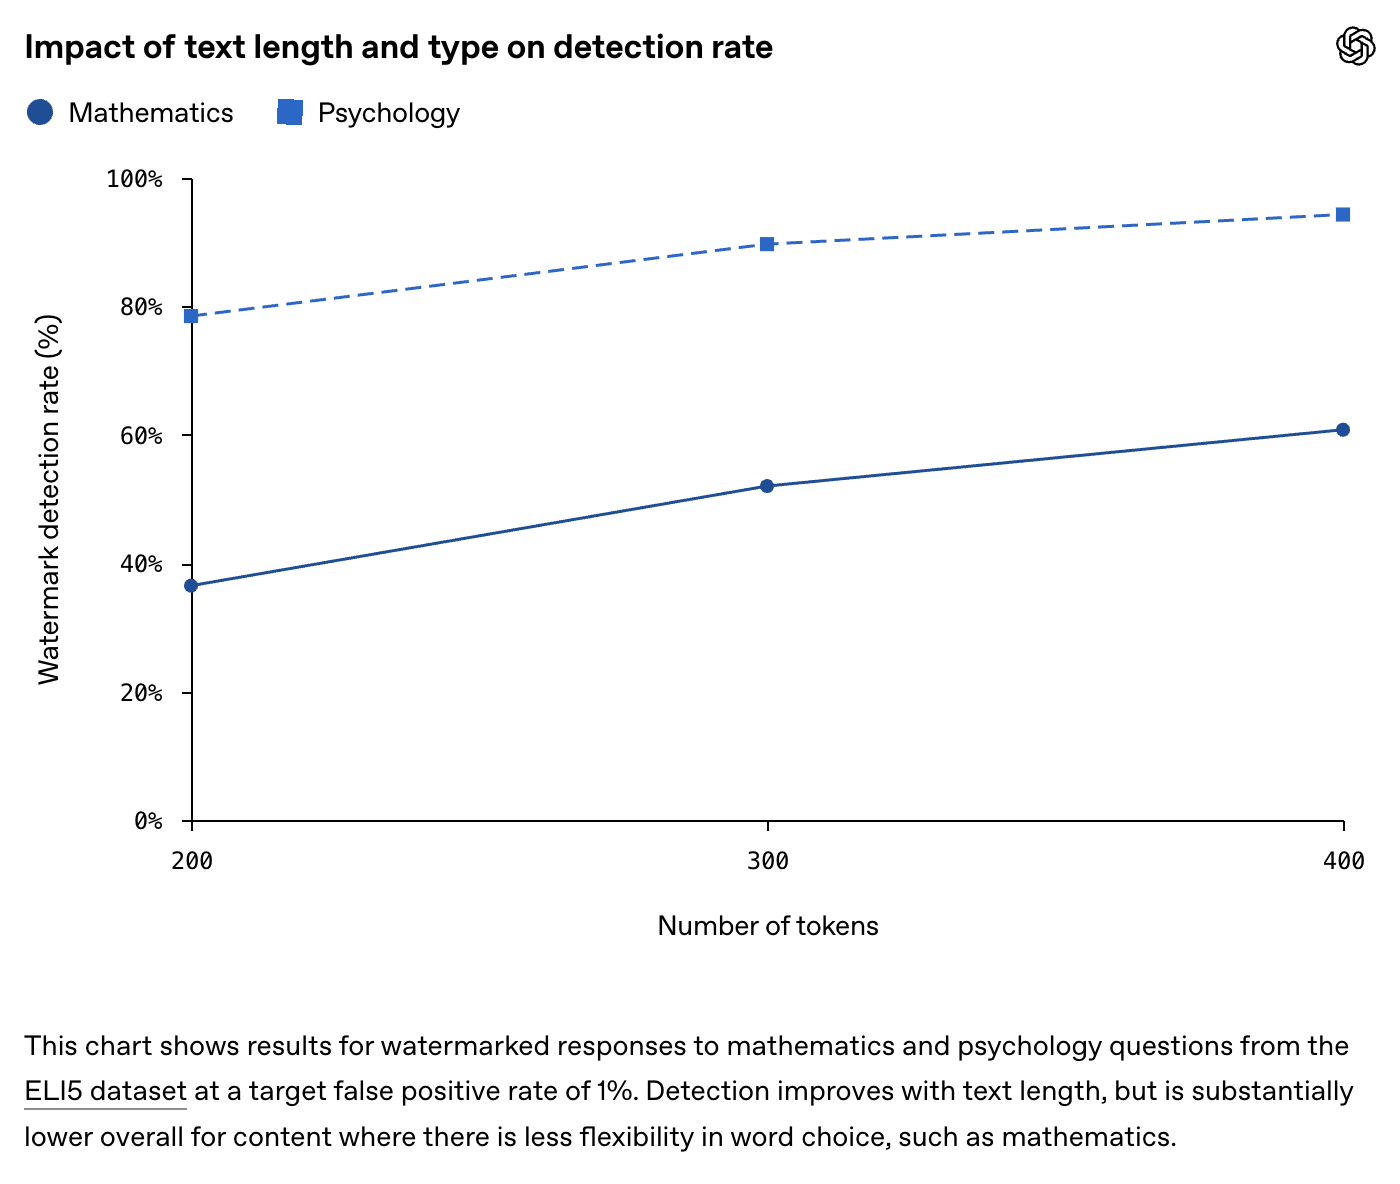
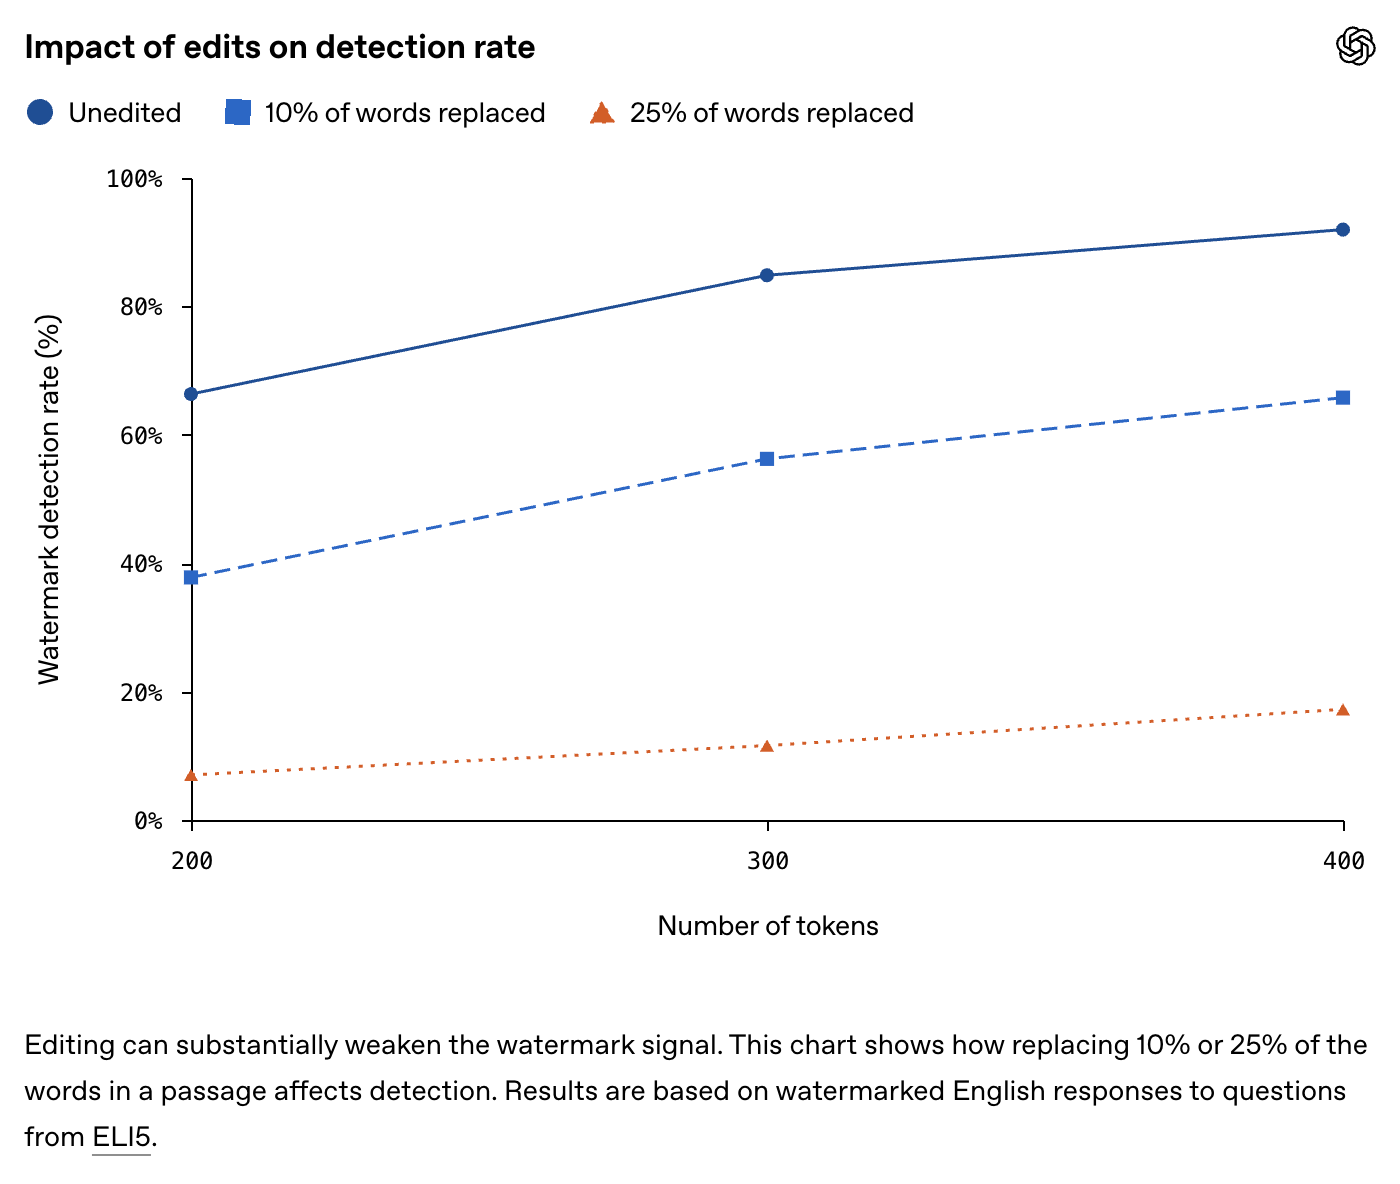
- 오탐률 1% 기준 400토큰 글의 판별률은 약 95%였지만 낱말 25%를 동의어로 바꾸면 17%로 떨어졌고, 아스트라 벤치마크 품질 차이는 없었다고 회사는 밝혔다.
- 발표
- 2026년 10월 5일(현지시간) · 오픈AI 「Our approach to EU text provenance rules」 · EU 인공지능법 텍스트 출처 규칙 대응
- 챗GPT·코덱스
- 유럽연합 한정 · 모든 요금제 적용 대상 출력 · 앞으로 몇 주에 걸쳐 도입 · 세계 기본값 아님
- API
- 발표 당일부터 전 세계 고객이 일부 모델에서 선택 적용 · 기본값 꺼짐 · 클라우드 파트너 경유 출력은 몇 주 안에
- 판별기
- 심사를 거친 연구자·전문 기관만 신청 · 실천 강령에 따라 사례별 허용 · 이용자·프롬프트·대화 비공개
- 판별 성능
- 오탐률 1% 기준 심리학 답변 200토큰 약 80%, 400토큰 약 95% · 수학 답변은 크게 낮음
- 편집 영향
- 400토큰 글 낱말 10% 동의어 교체 시 약 92%→66% · 25% 교체 시 17%
- 품질
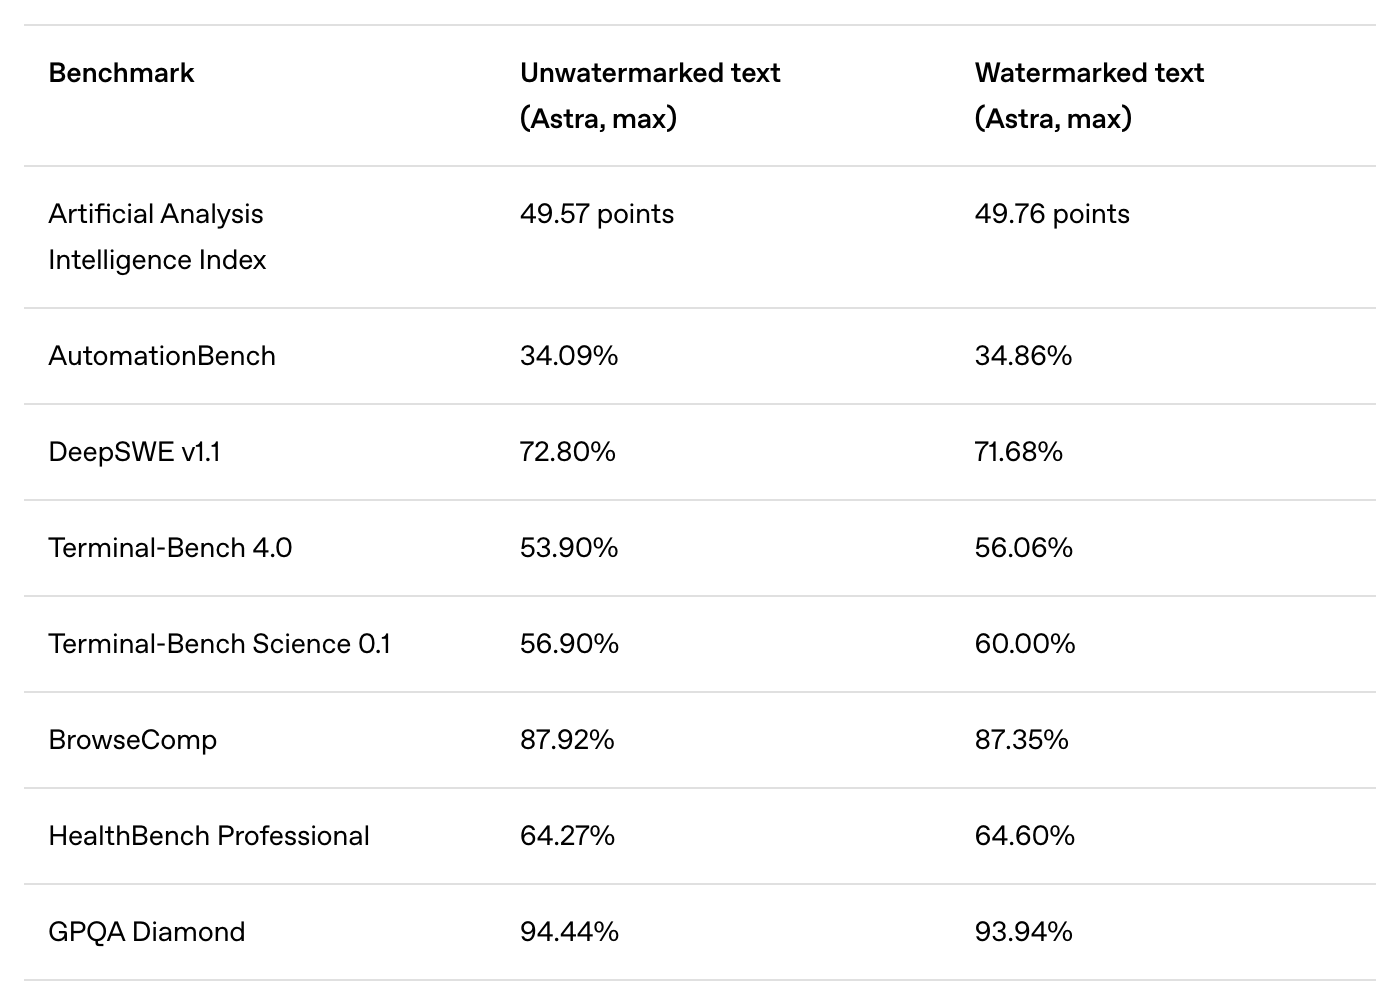
- 아스트라(최대 설정) 8개 벤치마크 · 아티피셜 애널리시스 지수 49.57→49.76점 · GPQA 다이아몬드 94.44→93.94%
- 기술 보고서
- 20쪽 · 저자 9명(오픈AI 5명·펜실베이니아대·예일대 4명) · 어휘 묶음 최적 수송 · 엔트로피 예산 · 교신저자 웨이제 수
오픈AI가 10월 5일(현지시간) 유럽연합(EU) 인공지능법(AI Act)의 텍스트 출처 규칙에 대응하는 텍스트 워터마크 도입 계획을 발표했다. 회사가 직접 만든 워터마크 기술의 이름은 textGrain이다. 유럽연합 안에서는 앞으로 몇 주에 걸쳐 챗GPT와 코덱스(Codex)가 쓰는 글 가운데 적용 대상 출력에 눈에 보이지 않는 워터마크가 붙고, 전 세계 API 고객은 발표 당일부터 일부 모델에서 워터마크를 직접 켤 수 있게 됐다. API의 기본값은 꺼짐이다. 워터마크를 찾아내는 판별기는 일반에 풀지 않고, 심사를 통과한 연구자와 전문 기관에만 신청을 받아 열기로 했다.
EU 인공지능법은 생성형 AI 제공자에게 AI가 만든 텍스트를 기계가 읽을 수 있는 방식으로 식별 가능하게 하라고 요구한다. 보도에 따르면 이 의무를 담은 제50조는 2026년 8월 2일 발효됐고, 기존 시스템에는 12월 2일까지 전환 기간이 주어졌다. 오픈AI는 발표문에서 "텍스트 워터마킹과 판별은 여전히 초기 기술이며 상당한 한계를 안고 있다"고 밝히고, 단계적 접근이 법의 요구와 기술의 현실을 함께 반영한 결과라고 설명했다. 오픈AI는 앞서 자사 지원 페이지에 "텍스트를 포함한 모든 형식으로 출처 신호를 넓히는 것이 목표"라고 적은 바 있다.
textGrain은 모델이 다음 낱말을 고르는 확률에 비밀 키로 만든 통계적 신호를 섞는 방식이다. 읽는 사람 눈에는 아무 차이가 없지만, 같은 키를 가진 판별기는 낱말 선택에 남은 치우침을 찾아 오픈AI 워터마크가 들어 있는지 가린다. 메탈이 확인한 20쪽 분량의 기술 보고서에 따르면 이 방법은 어휘를 키에 따라 여러 묶음으로 나누고, 최적 수송(optimal transport) 문제를 풀어 어떤 묶음이 뽑힐지를 키와 엮는다. 묶음 안에서는 낱말끼리의 원래 확률 비율을 그대로 둔다. 키를 무작위로 뽑아 평균을 내면 원래 모델의 분포가 그대로 돌아오도록 설계해, 워터마크가 모델의 답을 한쪽으로 몰지 않게 했다.
엔지니어 눈으로 볼 때 핵심 장치는 엔트로피 예산이다. 기존 굼벨-맥스(Gumbel-max) 방식은 같은 문맥과 같은 키에서 늘 같은 낱말을 고르기 때문에, 같은 질문을 여러 번 던지면 똑같은 답이 반복될 수 있다. 보고서는 이 문제를 짚으며 워터마크가 앗아 가는 샘플링 무작위성을 KL 발산 값 하나로 재고, 그 상한을 엔트로피의 일정 비율로 묶었다. 판별기는 생성된 텍스트와 비밀 키만 있으면 돌아가고, 생성에 쓴 모델이나 예산 값을 알 필요가 없다. 보고서는 이 방식이 초안 모델과 본 모델이 키를 공유하는 투기적 샘플링(speculative sampling)과도 함께 쓸 수 있다고 밝혔다. 저자는 9명으로 오픈AI 연구진 5명과 펜실베이니아대·예일대 연구진 4명이며, 교신저자는 오픈AI의 웨이제 수(Weijie Su)다.
오픈AI가 공개한 성능 수치는 조건에 따라 크게 갈렸다. 오탐률 목표를 1%로 둔 시험에서 판별기는 심리학 분야 답변 200토큰 분량의 약 80%, 400토큰 분량의 약 95%에서 워터마크를 찾았다. 낱말 선택의 폭이 좁은 수학 답변에서는 판별률이 크게 떨어져, 회사가 공개한 그래프상 200토큰에서 40%에 못 미쳤고 400토큰에서도 60% 안팎에 머물렀다. 손을 댄 글은 더 어려웠다. 400토큰 글에서 낱말의 10%를 동의어로 바꾸자 판별률은 약 92%에서 66%로 내려갔고, 25%를 바꾸자 17%까지 떨어졌다. 오픈AI는 자사가 시험한 다른 방식들, 구글의 텍스트용 SynthID와 비교해도 textGrain이 같거나 나은 성능을 냈다고 밝혔다. 다만 이상적 조건의 성적이 일상 사용에서의 안정적 판별을 보장하지 않는다는 점도 발표문에 함께 적었다.
품질 손실은 거의 없었다는 것이 회사 설명이다. 오픈AI는 최신 프런티어 모델 아스트라(Astra)를 최대 설정으로 돌려 워터마크를 넣은 출력과 넣지 않은 출력을 8개 벤치마크에서 비교했다. 아티피셜 애널리시스 인텔리전스 지수는 49.57점에서 49.76점, GPQA 다이아몬드는 94.44%에서 93.94%, DeepSWE v1.1은 72.80%에서 71.68%, 터미널-벤치 4.0은 53.90%에서 56.06%였다. 오르내림이 양쪽으로 섞여 있어 회사는 의미 있는 성능 차이가 보이지 않는다고 결론지었다.
판별기를 일반에 풀지 않는 결정은 이 수치에서 나왔다. 오픈AI는 워터마크가 없는데 있다고 하는 오탐과 있는데 놓치는 미탐의 위험을 들어 출시 시점에는 공개하지 않는다고 밝혔다. 판별기는 투명성 실천 강령(Code of Practice)에 따라 사례별로 접근을 허용하며, 오픈AI 워터마크가 있는지만 알려 주고 이용자가 누구인지나 프롬프트와 대화 내용은 드러내지 않는다. 회사는 워터마크 결과로 알 수 없는 것도 다섯 가지로 못 박았다. 사람이 얼마나 기여했는지, 글의 소유권과 책임이 누구에게 있는지, 누가 썼는지, 내용이 정확한지를 워터마크는 말해 주지 않는다. 워터마크가 안 잡혔다고 사람이 쓴 글이라는 증거도 아니다. 너무 짧거나 고쳐 쓰였거나 번역됐을 수 있고, 다른 회사 도구로 만든 글일 수도 있기 때문이다.
경쟁사 중에서는 앤스로픽이 먼저 움직였다. 메탈은 앤스로픽이 클로드가 쓴 글에 보이지 않는 워터마크를 넣기로 한 소식을 보도한 바 있다. 앤스로픽은 당시 "첫날부터 AI 생성 콘텐츠에 표시하겠다"고 밝히며 지원 지역 전체에 적용했다. 오픈AI는 반대로 챗GPT 워터마크를 유럽연합에서만 켜고 세계 기본값으로 삼지 않는다고 밝혔다. 지역 단위로 시작해 실제 사용과 피드백에서 배우겠다는 이유다. 보도에 따르면 마이크로소프트, 메타, 미스트랄도 같은 강령에 서명했지만 xAI는 서명하지 않아 그록(Grok)에는 같은 약속이 없다.
이미지와 오디오 쪽 장치는 그대로 유지된다. 오픈AI는 지원되는 이미지에 콘텐츠 자격 증명(Content Credentials)을 붙이고 C2PA 표준을 따르며, 이미지와 오디오에 구글의 SynthID 워터마크를 넣는다. openai.com/verify 웹 도구와 콘텐츠 출처 API(Content Provenance API)도 계속 공개로 열어 둔다. 회사는 앞으로 몇 주 안에 클라우드 파트너를 거쳐 쓰는 오픈AI 모델 출력에도 워터마크를 제공하고, 기술 보고서를 보강하며, textGrain을 오픈소스로 내놓을 계획이라고 밝혔다.
이번 발표가 남긴 숫자는 25%다. 낱말 넷 중 하나를 바꾸면 판별률이 17%로 떨어진다는 사실은, 텍스트 워터마크가 AI 글을 잡아내는 탐지기가 아니라 손대지 않은 출력의 출처를 확인하는 도장에 가깝다는 뜻이다. 오픈AI는 수치와 함께 그 경계를 먼저 공개하고 판별기 접근을 좁게 여는 쪽을 택했다. 규제가 요구하는 기계 판독 표시와 현재 기술이 줄 수 있는 신뢰도 사이의 간격을, 회사는 증거와 표준이 쌓이는 대로 다시 좁혀 가겠다고 밝혔다.
댓글