


이미지: 영상 갈무리
요약
- 구글이 9월 23일 Gemini 3.8 Flash TTS와 Flash-Lite TTS 2종을 출시했어요.
- 기본 목소리 30개에서 2,000개 이상의 라이브러리로 넓히고, 글로 새 목소리를 짓거나 30초 샘플로 복제할 수 있어요.
- 흄 AI 목소리 설계 벤치마크에서 71.4점으로 1위였고, 입력은 텍스트 최대 8K 토큰이에요.
- 발표
- 2026년 9월 23일 · 구글 · Gemini Audio 팀
- 모델
- Gemini 3.8 Flash TTS(창작) · Gemini 3.8 Flash-Lite TTS(대량 처리)
- 목소리
- 기본 30개 → 2,000개 이상 라이브러리 · 100개 이상 언어·방언
- 복제
- 30초 샘플 · 목소리 주인 구두 동의 녹음 확인 · SynthID · C2PA
- 연출
- 줄 단위 무대 지시 · 비언어 태그 · 맞장구 · 두 화자 장면
- 규격
- Gemini 3 Pro 기반 · 입력 텍스트 8K · 출력 오디오 64K 토큰
- 지식 기준
- 2025년 1월
- 벤치마크
- 흄 AI 목소리 설계 71.4(1위) · 억양 60.8(1위) · 종합 품질 1·2위
- 배포
- Gemini API · AI Studio · Gemini Notebook(Flash) · Google Vids(Flash-Lite)
- 기업용
- Gemini Enterprise API 곧 제공
- 복제 제외 지역
- 일리노이 · 텍사스 · 유럽경제지역 · 영국 · 스위스 · 인도(보도)
- 파트너
- 피그마 · 헤이젠 · 원더크래프트 등 6곳 · 플랫폼 Agora·LiveKit·Pipecat·Vercel
구글이 9월 23일 텍스트를 음성으로 바꾸는 Gemini 3.8 TTS 모델 2종을 출시했어요. 창작용 Gemini 3.8 Flash TTS는 자연어 설명만으로 새 목소리를 설계하고, 대량 처리용 Gemini 3.8 Flash-Lite TTS는 더빙과 음성 에이전트처럼 물량이 많은 작업을 맡아요. 두 모델 모두 같은 날부터 Gemini API와 Google AI Studio에서 풀리기 시작했어요.
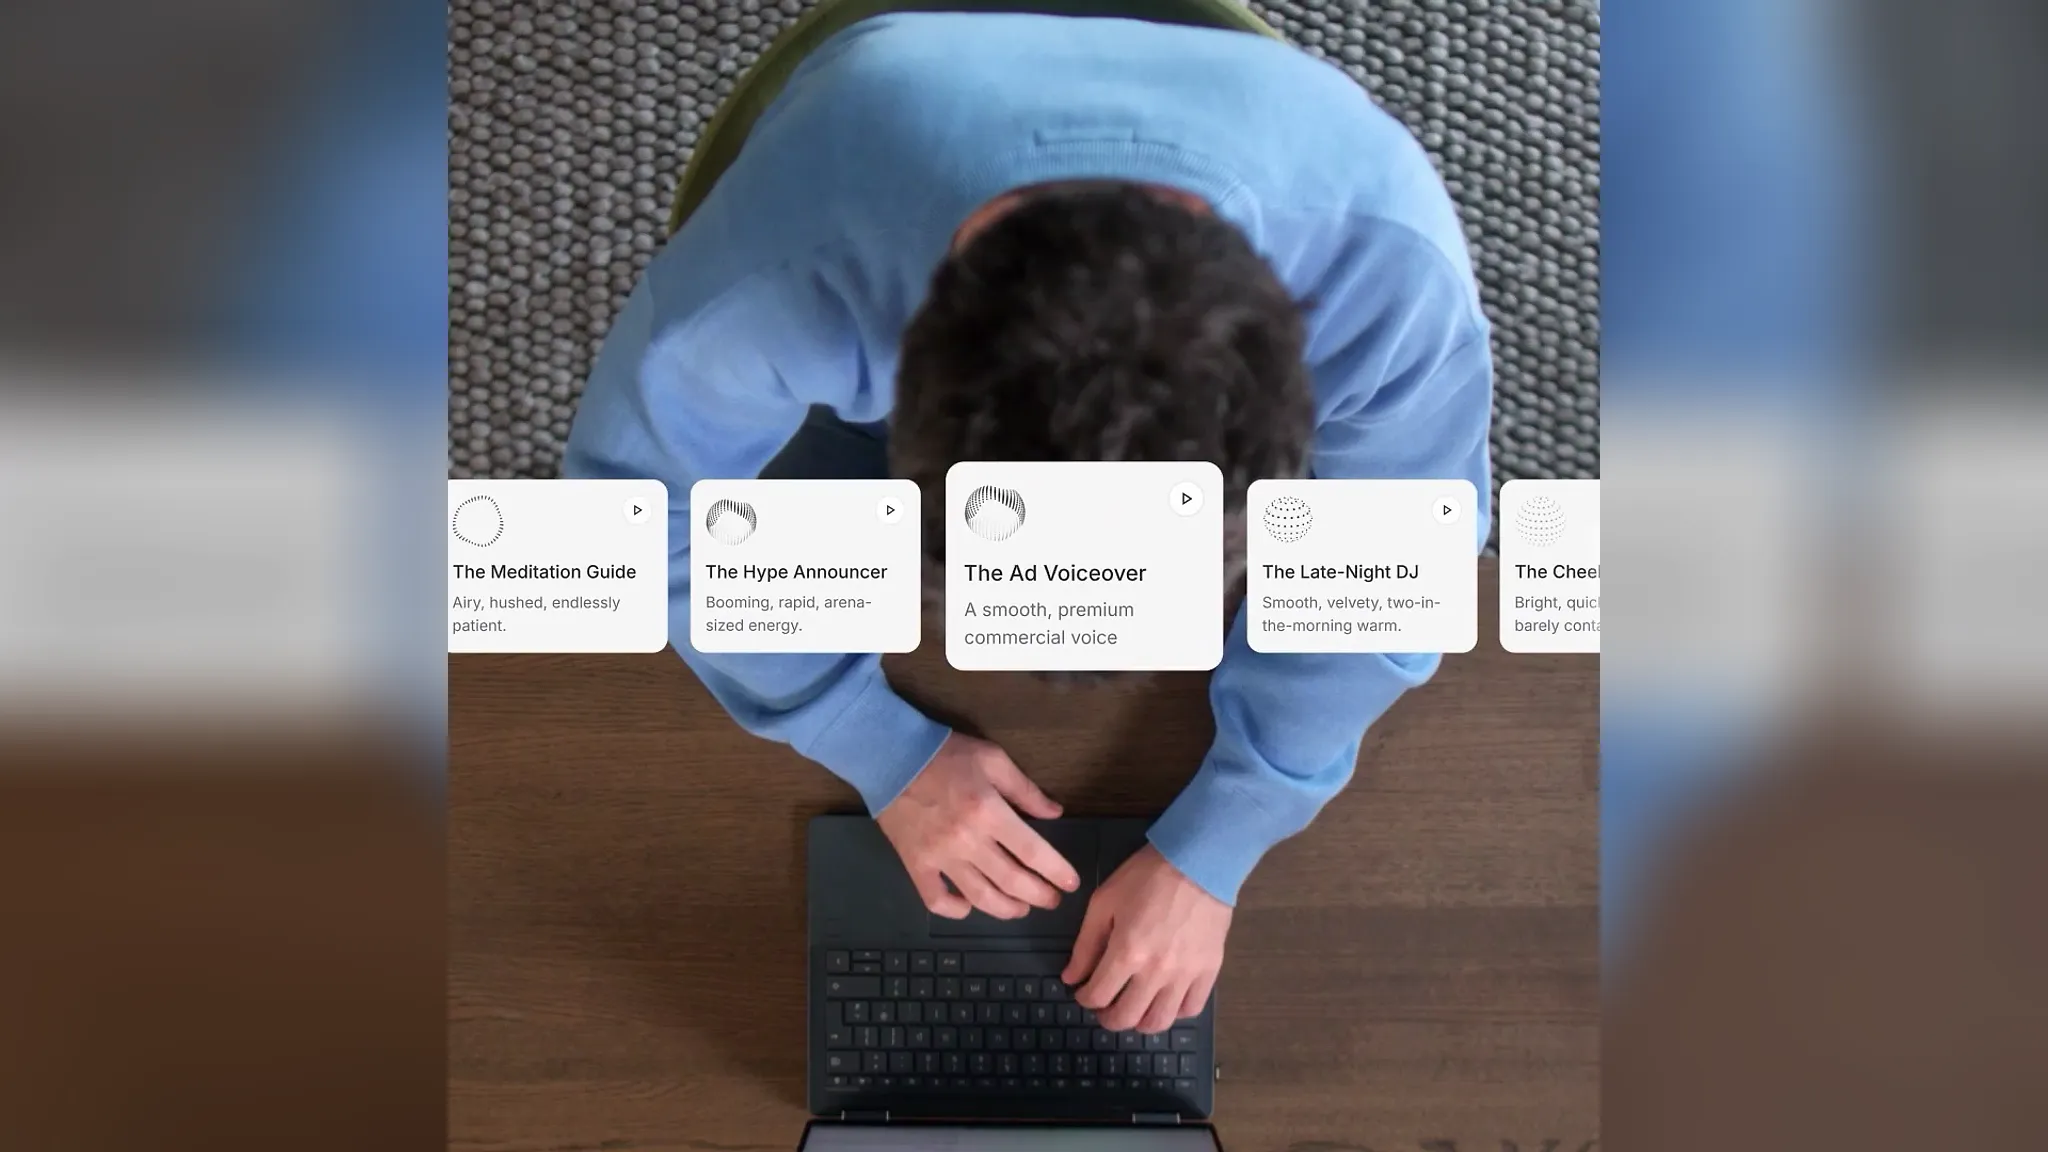
구글의 설명은 한 문장으로 모여요. 발표문을 쓴 리랜드 레치스 그룹 프로덕트 매니저와 앨런 코웬 연구과학 디렉터는 이번 모델이 "음성 생성을 정적인 프리셋에서 역동적인 창작 스튜디오로 바꾼다" 고 밝혔어요. 기본 목소리 30개를 고르던 방식에서, 제작 현장에 바로 쓰는 목소리 2,000개 이상의 라이브러리와 직접 만드는 목소리로 넓혔다는 뜻이에요. 라이브러리에는 멕시코 스페인어, 퀘벡 프랑스어, 스코틀랜드 영어 같은 지역 변종도 들어 있어요.
목소리를 만드는 길은 세 갈래예요. 첫째는 역할과 억양, 음색을 글로 적어 목소리를 처음부터 짓는 방식이고, 100개가 넘는 언어와 방언에서 돼요. 둘째는 30초짜리 음성 샘플로 본인 목소리나 사용 권리가 있는 목소리를 재현하는 방식이에요. 셋째인 음성 리믹스는 라이브러리 목소리의 음색과 음높이, 속도, 억양을 프롬프트로 다듬는 기능인데 곧 나온다고만 적혀 있어요. 만든 목소리는 저장해 두고 여러 프로젝트에서 같은 소리로 이어 쓸 수 있어요.
엔지니어 입장에서 눈에 띄는 건 연출 문법이에요. 대본 줄마다 무대 지시를 직접 쓰거나 Gemini가 대본의 단서를 읽고 말투를 정하게 할 수 있어요. 웃음과 한숨, 헉 하는 소리는 꺾쇠 태그로, 맞장구는 세로 막대로 감싼 짧은 말로 넣어요. 대본 하나로 두 화자의 대화를 목소리가 섞이지 않게 주고받게 하는 기능도 모델 안에 들어 있고, 구글은 몇 시간 이어지는 오디오에서도 화자 음색이 거의 흔들리지 않는다고 설명했어요. 팟캐스트와 오디오북을 겨냥한 설계예요.
규격은 모델 카드에 적혀 있어요. 구글 딥마인드의 Gemini 3.8 Audio 모델 카드에 따르면 두 TTS 모델은 Gemini 3 Pro를 바탕으로 하고, 입력은 텍스트 최대 8K 토큰, 출력은 오디오 64K 토큰이에요. 같은 카드에 묶인 Gemini 3.8 Live가 오디오와 이미지, 영상, 텍스트를 128K까지 받는 것과 달리 TTS는 입력을 텍스트로만 받아요. 지식 기준 시점은 2025년 1월이고, 알려진 약점으로는 환각과 가끔 생기는 지연·시간 초과가 적혀 있어요.
성능 근거는 외부 평가표에서 가져왔어요. 구글에 따르면 Gemini 3.8 Flash TTS는 흄 AI의 목소리 설계 벤치마크에서 71.4점으로 종합 1위, 억양 모델링에서 60.8점으로 1위였어요. 같은 회사의 종합 품질 지수에서는 Flash TTS가 1위, Flash-Lite TTS가 2위였어요. 블라인드 선호 평가인 Voice Arena에서는 일본어, 브라질 포르투갈어, 베트남어, 현대 표준 아랍어, 멕시코 스페인어, 힌디어에서 상위권에 올랐다고 구글은 밝혔어요. 이전 세대인 Gemini 3.1 Flash TTS와 견주면 긴 콘텐츠와 두 화자 대본 제어에서 크게 나아졌다는 게 회사 설명이에요.
목소리 복제에는 문턱을 뒀어요. 레치스와 코웬은 발표문에서 "목소리를 만들기 전에 사용자는 참조 화자와 일치하는 목소리 주인의 구두 동의 녹음을 제출해야 한다" 고 적었어요. 모든 생성 음성에는 귀에 들리지 않는 SynthID 워터마크가 오디오 안에 섞여 들어가고, 복제 기능에는 C2PA 출처 정보도 붙어요. 보도에 따르면 AI Studio의 음성 복제는 미국 일리노이주와 텍사스주, 유럽경제지역, 영국, 스위스, 인도에서는 쓸 수 없어요. 생체 정보와 목소리 권리를 둘러싼 규제가 기능 지도에 그대로 찍힌 셈이에요.
메탈이 확인한 구글 딥마인드의 59초 X 홍보 영상은 목소리를 글로 주문하고, 세 후보 중 하나를 고르고, 한 화자를 조금 더 낮게 다듬어 두 화자 장면에 넣은 뒤, 짧은 음성 본인 확인을 거쳐 자기 목소리로 바꾸는 흐름을 보여 줘요. 영상 속 내레이션은 바로 쓰는 목소리를 천여 개라고 말하는데, 발표문은 2,000개 이상으로 적었어요. 이 게시물은 올라온 지 한 시간이 안 돼 조회 1만 8천 회를 넘겼어요.
배포 경로는 모델마다 달라요. Flash TTS는 개발자에게 Gemini API와 AI Studio로, 일반 사용자에게는 Gemini Notebook으로 가고, Flash-Lite TTS는 Google Vids에 들어가요. 기업용 Gemini Enterprise API는 두 모델 모두 곧 나온다고만 적혀 있어요. 개발자 플랫폼 중에서는 Agora, LiveKit, Pipecat, Vercel이 Gemini API를 통해 지원하고, 피그마와 헤이젠, 원더크래프트 등 6곳이 더빙과 현지화, 음성 에이전트에 붙이는 파트너로 이름을 올렸어요.
구글의 음성 라인업은 9월 들어 빠르게 채워졌어요. 메탈은 구글이 9월 15일 실시간 대화용 Gemini 3.8 Live와 Live Extended Thinking을 내놨다고 보도한 바 있으며, 이번 TTS 2종은 그 뒤를 잇는 발표예요. 모델 카드는 두 TTS 모델이 Gemini 3.7 Flash와 비교해 의미 있는 새 능력이 없다며 프런티어 안전 기준의 추적·위험 능력 수준에 이르지 않을 것으로 판단했어요.
TPM의 눈으로 보면 이번 발표의 핵심은 음성이 선택 목록에서 코드로 관리하는 자산으로 바뀌었다는 점이에요. 목소리를 프롬프트로 짓고 저장해 여러 제품에 같은 소리로 붙이며, 연기 지시는 대본 태그로 버전 관리하는 흐름이에요. 창작 품질은 Flash, 물량은 Flash-Lite로 나눈 구성도 파이프라인 설계에 그대로 대응해요. 남은 과제는 복제 기능이 막힌 지역에서 같은 제품을 어떻게 운영하느냐, 그리고 기업용 API가 언제 열리느냐예요.


댓글