

이미지: METAL
요약
- 앤스로픽은 11월 6일 엔지니어링 블로그에서 에이전트 메모리의 구성 요소와, 쉬는 동안 기록을 되짚어 메모리를 정리하는 드리밍 실험을 공개했다.
- CL-Bench에서 메모리를 쓴 Opus 5.5는 0.838점으로 기준선 0.655점을 앞섰고, 포켓몬 레드에서 Fable 5는 파일 10개로 배지 4개를, Sonnet 3.7은 파일 413개로 배지 1개를 얻었다.
- 드리밍은 틀린 메모를 세션 기록과 대조해 고치고 위키를 지어, 사내 문서 질문 점수를 13%에서 48%로, 계약 사실 보존율을 72%에서 100%로 끌어올렸다.
- 발표
- 2026년 11월 6일(미국 시간) · 앤스로픽 엔지니어링 블로그 「The components of agent memory」 · 글 랜스 마틴
- 드리밍
- 유휴 시간에 기록을 되짚어 메모 정정·새 메모·위키 구축 · 레타·UC 버클리 수면 시간 연산에서 출발
- 메모리 층
- 대화 기록 · 클로드가 쓴 메모 · 위키 같은 표현 · 매 세션 주입 맥락
- CL-Bench 1.0 (메모리/기준선)
- Opus 5.5 0.838/0.655 · Sonnet 5.5 0.833/0.644 · Opus 5 0.828/0.564 · Opus 4.7 0.700/0.383 · Sonnet 5 0.610/0.306 · Sonnet 4.6 0.364/0.330
- 포켓몬 레드 (약 1만 걸음)
- Sonnet 3.7 파일 413개·폴더 225개·97만 7,930자·배지 1개 · Fable 5 파일 9개+global.md·4만 3,406자·배지 4개
- 지시 실험
- 실패만 기록 규칙에 Opus 5·4.7 향상분 상당 부분 상실 · Sonnet 4.6 메모리 읽기·가설 검증 지시로 0.330→0.641
- 메모리 읽기 빈도
- Sonnet 5 10번 중 9번 · Sonnet 4.6 절반 미만
- 메모 정정
- 달맞이산 포켓몬센터 위치 오기 → 드리밍으로 정정 후 블루시티 도착 · 미정정 판 세 번 낙하
- 스테인리스 위키
- 문서 약 35만 개·약 4억 2,000만 토큰 · 25개 질문 · Opus 5 128개 세션 · 위키만 13%→48% · 검색+위키 54%→61%(검색만 53%) · 질문당 약 2만 토큰 절약
- 하비 LAB
- 인수합병 24개 질문 중 다문서 항목 위키 87%·검색 73% · 단일 문서 과제 차이 없음 · 위키가 원본보다 커진 과제도
- 목표 맞춤 드리밍
- 계약 사실 41/57(72%) → 계약별 에이전트·원문 인용으로 57/57(100%) · 깨진 링크 9개 수정·새 페이지 3개
- 클로드 코드 자동 메모리
- MEMORY.md 처음 200줄 또는 25KB만 로드
- X 반응
- 조회수 163만 회 · 좋아요 1만 2,633개 · 북마크 1만 1,369개
앤스로픽이 11월 6일(미국 시간) 엔지니어링 블로그에 에이전트 메모리의 구성 요소를 정리한 글을 올리고, 클로드가 쉬는 동안 지난 기록을 되짚어 메모리를 정리하는 드리밍 실험 결과를 공개했다. 앤스로픽은 X에 "메모리는 클로드가 경험에서 배우게 해 주는 것"이라며 드리밍이 클로드가 배운 것을 정리하고 실수를 바로잡고 다음번에 필요한 것을 더 쉽게 찾도록 돕는다고 밝혔다. 글은 데이터베이스 질의 벤치마크, 포켓몬 레드 플레이, 사내 문서 위키 구축, 법률 문서 작성 벤치마크까지 네 갈래 실험을 묶었다. 대표 수치는 메모리를 쓴 Opus 5.5가 CL-Bench 데이터베이스 과제에서 0.838점을 받아 메모리 없는 기준선 0.655점을 크게 앞섰다는 것이다.
앤스로픽이 말하는 에이전트 메모리는 사용자와의 상호작용이나 맡은 작업에서 얻은 지식을 세션 사이에 남겨 나중에 읽을 수 있는 맥락으로 저장한 것이다. 학습으로 바뀌는 가중치, 한 대화 안에서 배우는 인컨텍스트 학습, 오래된 대화를 요약으로 갈아 끼우는 컴팩션은 이 정의에서 뺐다. 글은 사람의 해마가 경험을 바로 붙잡고 잠자는 동안 되살려 신피질로 옮긴다는 신경과학 설명을 출발점으로 삼았다. 메탈이 내려받아 확인한 39쪽 분량의 1995년 심리학 논문, 제임스 매클렐런드 등이 쓴 상보적 학습 체계 논문이 이 비유의 근거로 걸려 있다. 에이전트도 일하는 동안 기록을 남기고, 쉬는 동안 그 기록을 되짚어 실수를 고치거나 새 메모와 구조를 만든다. 앤스로픽은 레타와 UC 버클리 연구진이 제안한 수면 시간 연산, 곧 상호작용 사이 유휴 시간에 모델이 맥락을 재정리하는 방식을 드리밍의 뿌리로 소개했다.
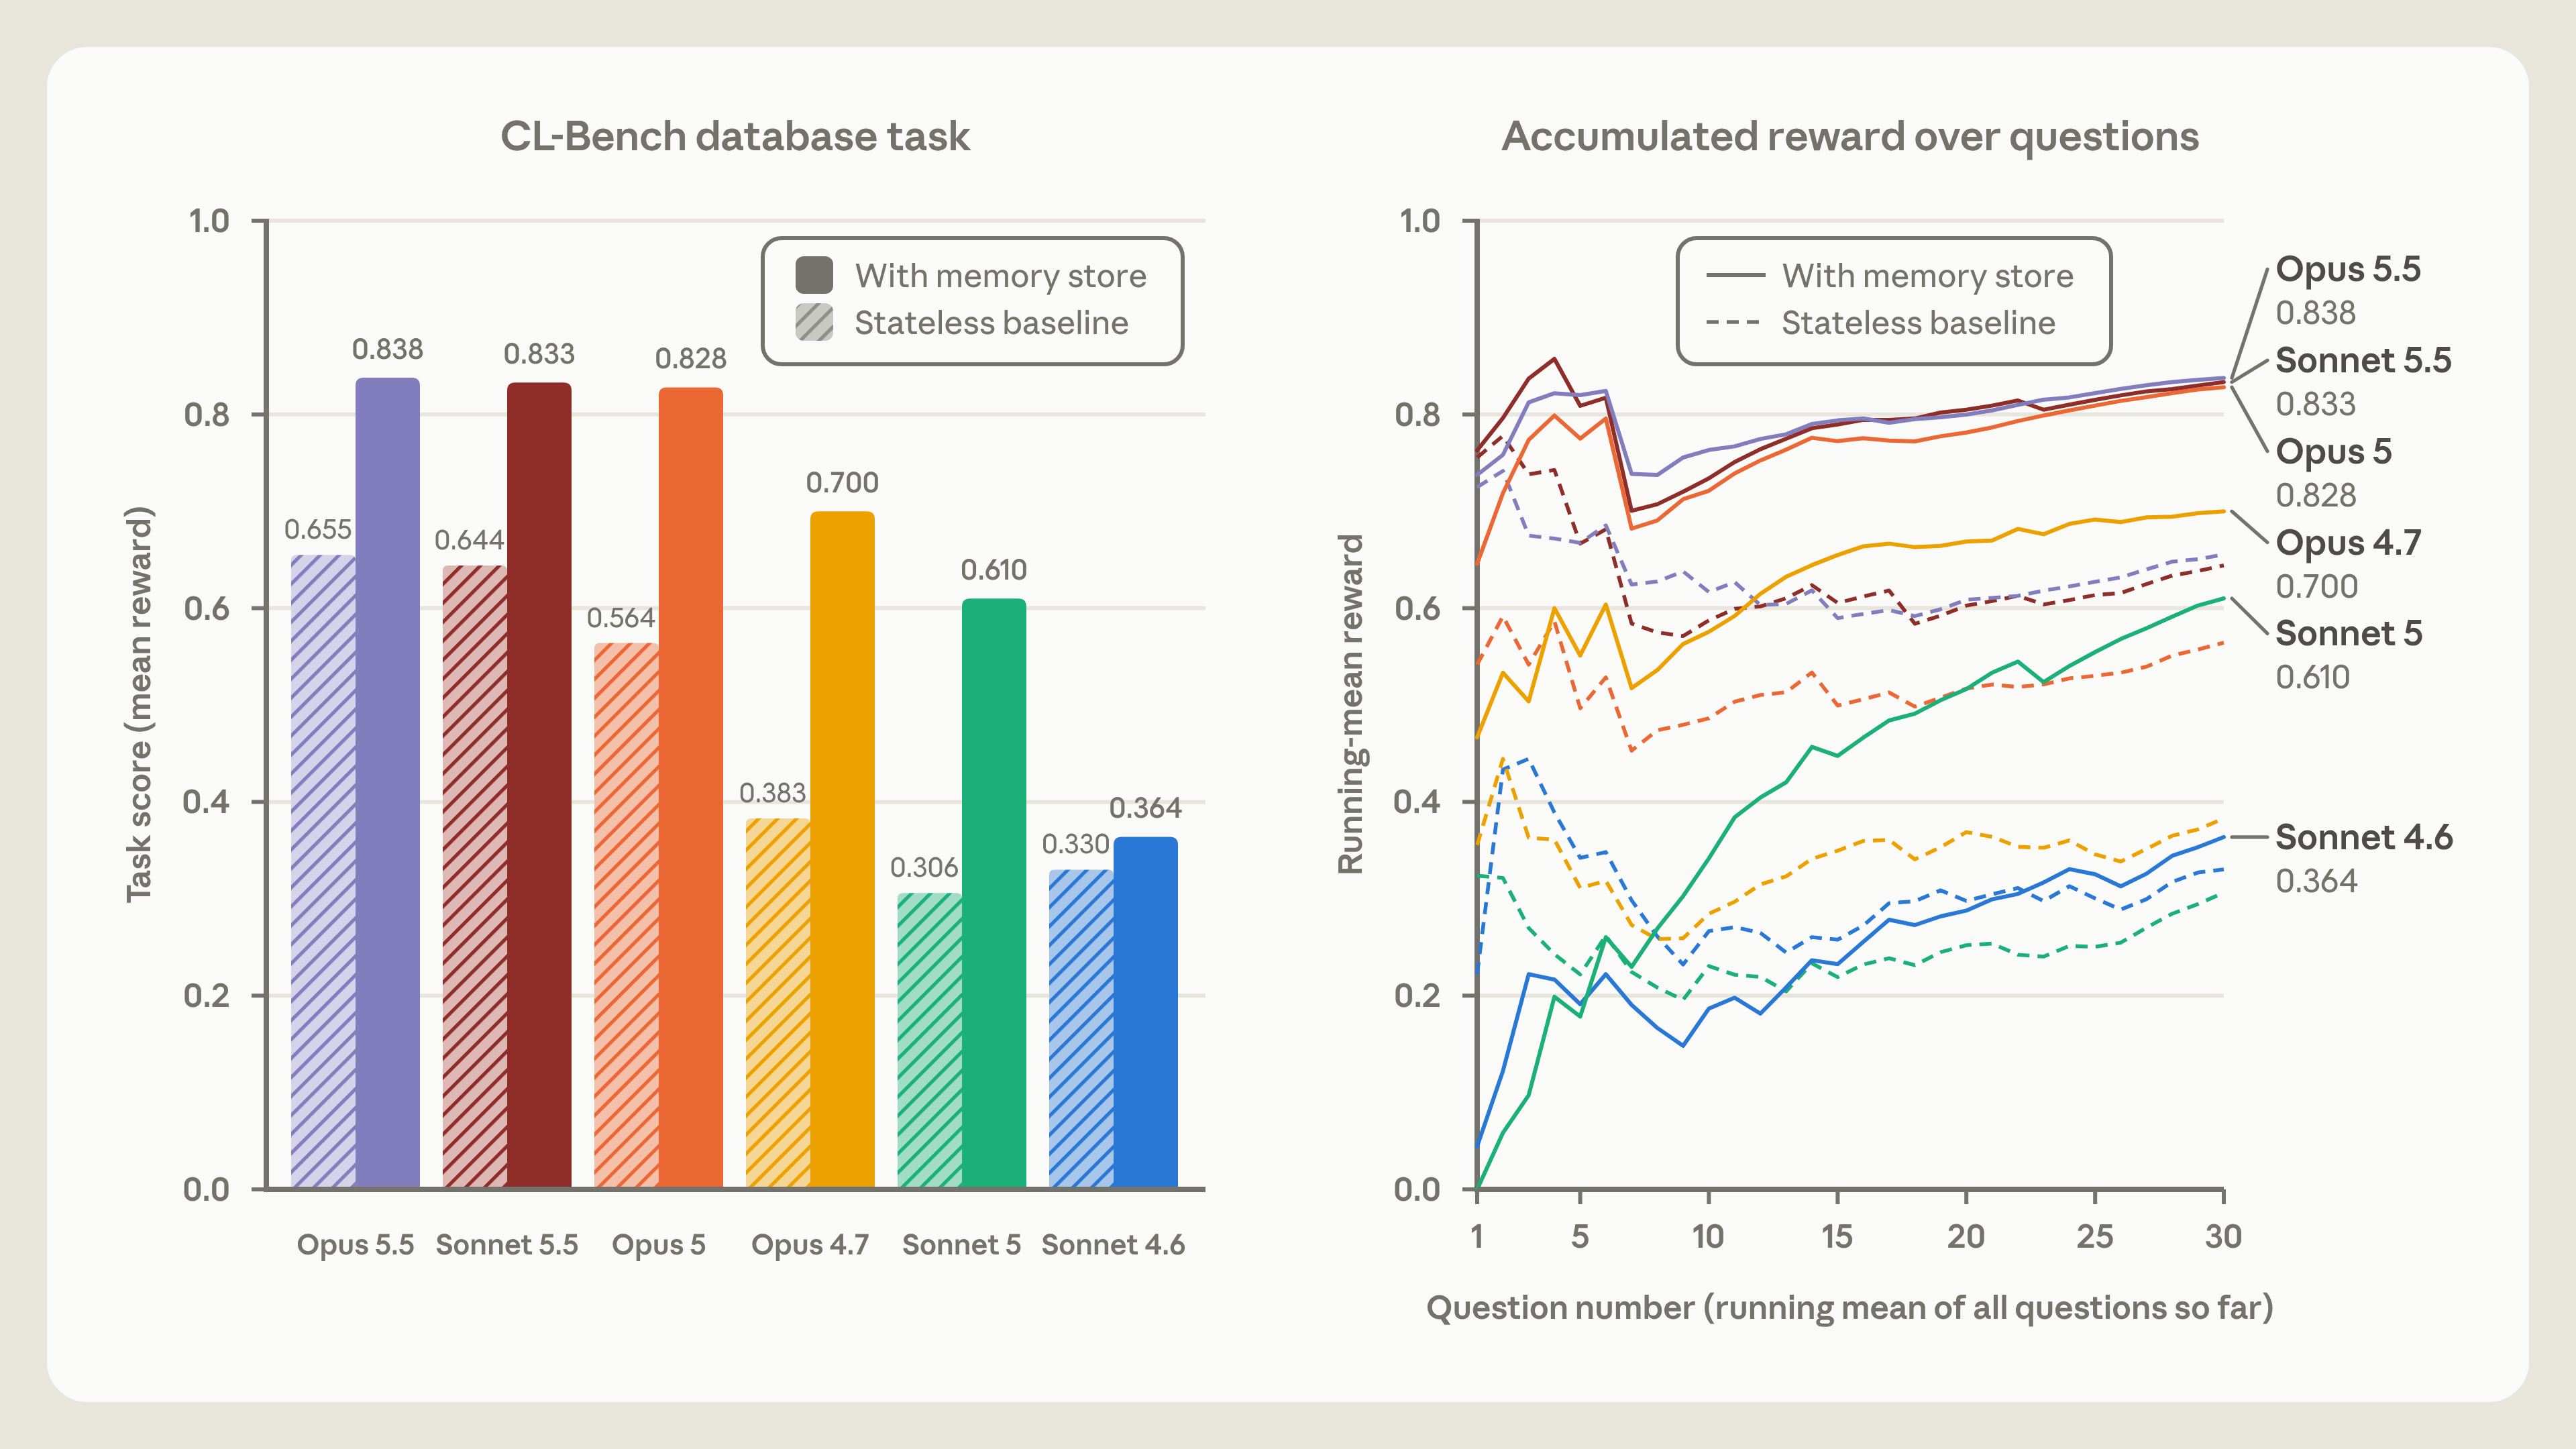
첫 실험은 장기 과제에서 메모리 활용 능력을 재는 Continual Learning Bench 1.0의 데이터베이스 과제다. 클로드는 클로드 매니지드 에이전트 위에서 질문마다 새 세션으로 출발하되, 세션을 넘어 유지되는 메모리 폴더 하나만 읽을 수 있었다. 답을 낸 뒤에는 정답을 듣고 메모를 남겼다. 메모리를 쓴 점수는 Opus 5.5 0.838, Sonnet 5.5 0.833, Opus 5 0.828, Opus 4.7 0.700, Sonnet 5 0.610, Sonnet 4.6 0.364였다. 기준선은 차례로 0.655, 0.644, 0.564, 0.383, 0.306, 0.330으로, Sonnet 5는 메모리 덕에 점수가 두 배 가까이 뛰었고 Sonnet 4.6은 거의 늘지 않았다.
점수 차이는 메모를 쓰는 방식에서 갈렸다. Sonnet 4.6은 오답 원인에 대한 검증하지 않은 추측을 여러 파일에 흩어 놓았고, Opus 4.7은 메모를 참고 문서 하나로 묶어 확인한 사실과 미확인 사실을 표시하기 시작했다. Sonnet 5는 채점을 거친 답에 확인 표시를 하고 틀린 답에는 정정을 적었다. 앤스로픽은 Opus 5를 학습 고리를 처음 닫은 모델로 꼽았다. 대부분의 항목에 규칙과 그 규칙이 참이라는 근거, 앞선 질문의 답, 도중에 발견한 함정에 대한 경고를 함께 적었다는 설명이다. 글은 메모리가 때로 예측이라며, 규칙을 적는 행위 자체가 그 패턴이 다시 쓰일 것이라는 예측이라고 정리했다.
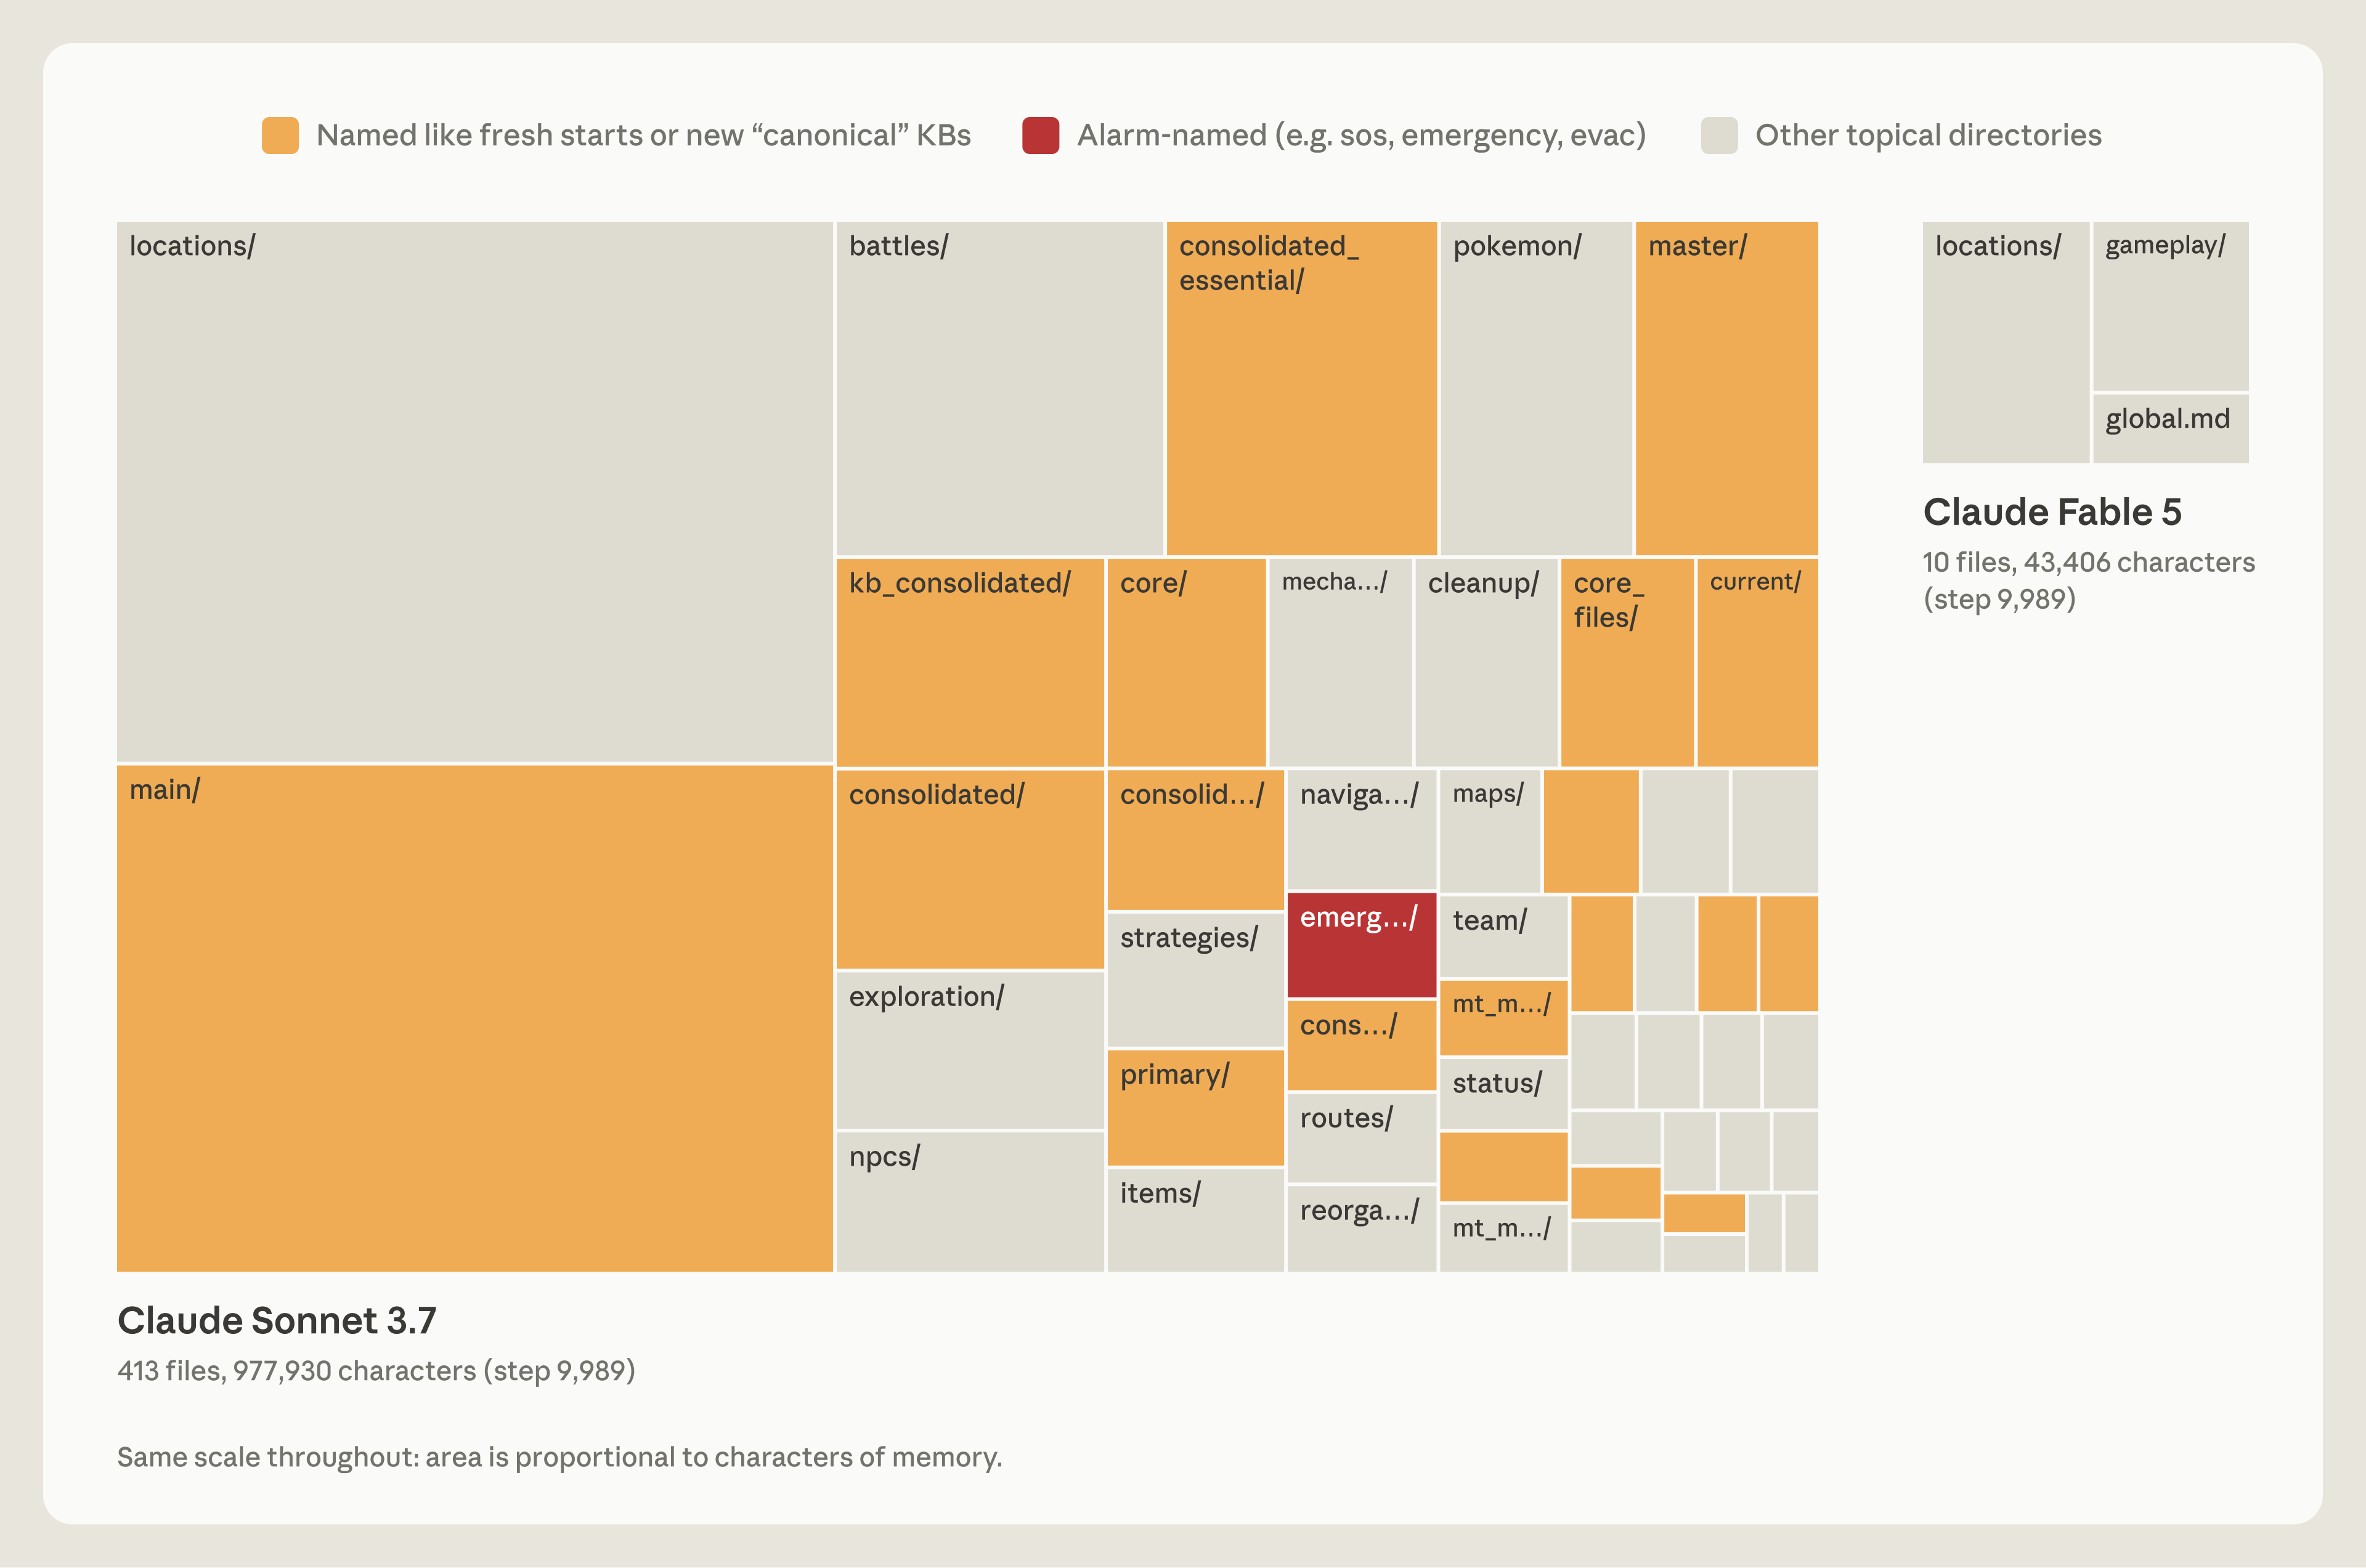
무엇을 기억할지 고르는 판단력은 포켓몬 레드에서 드러났다. 약 1만 걸음 시점에 Sonnet 3.7은 전투와 아이템, 등장인물마다 파일을 따로 만들어 폴더 225개에 메모리 파일 413개를 쌓았고 배지는 1개를 얻었다. Fable 5는 폴더 2개에 파일 9개와 최상위 global.md 하나만 두고 배지 4개를 땄다. 메탈이 확인한 원문 도표에 따르면 9,989걸음 시점의 메모리 분량은 Sonnet 3.7이 97만 7,930자, Fable 5가 4만 3,406자였다. Sonnet 3.7은 1만 걸음 무렵 네 번째 마스터 메모 폴더를 열었고, 이후 17걸음 동안 파일 6개를 만들고 9개를 지우면서 게임 안에서는 아무 행동도 하지 않았다.
Fable 5는 화면에서 바로 읽히는 소지금이나 위치는 적지 않고 전략과 계획, 직접 검증한 규칙만 남겼다. global.md는 현재 목표와 체육관 공략 계획, 메모리 사용 규칙을 담은 계기판 역할을 했다. 잉어킹을 잡으려다 몬스터볼 7개가 연달아 빗나가자 클로드는 "볼이 3번 이상 연속으로 실패하면 타이밍을 바꿔라, 메뉴 단계 사이에 대기 입력을 넣었더니 잡혔다"고 적었다. Opus 5.5도 현재 목표와 다음 단계를 담은 작은 메모 폴더를 계속 고쳐 쓰며 게임을 끝까지 깼다.
메모리 쓰는 법을 미리 정해 주는 지시는 강한 모델에게 오히려 손해였다. 앤스로픽은 메모리가 무엇을 위한 것인지는 알려 주되 어떻게 쓸지는 정하지 않는 편이 낫다고 밝혔다. 실패만 기록하라는 규칙을 주자 Opus 5와 Opus 4.7은 메모리로 얻던 향상분의 상당 부분을 잃었다. 반대로 Sonnet 4.6에 답하기 전에 메모리를 읽고 오답 가설을 검증하라고 지시하자 점수가 0.330에서 0.641로 두 배 가까이 올랐다. Sonnet 5는 지시 없이도 10번 중 9번은 답하기 전에 메모리를 읽었고, Sonnet 4.6은 그 비율이 절반에 못 미쳤다.
드리밍의 첫 쓸모는 틀린 메모를 고치는 일이다. 포켓몬 실험에서 클로드는 달맞이산 입구의 포켓몬센터가 동쪽에 있다고 잘못 적고 "달맞이산은 내 뒤에 있다"며 메모에 완료 표시를 했다. 몇 걸음 뒤 일방통행 절벽에서 떨어져 지나온 길로 되돌아갔지만, 길 안내 도구에 낙차가 보이지 않아 자기가 맞았다고 결론 내렸다. 같은 메모 폴더에 드리밍을 돌리자 클로드는 메모를 세션 기록과 대조해 오류를 찾아 다시 썼고, 고친 메모로 동굴에 다시 들어가 블루시티에 도착했다. 고치지 않은 메모로 돈 판에서는 같은 길로 세 번 떨어졌고, 클로드는 "계속 맴도느니 멈추겠다"고 적은 뒤 끝내 산을 넘지 못했다.
드리밍은 메모리를 찾아가는 지도도 만든다. 앤스로픽은 5월에 인수한 소프트웨어 회사 스테인리스의 내부 문서 약 35만 개, 약 4억 2,000만 토큰 분량으로 25개 질문 평가를 꾸렸다. Opus 5 에이전트가 128개 세션에 걸쳐 파일을 탐색하고 서로 연결된 위키 페이지를 쓰고 고치며 중복을 합치고 원문과 대조하자, 위키만으로 답한 점수가 세션 2개일 때 13%에서 128개일 때 48%로 올랐다. 검색 도구와 위키를 함께 쓰면 점수가 54%에서 61%로 올라 검색만 쓴 53%를 넘었고, 질문 하나당 약 2만 토큰을 아꼈다.
위키가 늘 도움이 된 것은 아니다. 법률 벤치마크 하비 LAB와 인수합병 문서로 만든 24개 질문에서, 여러 문서를 엮어야 하는 항목은 위키를 쓸 때 87%, 검색만 쓸 때 73%를 기록했다. 반면 대부분의 채점 기준을 문서 하나의 텍스트 검색으로 채울 수 있는 LAB 과제에서는 뚜렷한 차이가 없었고, 또 다른 과제에서는 위키가 원본 문서보다 커졌다. 앤스로픽은 이 결과를 제국만 한 지도를 그린 보르헤스 단편 속 지도 제작자에 빗댔다.
드리밍 지시를 목표에 맞추면 결과가 달라졌다. 계약 조건으로 채점하는 LAB 인수 과제에서 여러 에이전트가 계약 조건 표 하나에 동시에 쓰자 서로의 작업을 덮어써, 채점 대상 사실 57개 가운데 41개, 72%만 살아남았다. 클로드가 실패를 되짚어 지시를 고치고 위키를 다시 짓는 고리를 돌린 끝에, 계약마다 에이전트 하나가 자기 페이지를 맡아 조건을 원문 그대로 인용하도록 바뀌었고 57개 전부가 남았다. 두 번째 드리밍 단계는 없는 페이지를 가리키던 링크 9개를 같은 문서의 기존 페이지로 돌리고, 색인을 포함한 새 페이지 3개를 더했다.
매 세션 미리 불러오는 최상위 층은 작게 유지하는 것이 원칙이다. 앤스로픽은 주입된 메모가 귀한 토큰을 쓰고, 틀린 메모 하나가 모든 세션으로 번질 수 있으며, 지시 파일이 길수록 클로드가 따르는 정도가 떨어진다고 설명했다. 클로드 코드의 자동 메모리는 MEMORY.md의 처음 200줄 또는 25KB만 불러와 무엇을 알고 어디서 찾을지 보여 주는 색인으로 쓴다. 메탈은 클로드가 챗과 코워크의 메모리를 하나로 합친 소식과 앤스로픽의 Claude Sonnet 5.5 공개를 보도한 바 있다. 이번 글은 그 제품들 아래에서 메모리가 어떻게 쌓이고 고쳐지는지를 실험 수치로 펼쳐 보였다. 글은 랜스 마틴이 썼고, X 게시물은 이틀이 지나지 않아 조회수 163만 회와 북마크 1만 1,369개를 모았다.
드리밍이라는 개념은 이번 글에서 처음 나온 것은 아니다. 보도에 따르면 앤스로픽 기술 스태프 라미스 무크타는 올여름 런던 AI DevCon 발표에서 드리밍을 자체 자원으로 비동기 일괄 실행되는 과정이라고 소개하며 "방금 낸 최신 모델도 조직에서 성공하려면 무엇이 필요한지 처음부터 알지는 못한다"고 말했다. 같은 보도에서 에이전트 시스템을 연구하는 독립 연구자 자야쿠마르 라말링감은 "나쁜 답은 세션과 함께 사라지지만 나쁜 기억은 이후 수천 개 세션에 영향을 줄 수 있다"며 모든 메모리에 출처와 근거, 만료 조건을 달아야 한다고 주장했다.
AI 엔지니어의 눈으로 보면 이 글의 무게는 벤치마크 점수보다 설계 지침에 있다. 강한 모델에는 규칙 대신 판단을 맡기고, 메모를 원본 기록과 대조할 연산을 작업 바깥으로 떼어 두며, 매 세션 넣는 층은 색인 수준으로 줄이라는 것이다. 앤스로픽은 드리밍에도 연산이 들고 모든 메모리를 계속 점검하는 일은 현실적이지 않을 수 있다며, 바뀔 가능성이 큰 정보에 드리밍을 집중하거나 접근 빈도에 맞춰 주기를 조정하는 방안을 열린 질문으로 남겼다. 에이전트가 며칠씩 이어서 일하는 환경에서 성능을 가르는 변수가 모델 크기에서 무엇을 적고 언제 고칠지로 옮겨 가고 있다는 것이 네 갈래 실험이 가리키는 방향이다.
댓글