


이미지: @claudeai (X) 영상 갈무리
요약
- 앤스로픽이 9월 28일 Claude Sonnet 5.5를 공개했고, 토큰 단가는 Sonnet 5와 같게 두면서 작업당 비용을 최대 30% 낮췄다.
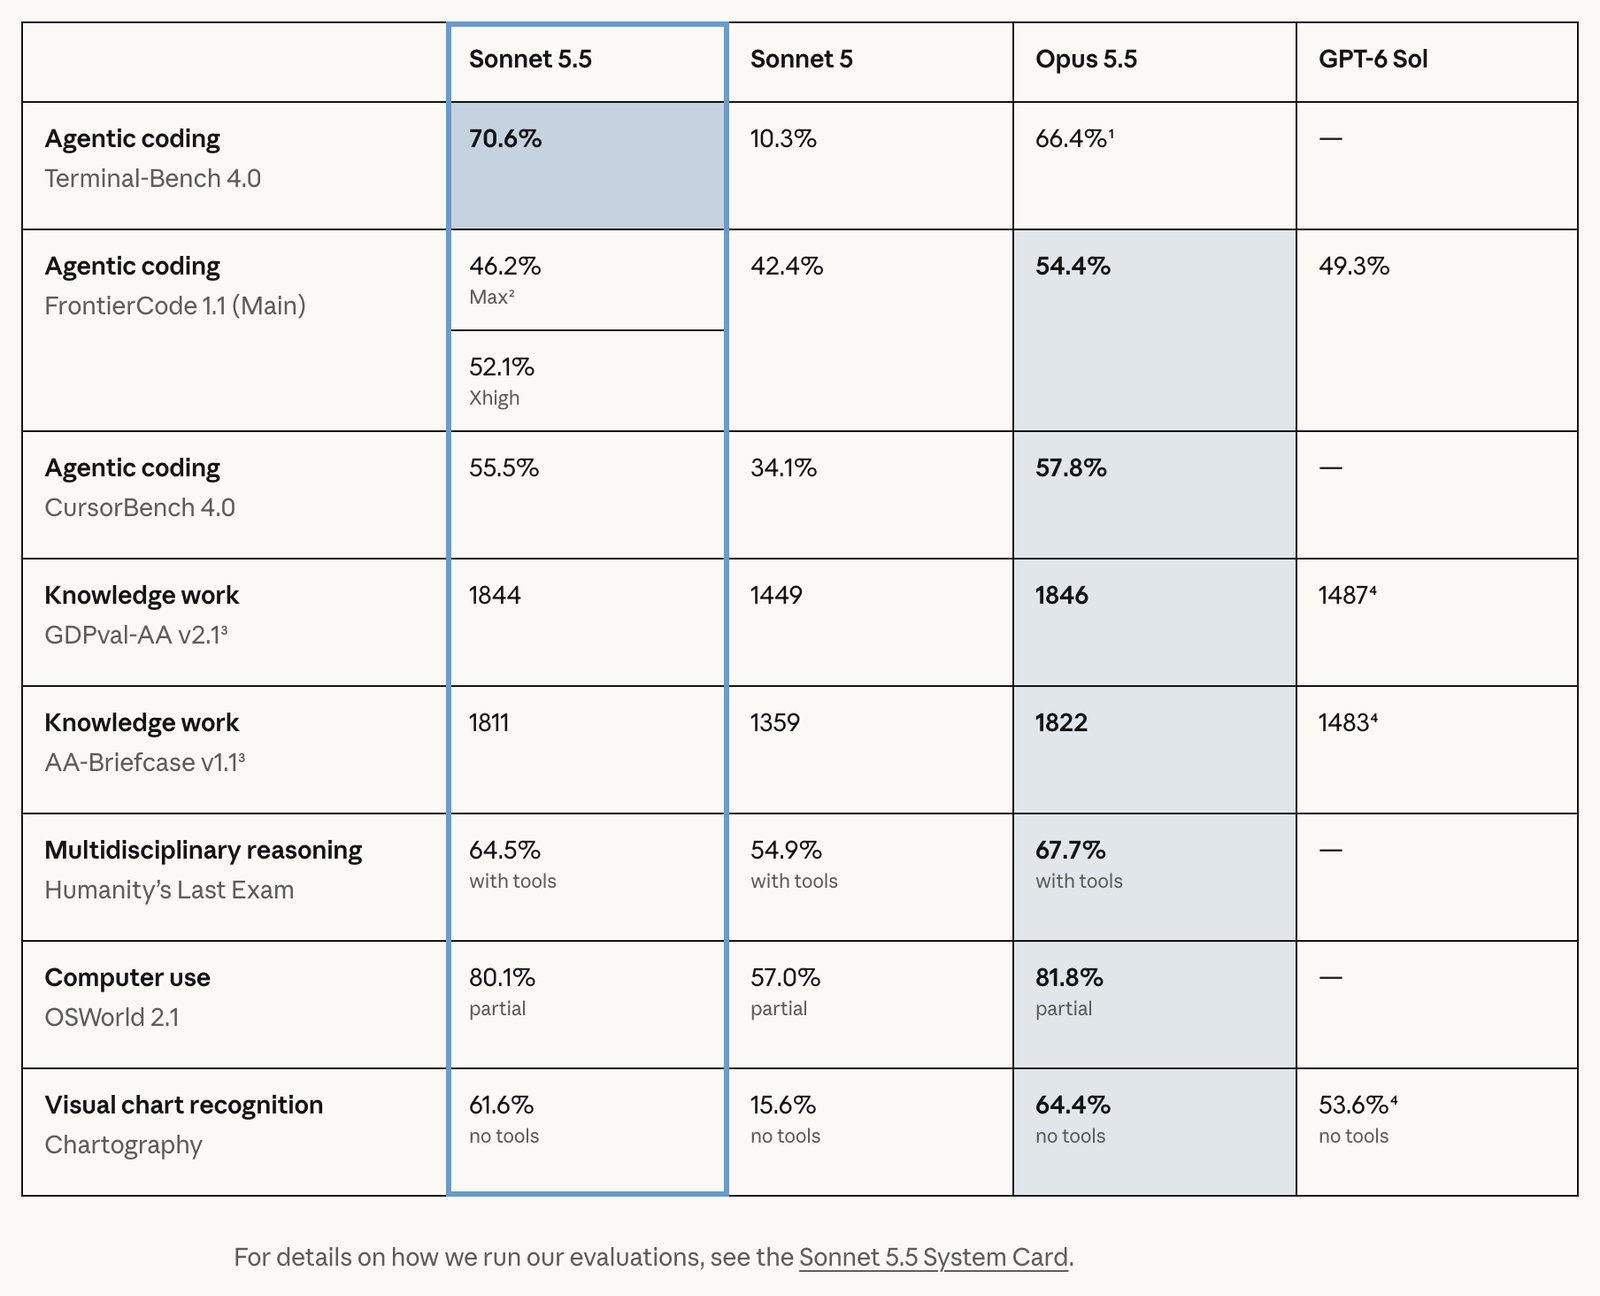
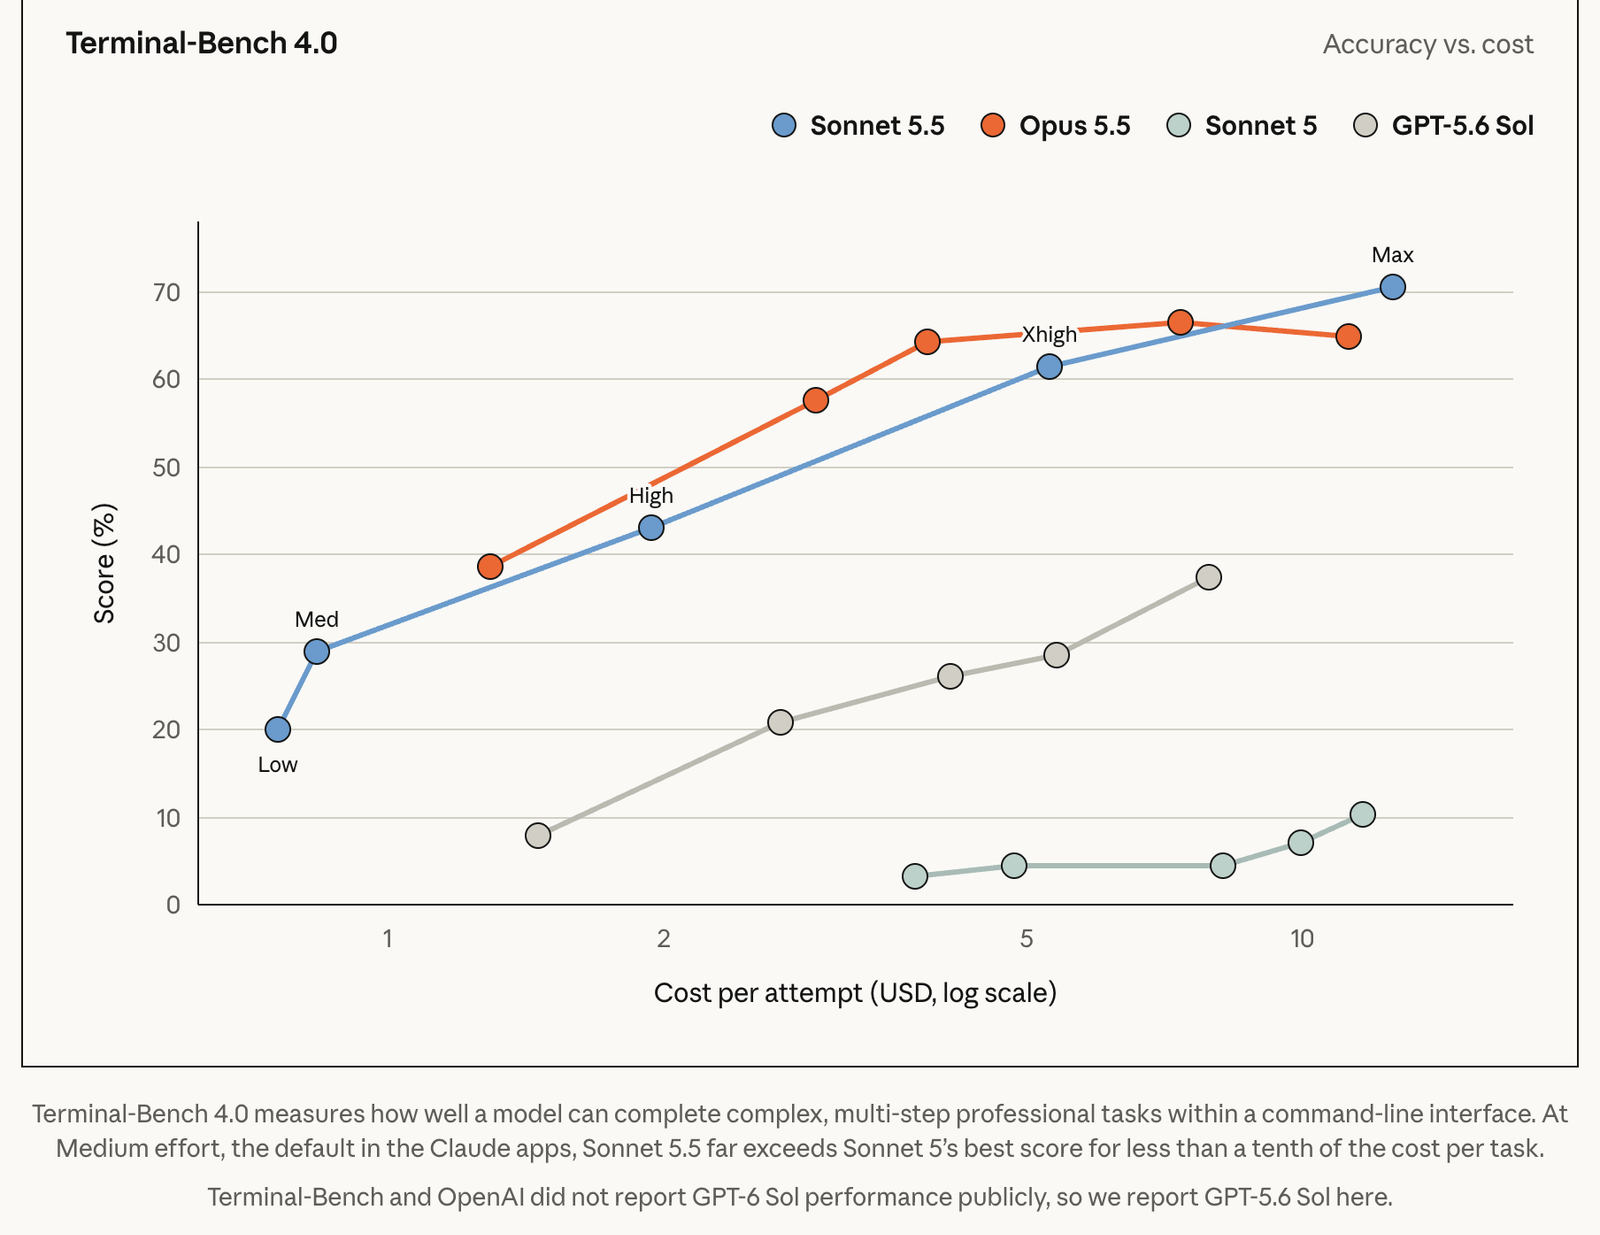
- Terminal-Bench 4.0 70.6%, GDPval-AA 1844점으로 Opus 5.5에 근접했고, Low·Medium 설정에서 Sonnet 5 최고점을 약 10분의 1 비용에 넘었다.
- 사이버 안전장치와 추론 추출 차단 분류기를 단 첫 Sonnet 모델이며, 모든 플랫폼에서 claude-sonnet-5-5로 쓸 수 있다.
- 발표
- 2026년 9월 28일 앤스로픽 발표문 · 클로드 X 게시물(13초 영상) · 확인 시점 조회 260만 · 좋아요 3만 1천
- 속도·비용
- 출력 속도 Sonnet 5 대비 30% 이상 빠름 · 작업당 비용 최대 30% 낮음 · 토큰 단가 Sonnet 5와 동일
- Terminal-Bench 4.0
- Sonnet 5.5 70.6% · Sonnet 5 10.3% · Opus 5.5 66.4%(Xhigh 최고점)
- GDPval-AA v2.1
- Sonnet 5.5 1844 · Opus 5.5 1846 · Sonnet 5 1449 · GPT-6 Sol 1487
- 기타 벤치마크
- CursorBench 4.0 55.5%(Opus 5.5 57.8%) · OSWorld 2.1 80.1%(81.8%) · Chartography 61.6%(Sonnet 5 15.6%) · HLE 도구 사용 64.5%
- FrontierCode 1.1
- Max 46.2% · Xhigh 52.1% · High 설정 비교 Sonnet 5보다 10점 높고 비용 약 15분의 1
- 기본 설정
- 클로드 앱·클로드 코드 Medium · 클로드 플랫폼 High
- 고객사
- 베이스44 118개 빌드 평균 3.6회(Opus 5 7.7회) · 발리아스니 2,441과제 답변당 약 12.1만 토큰(Sonnet 5 49.7만) · 슬랙 출력 토큰 약 14%↓ · 젠데스크 티켓 20% 빠름 · 박스 2.4배 빠름·토큰 12%↓
- 안전
- 사이버 안전장치·대체 경로 첫 Sonnet(고위험 요청은 Sonnet 5로) · 추론 추출 차단 분류기 · preserved thinking 확대 · 행동 감사 약 1,850개 시나리오
- 배포
- 모든 플랫폼(AWS·Google Cloud·Microsoft Azure) · 모델 ID claude-sonnet-5-5 · between_tools 설정 · Haiku 5.5 몇 주 안
앤스로픽이 9월 28일 Claude 5.5 계열의 두 번째 모델 Claude Sonnet 5.5를 공개했다. 회사는 발표문에서 Sonnet 5.5가 Claude Sonnet 5보다 출력을 30% 이상 빠르게 만들고, 대부분의 작업에서 작업 한 건당 비용이 최대 30% 낮다고 밝혔다. 토큰 단가는 Sonnet 5와 똑같이 두고, 같은 일을 훨씬 적은 토큰으로 끝내는 방식으로 비용을 낮췄다. 대량·저비용 용도의 Claude Haiku 5.5는 몇 주 안에 같은 계열에 합류한다.
두 모델의 역할은 분명하게 갈렸다. 앤스로픽은 Opus 5.5를 신중한 판단이 필요한 복잡한 일에, Sonnet 5.5를 범위가 정해진 일상 과제와 버그 수정, 문서·슬라이드·스프레드시트 작성에 맞춘 모델로 소개했다. 디자인 감각도 좋다고 덧붙였다. 메탈은 9월 22일 계열의 첫 모델인 Opus 5.5 공개 소식을 보도한 바 있으며, 그로부터 엿새 만에 중간 등급 모델이 뒤따랐다.
벤치마크 표에서는 윗급과의 간격이 크게 좁혀졌다. 명령줄에서 여러 단계를 거치는 과제를 재는 Terminal-Bench 4.0에서 Sonnet 5.5는 70.6%를 받아 Sonnet 5의 10.3%를 크게 넘었고, 최고 설정의 Opus 5.5가 낸 66.4%보다도 높았다. 44개 직업의 실제 업무를 재는 GDPval-AA에서는 1844점으로 Opus 5.5의 1846점과 2점 차이였고, Sonnet 5의 1449점과 GPT-6 Sol의 1487점을 앞섰다. 컴퓨터 사용을 재는 OSWorld 2.1은 80.1%로 Opus 5.5의 81.8%에 붙었고, 도표 읽기 시험 Chartography는 Sonnet 5의 15.6%에서 61.6%로 뛰었다. 실제 커서 코딩 세션에서 뽑은 과제로 재는 CursorBench 4.0은 55.5%로 Opus 5.5의 57.8%에 약 2점 뒤졌다. 스크린샷만 보고 포켓몬 레드를 끝까지 깬 첫 Sonnet 모델이라는 기록도 붙었다.
앤스로픽이 더 앞세운 것은 점수당 비용이다. 회사가 공개한 정확도·비용 곡선에서 Sonnet 5.5는 여러 벤치마크에서 Low나 Medium 설정만으로 Sonnet 5의 최고점을 약 10분의 1 비용에 넘었다. 병합 가능한 코드 변경을 재는 FrontierCode에서는 같은 High 설정끼리 비교해 Sonnet 5보다 10점 높은 점수를 약 15분의 1 비용으로 냈다. 클로드 앱과 클로드 코드의 기본 설정은 Medium, 클로드 플랫폼의 기본은 High다. 설정을 끝까지 올린다고 늘 좋은 것은 아니었다. FrontierCode에서 Max 설정 점수는 46.2%로 한 단계 아래인 Xhigh의 52.1%보다 낮았는데, 회사는 Max에서 코드 리뷰를 여러 하위 에이전트로 나눠 돌리다 시간 초과나 범위 밖 수정이 생긴 사례가 있었다고 설명했다. 앤스로픽은 오래 판단을 이어 가야 하는 열린 과제에서는 Opus 5.5가 여전히 분명히 강하다고 적었다.
초기 고객사 수치는 단계와 토큰이 줄었다는 쪽으로 모인다. 베이스44의 가브리엘 그린버그 AI 엔지니어링 리드는 "118개의 실제 앱 빌드에서 Claude Sonnet 5.5는 Opus 5와 같은 수준의 앱을 만들었다"며 "빌드당 평균 3.6번의 반복으로 도달했고, Opus 5는 7.7번이 걸렸다"고 밝혔다. 발리아스니 에셋 매니지먼트는 2,441개 금융 과제에서 Sonnet 5.5가 답변당 약 12만 1천 토큰을 써 Sonnet 5의 49만 7천 토큰보다 크게 적었다고 전했다. 러버블의 파비안 헤딘 공동창업자 겸 최고기술책임자는 자사 코딩 평가에서 도구 호출이 3분의 1 줄고 셸 실행은 약 절반으로 줄었다고 말했다.
업무용 도구 쪽 결과도 같은 방향이다. 슬랙의 커티스 앨런 수석 엔지니어는 "프롬프트를 하나도 바꾸지 않았는데 Claude Sonnet 5.5는 오프라인 슬랙봇 평가 거의 전부에서 Sonnet 5보다 나았다"며 단계는 더 적고 출력 토큰은 약 14% 적었다고 밝혔다. 젠데스크는 실제 상담 사례 수백 건에서 잘못된 판단이 줄고 티켓 처리가 20% 빨라졌다고 했고, 박스는 이전 모델보다 정확하면서 2.4배 빠르고 전체 토큰을 12% 덜 썼다고 전했다. 앤스로픽의 사내 시험에서는 한 상장사의 분기 실적 자료와 콘퍼런스콜 녹취, 슬라이드 템플릿을 주고 10장짜리 운영 리뷰를 맡겼는데, 전문가 두 명이 첫 초안을 그대로 보내도 된다고 판정했다.
안전장치는 한 단계 올라갔다. 앤스로픽은 Sonnet 5.5의 사이버보안 능력이 Opus 5와 비슷한 수준이라며, 최상위 모델에 쓰던 사이버 안전장치와 대체 경로를 달고 나온 첫 Sonnet 모델이라고 밝혔다. 일상적인 버그 찾기와 수정은 그대로 되지만, 위험도가 높은 사이버보안 요청은 눈에 보이게 Sonnet 5로 넘어간다. 가짜 계정 수천 개로 모델 능력을 대량으로 뽑아내는 증류 공격에 맞서 추론 추출을 막는 분류기도 Sonnet 계열에서 처음 붙었고, 생각 과정을 만든 계정과 떼어 낼 수 없게 하는 preserved thinking도 넓혔다. 생물학 안전장치는 Sonnet 5와 같다. 약 1,850개 시나리오로 돌린 자동 행동 감사에서 Sonnet 5.5는 대부분의 정렬 지표가 Sonnet 5와 같거나 나았고, 격리 평가에서는 컨테이너의 한도를 떠보는 경향이 앤스로픽 모델 가운데 가장 낮았다. 보도에 따르면 이 모델에는 EU AI Act 대응을 위한 보이지 않는 텍스트 워터마크도 들어갔다.
모델은 AWS와 Google Cloud, Microsoft Azure를 포함한 모든 플랫폼에 올라갔고, 개발자는 claude-sonnet-5-5로 부를 수 있다. Opus 5.5와 Sonnet 5처럼 데이터를 남기지 않는 설정으로도 쓸 수 있다. 생각 기능을 끄고 Sonnet을 쓰던 개발자는 옮기기 전에 새 between_tools 설정으로 바꿔야 한다. 메탈이 확인한 클로드 공식 계정의 발표 게시물은 13초짜리 영상을 달았고, 확인 시점 조회수 260만 회와 좋아요 3만 1천 개를 넘겼다. 영상에는 하늘을 뒤덮은 새 떼 장면이 들어갔고, 발표문은 찌르레기 400마리의 군무를 HTML 파일 하나로 그리라는 프롬프트를 속도 비교 예시로 들었다.
값 경쟁의 축도 바뀌고 있다. 보도에 따르면 오픈AI가 지난주 내놓은 GPT-6 Sol의 표준 API 단가는 Sonnet 5.5와 같고, 구글은 Gemini 3.8 Flash를 연말까지 더 낮은 도입가로 판다. 앤스로픽은 6월 Sonnet 5를 도입가로 내놓았다가 8월 그 단가를 굳혔고, 메탈은 Sonnet 5 도입가 영구 적용을 보도한 바 있다. 이번에는 단가를 다시 건드리지 않고, 과제 하나를 끝내는 데 드는 토큰과 도구 호출 수를 줄이는 쪽으로 비용을 끌어내렸다.
이번 발표로 기업이 모델을 고르는 기준이 달라진다. 중간 등급의 점수가 최상위 등급 바로 밑까지 올라오면서, 지금까지 Opus로 올려 보내던 일 가운데 상당수를 Sonnet에 남겨 둘 근거가 생겼다. 비교의 단위도 토큰 한 개의 값에서 일 한 건을 끝내는 데 드는 총량으로 옮겨 가고 있고, 앤스로픽은 그 계산표를 벤치마크와 함께 직접 내밀었다.
출처
- Anthropic — Introducing Claude Sonnet 5.5 →
- VentureBeat — Anthropic launches Claude Sonnet 5.5 with 30% cost reduction per-task due to faster speeds and fewer tool calls →
- SiliconANGLE — Anthropic debuts Claude Sonnet 5.5 running 30% faster than the previous-generation AI model →
- The New Stack — Anthropic launches Claude Sonnet 5.5 with near-Opus performance at half the price →
- Claude (X) — Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family. →
댓글