


이미지: METAL
요약
- 구글 리서치가 9월 29일 확산 모델의 이미지 생성 과정을 연속 제어 문제로 다시 쓴 Diffusion Controller를 공개했다.
- 원본 모델은 고정하고 중간 출력만 받는 경량 보조망이 매 단계 방향을 보정해, 가중치를 공개하지 않는 비공개 모델에도 붙일 수 있다.
- Stable Diffusion v1.4 실험에서 회색 상자 방식은 SFT·RWL 승률 0.667·0.682로 LoRA의 0.577·0.611을 앞섰고, 흰 상자 변형은 PPO에서 0.935를 기록했다.
- 발표
- 2026년 9월 29일 구글 리서치 블로그 · 치웨이 쉬·류문경 소프트웨어 엔지니어
- 논문
- 「Diffusion Controller: Framework, Algorithms and Parameterization」 · arXiv 2603.06981 · 2026년 3월 7일 · 37쪽 · 저자 7명(구글 리서치·구글 딥마인드·카네기멜런대·예일대)
- 이론
- 역방향 확산 샘플링을 LS-MDP 확률적 제어로 정식화 · 사전학습 전이 확률 재가중 · f-발산 비용
- 학습법
- PPO 방식 정책 경사법(클리핑) · 보상 가중 손실(RWL)
- 구조
- 원본 모델 고정 + 경량 UNet 보조망(잠재 64×64) · 중간 출력 입력 · 회색 상자 적용 · 최적 구성 학습 파라미터 11,810,621개
- 실험
- Stable Diffusion v1.4 · SFT·RWL·PPO · HPS-v2 승률(원본 대비)
- 파라미터
- Diffusion Controller 1.2×10^7 · LoRA 1.7×10^7 · J·S 변형 1.6×10^7
- 승률
- Diffusion Controller SFT 0.6667·RWL 0.6815·PPO 0.6957 · LoRA 0.5766·0.6109·0.9048 · Naive 0.5655·0.5060·0.5201 · J PPO 0.9353 · S RWL 0.7091
- 사람 평가
- 평가자 50명 이상 · 프롬프트 50개 · 프롬프트당 4장 · 최선 묶음 선택 · 유급 계약자
- 효율
- RWL이 DPOK보다 4분의 1 샘플로 더 높은 승률
- 다음 단계
- 개인화 도구 · 유해 생성 완화 안전장치 · 영상 모델 제어
구글 리서치가 9월 29일 텍스트로 이미지를 만드는 확산 모델을 원하는 방향으로 이끄는 제어 프레임워크 Diffusion Controller를 공개했다. 핵심은 거대한 원본 모델은 그대로 얼려 두고, 그 옆에 붙인 작은 보조 신경망이 이미지가 만들어지는 매 단계에서 방향을 미세하게 바로잡는 구조다. 블로그를 쓴 치웨이 쉬와 류문경 구글 리서치 소프트웨어 엔지니어는 이 보조망을 오토바이의 "스티어링 댐퍼"에 비유하며 "접근이 제한된 비공개 모델에도 매끄럽게 붙는다"고 밝혔다. 원본 모델을 고치지 않고도 사용자 의도에 맞춘 조정이 가능하다는 뜻이다.
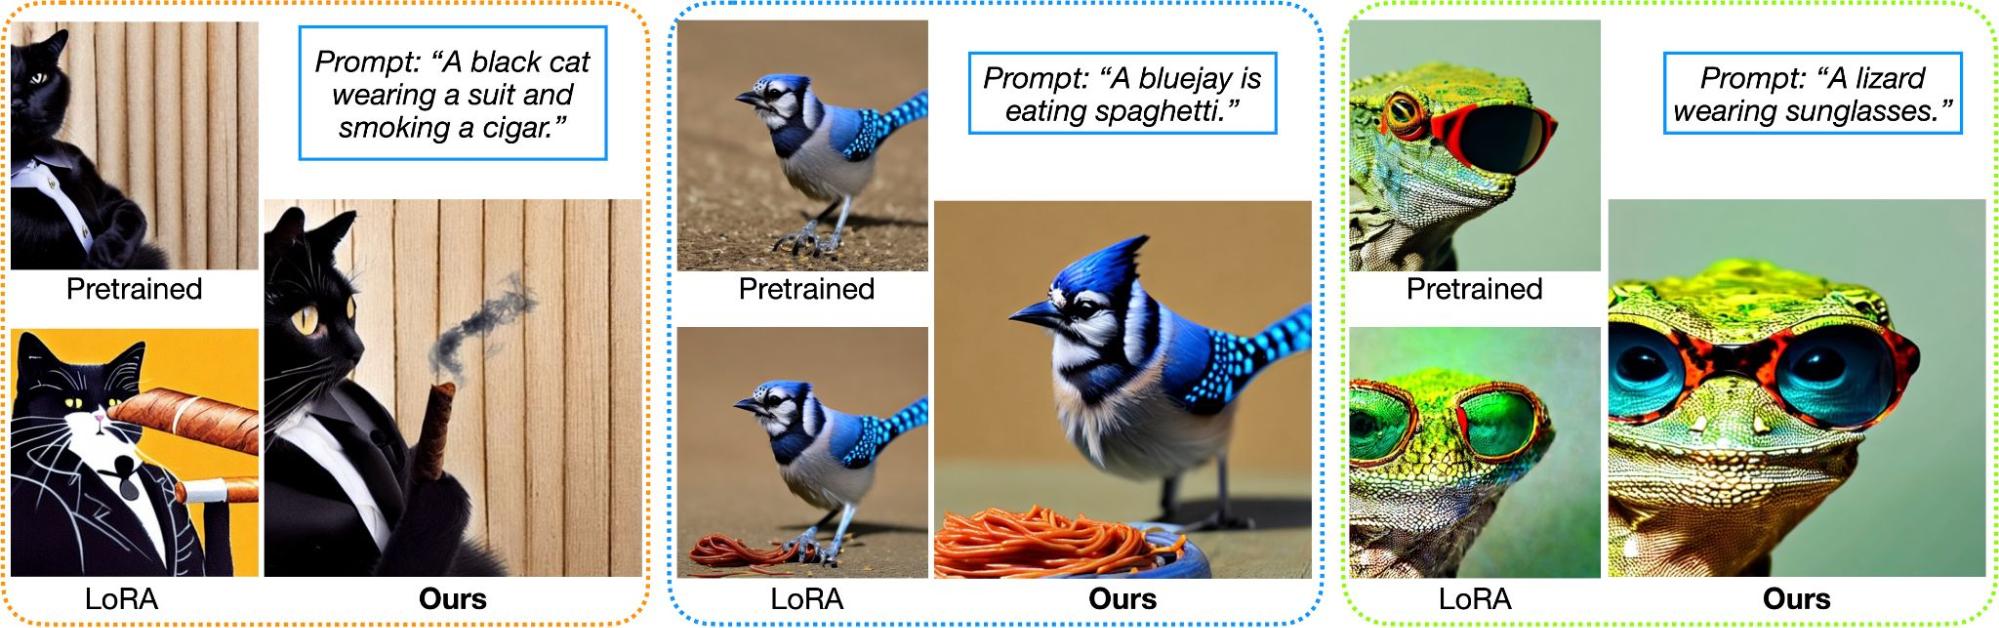
풀려는 문제는 프롬프트 충실도와 화질 사이의 줄다리기다. 블로그는 선글라스를 쓴 도마뱀을 예로 든다. 모델이 선글라스를 빠뜨린 사실적인 도마뱀을 내놓거나, 반대로 선글라스를 억지로 넣다가 도마뱀 얼굴이 뭉개지는 식이다. 지금까지 개발자는 생성 중에 프롬프트 영향력을 조절하는 가이던스 기법과, LoRA 같은 경량 어댑터나 보상 가중 회귀, 정책 경사법으로 모델을 다시 학습시키는 방법을 따로따로 써 왔다. 쉬와 류는 "이 도구들은 서로 무관한 해법으로 취급돼 왔고, 분야 전체에 이를 하나로 묶어 분석할 수학적 언어가 없었다"고 진단했다.
Diffusion Controller는 잡음을 조금씩 걷어 내며 그림을 완성하는 과정 전체를 하나의 연속 제어 문제로 다시 쓴다. 메탈이 확인한 37쪽 분량의 논문 원문에 따르면 연구진은 역방향 확산 샘플링을 선형 풀이형 마르코프 결정 과정(LS-MDP) 안의 확률적 제어로 놓고, 사전학습 모델의 전이 확률을 다시 가중하는 방식으로 제어를 정의했다. 이 최적 조건에서 두 가지 학습법이 나온다. 하나는 클리핑 규칙으로 변화 폭을 묶어 두는 PPO 방식의 정책 경사법이고, 다른 하나는 좋은 결과를 낸 생성 경로에 가중치를 주는 보상 가중 손실이다. 논문은 3월 7일 아카이브에 올라왔고, 카네기멜런대에서 구글 리서치 인턴으로 온 퉁 양과 예일대 유제 치, 구글 딥마인드 보 다이 등 7명이 저자로 이름을 올렸다.
같은 이론은 모델 구조도 정해 준다. 최적의 점수 함수가 고정된 사전학습 기준값과 작은 제어 보정값의 합으로 갈라지기 때문에, 원본 모델은 얼리고 보정값만 학습하면 된다는 결론이다. 보조망은 원본 모델이 내놓는 중간 잡음 제거 결과만 입력으로 받는다. 연구진이 이를 회색 상자 환경이라고 부르는 이유다. 내부 가중치를 뜯어볼 수 있는 흰 상자 접근이 없어도 중간 출력만 보이면 붙일 수 있다. 논문에 실린 보조망은 잠재 공간 64×64 크기에서 도는 경량 UNet이고, 가장 성능이 좋았던 구성의 학습 파라미터는 1,181만여 개다.
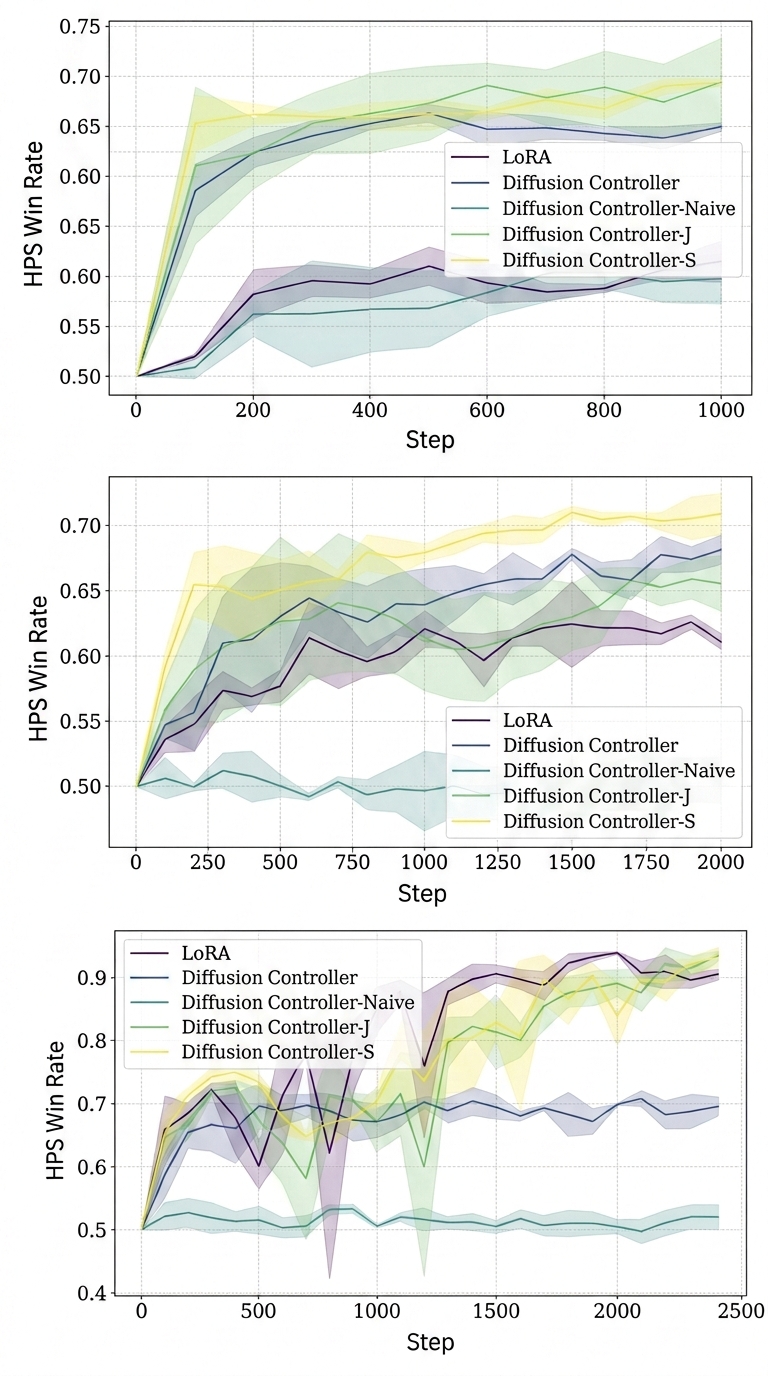
실험은 Stable Diffusion v1.4를 기반 모델로 지도 미세조정(SFT)과 보상 가중 손실(RWL), PPO 세 가지 학습 방식에서 진행했다. 지표는 사람 선호를 예측하는 HPS-v2 점수로 원본 모델과 겨룬 승률이다. 회색 상자용 Diffusion Controller는 파라미터 1,200만 개로 SFT에서 0.667, RWL에서 0.682의 승률을 냈다. 파라미터 1,700만 개를 쓰고 모델 내부 접근까지 필요한 LoRA는 같은 조건에서 0.577과 0.611에 그쳤다. 보조망 구조를 단순하게 만든 비교군은 0.566과 0.506으로 사실상 원본과 차이가 없었다. PPO에서는 LoRA가 0.905로 회색 상자 방식의 0.696을 앞섰지만, LoRA와 보조망을 함께 학습한 흰 상자 변형 Diffusion Controller-J는 0.935까지 올라갔다. 블로그가 말한 90% 승률이 이 수치다.
사람 평가도 붙었다. 연구진은 50명이 넘는 평가자에게 HPS-v2 프롬프트 50개로 만든 이미지 묶음을 보여 주고, 프롬프트마다 네 장씩 생성한 결과 가운데 가장 나은 묶음을 고르게 했다. 논문은 평가자들이 해당 국가의 생활임금 이상을 받는 유급 계약자였다고 적었다. 블로그에 따르면 Diffusion Controller는 여러 속성이 얽힌 복잡한 프롬프트에서 주관적 화질과 프롬프트 일치도 모두 가장 좋은 결과를 받았다. 보상 가중 손실 쪽에서는 기존 방식인 DPOK보다 4분의 1의 샘플로 더 높은 승률을 냈다고 논문은 밝혔다. 추론 단계에서는 가이던스 강도 값 하나만 바꿔 제어 세기를 올리거나 낮출 수 있다.
AI 엔지니어의 자리에서 보면 이 연구가 겨냥하는 곳은 비공개 모델이다. 쉬와 류는 블로그에서 "세계 최고 수준의 이미지 생성 모델은 대개 기업 비밀"이라며, 보조망이 기반 코드를 건드리지 않고도 잠긴 모델을 조정하게 해 준다고 설명했다. 모델 공급사가 가중치를 내주지 않아도 중간 출력만 열어 주면, 고객사가 자기 선호 데이터로 작은 보조망을 따로 학습시키는 사업 구조가 가능해진다는 얘기다. 실험이 Stable Diffusion v1.4 한 종에 머물렀다는 점은 최신 대형 모델에서의 효과를 아직 따로 확인해야 한다는 뜻이기도 하다. 구글 리서치는 다음 단계로 개인화 도구와 유해 이미지 생성을 줄이는 안전장치, 영상 모델 제어를 꼽았다. 메탈은 구글 리서치가 장편 AI 영상 생성 프레임워크를 공개한 소식을 보도한 바 있으며, 이번 제어 방식이 그 영상 생성 흐름으로 옮겨 갈지가 다음 관전 지점이다.
댓글