


이미지: METAL
요약
- 구글 리서치가 10월 2일 신뢰 실행 환경(TEE)과 공개 투명성 로그로 서버 측 처리를 외부에서 검증할 수 있게 한 TEE 기반 연합학습 시스템을 공개했다.
- 데이터 처리 코드는 기기가 업로드하기 전에 투명성 로그 레코에 공개되고, 바이너리는 깃허브 공개 코드로 다시 빌드해 대조할 수 있다.
- 지보드 A/B 테스트에서 새 시스템으로 학습한 영어 모델은 기존 제품 모델보다 3배 작은 프라이버시 예산으로 같은 사용성 지표를 냈고, 학습 기간은 2개월에서 3주로 줄었다.
- 발표
- 2026년 10월 2일 구글 리서치 블로그 · 백서 arXiv 2609.31494(14쪽)
- 저자
- 캐서린 데일리 소프트웨어 엔지니어 · 대니얼 라미지 리서치 디렉터
- 구조
- 기기 측 암호화 업로드 · 접근 정책을 투명성 로그 레코(Rekor)에 공개 · RAFT 합의 TEE 클러스터 KMS · 루트·워커 TEE에서 파이썬 학습 루프 실행
- 하드웨어
- AMD SEV-SNP · 인텔 TDX
- 기기 참여
- 기존 일본어 모델 38일·3000라운드에서 3550만 대 중 850만 대(23.9%) 참여 → 새 시스템 약 6일간 업로드 1780만 건 전량 학습
- 잡음 배수
- 영어 모델 5000라운드·zCDP 0.232 목표 시 새 시스템 5.16 · 기존 시스템이면 9.54
- A/B 테스트
- 실험군당 기기 350만 대 · zCDP 0.215 대 기존 0.641(3배 작음) · 사용성 지표 동등 · 학습 3주(기존 2개월)
- 다음 단계
- 현재 파라미터 1000만 개 규모까지 · 대형 모델은 GPU 워커 TEE 필요 · 합성 데이터 생성 작업 시험 중
구글 리서치가 10월 2일(현지시간) 기기 데이터를 서버로 모아 학습하면서도 그 처리 과정을 외부에서 검증할 수 있게 한 TEE 기반 연합학습 시스템을 공개했다. 신뢰 실행 환경(TEE)이라 불리는 서버 칩 안의 격리된 영역에서만 데이터를 풀고, 어떤 코드가 그 데이터를 만질 수 있는지를 공개 투명성 로그에 미리 올려 두는 방식이다. 구글은 이 시스템으로 안드로이드 키보드 지보드(Gboard)의 영어·일본어 다음 단어 예측 모델을 이미 내놨다. 함께 공개한 백서에 따르면 실사용 A/B 테스트에서 새 시스템으로 학습한 영어 모델은 기존 제품 모델보다 3배 작은 프라이버시 예산을 쓰면서 타이핑 속도 같은 핵심 사용성 지표를 그대로 지켰고, 학습 기간은 2개월에서 3주로 줄었다.
연합학습은 데이터를 한곳에 모으지 않고 여러 기기가 함께 모델을 학습하는 기법이다. 구글은 이 기법을 지보드의 다음 단어 예측과 스마트 컴포즈, 구글 메시지의 답장 제안, 안드로이드의 스마트 텍스트 선택에 써 왔다. 걸림돌은 서버였다. 구글은 블로그에서 예전 시스템에서는 서버에서 돌아가는 로직을 기기도 감사자도 검증할 수 없었고, 그래서 기울기 합에 무작위 잡음을 제대로 더해 차등 프라이버시를 지킨다는 점을 구글을 믿고 맡겨야 했다고 설명했다. 이후 도입한 보안 집계(Secure Aggregation)는 업로드를 암호로 보호했지만 최신 중앙 차등 프라이버시 보장과는 함께 쓸 수 없었다.
블로그를 쓴 캐서린 데일리 구글 리서치 소프트웨어 엔지니어와 대니얼 라미지 리서치 디렉터는 "새 TEE 기반 시스템은 서버 운영자를 믿어야 할 필요를 완전히 없애려는 지속적인 노력의 다음 이정표"라고 밝혔다. 백서는 이 시스템이 외부에서 검증할 수 있는 중앙 차등 프라이버시 보장을 처음으로 제공한다고 주장했다. TEE는 제3자가 실행 중인 로직을 확인하는 원격 증명, 내부 상태를 들여다볼 수 없는 기밀성, 로직을 방해할 수 없는 무결성을 기계 한 대 단위로 제공하는데, 구글은 이를 엮어 처음부터 끝까지 검증할 수 있는 연합학습 시스템을 만들었다. 서버 쪽 TEE에는 AMD SEV-SNP와 인텔 TDX를 썼다.
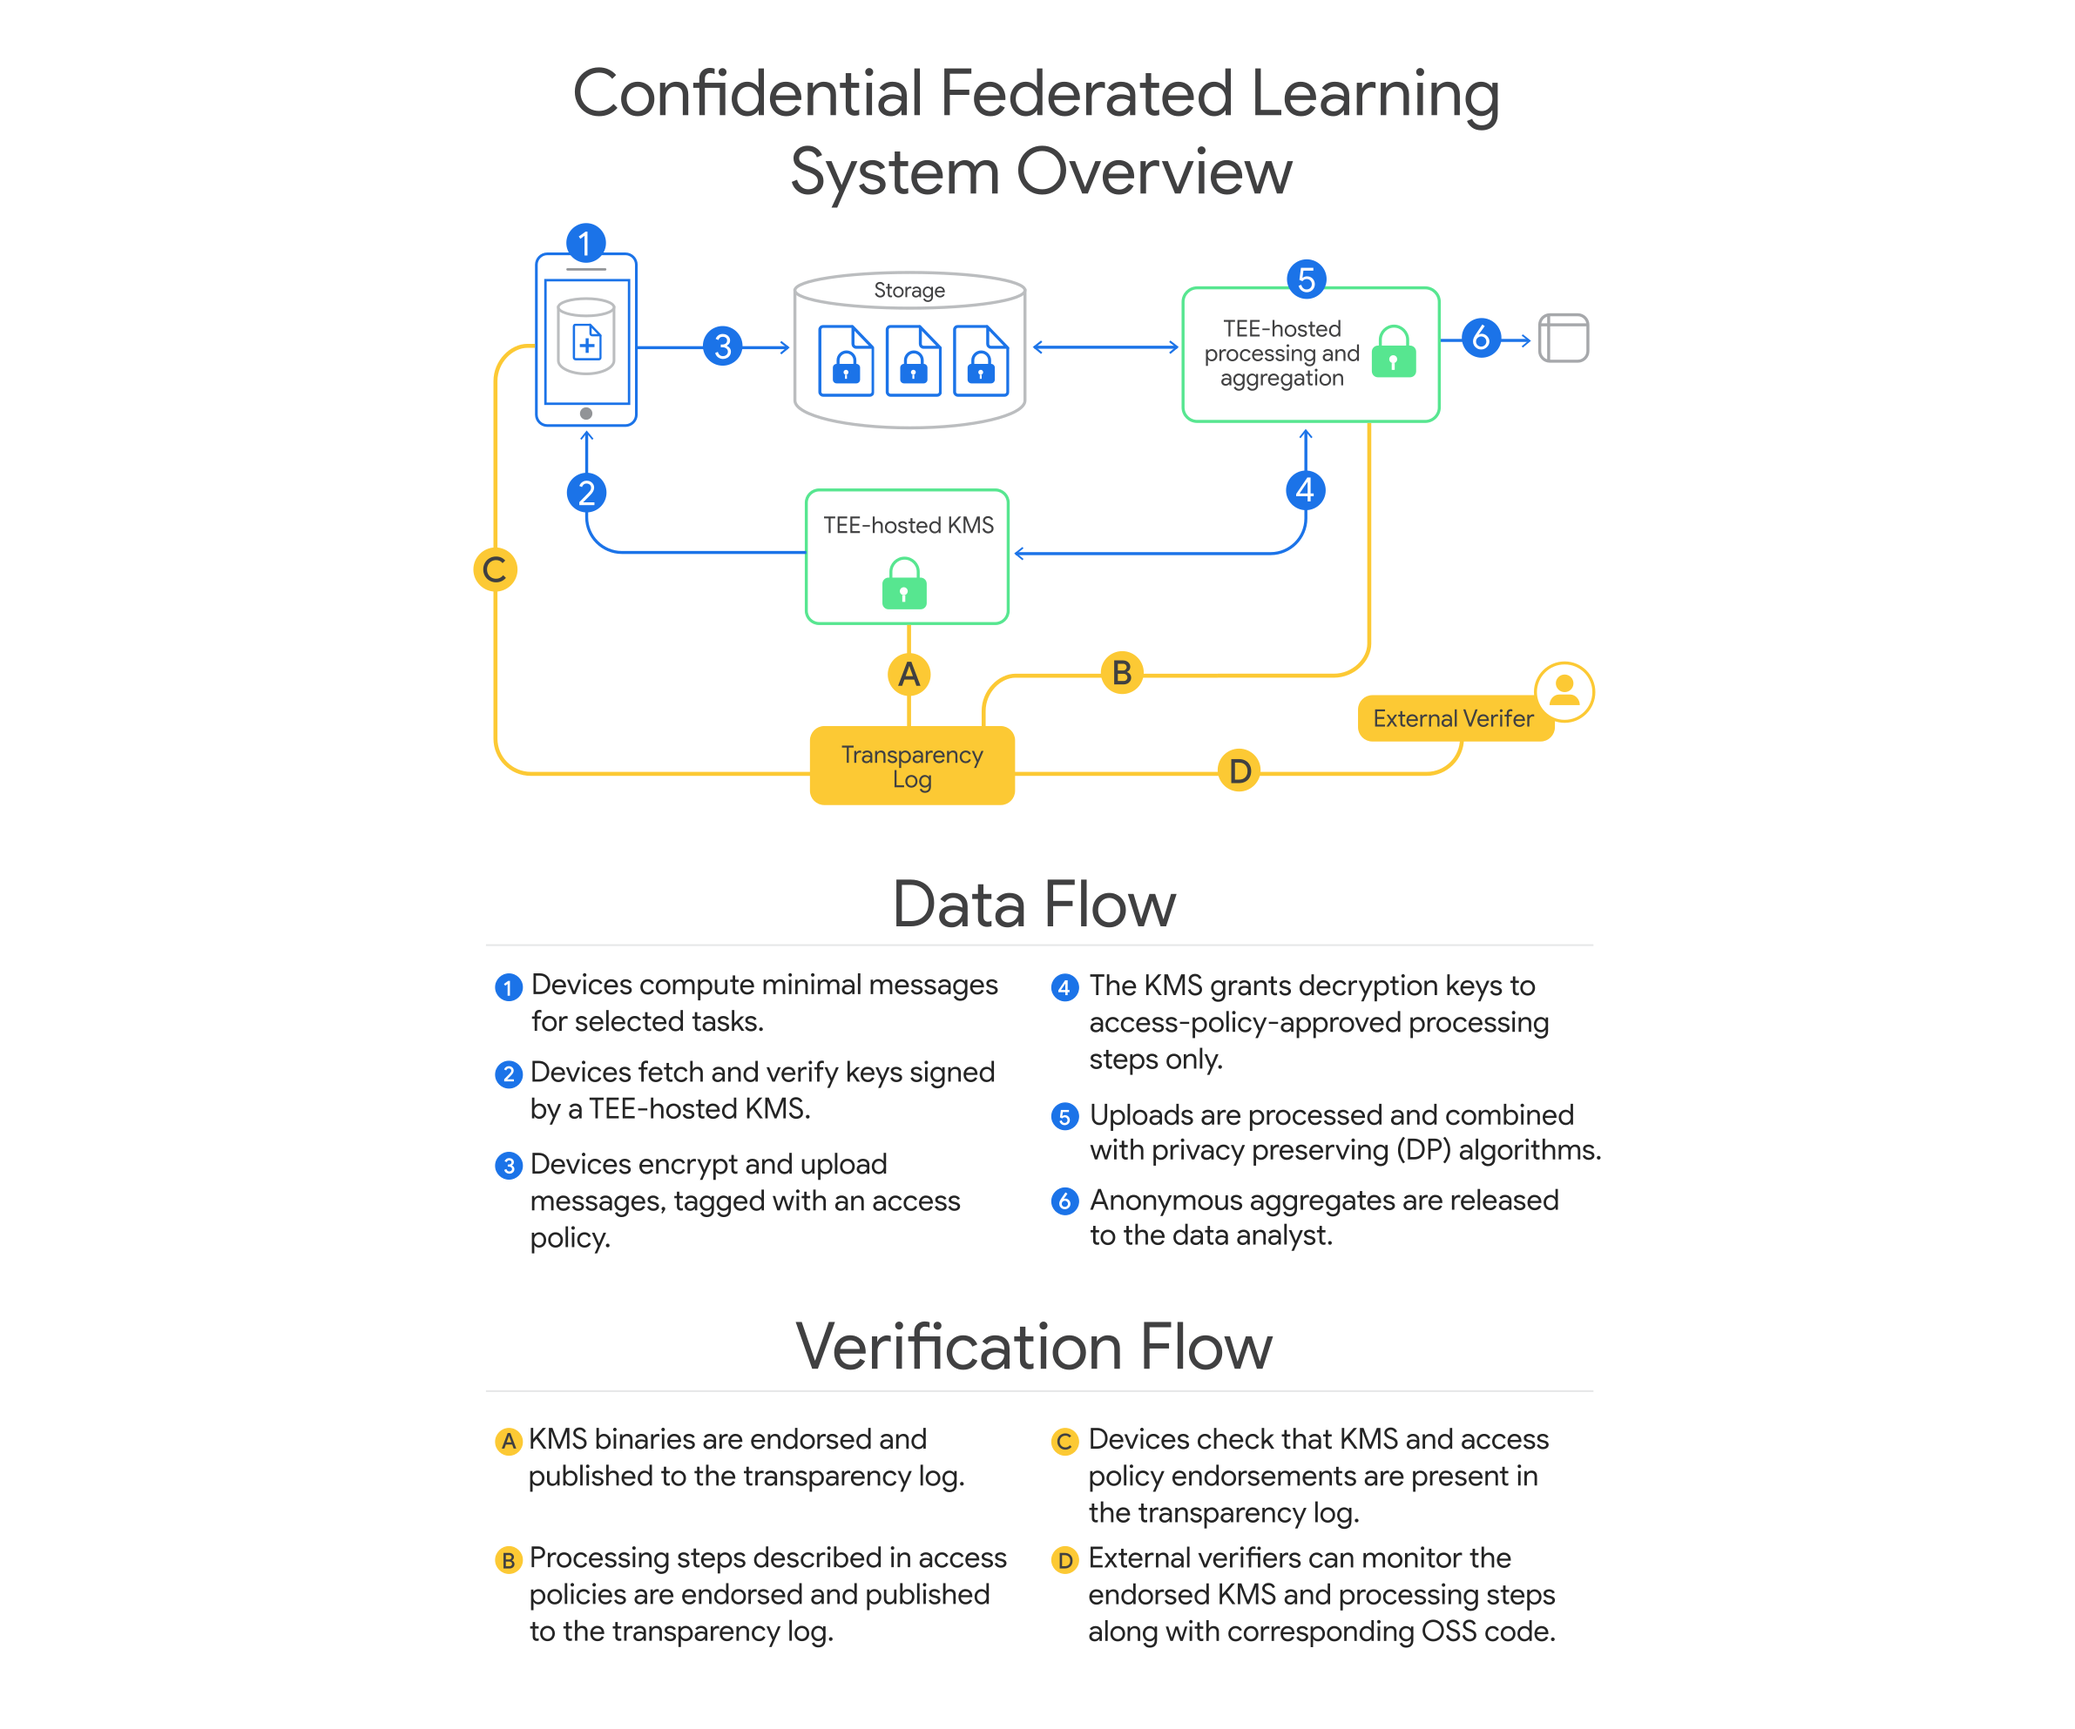
작동 순서는 이렇다. 기기는 학습 예시를 직접 암호화해 올리고, 올리기 전에 이 데이터를 처리해도 되는 TEE 계산의 목록인 접근 정책을 미리 승인한다. 기기는 그 접근 정책이 공개 투명성 로그 레코(Rekor)에 올라가 있어야만 업로드한다. 복호화 키를 쥔 키 관리 시스템(KMS)은 RAFT 합의 프로토콜로 묶인 TEE 클러스터이고, 접근 정책에 적힌 계산과 일치하는 서버 측 TEE 작업에만 키를 내준다. 실제 학습은 파이썬 학습 루프를 실행하는 루트 TEE가 맡고, 나눌 수 있는 작업은 워커 TEE들에 넘긴다. 분산 로직은 텐서플로 페더레이티드에서 갈라져 나온 오픈소스 오케스트레이션 언어 페더레이티드 랭귀지(Federated Language)로 짠다.
메탈이 확인한 14쪽 분량의 백서에 따르면 접근 정책에는 학습 로직을 담은 파이썬 프로그램 자체와 루트·워커 바이너리의 해시가 함께 들어간다. 정책이 투명성 로그에 공개되는 순간 그 파이썬 프로그램은 오픈소스가 되고, 외부 감사자는 프로그램이 차등 프라이버시를 어떻게 확보하는지 직접 읽을 수 있다. KMS와 데이터 처리 바이너리는 깃허브의 컨피덴셜 페더레이티드 컴퓨트(Confidential Federated Compute) 저장소에 공개된 코드로 똑같이 다시 빌드할 수 있다. 감사자는 학습에 참여하는 기기가 없어도 로그만 보고 서버에서 돌 수 있는 작업의 전체 목록을 알 수 있고, 워크로드 운영자의 눈에 보이는 것은 지표와 차등 프라이버시가 적용된 모델 가중치뿐이다.
회사의 영업비밀은 사이드로딩이라는 통로로 남겼다. 모델 구조나 데이터 전처리 로직처럼 공개하기 어려운 정보는 실행 시점에 파이썬 프로그램으로 불러오되, 프라이버시에 관련된 로직은 모두 프로그램 안에 고정해 둬야 한다는 조건이다. 백서는 사이드로딩된 정보는 암호화되지 않고 공개되지도 않지만, 감사자가 그 정보가 프로그램에서 어떻게 쓰이는지 보고 보장이 유지되는지 판단할 수 있다고 적었다. 구글은 이 보장이 부채널 관측처럼 현 세대 TEE에 알려진 제약을 전제로 한다는 점도 밝혔다. 업로드 데이터에는 유효기간(TTL)이 걸려 일정 기간이 지나면 어떤 TEE도 풀 수 없는데, 백서는 이 TTL을 KMS가 최선 노력 방식으로 집행한다고 적었다.
구조를 바꾸자 학습에 참여하는 기기 수부터 달라졌다. 기존 시스템에서는 와이파이에 연결되고 충전 중이며 배터리가 충분한 기기만 서버가 고른 묶음인 코호트에 들어가 그 자리에서 계산을 마쳐야 했다. 백서에 따르면 일본어 모델을 기존 시스템에서 코호트 6500대로 38일 동안 3000라운드 학습했을 때 조건을 갖춘 기기 3550만 대 가운데 실제로 데이터를 보탠 기기는 850만 대, 23.9%에 그쳤다. 2050만 대는 서버에서 작업을 한 번도 받지 못했고, 650만 대는 작업을 받았지만 중간에 끊겨 끝내지 못했다. 새 시스템은 약 6일 동안 업로드 1780만 건을 먼저 모은 뒤 학습을 시작했고, 그 1780만 건을 모두 학습에 썼다.
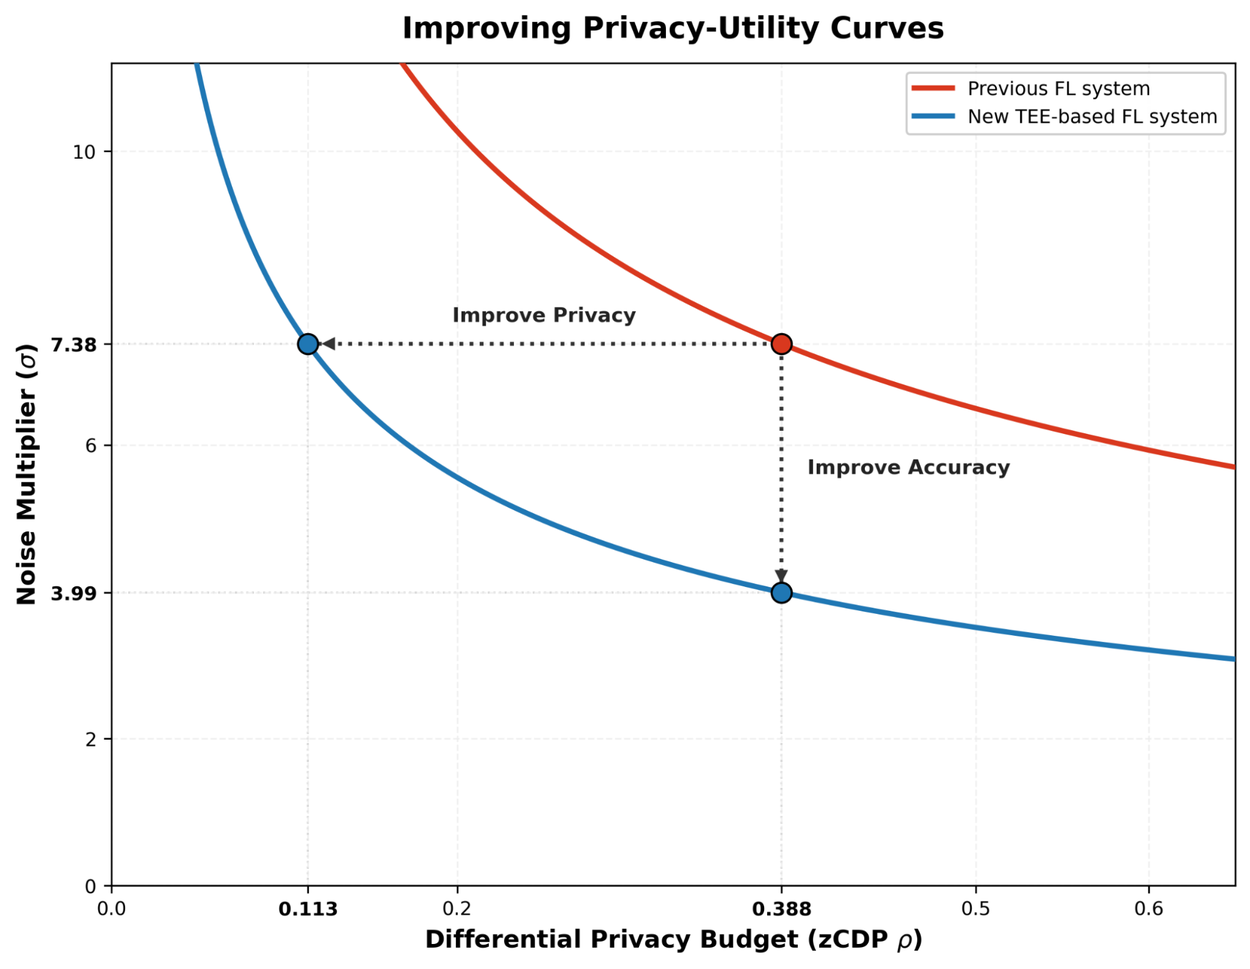
데이터를 먼저 다 모아 두면 낮과 밤에 따라 접속 기기 수가 출렁이는 문제에서 벗어나, 기기마다 참여 횟수와 간격을 서버에서 최적으로 짤 수 있다. 영어 모델 실험에서 구글은 5000라운드 기준 프라이버시 예산 zCDP 0.232를 목표로 잡았고, 업로드 1180만 건을 바탕으로 필요한 잡음 배수를 5.16으로 계산했다. 같은 예산을 기존 시스템에서 맞추려면 잡음 배수가 9.54까지 올라가야 했다. 기존 시스템은 잡음 배수 7.38로 85일 동안 8616라운드를 돌렸고, 기기는 144시간에 한 번씩만 참여할 수 있었다. 5000라운드 시점에서 한 기기가 참여한 최대 라운드 수는 기존 8회에서 3회로 줄었고, 참여 사이 최소 간격은 561라운드에서 1822라운드로 늘었다.
실사용 검증은 지보드 사용자 일부를 대상으로 한 A/B 테스트로 했다. 지보드의 타이핑 디코더는 자동 수정과 단어 완성, 다음 단어 예측에 언어 모델을 쓰는데, 실험군마다 기기 350만 대가 들어갔다. 가장 좋은 TEE 실험군은 zCDP 0.215로, 같은 방식으로 환산한 기존 제품 영어 모델의 0.641보다 프라이버시 예산이 3배 작았다. 분당 입력 단어 수와 사용자가 제안을 고쳐 쓴 비율 같은 핵심 지표는 차이가 없었다. 예전에는 이런 모델 하나를 학습하는 데 1~2개월이 걸렸지만, 병목이 서버로 옮겨 가면서 기계 14대만으로도 라운드 시간이 크게 줄었다고 백서는 적었다.
서버의 격리된 칩 영역으로 개인 데이터를 보호하는 흐름은 업계 전반으로 번지고 있다. 백서는 애플 프라이빗 클라우드 컴퓨트, 구글 프라이빗 AI 컴퓨트, 메타 프라이빗 프로세싱을 TEE나 비슷한 기밀 컴퓨팅 환경에서 LLM 추론을 돌리는 최근 사례로 꼽았다. 메탈은 구글의 서버 측 AI 메모리 설계 공개를 보도한 바 있으며, 이번 발표는 같은 접근을 추론에서 학습으로 넓힌 것이다. 새 시스템으로 학습한 모델은 지금까지 파라미터 1000만 개 규모까지이고, 훨씬 큰 모델을 학습하려면 워커 TEE가 GPU를 써야 한다고 백서는 밝혔다. 구글은 같은 인프라에서 합성 데이터 생성 작업을 시험하고 있으며, LLM 추론 전용 TEE와 묶어 쓰는 방안도 살피고 있다.
테크 법률의 눈으로 보면 이번 발표의 무게는 정확도보다 입증 책임에 있다. 지금까지 개인정보를 다루는 기업의 약속은 정책 문서와 내부 감사에 기댔고, 이용자와 규제 당국은 회사의 설명을 믿는 수밖에 없었다. 구글은 어떤 코드가 데이터를 만질 수 있는지를 기기가 업로드하기 전에 공개 로그로 고정하고, 그 코드를 누구나 다시 빌드해 대조할 수 있게 해 약속을 외부에서 확인할 수 있는 기록으로 바꿨다. 백서는 파이프라인 운영자가 라운드마다 어떤 업로드가 쓰였는지는 여전히 볼 수 있다고 밝히고, 이를 가리면 표본 추출에 의한 프라이버시 증폭으로 같은 잡음에서 더 강한 보장을 얻을 수 있다고 적었다.
데일리 엔지니어와 라미지 디렉터는 "이번 작업은 서버 측 처리가 개인의 프라이버시를 지킨다는 엄밀한 증명을 향한 한 걸음"이라고 썼다. 이들은 외부 검증자가 구글이 정확히 어떤 코드를 돌리는지 들여다볼 수 있기 때문에 데이터가 설명된 그대로 처리된다는 강한 확신을 줄 수 있다고 밝혔다. 구글은 차세대 TEE 하드웨어와 부채널 연구가 동적으로 불러온 작업까지 보호하고, 언젠가는 차등 프라이버시 알고리즘과 시스템 구성 요소의 구현 전체에 정확성 증명이 붙을 것으로 내다봤다. 개인 데이터로 AI를 학습하는 일에서 신뢰의 근거는 회사의 선언에서 누구나 열어 볼 수 있는 로그로 옮겨 가고 있다.
댓글