


이미지: METAL
요약
- 사카나AI가 도쿄대학과 함께 VLM 기반 로봇 궤적 생성법 SAIL을 공개했고, 이 연구는 IROS 2026에서 발표된다.
- Gemini Robotics-ER 1.5의 가중치를 바꾸지 않고 MCTS·유사 시연 검색·단계별 피드백으로 궤적을 고쳐, 여섯 과제 평균 성공률을 25%에서 73%로 끌어올렸다.
- LeRobot SO-101 실물 팔로 6번 중 5번 성공했고, 탐색으로 모은 궤적 120개로 학습한 정책은 실행 시간을 644.72초에서 72.306초로 줄였다.
- 발표
- 2026년 9월 27일(UTC) 사카나AI 블로그·X · 도쿄대학 공동 연구 · IROS 2026 발표
- 논문
- arXiv 2603.08269 · 3월 9일 v1, 9월 19일 v2 · 저자 사토 마코토·이와사와 유스케·유진 탕·구로키 소
- 모델
- Gemini Robotics-ER 1.5(정책·평가 공용, 가중치 갱신 없음)
- 방법
- MCTS(마디=완성 궤적, 분기 계수 3) · LPIPS 유사 시연 검색 · 실행 영상 50프레임 진행률 채점 · 경유점별 피드백
- 시뮬레이션
- ALOHA 6과제 × 초기 배치 20개 · 후보 1/6/15/30/45개 평균 25/55/65/71/73%
- 탐색 비교
- 15개 예산 SAIL 65% · 너비 우선 51% · 깊이 우선 37%
- 검색·피드백
- 유사 시연 65% · 고정 45% · 무작위 50% · 단계별 피드백 65% vs 다른 방식 45~49%
- 실물
- LeRobot SO-101 · 블록을 그릇에 넣기 · 6회 중 5회 성공(탐색·증류 정책 모두)
- 속도
- MCTS 평균 644.72초 → ACT 증류 정책 72.306초 · 성공 궤적 120개로 학습
사카나AI가 9월 27일(UTC) 로봇 궤적 생성법 SAIL(Scaling In-Context Imitation Learning)을 공개했다. 비전언어모델(VLM)이 성공 시연 몇 개만 보고 로봇 팔의 움직임 전체를 짜되, 한 번에 내놓은 답을 그대로 쓰지 않고 시뮬레이터에서 먼저 돌려 본 뒤 고쳐 쓰게 하는 방식이다. 여섯 가지 조작 과제에서 후보 궤적 예산을 1개에서 45개로 늘리자 성공 궤적을 찾는 평균 비율이 25%에서 73%로 올랐다고 회사 측은 밝혔다. 도쿄대학과 함께 한 이 연구는 로봇 학회 IROS 2026에서 발표된다.
이번 연구에서 모델 가중치는 한 번도 바뀌지 않았다. SAIL은 궤적을 만드는 정책 역할과 결과를 채점하는 평가 역할 모두에 구글의 Gemini Robotics-ER 1.5를 그대로 썼다. 언어 모델에서는 추론 시점에 계산을 더 들여 후보를 만들고 검토하고 고치는 테스트 타임 스케일링이 정확도를 끌어올리는 길로 자리 잡았는데, 사카나AI는 같은 거래가 물리적 동작에도 통하는지를 물었다. 회사는 블로그에서 GPT-6 Astra가 카메라 영상과 로봇 상태만으로 동작 목표를 정해 실물 로봇의 조작 과제 여러 개를 해냈다고 짚으며, 파운데이션 모델 안에 이미 로봇 제어에 쓸 지식이 들어 있다는 전제를 깔았다.
출발점은 한 번의 생성을 믿기 어렵다는 관찰이다. 모델의 예측은 어떤 시연을 맥락으로 받느냐에 따라 달라지고, 같은 조건에서도 샘플링마다 흔들린다. 사카나AI는 "모델이 생성한 동작 목표의 작은 오차 하나가 작업 전체를 실패로 만들 수 있다"고 설명했다. 평가 없이 첫 예측을 곧바로 실행하면 로봇이 움직이기 전에 그 오차를 바로잡을 기회가 없다는 것이다.
SAIL은 이 문제를 몬테카를로 트리 탐색(MCTS)으로 푼다. 트리의 마디 하나가 완성된 궤적 하나이고, 가지는 앞 궤적을 고쳐 쓰는 한 번의 수정이다. 먼저 성공 궤적을 쌓아 둔 보관소에서 지금 장면과 가장 비슷해 보이는 시연을 LPIPS 거리로 골라 맥락에 넣는다. 만든 궤적은 시뮬레이터에서 실행되고, 평가용 VLM이 그 실행 영상에서 50장의 프레임을 고르게 뽑아 잡기, 들기, 건네기 같은 하위 과제가 몇 퍼센트 진행됐는지 매긴다. 이 점수를 궤적의 경유점마다 붙여 다시 정책 모델에 돌려주면, 모델은 점수가 높은 구간은 살리고 진행이 멈춘 구간만 고친다. 탐색 중 찾은 성공 궤적은 보관소에 추가돼 다른 초기 배치를 풀 때 다시 쓰인다.
논문 제1저자인 사토 마코토 도쿄대학 연구원을 비롯한 저자 4명은 논문에서 이 설계가 "정적인 모방에서 벗어나, 로봇이 사실상 더 오래 생각해 새 과제의 모호함을 풀 수 있는 역동적 패러다임으로 초점을 옮긴다"고 썼다. 사토 연구원은 사카나AI 인턴 시절 이 연구를 했고, 공동 저자에는 이와사와 유스케 도쿄대학 연구원과 사카나AI의 유진 탕, 구로키 소 연구원이 이름을 올렸다.
수치는 계산을 늘릴수록 올라갔다. 실험은 ALOHA 조작 시뮬레이터의 바나나 건네기, 펜 건네기, 그릇 선반에 올리기, 서랍 열기, 노트북 닫기, 마커 뚜껑 빼기 여섯 과제에서 과제마다 초기 배치 20개로 진행됐다. 후보 예산이 6개, 15개, 30개, 45개일 때 평균 성공률은 각각 55%, 65%, 71%, 73%였다. 서랍 열기는 10%에서 50%로, 노트북 닫기는 15%에서 70%로, 마커 뚜껑 빼기는 5%에서 45%로 뛰었고, 바나나 건네기는 95%까지 올랐다. 그릇 과제는 후보 6개에서 이미 100%에 닿아 그 뒤로 그대로였다.
탐색 방식의 차이도 드러났다. 같은 15개 예산에서 SAIL의 평균 성공률은 65%로, 피드백 없이 후보 15개를 한꺼번에 뽑는 너비 우선 탐색 51%와 한 궤적을 15번 연달아 고치는 깊이 우선 탐색 37%를 앞섰다. 다만 노트북 닫기에서는 너비 우선 탐색이 60%로 SAIL의 50%보다 높았는데, 저자들은 얇은 화면 윗모서리를 그리퍼가 안전하게 넘어가려면 미세한 위치 조정이 필요하고 무작위성이 큰 너비 우선 탐색이 이 기하 조건에 잘 맞았다고 분석했다.
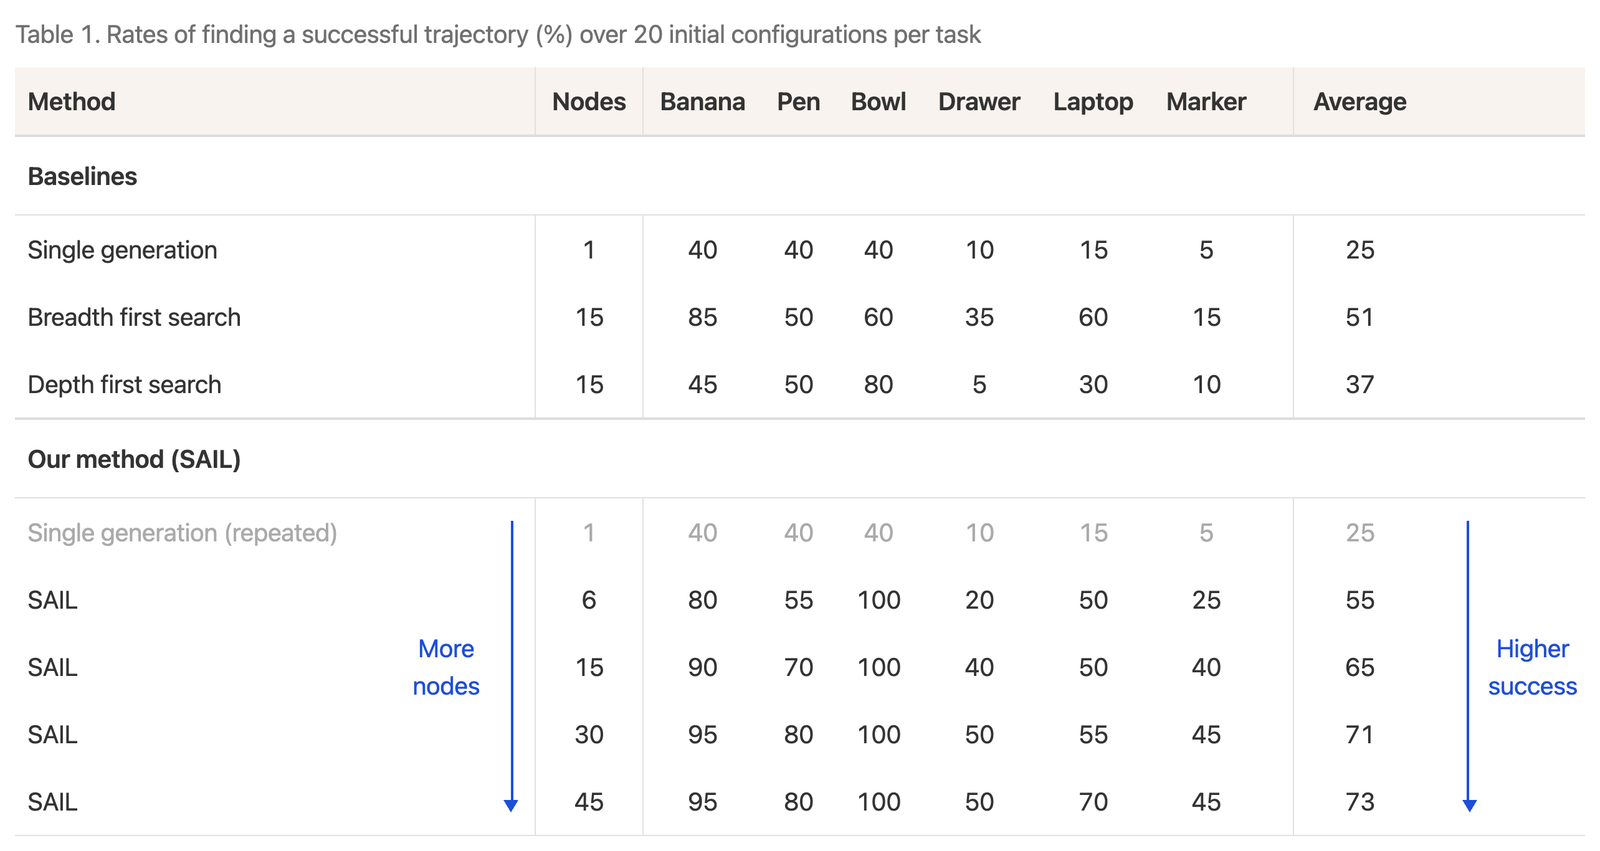
어떤 시연을 넣느냐는 얼마나 넣느냐보다 중요했다. 15개 예산 기준으로 비슷한 장면의 시연 하나를 골라 넣은 SAIL은 65%, 원래 시연만 고정해 쓴 경우는 45%, 보관소에서 무작위로 고른 경우는 50%였다. 고정 시연을 3개로 늘려도 49%, 무작위 3개는 53%에 그쳤다. 저자들은 논문에서 "성능은 맥락 속 시연의 양보다 관련성에 더 민감하다"고 결론지었다. 피드백 방식 비교에서도 궤적 글만, 실행 이미지만, 둘을 함께 준 경우가 45~48%, 최종 점수 하나만 준 경우가 49%로, 경유점마다 점수를 붙인 단계별 피드백의 65%에 못 미쳤다.
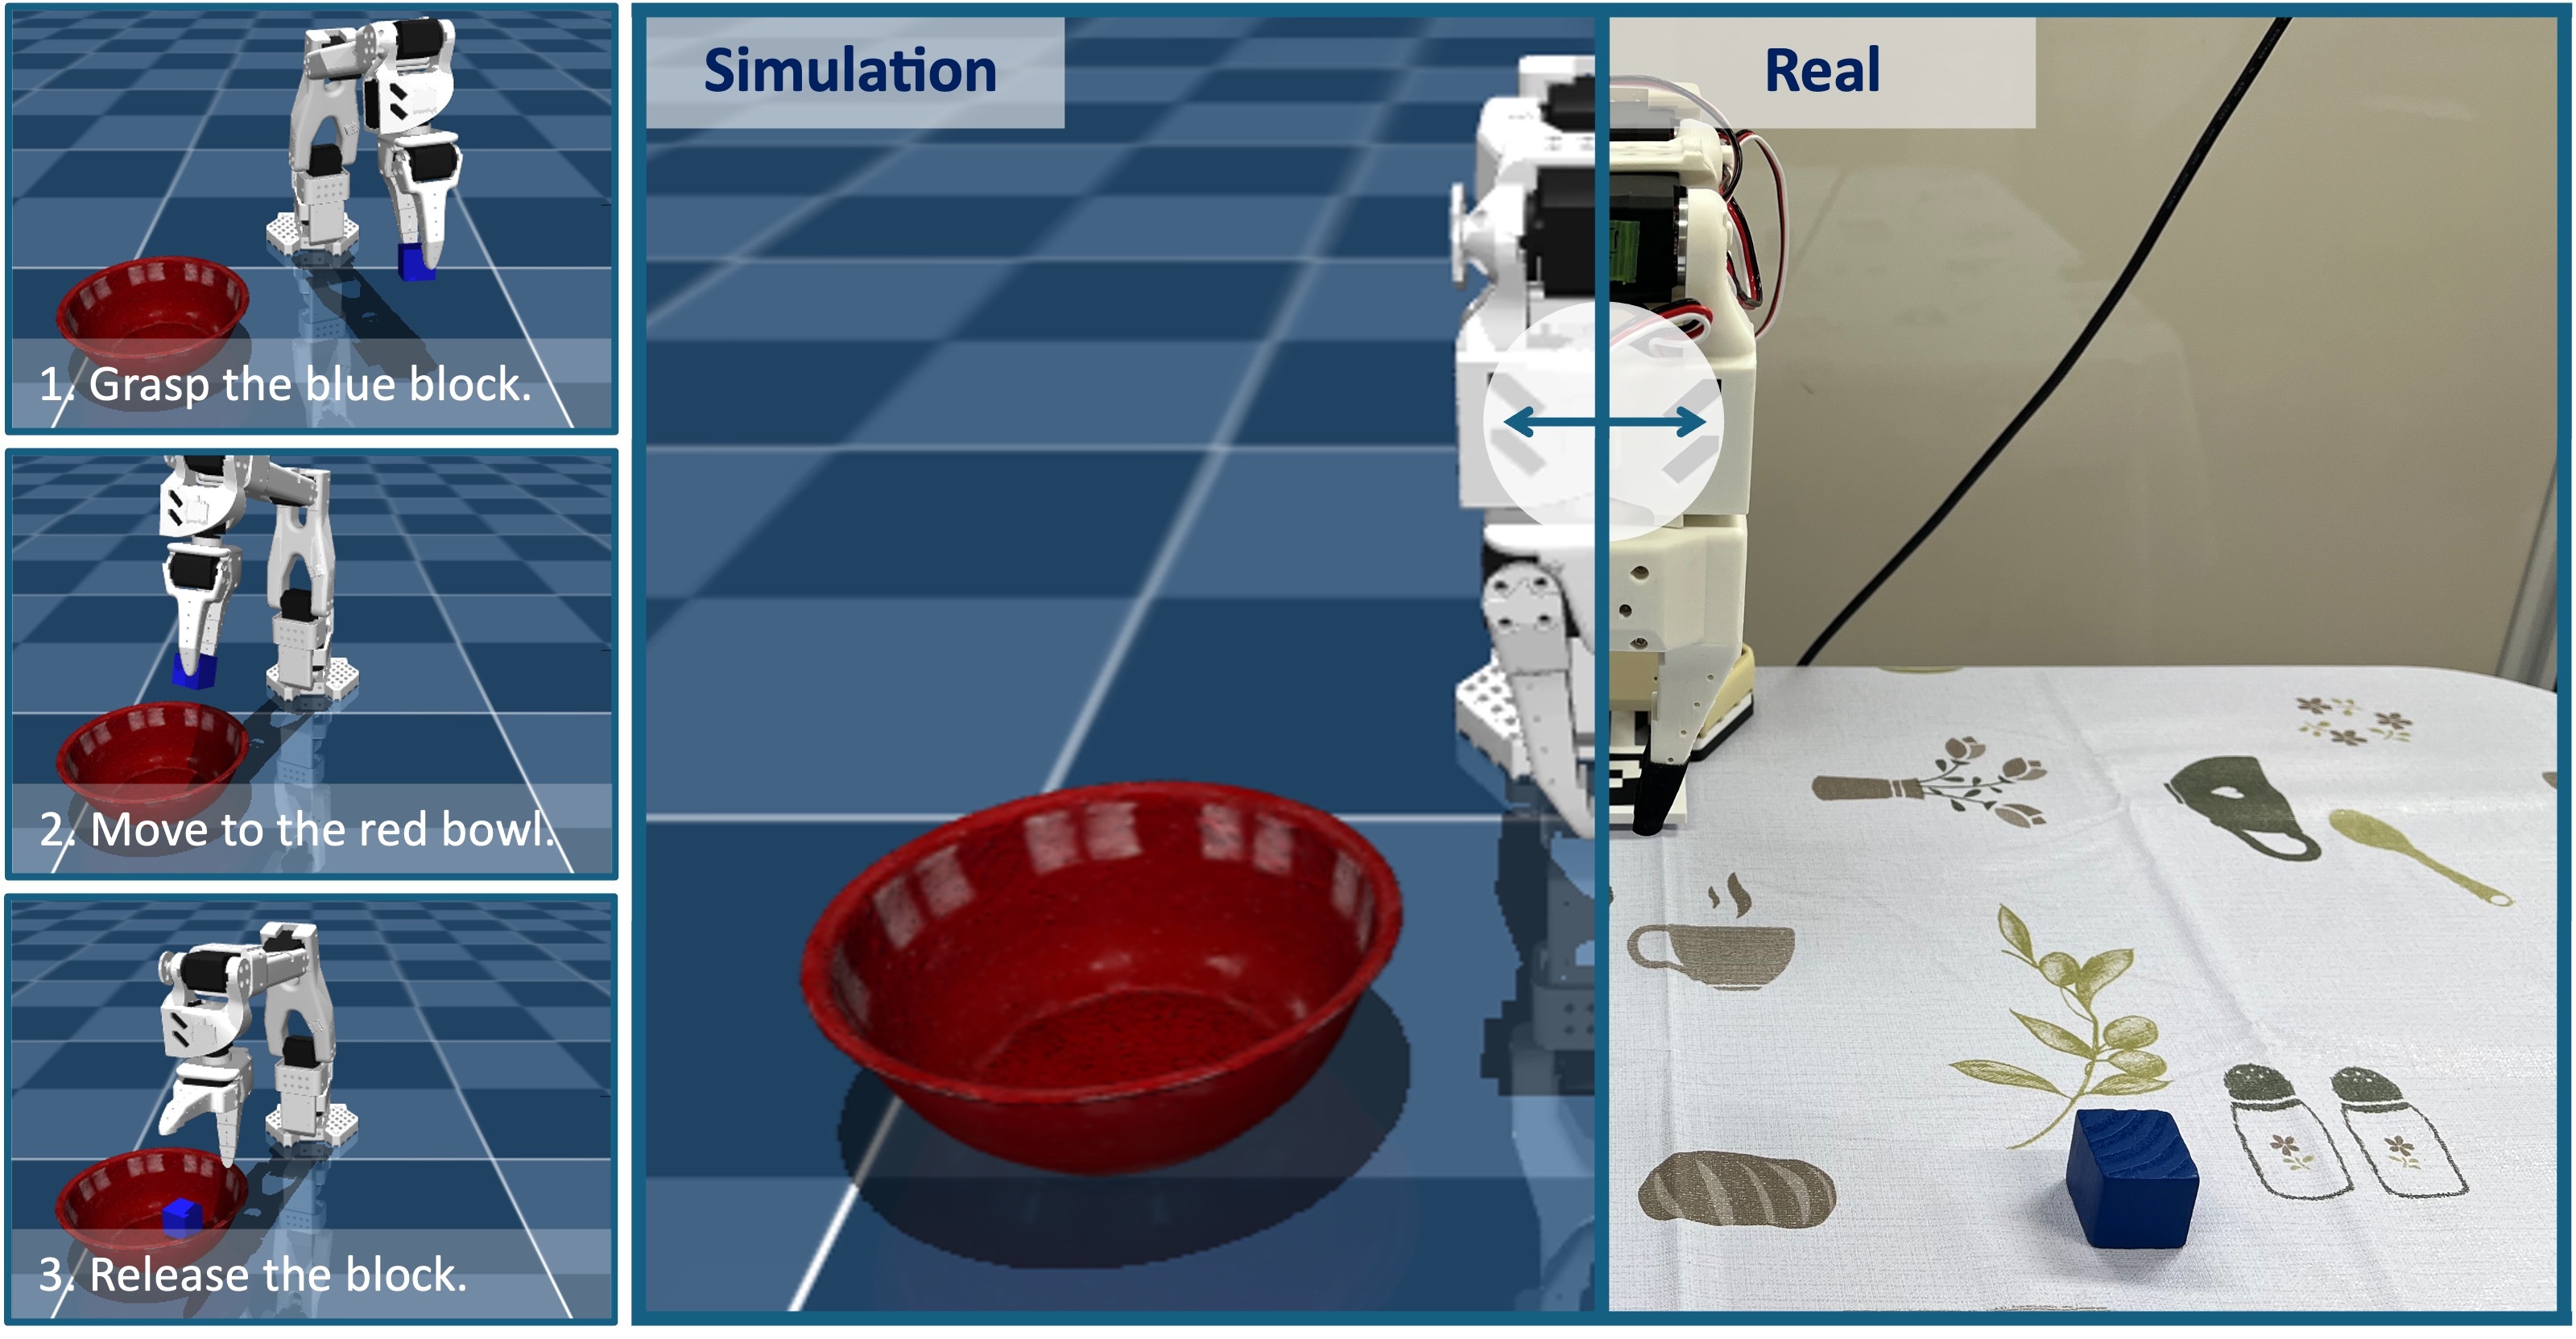
실물 검증은 오픈소스 로봇 학습 라이브러리 LeRobot 계열의 SO-101 로봇 팔로 했다. 과제는 파란 블록을 집어 빨간 그릇에 넣는 것이다. 인텔 RealSense D435i 카메라의 색상과 깊이 정보로 GroundingDINO가 물체를 찾고 SAM2가 윤곽을 따면, 로봇 받침대에 붙인 ArUco 마커를 기준으로 좌표를 맞춰 시뮬레이터 안에 같은 장면을 다시 세운다. 그 디지털 트윈에서 후보 15개 예산으로 성공 궤적을 찾아 실물 팔로 실행하자, 블록과 그릇 위치를 손으로 섞은 6번의 시도 중 5번이 성공했다. 저자들은 나머지 1번의 실패를 깊이 영상 기반 자세 추정의 작은 오차와 시뮬레이터가 담지 못한 실제 접촉 역학 차이 탓으로 돌렸다.
속도 문제에는 증류로 답했다. MCTS 탐색은 시도 한 번에 평균 644.72초가 걸렸다. 연구진은 시뮬레이션에서 물체 배치를 바꿔 가며 SAIL로 성공 궤적 120개를 모은 뒤, 이를 행동 복제 방식으로 ACT(Action Chunking with Transformers) 정책에 학습시켰다. 이 정책도 실물 시도 6번 중 5번 성공했고, 평균 실행 시간은 72.306초로 줄었다. 저자들은 "MCTS 프레임워크가 빠르게 배치할 수 있는 로봇 정책을 훈련하는 자동 데이터 수집 엔진이 될 수 있다"고 적었다.
메탈이 확인한 논문 원문과 발표 페이지에 따르면 이 연구는 3월 9일 arXiv에 처음 올라왔고 9월 19일 개정판이 나왔다. 궤적은 움직이는 동안 시각 피드백 없이 정해진 대로 실행되는 개방 루프 방식이고, 실물 평가는 한 과제 6회에 머물렀다고 사카나AI는 스스로 적었다. 연구진은 다음 단계로 가우시안 스플래팅으로 만든 사실적 디지털 트윈과 결합해 시뮬레이션과 현실 사이의 시각 격차를 좁히겠다고 밝혔다. 메탈은 사카나AI가 역전파 없는 학습법 PC-ALM을 공개한 소식을 보도한 바 있으며, 이번 SAIL이 기반으로 삼은 제미나이 로보틱스 계열이 실제 가정용 로봇 Apollo에서 부딪힌 문제도 다룬 바 있다.
AI 엔지니어의 눈으로 보면 SAIL은 로봇 학습의 비용 구조를 옮겨 놓는다. 지금까지 새 과제를 가르치는 비용은 사람이 시연을 모으고 정책을 다시 학습시키는 데이터 비용이었다. SAIL은 그 자리를 추론 계산으로 채우고, 계산이 늘어나는 만큼 성공률이 오르는 곡선을 실측으로 내놓았다. 대가는 시간이다. 한 번에 11분 가까이 걸리는 탐색은 그대로 현장에 쓰기 어렵지만, 그렇게 찾은 성공 궤적 120개가 72초짜리 정책의 학습 데이터가 되는 순환은 계산을 데이터로 바꾸는 공장에 가깝다. 이 공장의 품질은 결국 시뮬레이터가 현실을 얼마나 닮았느냐에 묶인다. 사카나AI가 "기존 모델이 이런 피드백으로 무엇을 할 수 있는지, 그 개선이 실제 로봇까지 얼마나 이어지는지 더 배울 것이 있다"고 밝힌 것도 그 병목을 가리킨다.
댓글