


이미지: 영상 갈무리
요약
- 일레븐랩스가 9월 28일 새 아키텍처의 음성 모델 Eleven v4와 실시간용 Eleven v4 Turbo를 공개했다.
- Eleven v4는 아티피셜 애널리시스 음성 순위표 1위에 올랐고, 회사의 블라인드 선호도 시험에서 경쟁 모델을 상대로 65~81%를 이겼다.
- Turbo의 첫 음성까지 걸리는 시간 중앙값은 약 150밀리초이며, 두 모델 모두 90개 이상의 언어와 인라인 연출 태그를 지원한다.
- 발표
- 2026년 9월 28일 · Eleven v4 · Eleven v4 Turbo · ElevenAgents·ElevenCreative·ElevenAPI 제공
- 순위
- 아티피셜 애널리시스 음성 순위표 1위 · 보도에 따르면 엘로 1319(표본 1674개)
- 선호도 시험
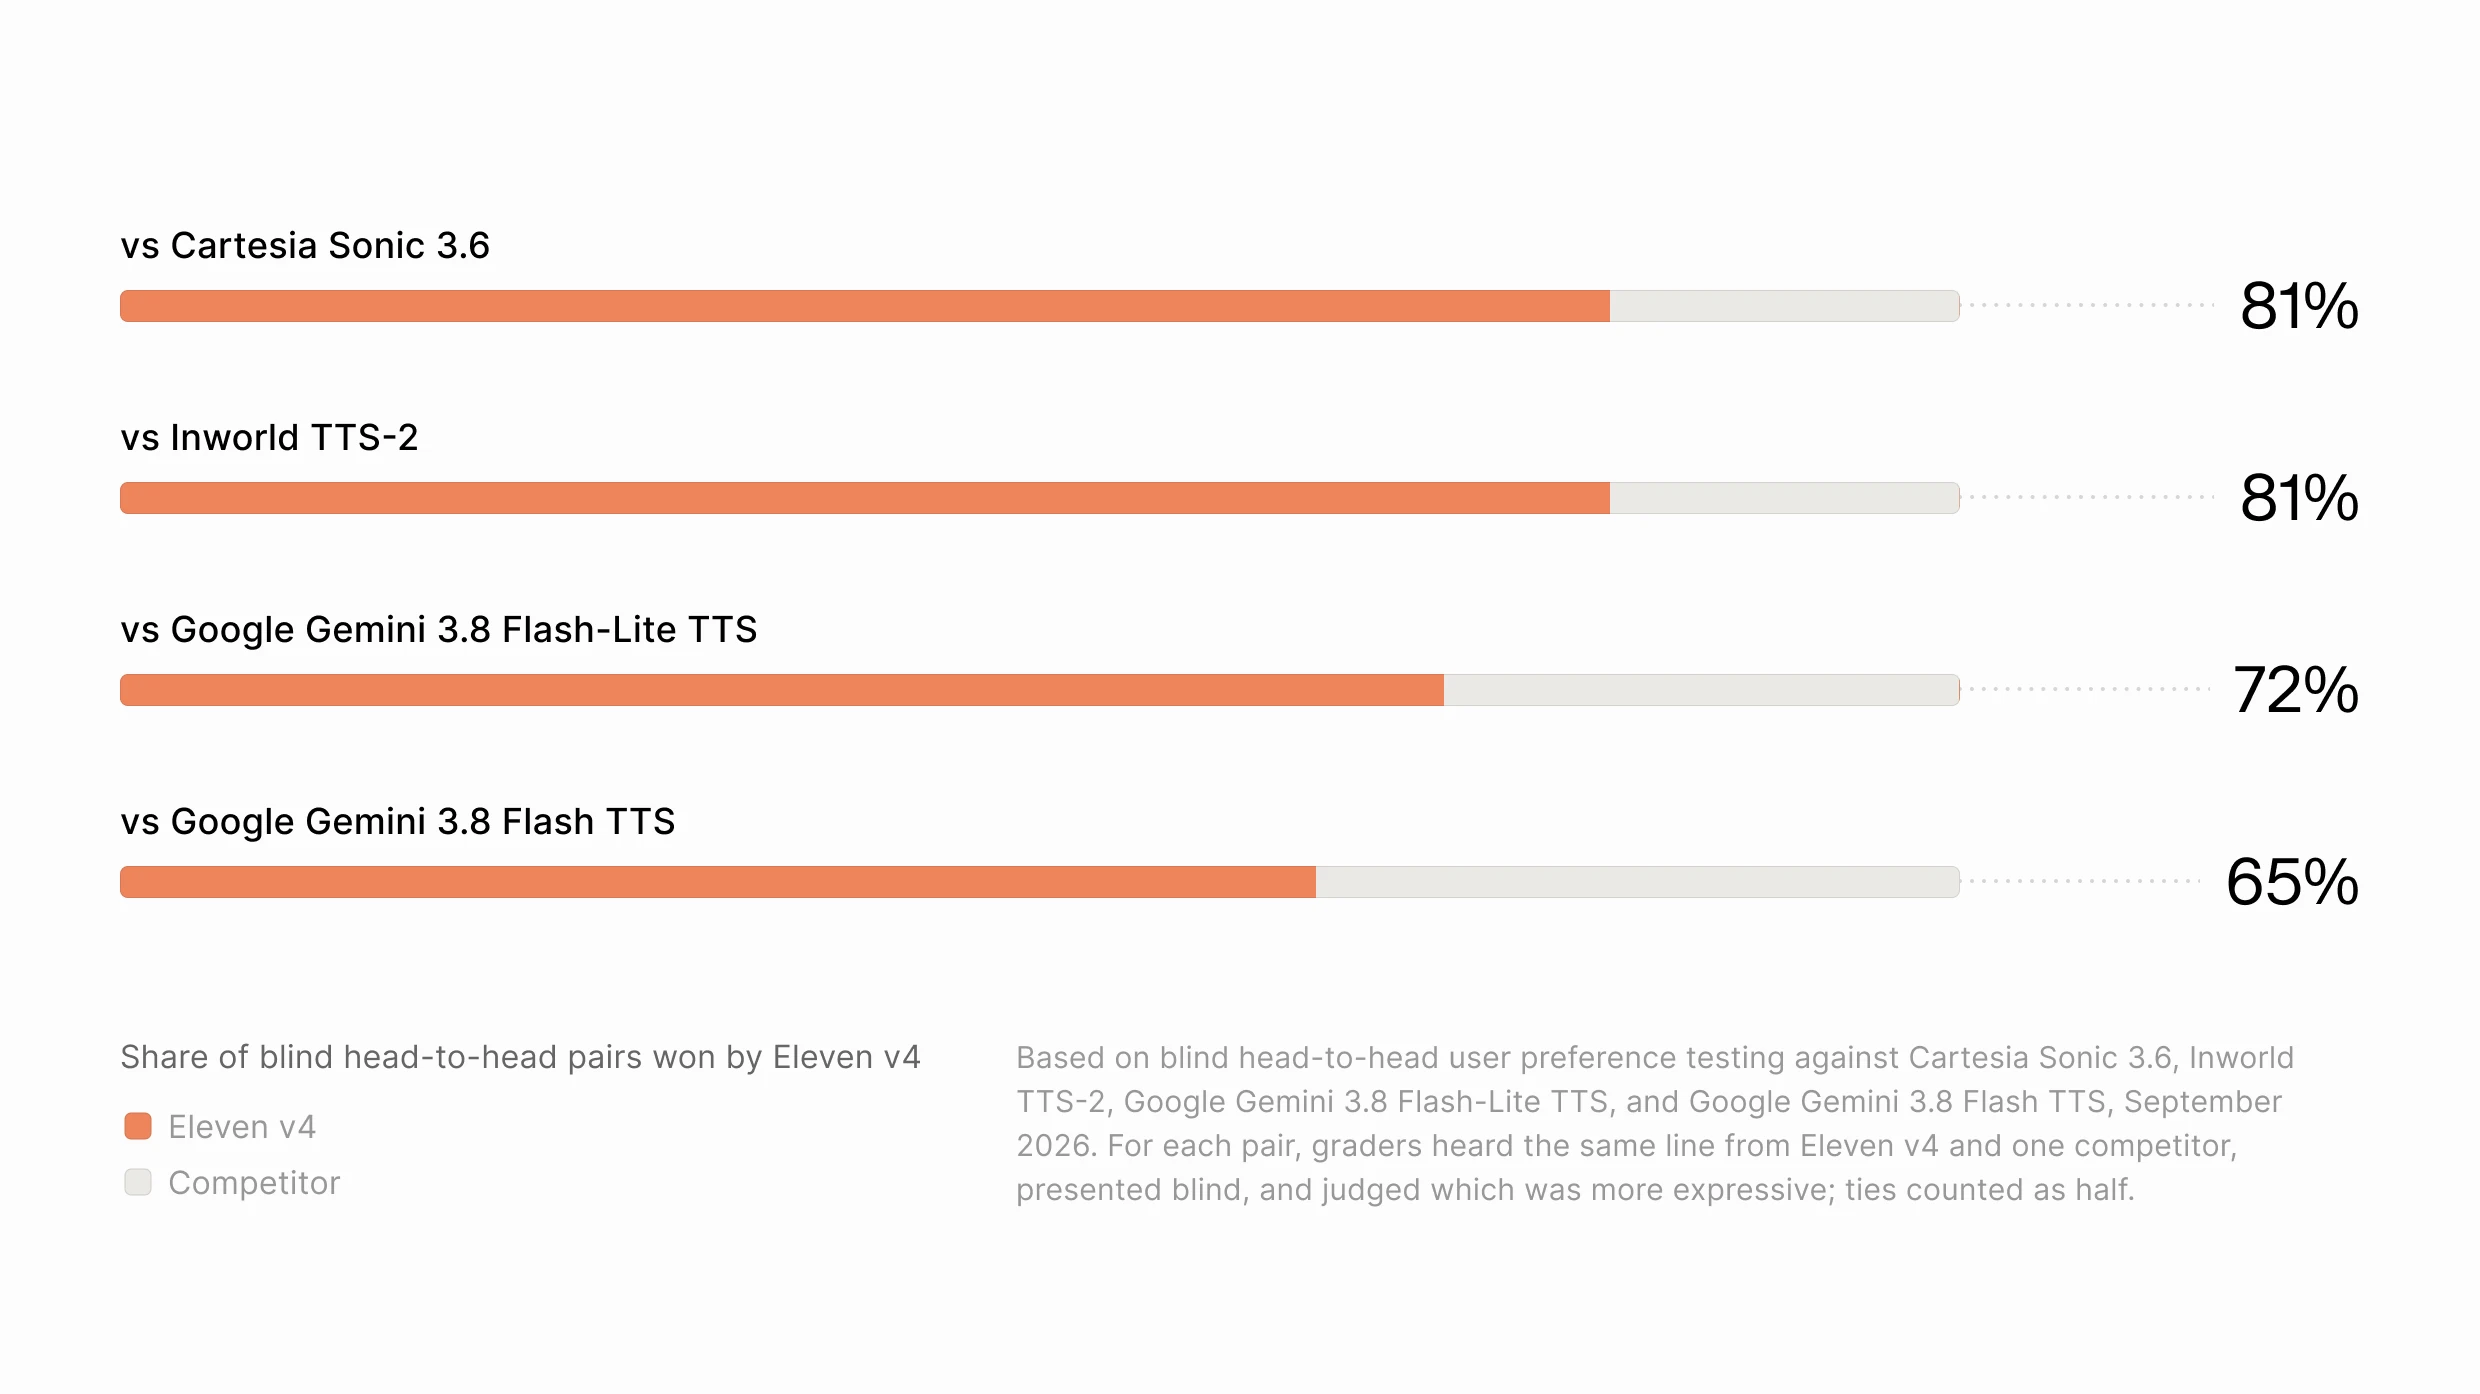
- 약 75% 선호 · 카르테시아 Sonic 3.6 81% · 인월드 TTS-2 81% · Gemini 3.8 Flash-Lite TTS 72% · Gemini 3.8 Flash TTS 65%
- Turbo 지연
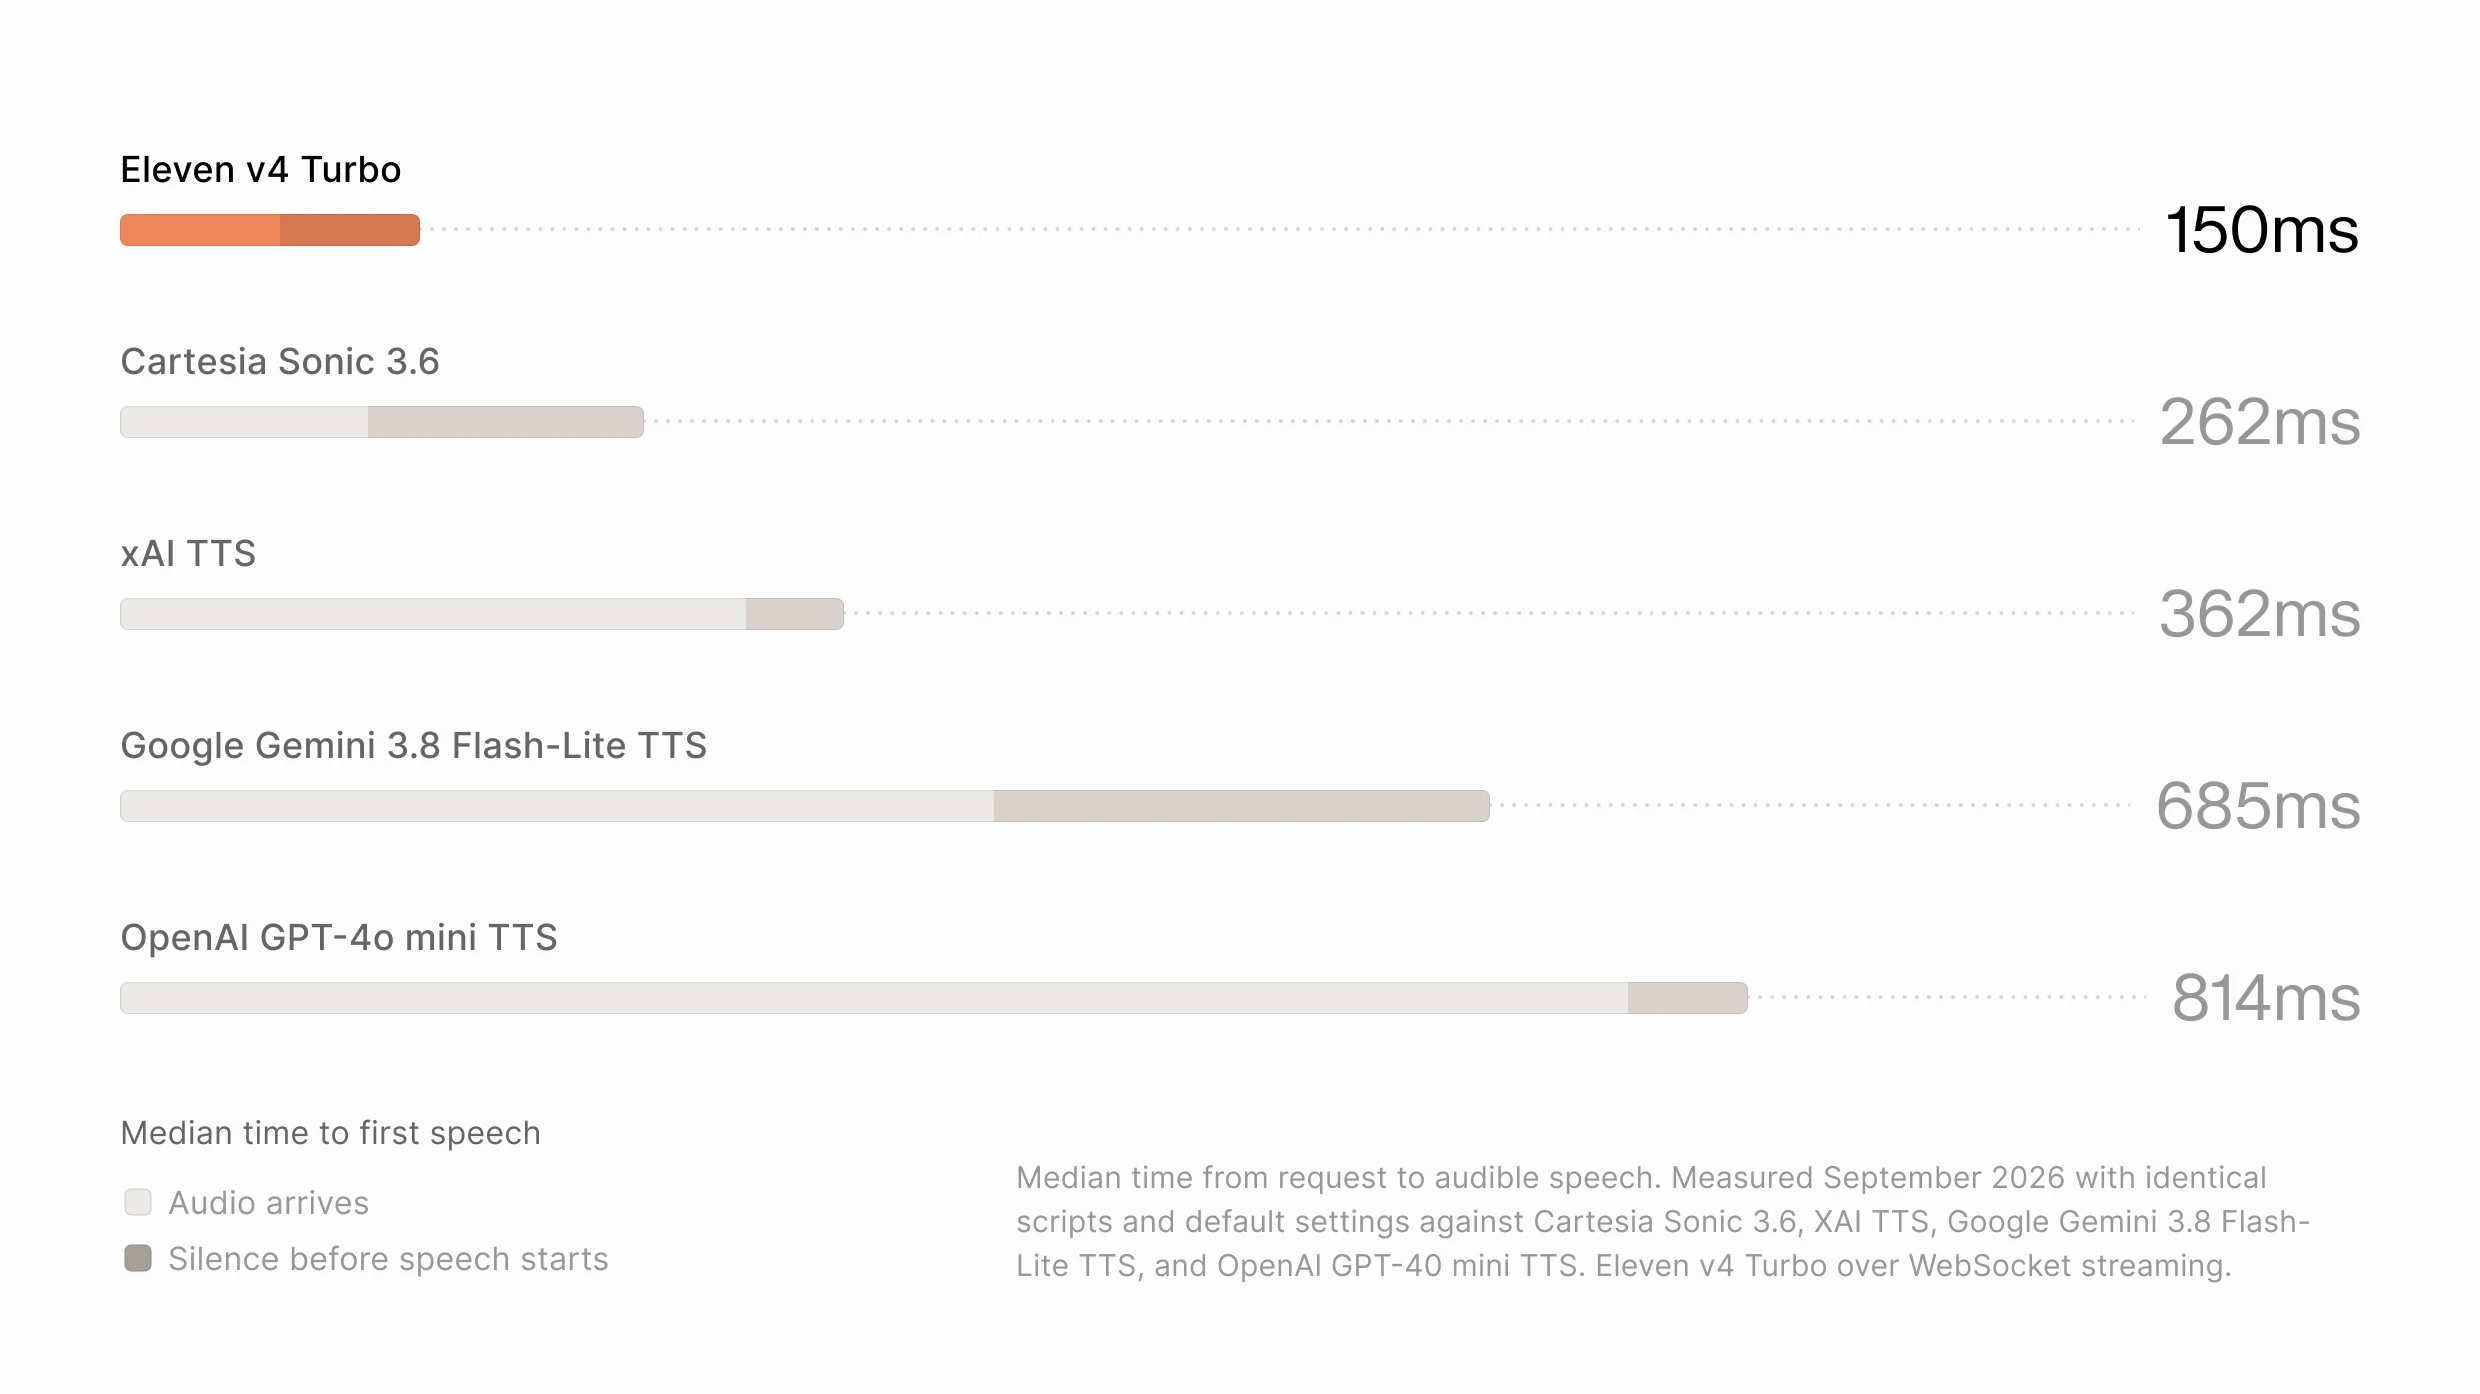
- 추론 중앙값 약 100밀리초 · 첫 음성 중앙값 약 150밀리초(비교: 262·362·685·814밀리초)
- 언어
- 90개 이상(이전 세대 70개) · 일본어·브라질 포르투갈어·표준 중국어·광둥어 개선 폭 최대
- 복제
- 인스턴트 보이스 클론 10초(회사 발표) · 프로페셔널 보이스 클론 재지원 · 보이스 라이브러리 1만7500개 이상
- 회사
- 보도에 따르면 대기업 매출 비중 55% 이상 · 연환산 매출 약 3억3000만→6억 달러 이상 · 기업가치 110억 달러 · 인력 800명 이상
일레븐랩스가 9월 28일 새 음성 모델 Eleven v4와 저지연 변형 Eleven v4 Turbo를 공개했다. 회사는 Eleven v4를 "지금까지 가장 감정 표현이 풍부한 텍스트 음성 변환 모델"이라고 소개했고, 두 모델 모두 90개 이상의 언어를 지원한다. 음성 모델 비교 사이트 아티피셜 애널리시스의 음성 순위표에서 1위에 올랐으며, 두 모델은 발표 당일부터 ElevenAgents와 ElevenCreative, ElevenAPI에서 쓸 수 있다.
Eleven v4는 완전히 새로운 아키텍처 위에 만들었다. 일레븐랩스는 이 모델이 대본을 성우처럼 읽는다고 설명했다. 누가 말하는지, 방금 무슨 일이 있었는지, 한 줄이 어떻게 떨어져야 하는지를 문맥에서 읽어 어조와 속도, 감정, 인물을 해석한다는 것이다. 여러 화자가 나오는 장면에서는 따로 만든 대사를 이어 붙이는 대신 앞사람의 말에 반응하는 대화를 만든다고 회사는 밝혔다.
수치로 내세운 근거는 두 가지다. 일레븐랩스가 9월 진행한 블라인드 일대일 선호도 시험에서 청취자들은 약 75%의 비율로 Eleven v4를 골랐다. 상대별로는 카르테시아 Sonic 3.6과 인월드 TTS-2를 상대로 각각 81%, 구글 Gemini 3.8 Flash-Lite TTS를 상대로 72%, Gemini 3.8 Flash TTS를 상대로 65%를 이겼다. 보도에 따르면 아티피셜 애널리시스 순위표에서 Eleven v4는 표본 1674개로 엘로 점수 1319를 받았다.
연출을 글로 적는 기능이 이번 판의 중심이다. 사용자는 대사 한 줄을 어떻게 읽을지 자연어로 설명하거나, [laughs], [said angrily in French accent], [light rain], [phone buzzing] 같은 인라인 태그를 대본에 끼워 감정과 효과음까지 지시한다. 태그를 여러 개 겹쳐 쓰면 모델이 그 순서를 따른다. 공식 제품 페이지는 v4가 v3보다 태그 순서를 더 안정적으로 따른다고 적었고, 사용자가 이름이나 약어의 발음을 직접 정하는 국제음성기호(IPA) 지원도 크게 손봤다. 메탈이 확인한 2분 36초 분량의 공식 시연 영상은 촬영장 감독과 배우의 대화, 뉴스 앵커의 비둘기 소동 보도, 약국 사전 승인 전화를 편집 없이 프롬프트만으로 만들었다고 밝힌다.
Eleven v4 Turbo는 실시간 대화를 위한 모델이다. 추론 지연 시간 중앙값은 약 100밀리초이고, 요청부터 소리가 들리기까지 걸리는 시간 중앙값은 약 150밀리초다. 일레븐랩스가 같은 대본과 기본 설정으로 잰 비교에서 카르테시아 Sonic 3.6은 262밀리초, xAI TTS는 362밀리초, 구글 Gemini 3.8 Flash-Lite TTS는 685밀리초, 오픈AI GPT-4o mini TTS는 814밀리초가 걸렸다. 회사는 이 속도가 대화하는 두 사람 사이의 평균적인 멈춤보다 빠르다고 설명했다. Turbo는 거대언어모델이 답을 만드는 도중부터 음성을 흘려보내는 양방향 스트리밍을 지원하고, 일레븐랩스의 에이전트 플랫폼 ElevenAgents와 한 시스템으로 함께 최적화했다.
고객사의 반응도 발표문에 실렸다. 세일즈포스의 라이언 피터슨 Agentforce Voice 제품 담당 수석부사장은 "Eleven v4 Turbo가 더 빠르고 자연스러운 응답으로 기준을 끌어올리고 있다"고 말했다. 신용 상품 기업 스프링 파이낸셜의 오스카 대니얼스 신용 구축 상품 책임자는 "Eleven v4 Turbo는 속도와 품질을 둘 다 잡은 첫 모델"이라며 "자동화된 영업 업무에서 구축이 더는 실험처럼 느껴지지 않는 지점"이라고 평가했다.
언어 폭도 넓어졌다. 보도에 따르면 이전 세대가 70개 언어를 지원했고 v4는 90개 이상으로 늘었으며, 품질이 가장 크게 오른 언어는 일본어와 브라질 포르투갈어, 표준 중국어, 광둥어다. 한 언어로 녹음한 목소리가 다른 언어를 말할 때는 원래 목소리의 정체성을 지키면서 그 언어 원어민의 억양을 따른다. 인스턴트 보이스 클론은 10초 분량의 음성만으로 목소리를 복제한다고 회사는 밝혔지만, 보도에 따르면 v4 개발 문서는 보통 1~2분 분량의 샘플을 쓴다고 적고 있다. v3에서 빠졌던 프로페셔널 보이스 클론도 다시 지원하며, 긴 원고를 여러 번에 나눠 생성해도 목소리가 흔들리지 않게 이어 붙이는 기능도 개선했다.
AI 엔지니어의 눈으로 보면 이번 발표의 핵심은 표현력과 속도를 하나의 아키텍처에서 나눠 낸 설계다. 일레븐랩스는 고품질 음성 모델이 느려서 기업들이 빠르지만 단조로운 에이전트를 택해 왔다고 짚었다. 같은 기술을 창작용 v4와 실시간용 Turbo로 나누고, 에이전트 플랫폼까지 한 몸으로 조율한 것은 모델만 파는 경쟁사와 선을 긋는 방식이다. 보이스 라이브러리에 쌓인 1만7500개 이상의 목소리가 두 모델에서 그대로 쓰인다는 점도 전환 비용을 낮춘다.
사업의 무게중심도 이 방향으로 옮겨 가고 있다. 보도에 따르면 일레븐랩스 매출의 55% 이상이 대기업에서 나오고, 연환산 매출은 연초 약 3억3000만 달러에서 6억 달러 이상으로 늘었다. 회사는 올해 초 세쿼이아가 이끈 5억 달러 투자를 받으며 기업가치 110억 달러를 인정받았고, 인력은 800명을 넘었다. 공동창업자인 마티 스타니셰프스키 CEO는 기업공개를 "앞으로 몇 년 안에" 하겠다면서도 시점은 정하지 않았다고 보도는 전했다. 메탈은 일레븐랩스가 실시간 대화용 음성 모델 v3 Conversational을 정식 출시한 소식을 보도한 바 있다.
카르테시아와 딥그램 같은 스타트업, 구글과 오픈AI 같은 대형 기업이 모두 표현력 있는 음성 모델을 내놓는 가운데 일레븐랩스는 순위표 1위와 150밀리초라는 두 숫자로 답했다. 사람의 목소리를 흉내 내는 단계를 지나 대본을 연기하는 단계로 넘어갔다는 것이 회사의 주장이고, 그 주장은 이제 고객센터 통화와 오디오북, 게임 대사 같은 실제 현장에서 검증받는다.
출처
- ElevenLabs — Eleven v4: Our most expressive text-to-speech AI model yet →
- ElevenLabs — Eleven v4 and Eleven v4 Turbo Text to Speech models →
- TechCrunch — ElevenLabs' new v4 speech model supports more expression control and 90 languages →
- RuntimeWire — ElevenLabs ships v4 voice models, ranked No. 1 by Artificial Analysis →


댓글