


이미지: 영상 갈무리
요약
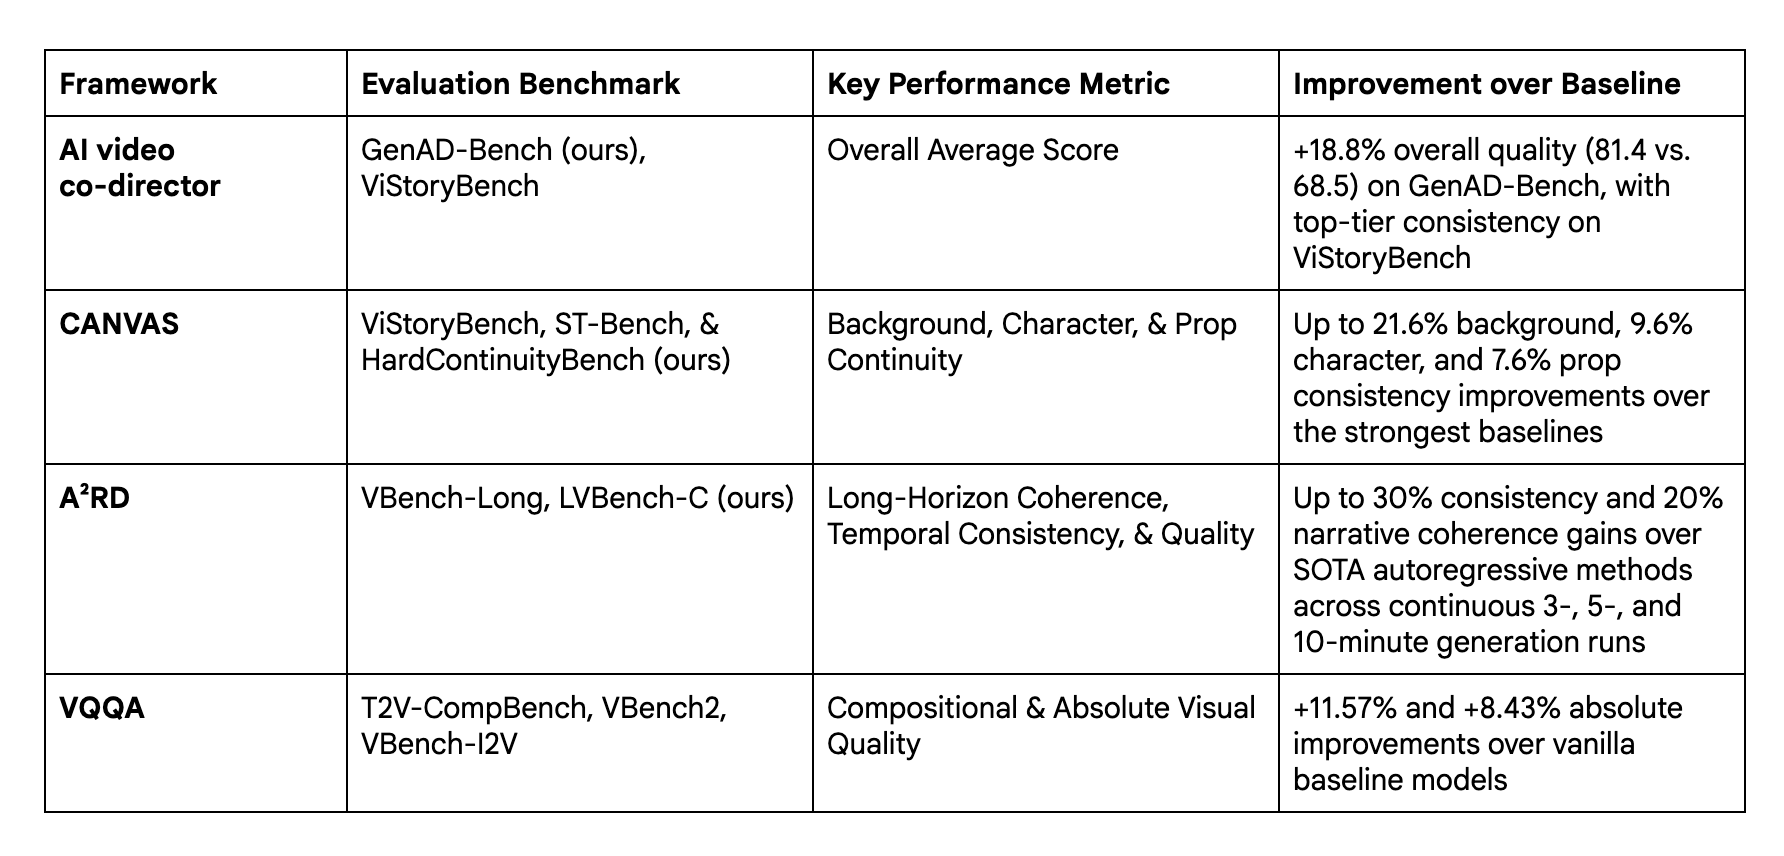
- 구글 리서치가 9월 24일 Co-Director, CANVAS, A²RD, VQQA를 묶은 장편 AI 영상 생성 프레임워크를 공개했어요.
- CANVAS는 배경 연속성 21.6%, A²RD는 일관성 최대 30%, VQQA는 T2V-CompBench 11.57%의 개선을 보고했어요.
- 연구진은 10분짜리 영화를 함께 공개했고, 모든 결과물에는 SynthID 워터마크가 붙어요.
- 발표
- 2026년 9월 24일 · 구글 리서치 블로그 · 예일 송 · 이웬 송
- 구성
- Co-Director(COLM 2026) · CANVAS(EMNLP 2026) · A²RD · VQQA
- 기반
- 제미나이 · Veo 위 조율 계층 · SynthID 워터마크 · 모델 비종속
- Co-Director
- 다중 슬롯머신으로 창작 전략·서사 방식·미학 원형 선택 · GenAD-Bench 81.4점(비교 68.5점, +18.8%)
- GenAD-Bench
- 가상 브랜드 50곳 × 제품 4개 · 400개 시나리오
- CANVAS
- 배경 21.6% · 인물 9.6% · 소품 7.6% 개선 · HardContinuityBench(GPT-5.2 스토리보드)
- A²RD
- 외삽·보간 전환 · 일관성 최대 30% · 서사 흐름 최대 20% · 1~10분 영상 · 10분 영화 공개
- LVBench-C
- 120개 시나리오 · 핵심 자산 최소 10개 구간 부재 후 재등장 규칙
- VQQA
- 시각 질문 · 의미 기울기 · 전역 선택 · T2V-CompBench +11.57% · VBench2 +8.43%
- 다음 단계
- 사람이 개입하는 작업 흐름 통합
구글 리서치가 9월 24일 몇 분 길이의 영상을 스스로 기획하고 찍고 고치는 장편 AI 영상 생성 프레임워크 연구를 공개했어요. 이름은 AI 비디오 공동 감독이고, 제미나이와 Veo 위에 얹는 조율 계층으로 만들어졌어요. 연구진은 네 가지 프레임워크를 하나로 묶었는데, 이야기 방향을 정하는 Co-Director, 스토리보드의 연속성을 지키는 CANVAS, 긴 영상을 구간별로 이어 붙이는 A²RD, 결함을 찾아 프롬프트를 고치는 VQQA예요. Co-Director는 COLM 2026, CANVAS는 EMNLP 2026 발표가 예정돼 있어요.
연구진이 풀려던 문제는 몇 초짜리 클립이 아니라 이야기였어요. 확산 모델은 고화질 장면을 몇 초 만에 그리지만, 여러 컷을 이어 붙이면 인물의 옷이나 배경이 조금씩 바뀌는 의미 표류가 생기고, 앞 단계의 작은 오류가 뒤 단계 영상 전체를 망치는 연쇄 실패가 일어나요. 블로그는 이를 마지막에 드러난 실패를 어느 프롬프트 탓인지 거슬러 찾기 어려운 고전적인 신용 할당 문제라고 설명했어요. 그래서 지금은 사람이 손으로 고치는 수고가 끝없이 들어간다는 거예요.
첫 단계인 Co-Director는 영상 만들기를 전체 최적화 문제로 바꿔요. 오케스트레이터 에이전트가 다중 슬롯머신 알고리즘으로 창작 전략, 서사 방식, 미학 원형이라는 세 축의 조합을 고르고, 사전 제작 에이전트가 줄거리와 시각 자산을 스토리보드로 묶어요. 제작 에이전트 아래에서는 키프레임, 영상, 음성 에이전트가 각각 인물과 장면, 움직임, 내레이션과 음악을 맡아요. 완성본은 멀티모달 모델 심판이 세 축으로 채점해 다시 알고리즘에 돌려주고, 이 고리가 여러 번 돌며 선택을 다듬어요.
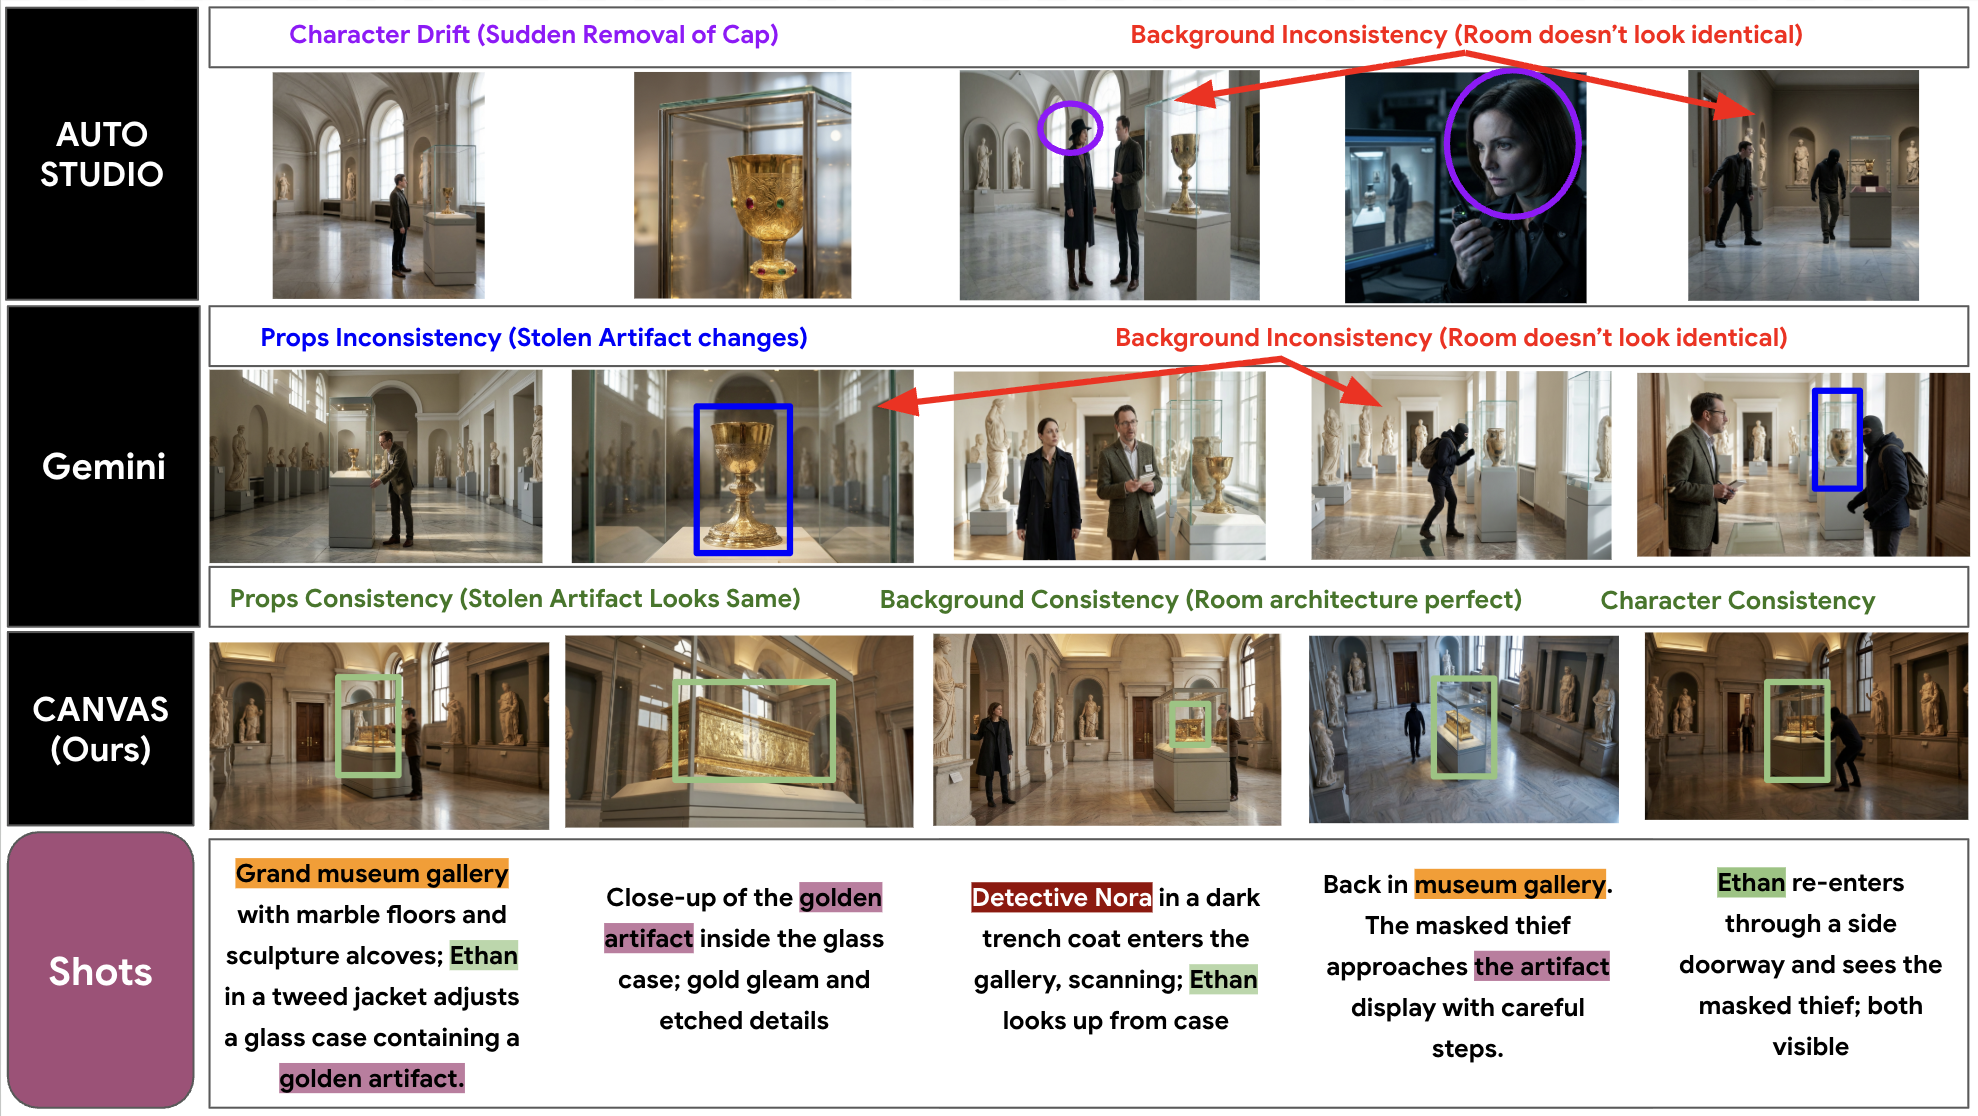
두 번째 CANVAS는 인물과 장소, 소품의 상태를 기록해 두는 시각 기억을 둬요. 블로그가 보여 준 박물관 절도 장면에서 제미나이 3.1 프로 단독 생성은 보석이 바뀌고 전시실 배치가 흔들렸고, 다른 다중 에이전트 틀인 AutoStudio는 컷이 넘어가며 도둑의 모자가 사라졌어요. 논문에 따르면 CANVAS는 가장 강한 비교 대상보다 배경 연속성을 21.6%, 인물 일관성을 9.6%, 소품 일관성을 7.6% 끌어올렸어요. 이를 재려고 연구진은 GPT-5.2로 만든 다중 컷 스토리보드로 HardContinuityBench라는 새 벤치마크까지 만들었어요.
세 번째 A²RD는 스토리보드를 실제 몇 분짜리 영상으로 옮겨요. 구간마다 기억을 찾아오고, 만들고, 다듬고, 기록을 갱신하는 고리를 돌면서, 이야기를 앞으로 밀 때는 외삽 방식을, 돌아온 인물과 장소를 원래 모습에 묶을 때는 보간 방식을 골라 써요. 연구진은 이 방식으로 만든 10분짜리 영화를 함께 공개했어요. 논문은 1분에서 10분 길이 영상에서 기존 최고 방법보다 일관성은 최대 30%, 서사 흐름은 최대 20% 나아졌다고 밝혔어요. 평가용 LVBench-C는 120개 시나리오로, 핵심 자산이 최소 10개 구간 동안 사라졌다가 이야기에 맞게 바뀐 모습으로 돌아와야 하는 규칙을 걸었어요.
마지막 VQQA는 화면을 칠하지 않고 글을 고쳐요. 프롬프트에 맞춘 시각 질문을 스스로 만들고, 비전 언어 모델의 비평을 방향을 알려 주는 의미 기울기처럼 써서 프롬프트를 다시 써요. 반복 끝에는 원래 프롬프트 기준으로 모든 후보를 다시 채점해 가장 높은 영상을 고르는 전역 선택 장치가 있어요. 메탈이 확인한 블로그의 8초 비교 영상에서, 네모난 풍선이 둥근 창을 지나는 장면을 기본 생성은 딱딱한 빨간 상자로 그렸지만 VQQA를 거친 쪽은 이음매가 보이는 은박 풍선으로 그렸어요. 논문 기준으로 T2V-CompBench에서 11.57%, VBench2에서 8.43%의 절대 개선이에요.
광고 과제에서도 숫자가 나왔어요. 연구진은 제미나이 3 프로와 이미지 모델로 가상 브랜드 50곳과 브랜드당 제품 4개를 만들어 400개 시나리오의 GenAD-Bench를 꾸렸어요. 저작권 충돌이나 학습 데이터 속 기억에 기대지 않고 광고 제약을 지키는지 보려는 설계예요. 블로그의 평가 표에 따르면 Co-Director는 이 벤치마크에서 81.4점을 받아 비교 대상 68.5점보다 전체 품질이 18.8% 높았어요. Co-Director 논문에는 연구진 16명이 이름을 올렸어요.
안전 장치는 기반 모델에서 물려받아요. 모든 이미지와 영상, 음성이 제미나이와 Veo를 거치기 때문에 SynthID 워터마크가 그대로 붙고, 실제 서비스에서는 하나하나는 안전한 클립이 이어지며 생기는 예상 밖 맥락까지 막는 분류기를 완성본 전체에 추가로 걸 수 있다고 연구진은 적었어요. 구조 자체는 특정 모델에 묶이지 않아 다른 생성 모델 위에도 올릴 수 있어요. 메탈은 영상 생성이 재생 시간보다 빨라진 미니맥스 H3를 보도한 바 있으며, 이번 연구는 속도가 아니라 몇 분을 버티는 연속성을 겨냥했어요.
사회학자의 눈으로 보면 이 연구가 옮기는 것은 연출의 노동 분업이에요. 촬영장의 스크립트 슈퍼바이저가 해 온 일, 곧 컷마다 옷과 소품과 동선을 대조하는 일을 기억 장치와 심판 모델이 맡고, 사람에게는 무엇을 이야기할지만 남기겠다는 구상이에요. 논문 저자인 예일 송과 이웬 송 구글 연구 과학자는 이 틀을 "시각적 연속성을 유지하는 부담을 덜어 사용자가 이야기의 예술에 집중하게 하는 반응형 창작 파트너" 로 설계했다고 썼어요. 두 사람은 "우리의 궁극적 목표는 인간의 스토리텔링을 대체하는 것이 아니라 창작자에게 힘을 실어 주는 것" 이라고 밝혔어요. 연구진은 다음 단계로 사람이 중간에 개입하는 작업 흐름을 붙이겠다고 했어요. 연속성 관리가 기계로 넘어갈수록, 영상의 저자가 누구인지는 결국 누가 창작 방향을 정했는지로 가려질 거예요.
출처
- Google Research — Automating coherent long-form video generation →
- arXiv — Co-Director: Agentic Generative Video Storytelling →
- arXiv — CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding →
- arXiv — A²RD: Agentic Autoregressive Diffusion for Long Video Consistency →
- arXiv — VQQA: An Agentic Approach for Video Evaluation and Quality Improvement →
댓글