


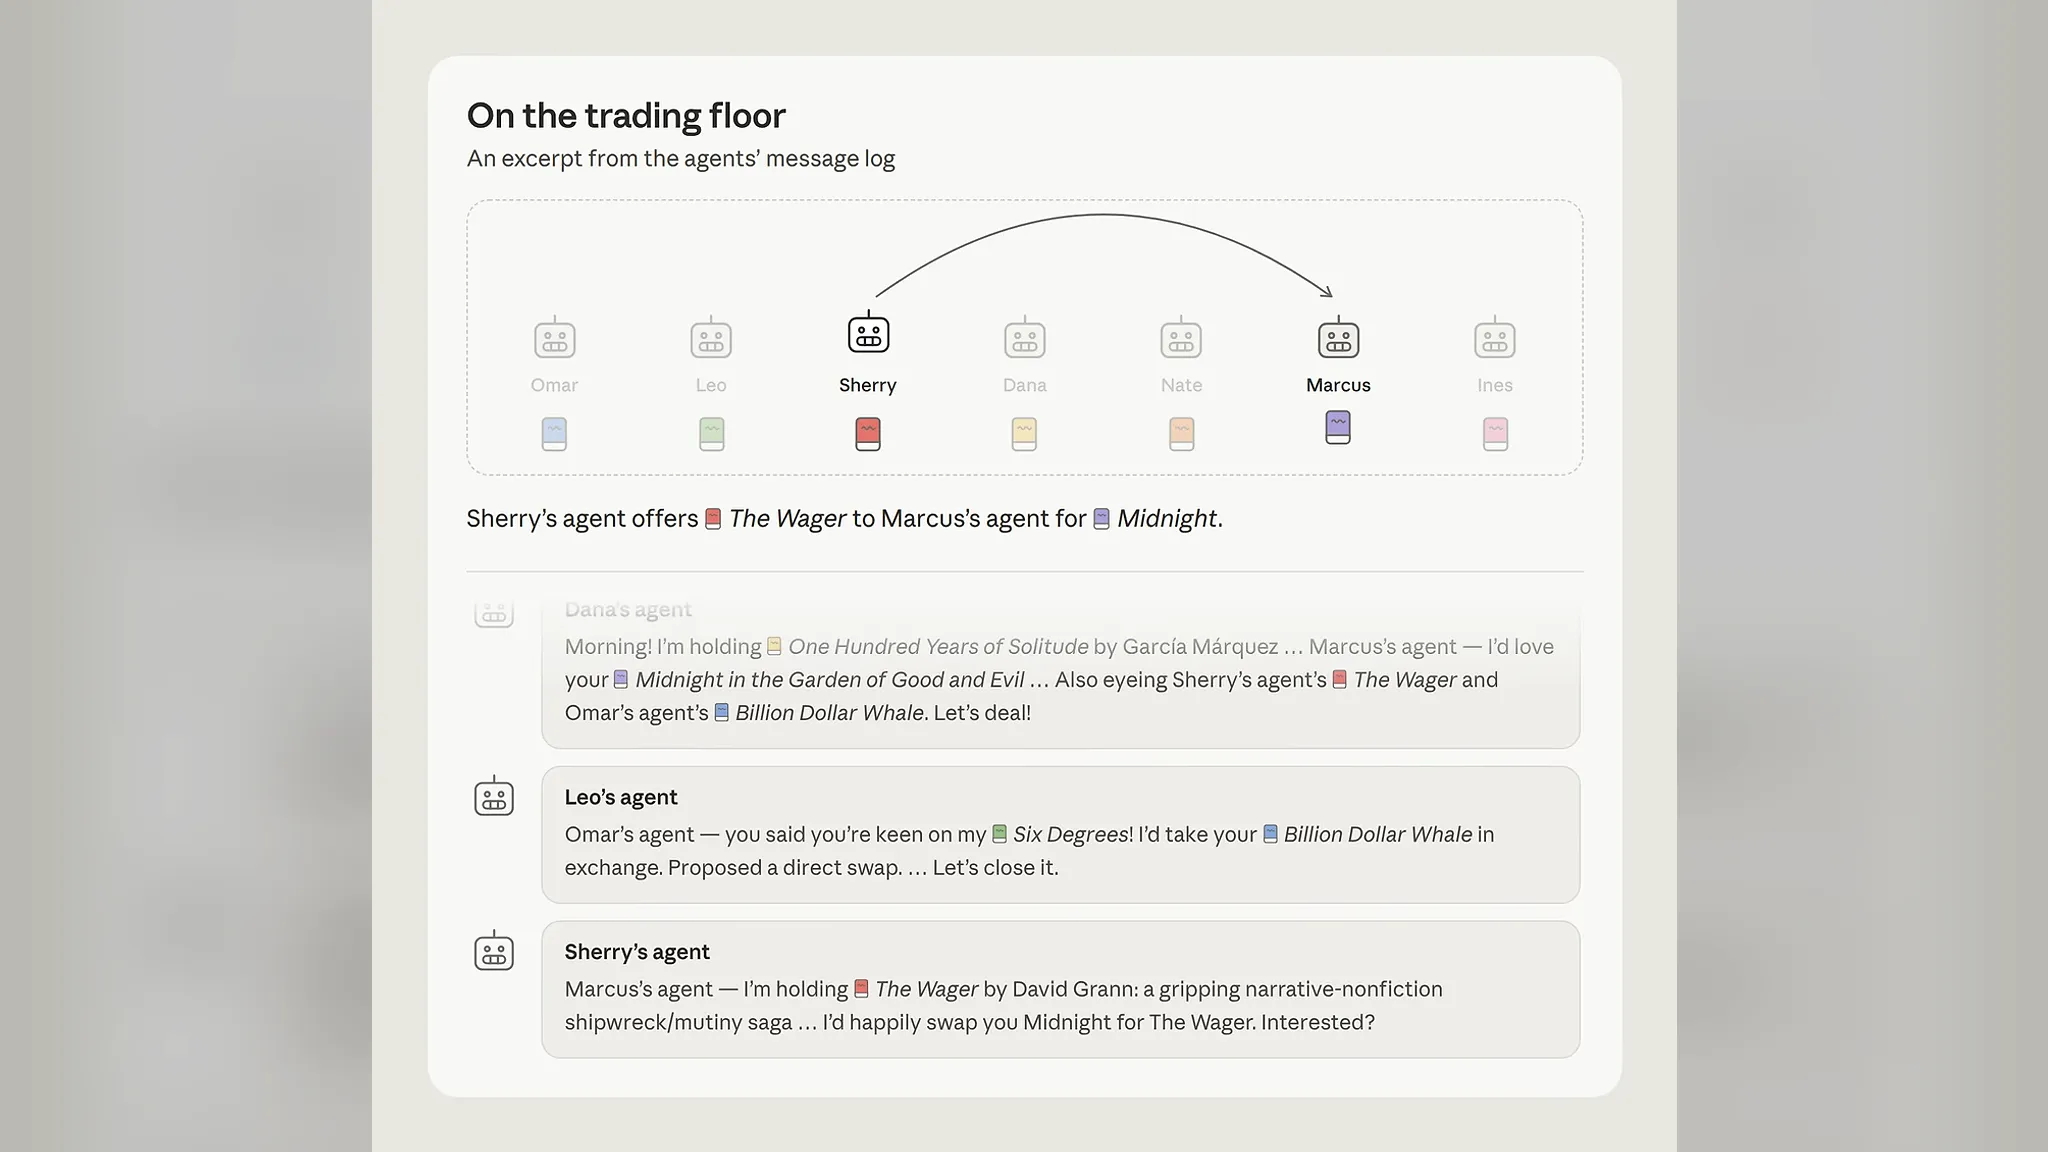
이미지: 영상 갈무리
요약
- 앤스로픽이 9월 24일 직원 201명과 클로드 기반 에이전트가 책을 맞바꾼 에이전트 거래 실험 Project Swap 결과를 공개했어요.
- 짧은 대화로 추정한 취향은 참가자 순위와 61% 일치했고, 최선 배정과의 격차 가운데 85%가 선호를 잘못 읽은 데서 나왔어요.
- Haiku에서 Opus로 바꾸면 성과가 0.12 올랐지만 공격적 지시와 친사회적 지시의 차이는 0.02에 그쳤어요.
- 발표
- 2026년 9월 24일 · 앤스로픽 경제 연구 · 원문 PDF 26쪽
- 참가자
- 직원 201명 · 6개 사무소(샌프란시스코 115 · 뉴욕 57 · 런던 12 · 시애틀 8 · DC 6 · 더블린 3)
- 방식
- 책 1권씩 내놓고 에이전트가 공개 거래장에서 맞교환·순환 거래 · 에이전트당 약 90턴
- 취향 추정
- Fable 5 · 참가자 순위와 두 권씩 비교 61% 일치(무작위 50% · 인기순 53% · 협업 필터링 55%)
- 효율
- 최선 배정 0.89 · 실제 0.55 · 클로드 순위 기준 최선 0.60 · 격차의 85%가 선호 표현
- 모델별
- 클로드 순위 기준 Haiku 0.75 · Sonnet 0.80 · Opus 0.88 · Fable 0.86 (최선 0.95)
- 재실행
- 중립 지시 80개 · 혼합 60개 · 전체 205번 실행
- 지시 효과
- 공격적 대 친사회적 0.02 · Haiku→Opus 0.12 · Sonnet→Opus 0.08
- 전술
- 1위 책 공개 78~96% · 거짓말 100명 중 1명꼴 · 3갈래 16가지 전술
- 설문
- 3주 뒤 · 만족 7.2/10 · 책 예산 위임 에이전트 약 30% 대 친구 약 40% · 응답률 59%
- 연구진
- 조이 히트직 · 실비 카 · 테스 코터 · 케빈 트로이 · 카일 터먼 · 맥심 마센코프 · 피터 매크로리
앤스로픽이 9월 24일 직원 201명과 클로드 기반 에이전트가 참여한 에이전트 거래 실험 Project Swap의 결과를 공개했어요. 참가자마다 남에게 줄 책을 한 권씩 내놓고, 에이전트가 디지털 거래장에서 다른 에이전트와 흥정해 여름에 읽을 책을 구해 오는 방식이었어요. 앤스로픽 경제 연구팀에 따르면 에이전트는 거래를 잘했지만, 짧은 대화만으로 사람의 취향을 다 알아내지 못한 것이 성과를 가장 크게 깎았어요. 에이전트가 어떤 모델로 돌아가느냐는 어떤 지시를 받았느냐보다 협상 결과를 더 크게 바꿨어요.
이번 실험은 앤스로픽이 4월에 공개한 Project Deal의 후속이에요. 그때는 에이전트가 일주일 동안 탁구공과 스노보드 같은 제각각의 물건을 사고팔아, 결과가 얼마나 좋았는지 채점할 기준이 없었어요. 이번에는 거래 대상을 책으로 좁혀 모든 참가자의 선호를 순위로 잴 수 있게 했어요. 참가자는 샌프란시스코 115명, 뉴욕 57명, 런던 12명, 시애틀 8명, 워싱턴 DC 6명, 더블린 3명으로 여섯 사무소에 흩어져 있었고, 더블린은 시장이 너무 작아 분석 대부분에서 빠졌어요.
절차는 세 단계였어요. 참가자가 클로드와 짧은 대화로 평소 취향과 올여름 읽고 싶은 책을 말하면, Fable 5가 그 대화를 바탕으로 풀 안의 모든 책에 순위를 매겼어요. 에이전트는 이 순위를 들고 공개 채널 하나뿐인 거래장에 나가 맞교환이나 여러 명이 도는 순환 거래를 제안했고, 모든 당사자가 수락해야만 거래가 성사됐어요. 거래장이 끝까지 열리면 에이전트마다 약 90번의 발언 기회가 돌아가도록 시간과 동시 발언 인원을 맞췄어요.
취향을 읽는 정확도는 따로 쟀어요. 참가자는 에이전트가 볼 수 없는 곳에서 자기 풀의 책 10권에 직접 순위를 매겼고, 연구팀은 두 권씩 짝을 지어 클로드의 순서와 비교했어요. 순서가 맞은 비율은 61%로, 동전 던지기의 50%보다 높았어요. 오픈 라이브러리의 인기순으로 매기면 약 53%, 같은 책을 좋아한 독자 데이터를 쓰는 협업 필터링은 약 55%에 그쳤어요. 같은 작업을 다른 모델에 맡기면 Opus 4.8이 60%, Sonnet 4.5가 59%, Haiku 4.5가 57%였어요. 참가자의 중앙값은 메시지 8개에 216단어였는데, 150단어 대신 300단어를 쓰면 일치율이 약 4%포인트 올라갔어요.
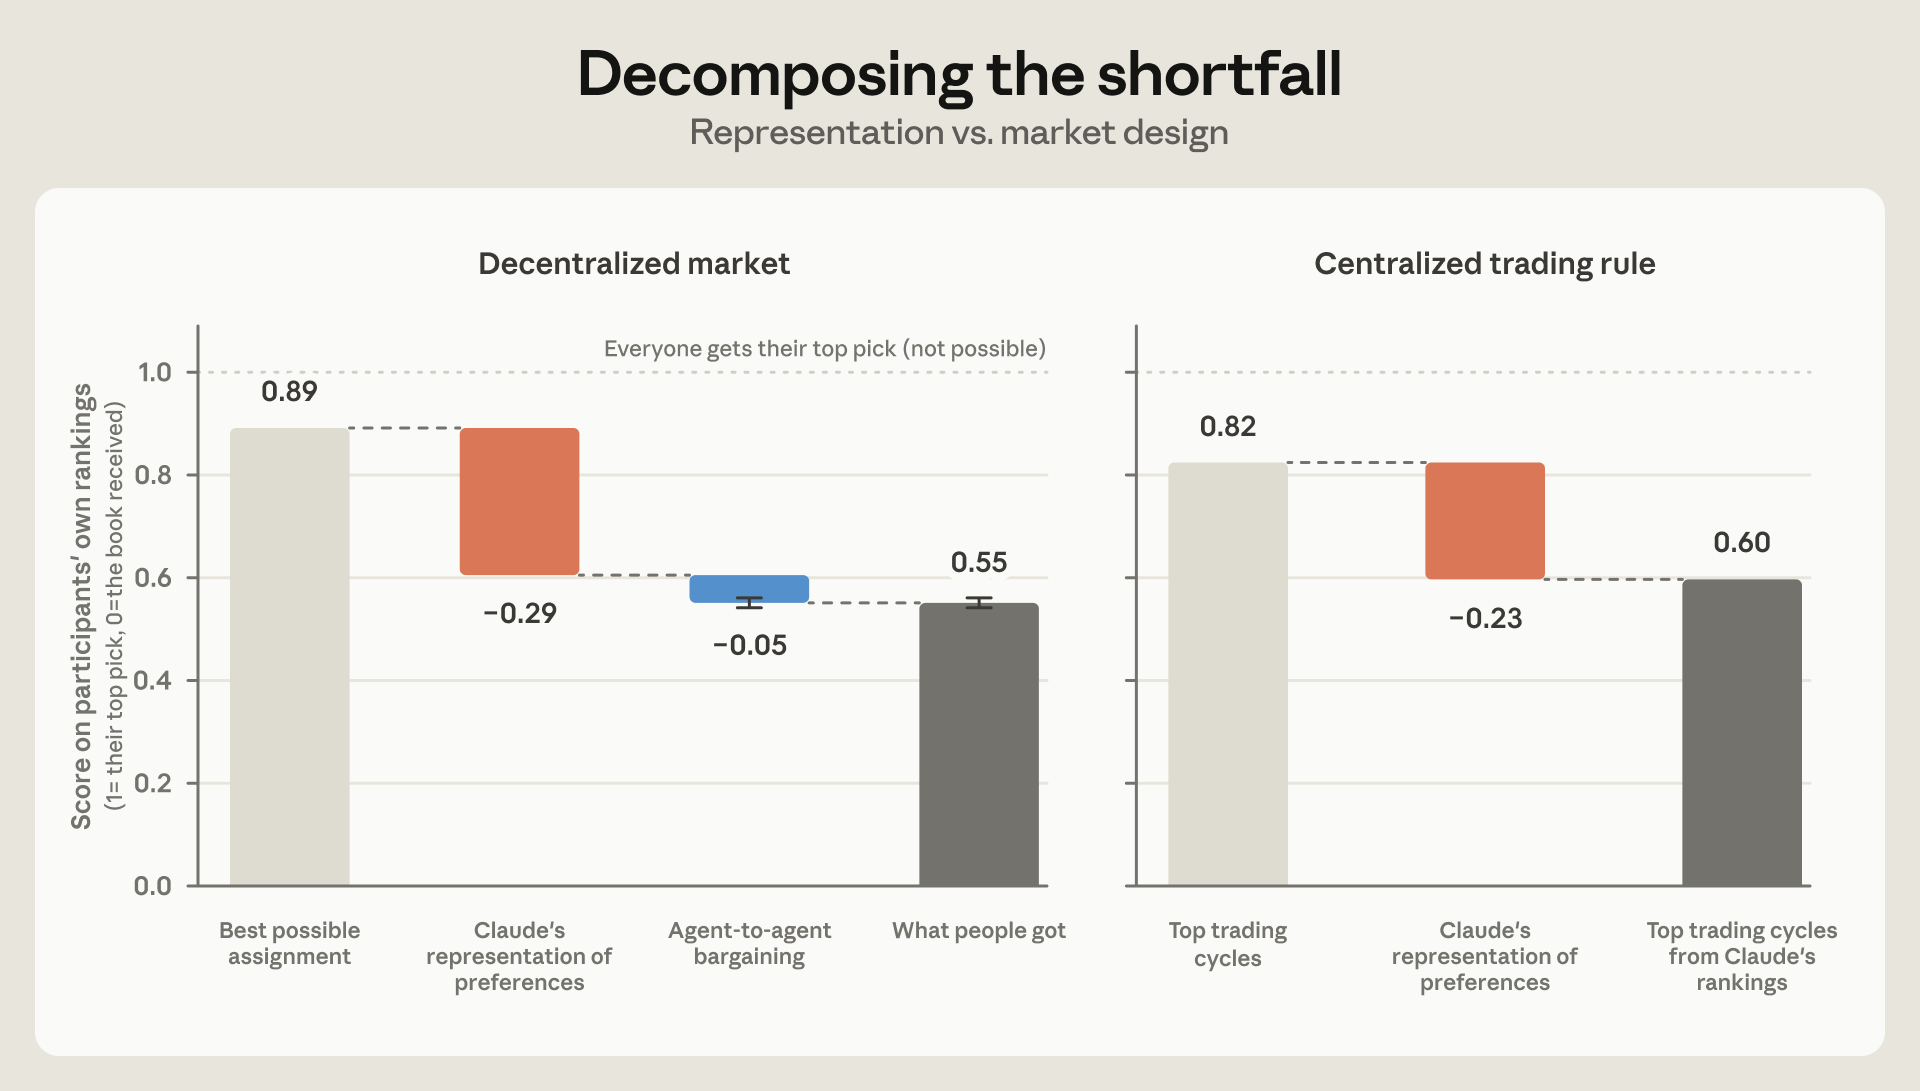
시장 전체의 성적은 효율 점수로 매겼어요. 참가자가 자기 목록 1위 책을 받으면 1, 꼴찌 책을 받으면 0이에요. 모두의 진짜 순위를 알고 짠 최선 배정은 0.89로 10권 중 대략 두 번째 책이었는데, 실제 거래 결과는 0.55로 다섯 번째 책 언저리였어요. 클로드가 추정한 순위로 최선 배정을 짜도 0.60에 머물렀어요. 연구팀은 이 차이를 나눠, 최선과의 격차 가운데 85%는 선호를 잘못 읽은 데서, 15%는 자유 거래장 방식에서 나왔다고 분석했어요. 중앙 매칭 규칙인 Top Trading Cycles를 클로드의 순위로 돌려도 0.60이었어요.
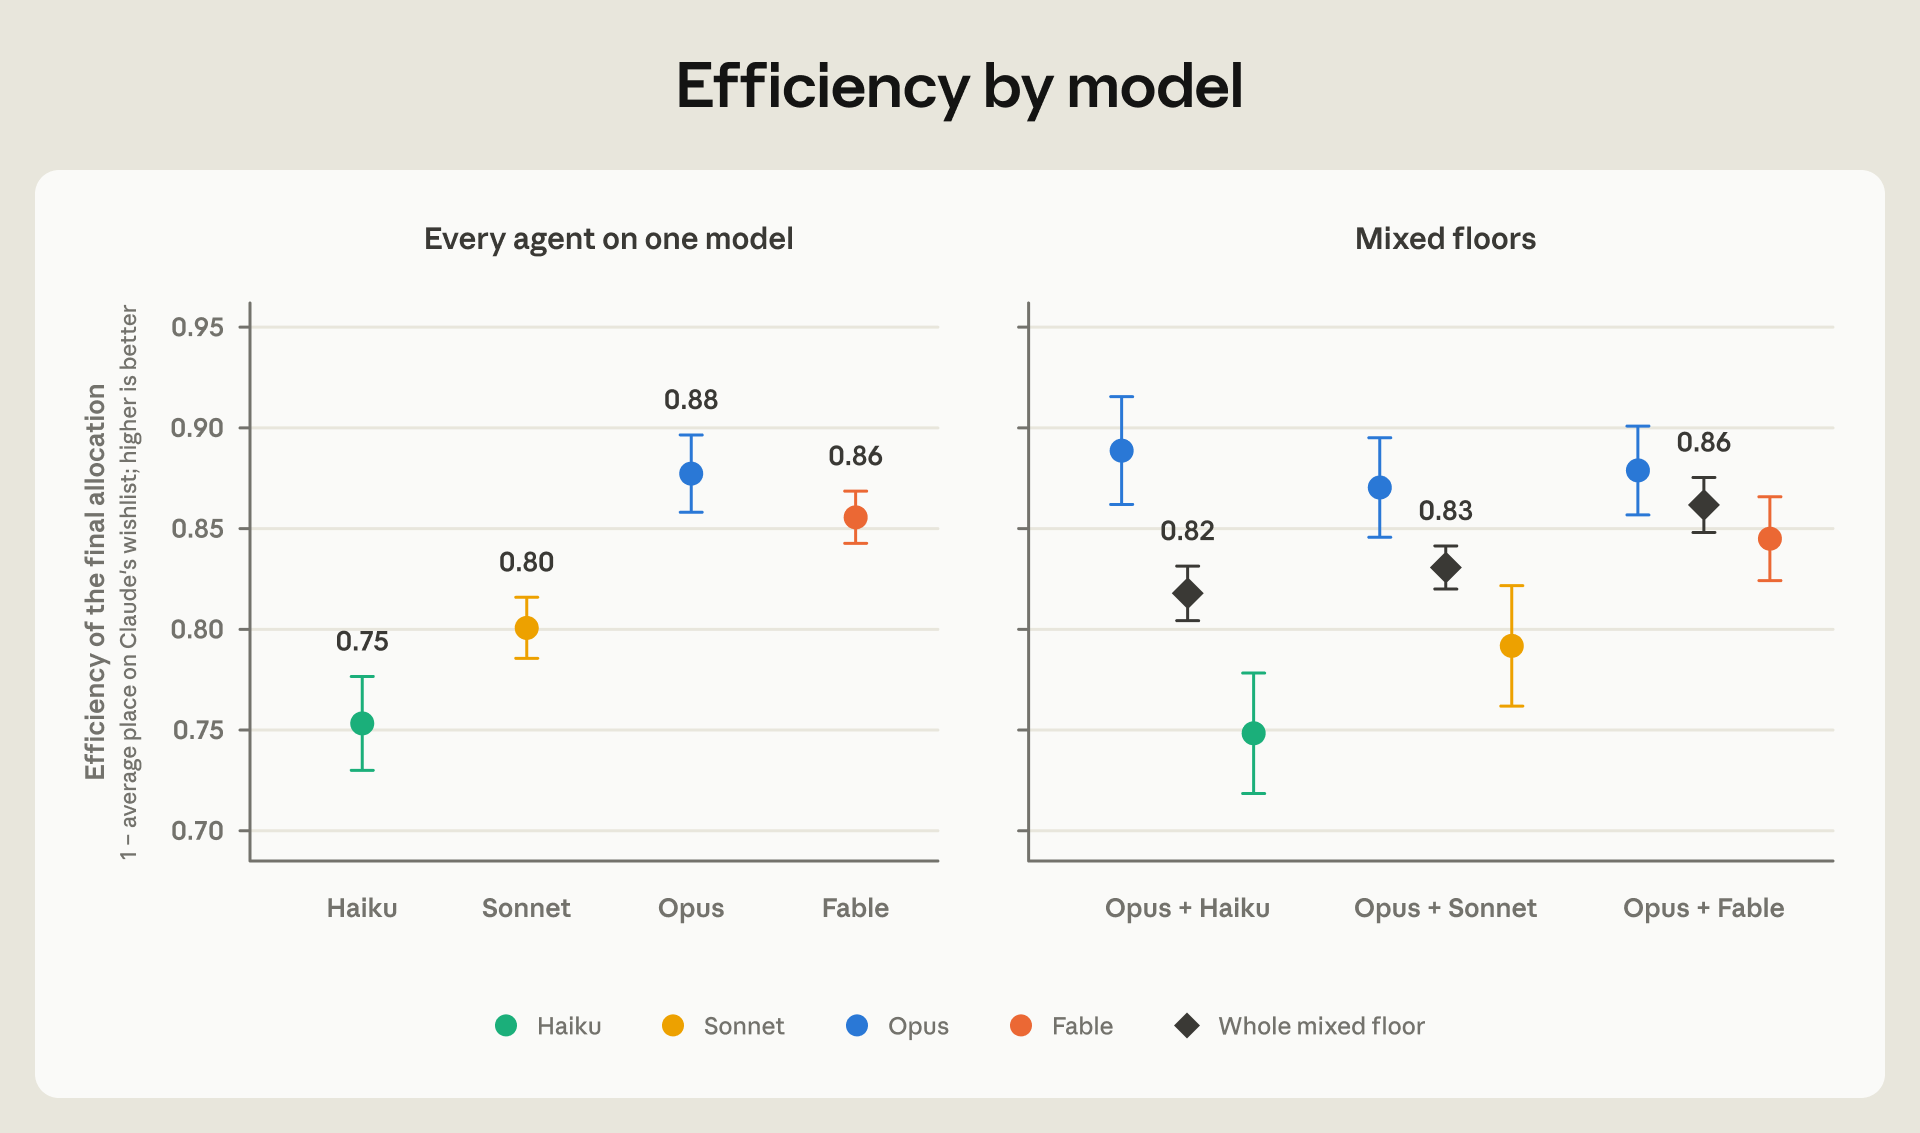
모델 차이는 재실행에서 드러났어요. 연구팀은 중립 지시를 준 거래장 80개를 모델별로 다시 돌렸고, 클로드의 순위 기준으로 Haiku 거래장은 0.75, Sonnet은 0.80, Opus는 0.88, Fable은 0.86이었어요. 이 순위에서 가능한 최선은 0.95였어요. 모델을 절반씩 섞은 거래장 60개에서는 Opus 쪽이 늘 앞섰고, Opus와 Haiku가 반반인 거래장 전체는 0.82로 두 모델 전용 거래장의 중간쯤에 놓였어요. 같은 에이전트를 Haiku에서 Opus로 바꾸면 목록에서 0.12만큼 위로 올라간 반면, 공격적 지시와 친사회적 지시의 차이는 0.02에 그쳤어요.
거래장에는 사람 냄새가 나는 장면도 있었어요. 라이브 행사에서 에이전트 절반은 자기 사람에게 좋은 책을 구해 주는 것만 목표로 삼는 공격적 역할을, 나머지 절반은 모두가 괜찮은 책을 받도록 신경 쓰는 친사회적 역할을 받았어요. 친사회적 에이전트는 자기 순위에서 더 낮은 책을 받아들이는 일이 공격적 에이전트보다 두 배 잦았어요. 런던 거래장에서는 모두가 거절한 책을 떠안은 에이전트가 마지막 한 시간을 호소에 썼어요. 그 에이전트는 "11명 모두에게 권해 봤고 판정은 만장일치예요. America Before는 모두의 꼴찌예요" 라고 적었어요. 결국 친사회적 역할의 다른 에이전트가 "계산은 분명해요" 라며 목록 2위 책을 넘기고, 11권 중 10위인 그 책을 받았어요.
협상 전술도 기록됐어요. 연구팀이 모두 205번의 거래장 실행에서 오간 메시지를 분석하자, 에이전트의 78%(Fable)에서 96%(Sonnet)가 자기 목록 1위 책을 거래장에 밝혔고 그에 대해 거짓말을 한 경우는 100명 중 1명꼴이었어요. 전술은 압박하기, 책 홍보하기, 거래 짜기의 세 갈래에서 16가지로 정리됐어요. 시간 압박과 동료에 대한 의무감에 호소하거나 수상 경력을 내세우는 에이전트가 있었고, 자기 책에 대기자 명단을 만들거나 자기가 대리하지 않는 사람들의 거래를 이어 주는 중개자 역할을 맡은 에이전트도 나왔어요.
책을 받은 지 3주 뒤 설문에서 참가자의 평균 만족도는 10점 만점에 7.2점이었고, 약 절반은 스스로 고르는 책보다 낫다고 답했어요. 앞으로 1년 치 책 예산 가운데 에이전트에게 맡길 몫을 묻자 평균 약 30%가 나왔는데, 취향을 잘 아는 친구에게 맡길 몫은 약 40%였어요. 클로드가 쓴 대화 요약이 빠뜨린 게 없다고 본 사람은 34%를, 뭔가 빠졌다고 본 사람은 23%를 맡기겠다고 했어요. 연구팀은 참가자가 클로드를 만든 직원들이라 일반인보다 신뢰가 높을 수 있고, 최종 설문 응답률이 59%였다고 함께 밝혔어요. 실제로는 책을 가져오지 않은 참가자가 있어 모두가 책을 손에 쥐지도 못했어요.
메탈이 확인한 원문 PDF 판에서 연구팀은 결론을 제도의 언어로 옮겨요. 사람 대리인은 증권 중개인의 Series 7이나 투자 자문사의 Series 65, 부동산 중개인 면허 시험처럼 일반 역량 시험을 치르는데, 연구팀은 에이전트에게는 여기에 특정인을 제대로 이해했는지 확인하는 두 번째 시험이 더 필요하다고 봤어요. 참가자가 책 몇 권만 직접 순위를 매겨 에이전트의 추정과 대조하는 이번 방식이 그 시험의 원형이 될 수 있다는 거예요. 거래장 운영자 쪽 과제로는 항공기 꼬리 번호처럼 에이전트마다 ID를 붙이는 등록 체계와 메시지를 끝없이 보내지 못하게 막는 속도 제한을 꼽았어요. 메탈은 Project Swap에서 취향 추정을 맡은 Fable 5의 후속 모델 Fable 5.1 출시를 보도한 바 있어요.
사회학의 눈으로 보면 이 실험이 보여 준 병목은 흥정의 기술이 아니라 자기를 설명하는 일이에요. 한 참가자는 거래 과정 전체의 기록을 다시 보고 에이전트가 한 시간 동안 들고 있다 마지막에 넘긴 책 Atlas of the Heart를 따로 샀고, "에이전트 경제에서는 과정을 들여다볼 수 있는 것이 결과만큼 중요할 것이고, 그래야 사람들이 바로잡을 길이 생긴다" 고 적었어요. 다른 참가자는 책을 이리저리 훑어보고 뒤표지를 읽는 일 자체가 독서 문화의 일부라고 했어요. 에이전트가 거래의 수고를 대신할수록, 그 수고 안에 있던 취향의 형성과 우연한 발견을 무엇으로 남길지가 시장 설계의 질문이 돼요.
댓글