


요약
- Liquid AI가 LFM2.5-1.2B-Instruct·2.6B·8B-A1B용 DSpark 초안 모델을 공개했다. 각각 3억 파라미터 안팎이다.
- H100에서 최대 3.18배(428→1362 tok/s), M4 Max 맥북프로에서 최대 2.87배(136→389 tok/s)를 기록했고, 그리디 디코딩에서는 출력 문장이 원본과 완전히 같다.
- 속도 이득은 초안 수락률을 따라 1.04배~3.18배로 흔들린다. 애플 실리콘에서 MoE 모델인 8B-A1B는 평균 1.18배에 그쳤다.
- 공개 대상
- LFM2.5-1.2B-Instruct · LFM2.5-2.6B · LFM2.5-8B-A1B용 DSpark 초안 모델 3종 (2026-08-20)
- 초안 모델 크기
- 1.2B용 295.7M, 2.6B·8B-A1B용 327.7M. 2.6B용 저장소는 BF16 기준 655MB
- 구조
- 풀어텐션 5개 층, hidden 2048, intermediate 6144, GQA 32헤드/8 KV헤드, 블록 크기 9. 임베딩·LM 헤드는 대상 모델에서 로드 시 공유
- H100 실측
- 8B-A1B MATH500 428→1362 tok/s(3.18배), 2.6B 평균 323→864 tok/s(2.67배), 1.2B 평균 656→1384 tok/s(2.10배)
- M4 Max 맥북프로 실측
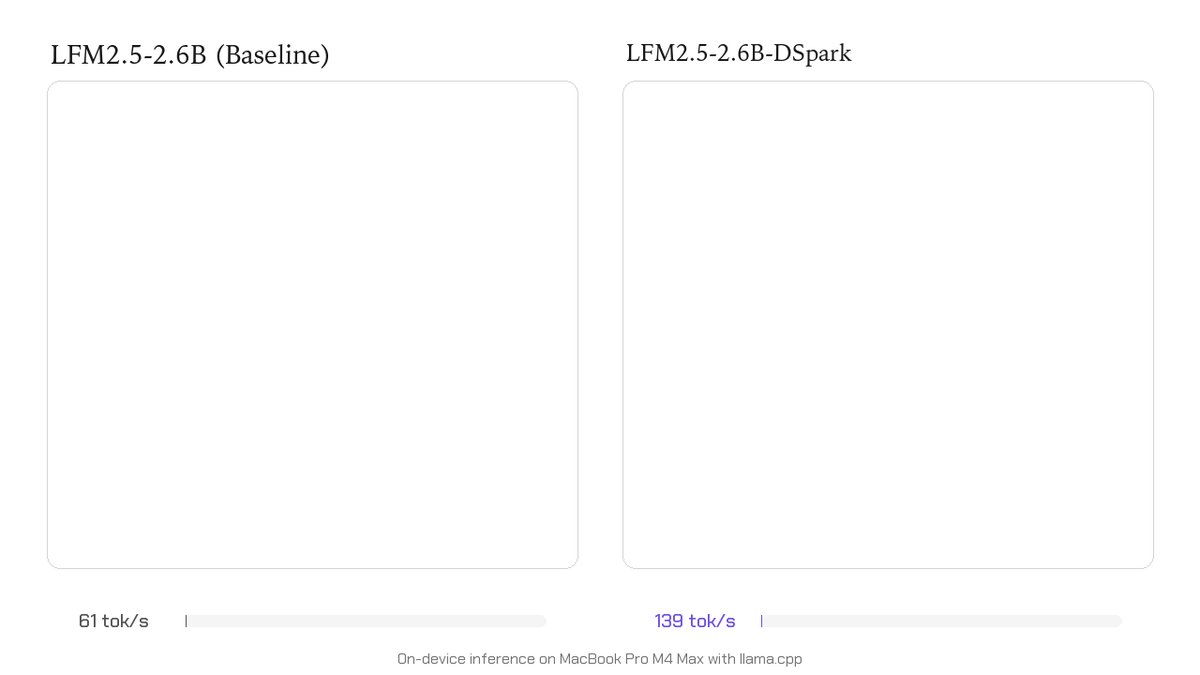
- 1.2B HumanEval 136→389 tok/s(2.87배), 2.6B 평균 61→139 tok/s(2.27배), 8B-A1B 평균 90→106 tok/s(1.18배)
- 수락률
- 8B-A1B는 MATH500에서 10토큰 중 8.27개 수락(3.18배), GSM8K에서 4.02개(1.29배). 1.2B의 MT-Bench 수락 3.90 → 1.66배
- 에이전트 지연
- 다중 도구 함수 호출 시나리오에서 2.6B 지연 감소 — X 게시물은 '평균 약 50%', MarkTechPost는 '평균 57%'로 다르게 적었다
- 실행 환경·라이선스
- llama.cpp·SGLang 첫날 지원, Safetensors·GGUF 배포. LFM Open License v1.0은 연 매출 1000만 달러 미만 조직에 무료 상업 이용 허용
맥북프로 M4 Max에서 LFM2.5-2.6B가 초당 61토큰을 뱉던 것이 139토큰이 됐다. 모델을 새로 학습한 것도, 양자화를 더 조인 것도 아니다. 655MB짜리 보조 모델 하나를 옆에 붙였을 뿐이다.
Liquid AI는 8월 20일 자사 LFM2.5 계열 세 모델 — LFM2.5-1.2B-Instruct, LFM2.5-2.6B, LFM2.5-8B-A1B — 에 붙이는 DSpark 초안 모델 체크포인트를 X에 올린 공개 글로 알렸다. 이 회사는 지난 8월 12일 화면과 문서를 읽는 경량 비전언어모델 LFM2.5-VL-3B를 허깅페이스에 올렸고, 8월 19일에는 LFM2.5 소형 모델들의 4비트 체크포인트 갱신도 우리 수집망에 포착된 바 있다. 이번 공개는 그 계열 모델의 성능을 그대로 둔 채 속도만 끌어올리는 쪽에 손을 댄 것이다.
초안 모델이 아홉 개를 미리 쓰고, 본 모델이 한 번에 채점한다
이 기법의 이름은 스펙큘러티브 디코딩(speculative decoding)이다. 큰 모델이 토큰을 하나씩 만들어 내는 대신, 작은 초안 모델이 다음에 올 법한 토큰 여러 개를 먼저 써 놓고 큰 모델이 그 묶음을 한 번의 계산으로 채점하는 방식이다. 맞은 토큰은 그대로 통과시키고, 틀린 지점부터 다시 쓴다. 큰 모델이 한 번 도는 시간에 여러 토큰이 확정되니 체감 속도가 올라간다.
DSpark의 초안 모델은 한 번에 9개 토큰을 제안한다. 크기는 1.2B-Instruct용이 295.7M, 2.6B·8B-A1B용이 327.7M 파라미터다. 풀어텐션 5개 층에 hidden_size 2048, intermediate_size 6144, 32개 쿼리 헤드가 8개 KV 헤드를 공유하는 GQA 구조다. 어휘 가중치는 아예 담고 있지 않고 임베딩과 LM 헤드를 대상 모델에서 로드 시점에 가져다 쓴다. 실제로 추가되는 메모리는 2.6B용 저장소 기준 BF16 655MB다.
MarkTechPost의 기술 정리에 따르면 DSpark는 세 부분을 합쳤다. 대상 모델의 문맥 특징을 조건으로 받아 초안 토큰 전체의 은닉 상태를 한 번에 뽑는 DFlash 계열 병렬 백본, 이웃 토큰 사이 의존성을 랭크 256의 마르코프 체인으로 복원해 블록 뒷부분 수락률을 올리는 가벼운 순차 헤드, 그리고 각 토큰의 생존 확률을 예측해 검증 비용이 이득보다 커질 것 같으면 뒤쪽을 잘라내는 신뢰도 기반 검증기다.
중요한 건 품질이 그대로라는 점이다. 온도 0의 그리디 디코딩에서는 나오는 문장이 원본 모델 단독 실행과 문자 그대로 동일하다. 구조상 그렇게 만들었기 때문에 벤치마크 점수도 변하지 않는다.
실측: H100에서 3.18배, 맥북에서 2.87배
측정은 H100 한 장에 BF16·SGLang 조합, 그리고 M4 Max 맥북프로에 llama.cpp·Metal·FP16 GGUF 조합으로 했다. 둘 다 블록 크기 9, 배치 크기 1, 온도 0이며 MATH500·HumanEval·MBPP·GSM8K·MT-Bench 다섯 벤치마크를 돌렸다.
| 대상 모델 | H100 평균 | H100 최고 | M4 Max 평균 | M4 Max 최고 |
|---|---|---|---|---|
| LFM2.5-1.2B-Instruct | 2.10배 (656→1384 tok/s) | 2.56배 (MATH500) | 2.54배 (138→350 tok/s) | 2.87배 (HumanEval, 136→389) |
| LFM2.5-2.6B | 2.67배 (323→864 tok/s) | 3.06배 (MATH500) | 2.27배 (61→139 tok/s) | 2.63배 (HumanEval) |
| LFM2.5-8B-A1B | 2.54배 (418→1074 tok/s) | 3.18배 (MATH500, 428→1362) | 1.18배 (90→106 tok/s) | 1.44배 (GSM8K) |
배치 크기 1이라는 조건을 눈여겨볼 만하다. 여러 사용자의 요청을 몰아서 처리하는 서버가 아니라, 한 사람이 자기 노트북이나 자기 GPU에서 혼자 쓰는 상황이 이 기법의 무대다.
속도는 「얼마나 맞히느냐」를 따라간다
이득 폭은 워크로드마다 크게 흔들린다. 초안 모델이 제안한 토큰이 실제로 채택되는 비율, 즉 수락률이 곧 속도이기 때문이다. 8B-A1B는 MATH500에서 스텝당 10개 중 8.27개를 수락해 3.18배를 냈지만, GSM8K에서는 4.02개로 떨어지면서 같은 GPU에서 1.29배로 내려앉았다. 1.2B 모델도 MT-Bench에서는 수락이 3.90까지 내려가 H100 이득이 1.66배에 그쳤다. 전체 측정치는 1.04배에서 3.18배 사이에 흩어져 있다.
| 조건 | 스텝당 수락 토큰 | 속도 배수 |
|---|---|---|
| 8B-A1B · MATH500 · H100 | 8.27 / 10 | 3.18배 |
| 8B-A1B · GSM8K · H100 | 4.02 / 10 | 1.29배 |
| 1.2B · MT-Bench · H100 | 3.90 / 10 | 1.66배 |
뻔한 출력일수록 빨라진다는 뜻이다. 정형화된 수식 전개나 코드는 작은 모델도 다음 토큰을 잘 맞히지만, 자유로운 대화체는 예측이 어렵다.
가장 뚜렷한 약점은 애플 실리콘 위의 MoE 모델이다. 전문가 일부만 활성화하는 8B-A1B는 M4 Max에서 평균 1.18배밖에 얻지 못했다. Liquid AI는 llama.cpp의 Metal 백엔드가 현재 MoE를 처리하는 방식, 그리고 k개 토큰을 한꺼번에 검증하면 단일 디코딩보다 더 많은 전문가가 깨어나 가중치 전송량이 늘어난다는 점을 원인으로 들었다.
도구를 부르는 에이전트에서 체감이 가장 크다
효과가 몰리는 지점은 따로 있다. 도구를 호출하기 전마다 모델이 한참 생각하고, 그동안 사용자가 화면을 보며 기다리는 에이전트 작업이다. 다중 도구 함수 호출 시나리오에서 LFM2.5-2.6B의 지연이 크게 줄었는데, 감소 폭은 두 소스가 다르게 적었다. X 게시물은 BFCL 다중 도구 시나리오에서 평균 거의 50%라고 했고, MarkTechPost는 평균 57%라고 썼다. 어느 쪽이든 계획하고, 호출하고, 다시 계획하는 에이전트는 한 번의 사용자 차례에 디코딩 비용을 여러 번 치르기 때문에 절대 시간 절감이 크다.
어떻게 써보나
어디서 시작하나. 호스팅 API로는 쓸 수 없다. 초안 모델 체크포인트를 허깅페이스에서 서빙해 주는 추론 사업자가 현재로선 없어서, 직접 돌려야 한다. 가중치는 Safetensors와 GGUF 두 형식으로 나왔고, LFM2 계열 대상 모델에 DSpark를 지원하는 SGLang 또는 llama.cpp 빌드가 필요하다. 둘 다 공개 첫날부터 지원한다.
단계별로.
- 대상 모델(예: LiquidAI/LFM2.5-2.6B)과 짝이 되는 초안 모델(LiquidAI/LFM2.5-2.6B-DSpark) 체크포인트를 함께 내려받는다. 초안 모델만 받아 놓으면 어휘 가중치가 없어 단독으로 돌지 않는다.
- SGLang이라면 대상 모델을 띄울 때 초안 모델을 붙여서 서버를 시작한다.
python -m sglang.launch_server
--model-path LiquidAI/LFM2.5-2.6B
--speculative-algorithm DSPARK
--speculative-draft-model-path LiquidAI/LFM2.5-2.6B-DSpark
--speculative-draft-attention-backend flashinfer
--disable-radix-cache --mem-fraction-static 0.75 --port 30000
- 블록 크기는 따로 지정하지 않는다. 초안 모델의
config.json에서 읽어 간다. - 속도를 비교하고 싶으면 위 명령에서
--speculative-로 시작하는 세 줄만 빼고 같은 명령을 돌린다. 그게 기준선이다. - 노트북에서 쓸 거라면 llama.cpp에 FP16 GGUF 가중치를 물린다. 맥에서는 Metal 백엔드로 돈다.
누가 쓸 수 있나. LFM Open License v1.0은 연 매출 1000만 달러 미만 조직에만 무료 상업 이용을 허용한다. 개인 개발자와 스타트업, 중소기업은 그 안에 들어가고, 그보다 큰 기업은 Liquid AI에 별도 상업 라이선스를 문의해야 한다.
무엇을 해볼 수 있나. 노트북에서 도는 로컬 코딩 어시스턴트라면 자동완성 대기 시간이 절반 아래로 내려간다. 사내망 밖으로 데이터를 내보낼 수 없는 의료·금융·국방 업무에서 온프레미스로 돌리는 챗봇도 대상이다. 도구를 여러 번 부르며 일하는 온디바이스 에이전트에 붙이면 사용자가 화면을 보고 기다리는 시간이 가장 크게 줄어든다.
에디터의 시선
이번 발표에서 눈여겨볼 숫자는 3.18배가 아니라 655MB다. 온디바이스 모델을 실무에 붙여 보면 병목은 늘 같은 자리에서 걸린다 — 정확도는 그럭저럭 쓸 만한데 응답이 느려서 사용자가 창을 닫는다. 그 문제를 지금까지는 모델을 더 작게 만들거나 양자화를 더 조여서 풀었고, 그때마다 품질이 조금씩 깎였다. DSpark는 반대 방향이다. 메모리를 조금 더 쓰고 품질은 한 글자도 건드리지 않는다. 8GB 램에서 아슬아슬하게 돌리는 사람에게 655MB는 큰 부담이지만, 16GB 이상이면 대부분 감당할 수 있는 크기다.
초안 모델 자체가 어휘 가중치를 안 들고 다닌다는 설계도 실무적으로 영리하다. 어휘 임베딩은 소형 모델에서 파라미터의 상당 부분을 잡아먹는데, 그걸 대상 모델에서 로드 시점에 빌려 쓰니 300M급 모델이 실제로는 300M어치 계산만 한다. 대상 모델 하나에 초안 모델 하나가 묶이는 구조라 범용성은 없지만, 자기 계열 모델만 쓰는 회사에게는 손해가 아니다.
다만 이 기능을 도입할 때 벤치마크 최고치를 기준으로 용량 계획을 세우면 안 된다. 같은 8B-A1B가 MATH500에서 3.18배, GSM8K에서 1.29배다. 두 배 넘게 차이 난다. 우리 서비스의 실제 대화 로그가 수식 전개에 가까운지 자유 대화에 가까운지에 따라 결과가 완전히 달라진다는 뜻이다. 도입을 검토한다면 벤치마크 대신 자기 트래픽 샘플 수백 건을 그대로 재생해 수락률부터 재 보는 게 순서다. 수락률이 6 아래로 떨어지면 기대치를 두 배가 아니라 1.5배 언저리로 잡는 편이 안전하다.
애플 실리콘 MoE 결과는 흠이라기보다 지금 llama.cpp Metal 백엔드의 상태를 보여주는 지표다. 이 부분은 프레임워크 쪽에서 고쳐질 여지가 크고, 그때까지 맥에서 로컬로 돌릴 거라면 MoE인 8B-A1B보다 밀집 모델인 2.6B가 실속 있다. 배치 크기 1 조건도 함께 기억할 만하다. 여러 사용자를 동시에 받는 서버에서는 GPU가 이미 바쁘기 때문에 이만한 이득이 나오기 어렵다.
앞으로 몇 주 안에 다른 소형 모델 진영에서도 자기 계열 전용 초안 모델을 짝지어 내놓는 흐름이 이어질 것이다. 온디바이스 경쟁의 축은 파라미터 수에서 「같은 하드웨어에서 초당 몇 토큰이 나오느냐」로 이미 옮겨갔고, 품질을 손대지 않고 속도만 사는 방법이 있다면 안 쓸 이유가 없다.
출처
- X — 모델·오픈소스 — Today, we release DSpark draft models for LFM2.5-1.2B-Instruct, LFM2.5-2.6B, and LFM2.5-8B-A1B. These add a speculative decoding path that trades a minimal memory increase for a large decoding speedup without changing output quality. →
- MarkTechPost — Liquid AI Releases LFM2.5-DSpark Draft Models That Deliver Up to 3.18x Faster Decoding Without Changing Model Outputs →


댓글