

이미지: METAL
요약
- 오픈AI는 11월 18일 자사 모델이 AMD 플래그십 GPU 설계의 전력·성능·면적(PPA)을 고도로 최적화된 기존 설계 대비 최대 14% 개선했고, AMD가 그중 일부를 제조에 넘긴 칩에 넣었다고 밝혔다.
- 자체 추론 칩 Jalapeño에서는 모델 제안으로 표준 셀 면적이 벡터 유닛에서 약 13%, 매트릭스 유닛에서 10% 줄었고 실제 실리콘에서 입증됐다.
- RISC-V 코어 설계 시험 9,881회에서 GPT-6.2 Astra가 가장 높은 점수를 냈고, 오픈AI는 시놉시스와 칩 설계 전용 모델 GPT-Synopsys를 훈련하고 있다.
- 발표
- 2026년 11월 18일 · 오픈AI 발표문 「Advancing chip design with OpenAI models」 · X 게시물
- AMD GPU
- 플래그십 GPU IP · 고도로 최적화된 기존 설계 대비 PPA 최대 14% 개선 · SystemVerilog RTL 재작성 · 1년치 진척을 5개월 미만에
- 적용
- 일부 변경은 최근 제조에 넘긴 설계에 포함 · 나머지는 양산 설계 파일에 추가
- AMD CPU
- 차세대 플래그십 CPU 핵심 블록에서 한 자릿수 퍼센트 PPA 개선을 AMD가 확인
- 검증
- 시놉시스 도구로 동작 보존 검증 · PPA 맞교환 평가
- Jalapeño
- 2025년 초부터 모델 활용 · 표준 셀 면적 벡터 유닛 약 13%·매트릭스 유닛 10% 감소 · 곱셈기 셀 면적 약 15%↓·지연 2→1클록 · 덧셈기 셀 면적 약 15%↓ · 실리콘 브링업에서 입증
- RISC-V 평가
- PicoRV32 · Ibex · 5개 모델 · 실행당 약 11만 2천 토큰 · 9,881회 채점 · GPT-6.2 Astra 최고점(명세→RTL PicoRV32 0.7 초과·Ibex 약 0.75)
- GPT-Synopsys
- 2026년 9월 30일 다년간 전략적 파트너십 · EDA 도구 라이선스 · 수익 공유·공동 시장 진출 · 고객 데이터 학습 미사용·암호화
- 발언
- 사신 가지 시놉시스 사장 겸 최고경영자 · 그레그 브록먼 오픈AI 사장 겸 공동창업자
오픈AI가 11월 18일 자사 모델로 AMD의 플래그십 GPU 설계를 다듬어 전력·성능·면적(PPA)을 최대 14% 개선했다고 공개했다. 비교 기준은 AMD 엔지니어들이 이미 수년간 깎아 온, 고도로 최적화된 기존 설계다. 오픈AI는 이 성과가 대략 1년치 진척을 5개월이 안 되는 기간에 거둔 것이라고 밝혔다. AMD는 바뀐 설계 일부를 최근 제조에 넘긴 칩에 이미 넣었고, 나머지는 다음 세대 제품에 쓰도록 양산 설계 파일에 추가했다.
모델이 손댄 곳은 칩 회로를 글로 적어 둔 코드, 즉 SystemVerilog로 쓴 RTL이다. 오픈AI에 따르면 모델은 계산을 하는 회로와 동작을 제어하는 회로, 데이터를 옮기는 회로를 가리지 않고 다시 썼다. 고칠 때마다 시놉시스의 설계 도구로 블록의 동작이 그대로인지 검증하고, 전력과 성능과 면적 사이의 맞교환을 따졌다. 오픈AI는 모델이 숙련된 마이크로아키텍트 수준으로 RTL을 추론하는 모습을 관찰했다고 적었다. AMD는 개발 중인 차세대 플래그십 CPU의 핵심 블록에서도 모델이 쓴 설계로 한 자릿수 퍼센트의 PPA 개선을 직접 확인했다.
같은 방식은 오픈AI의 첫 자체 추론 칩 Jalapeño에서 먼저 시험됐다. 오픈AI는 2025년 초부터 모델에게 Jalapeño 설계를 돕게 했고, 그 시절의 초기 모델도 의미 있는 개선을 찾아냈다. 병렬 연산을 맡는 벡터 유닛에서는 부동소수점 덧셈기와 곱셈기, 변환 함수, 축약 논리에서 면적이 줄었다. 연산 부품인 매트릭스 유닛에서는 곱셈기 하나를 다시 설계해 합성 기준 셀 면적을 약 15% 줄이면서 지연을 2클록에서 1클록으로 당겼다. 덧셈기 하나는 2클록 지연을 유지한 채 셀 면적을 약 15% 줄였다. 메탈은 Jalapeño가 블랙웰보다 빠른 추론 성능을 냈다는 소식을 보도한 바 있다.
설계 전체로 보면 모델이 제안한 변경은 표준 셀 면적을 벡터 유닛에서 약 13%, 매트릭스 유닛에서 10% 줄인 것으로 팀은 추산했다. 이 최적화는 Jalapeño 실리콘 브링업 단계에서 실제 칩으로 동작이 입증됐다. 오픈AI는 X에 올린 글에서 Jalapeño의 개선이 "실제 실리콘에서 검증됐다"고 강조했다. 이 글은 이튿날까지 조회수 96만 회를 넘겼다.
세대별 실력 차이를 재기 위해 오픈AI는 공개된 32비트 RISC-V 코어 두 개로 시험을 돌렸다. PicoRV32는 FPGA용으로 만든 작은 코어이고, Ibex는 OpenTitan 보안 칩에 들어가는 내장 프로세서다. 시험 대상은 GPT-6.2 Astra, GPT-6 Astra, GPT-6.1 Sol, GPT-5.6 Sol, GPT-5.5 다섯 모델이다. 과제는 기존 코어를 고쳐 처리량을 높이는 것과, 글로 쓴 요구 사항에서 코어를 새로 설계하는 것 두 가지였다. 시뮬레이션 검사를 하나라도 통과하지 못하거나 원래 코어 면적의 16배를 넘으면 0점을 줬다. 통과한 설계는 모델이 보지 못한 작업에서 클록당 명령어 수를 재고, Yosys로 추정한 최대 클록 주파수를 곱해 초당 명령어 수를 구했다.
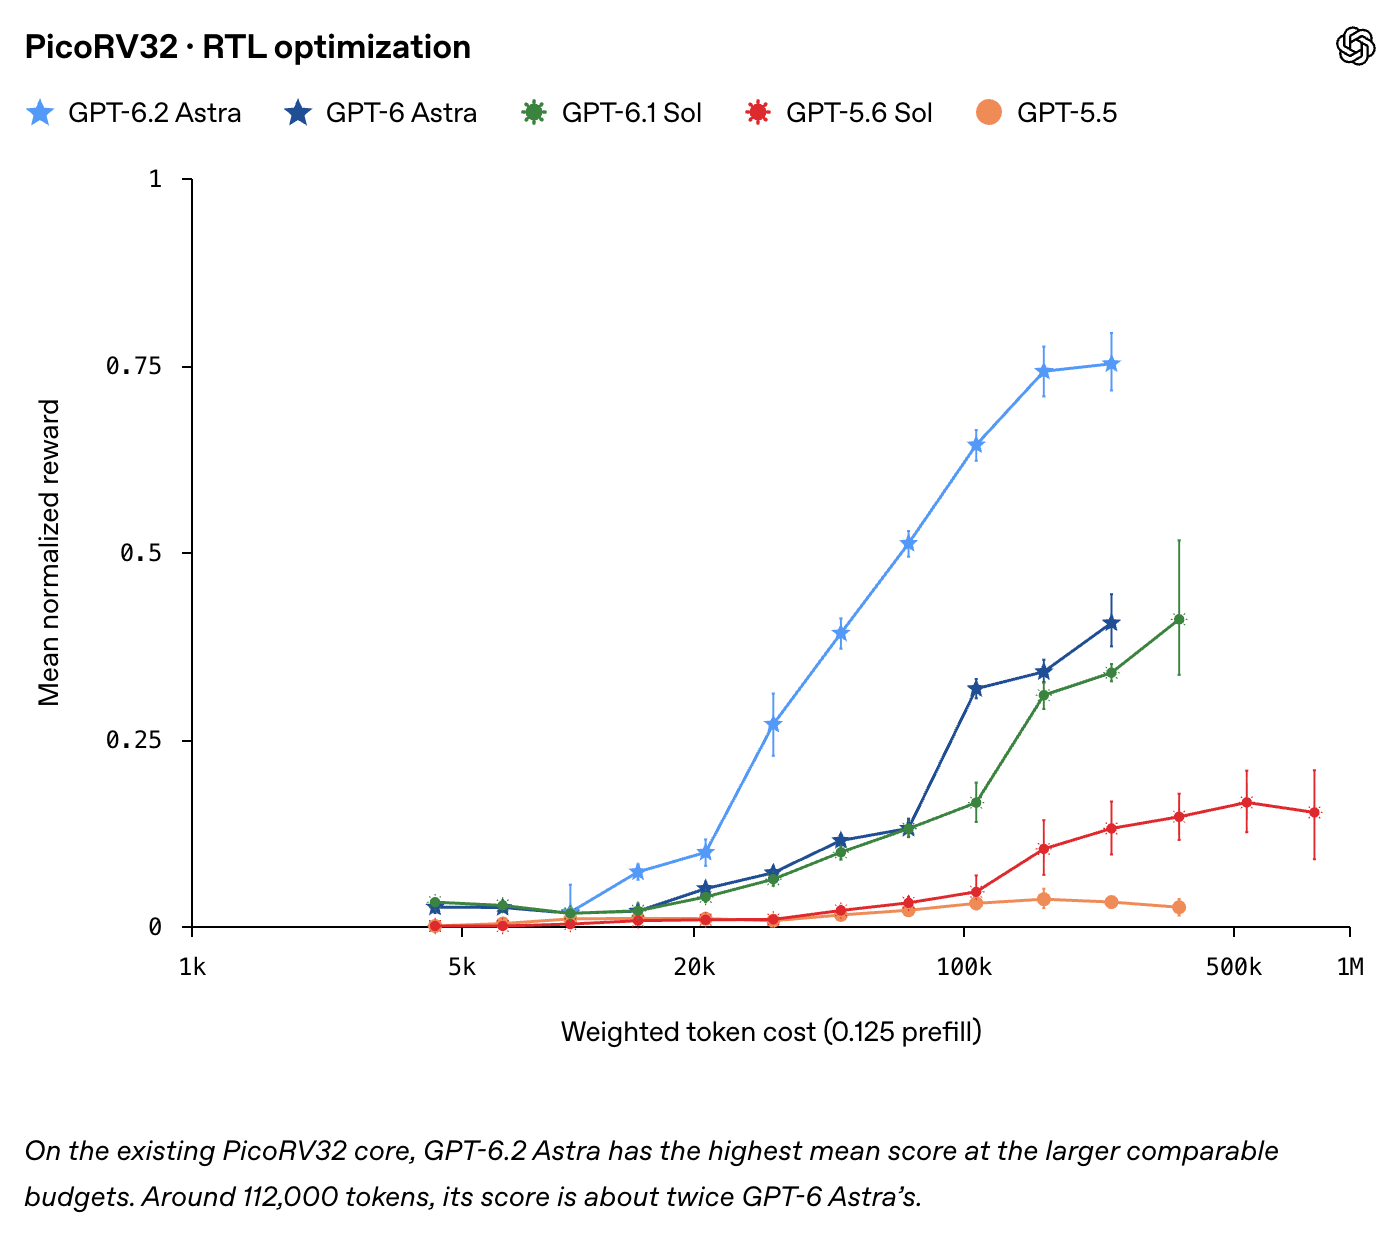
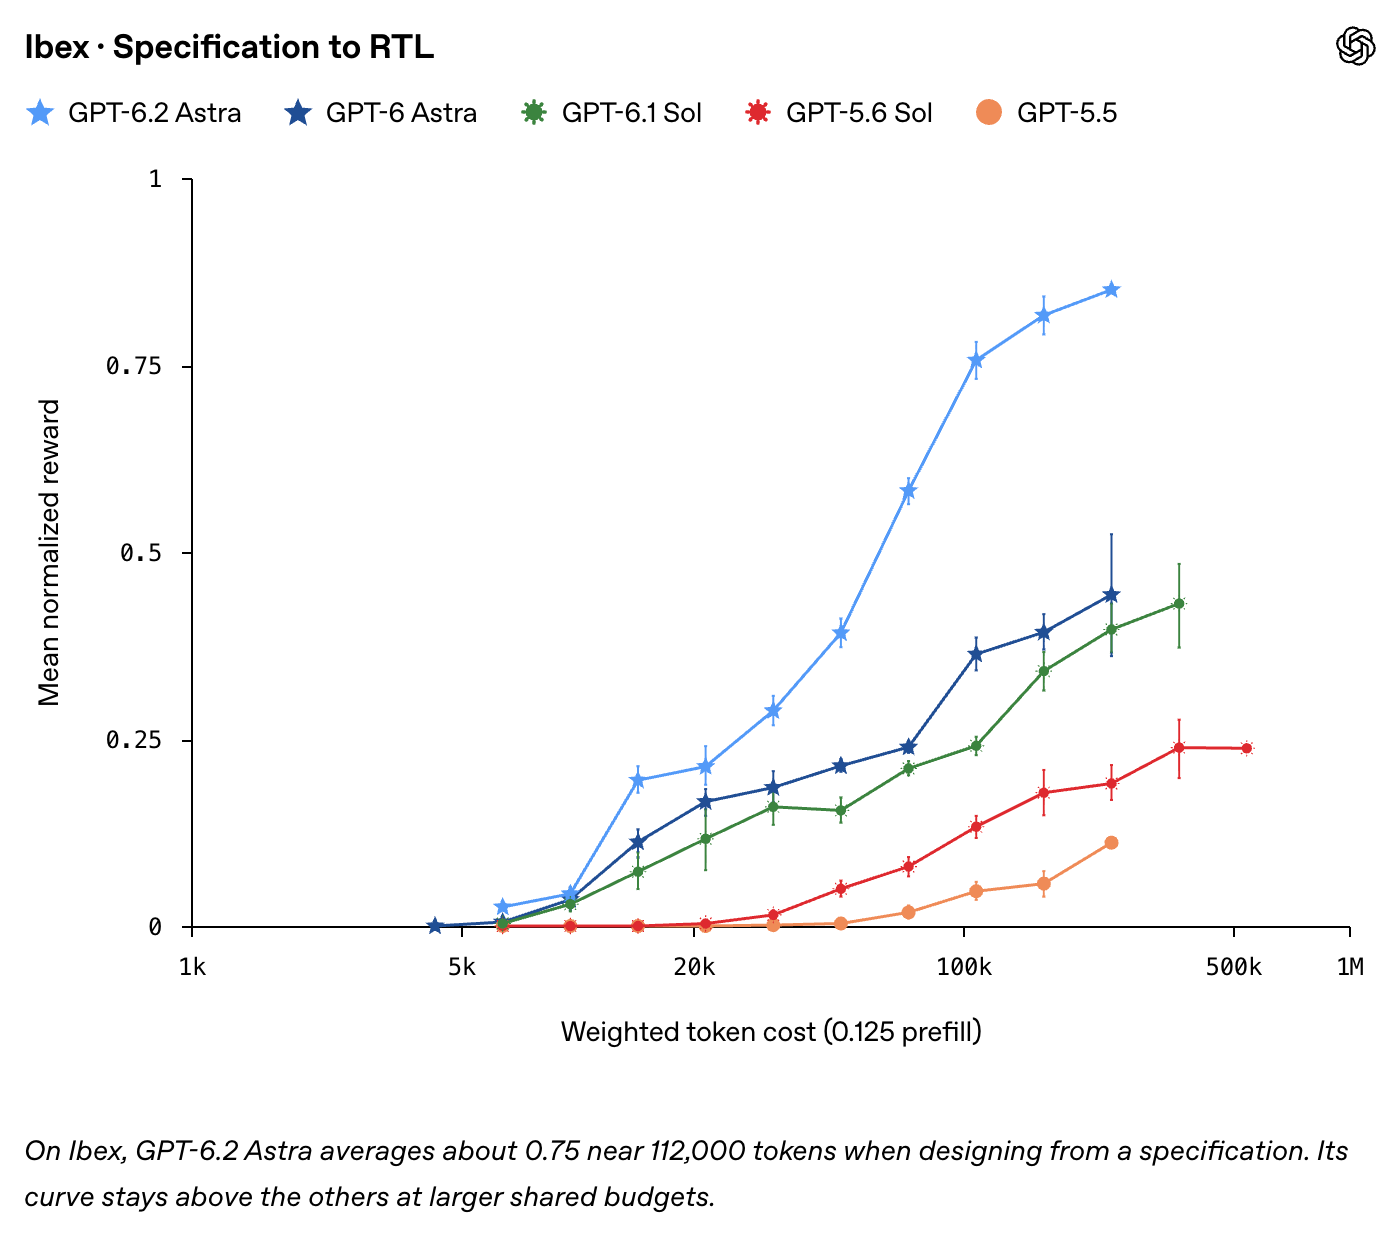
결과는 세대가 올라갈수록 뚜렷하게 갈렸다. 실행당 약 11만 2천 토큰이라는 같은 예산에서 GPT-6.2 Astra가 두 코어 모두 가장 높은 평균 점수를 냈고, GPT-6.1 Sol도 두 코어 모두에서 GPT-5.6 Sol을 앞섰다. PicoRV32 개선 과제에서 GPT-6.2 Astra의 점수는 같은 예산에서 GPT-6 Astra의 약 두 배였다. 요구 사항에서 코어를 새로 짜는 과제에서는 PicoRV32에서 평균 0.7을 넘겼고 Ibex에서는 약 0.75를 기록했다. 평가 전체는 두 과제와 두 코어, 모든 토큰 예산을 합쳐 9,881회 채점한 결과다.
다섯 모델 모두 기존 설계를 고칠 때보다 백지에서 설계할 때 점수가 높았는데, 오픈AI는 그 이유 일부를 스스로 짚었다. 요구 사항에서 출발하면 성능 카운터나 추가 명령어처럼 원래 코어에 있던 기능을 빼먹어도 시험 작업의 처리량에는 손해가 거의 없다. 오픈AI는 그런 기능을 필수로 요구하고 면적 상한을 더 조이고 물리 합성 뒤 타이밍까지 확인해야 실제 칩 설계에 가까운 시험이 된다고 적었다. 메탈이 확인한 오픈AI 발표문에는 두 코어와 두 과제의 점수 곡선 네 장이 실려 있다.
다음 단계는 시놉시스와 함께 만드는 칩 설계 전용 모델 GPT-Synopsys다. 두 회사는 9월 30일 다년간 전략적 파트너십을 맺었고, 오픈AI는 시놉시스의 전자설계자동화(EDA) 도구 라이선스를 들여 모델이 숙련 설계자처럼 도구를 다루도록 훈련한다. 계약에는 수익 공유와 공동 시장 진출이 들어 있다. 사신 가지 시놉시스 사장 겸 최고경영자는 당시 "미래의 반도체 엔지니어링을 위해서는 PPA와 첫 시도에서의 성공적인 실리콘 구현을 타협하지 않으면서 칩 설계 프로세스를 획기적으로 가속화해야 한다"고 말했다. 그레그 브록먼 오픈AI 사장 겸 공동창업자는 "OpenAI는 가장 발전된 기술을 활용해 AI를 구동하는 시스템 자체를 개선하고 있다"고 밝혔다.
시놉시스 설명에 따르면 엔지니어가 PPA 최적화부터 타이밍과 검증 마무리까지 목표를 정하면, 에이전트가 도구를 실행하고 결과를 해석해 설계를 고치고 검증된 결과가 나올 때까지 반복한다. 최종 결과는 엔지니어가 검토한다. GPT-Synopsys는 오픈AI가 운영하는 인프라에서 돌아가며, 고객 설계 데이터는 모델 학습에 쓰이지 않고 저장과 전송 과정에서 암호화된다. 보도에 따르면 오픈AI 칩 개발을 이끄는 리처드 호는 지난달 AI가 낸 설계 변경을 아직 온전히 믿지 않아 하나하나 검증한다고 말했다.
AI 엔지니어의 눈으로 보면 이번 발표에서 무게가 실린 쪽은 14%라는 숫자보다 검증의 고리다. 칩 설계는 오래된 집을 리모델링하는 일과 닮았다. 벽 하나를 옮겨 방을 넓혀도 배관과 전기가 그대로 돌아간다는 걸 확인하지 못하면 공사는 끝나지 않는다. 모델이 RTL을 다시 쓰는 속도는 빨라졌지만, 바뀐 회로가 원래와 똑같이 동작하는지를 판정하는 일은 여전히 시놉시스 도구와 사람 엔지니어가 맡았다. AMD가 수정본 일부를 실제 제조 설계에 넣었다는 사실은 그 고리가 양산 현장에서 한 번 닫혔다는 뜻이다. 오픈AI는 AI를 돌리는 칩을 AI로 개선하는 순환을 GPT-Synopsys로 다른 칩 회사들에까지 넓히려 한다.
댓글