


이미지: METAL
요약
- 오픈AI가 10월 2일 GPT-6 계열 세 모델을 작업에 맞춰 고르고 지시하고 운영하는 법을 정리한 공식 모델 가이드를 공개했다.
- 가이드는 Astra를 가장 어려운 추론에, Sol을 코딩·리서치·컴퓨터 사용에, Luna를 반복 작업에 쓰라고 나눴고, 캐시된 입력 토큰은 최대 95% 저렴하다고 밝혔다.
- 하비·코그니션·헥스·인비디오의 GPT-6 Astra 사례가 실렸고, 인비디오는 색 보정 작업 성공률이 약 3배로 올랐다고 밝혔다.
- 발표
- 2026년 10월 2일 오픈AI 공식 가이드 「A model guide for the GPT-6 family」
- 모델 구분
- GPT-6 Astra 최고난도 추론 · GPT-6.1 Sol 복잡한 코딩·리서치·컴퓨터 사용 · GPT-6 Luna 대규모 반복 작업
- 추론 강도
- 낮음 · 중간 · 높음 · 매우 높음/최대 — API에서는 대화 도중 바꿔도 캐시 유지
- 속도
- Fast 모드(토큰당 비용 높고 응답 일정) · Ultrafast(GPT-6 Astra 전용)
- 캐싱
- 캐시된 입력 토큰은 모델에 따라 최대 95% 저렴 · 긴 대화는 컴팩션
- 장기 작업
- Responses WebSocket API 턴 중간 조종 · 비동기 도구 호출 · GPT-6.1 Sol 멀티 에이전트(베타)
- 컴퓨터 사용
- 세 모델 모두 지원 · 브라우저는 플레이라이트, 데스크톱은 PyAutoGUI
- 기업 사례
- 하비 · 코그니션(데빈) · 헥스 · 인비디오(색 보정 성공률 약 3배, 하루 효과 약 50개)
오픈AI가 10월 2일(현지시간) GPT-6 계열 모델 세 종을 어떤 일에 어떻게 써야 하는지 정리한 공식 모델 가이드를 공개했다. 가이드는 작업에 맞는 모델과 추론 강도, 속도를 고르는 법, 프롬프트와 스킬과 저장소 지침을 고치는 법, 몇 시간에서 며칠에 걸친 장기 작업을 조종하는 법, 실제 서비스에 올리기 전 점검할 항목을 차례로 묶었다. 오픈AI는 GPT-6를 지금까지 가장 앞선 모델군이라고 소개하면서, 아이디어를 작동하는 시제품으로 바꾸는 일부터 코드 저장소와 데이터베이스, 외부 API를 넘나드는 다단계 워크플로까지를 이 가이드의 대상으로 잡았다.
모델 선택의 기준은 세 갈래다. 가이드에 따르면 GPT-6 Astra는 최대 지능이 필요한 가장 어려운 추론 작업에, GPT-6.1 Sol은 복잡한 코딩과 리서치, 컴퓨터 사용에 맞는다. GPT-6 Luna는 송장 항목 추출이나 요청 분류, 구조화된 요약처럼 목표가 분명한 일상 반복 작업을 대규모로 돌리는 용도다. 오픈AI는 모델 선택과 추론 수준을 지능과 가격 사이의 맞교환으로 보라고 권하고, 작업마다 모델별 요금을 비교하라고 덧붙였다.
추론 강도는 네 단계로 나눴다. 낮음은 사실 추출이나 작은 수정 같은 일상 작업, 중간은 기능 기획이나 선택지 비교처럼 판단이 필요한 일, 높음은 어려운 디버깅과 깊은 분석, 꼼꼼한 리뷰에 쓴다. 매우 높음과 최대는 높음으로 부족할 때만 시험하고, 늘어난 시간과 비용만큼 결과가 나아질 때만 유지하라고 가이드는 적었다. API에서는 대화 도중 추론 강도를 바꿔도 캐시가 깨지지 않는다. 속도 옵션도 둘이다. Fast 모드는 채팅 앱이나 코딩 도구처럼 응답 시간이 중요한 곳에서 표준 처리보다 토큰당 비용을 더 내고 더 빠르고 일정한 응답을 받는 방식이고, Ultrafast는 추론 강도와 상관없이 토큰 생성 자체를 빠르게 하는 옵션으로 GPT-6 Astra에서만 쓸 수 있다.
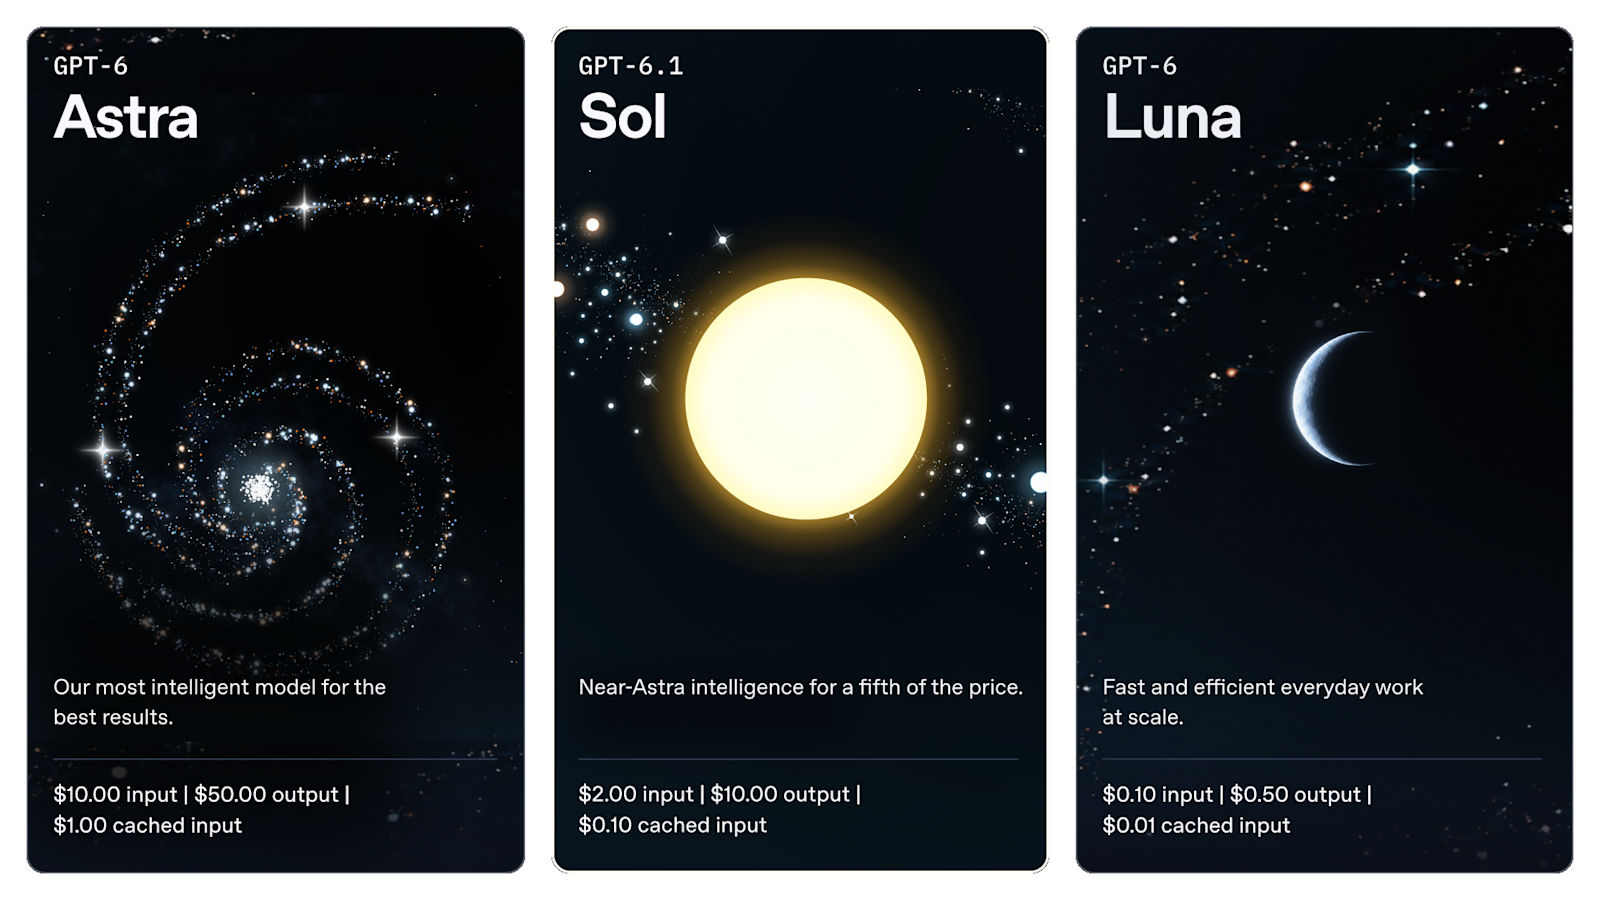
운영 비용을 줄이는 핵심 수단으로는 프롬프트 캐싱을 꼽았다. 오픈AI에 따르면 캐시된 입력 토큰은 모델에 따라 캐시되지 않은 입력 토큰보다 최대 95% 저렴하다. 이를 살리려면 변하지 않는 지침과 참고 자료를 앞에 두고 바뀌는 작업 내용을 뒤에 두며, 도구 정의를 일관되게 유지해야 한다. 가이드는 전체 워크플로 비용을 계산할 때 캐시 쓰기 비용과 긴 맥락 요금까지 넣으라고 했고, 긴 대화에는 다음 단계에 필요한 상태를 남긴 채 맥락 크기를 줄이는 컴팩션을 쓰라고 했다. 배포 전에는 대표 작업을 돌려 작업 성공률과 지연 시간, 성공한 작업 하나당 비용을 재라고 권했다.
프롬프트에 대한 조언은 더 적게, 더 분명하게로 요약된다. 오픈AI 개발자 경험 담당 에릭 프로벤처는 "모델이 뉘앙스와 모호함을 훨씬 잘 이해하게 되면서, 예전에는 도움이 되던 지나치게 구체적인 지침이 이제는 결과를 해칠 수 있다"고 말했다. 가이드는 원하는 결과와 그 결과를 받을 사람, 관련 맥락과 제약, 완료의 기준부터 적으라고 했다. 스킬 설명은 짧게 쓰고 언제 실행되는지 분명히 하며, 세부 자료는 필요할 때만 불러오고 경직된 절차 대신 지침을 주라는 것이다. AGENTS.md에는 어떤 문서와 테스트가 언제 중요한지 설명하고, 운영 환경에 접근하지 않고 버릴 데이터로 로컬 테스트를 돌리는 것처럼 안전한 일상 작업은 명시적으로 허락하라고 했다.
판단의 경계도 문서로 정하라고 가이드는 주문했다. 모델이 스스로 진행할 수 있는 행동과 승인이 필요한 행동을 나눠 적고, 무조건 먼저 물어보라는 규칙은 분명한 경계로 바꾸라는 것이다. 예를 들어 요약을 어떻게 구성할지는 모델이 고르게 두되, 프로젝트 범위를 바꾸기 전에는 확인을 받게 하는 식이다. 완료의 정의에는 변경을 구현하고, 실행하고, 결과를 살피고, 실패를 고치는 과정까지 넣으라고 했다. 마지막 응답은 무엇을 바꿨는지, 무엇을 확인했는지, 무엇이 아직 남았는지를 짧게 넘겨주는 인계 형식을 권했다.
장기 작업을 위한 기능은 API와 코덱스로 나눠 소개했다. API에서는 Responses WebSocket API로 작업 중인 모델에 수정 지시를 보내는 턴 중간 조종을 쓸 수 있는데, 지시는 대기열에 쌓이고 실행 중인 도구를 취소하거나 끝난 작업을 되돌리지 않는다. 비동기 도구 호출을 쓰면 앱이 테스트처럼 느린 작업을 돌리는 동안 모델은 그와 무관한 일을 계속한다. GPT-6.1 Sol은 Responses API에서 멀티 에이전트 워크플로를 지원해, 코드베이스의 서로 다른 부분 조사 같은 독립 작업을 하위 에이전트에 나눠 맡기고 결과를 하나의 응답으로 합친다. 멀티 에이전트는 아직 베타다. 코덱스에서는 GPT-6 Astra가 작업 도중 사용자에게 확인 질문을 던질 수 있고, 사용자는 진행 중인 작업에 새 정보를 넣어 방향을 틀 수 있다.
컴퓨터 사용은 세 모델 모두에 열려 있다. 가이드에 따르면 GPT-6 Astra와 GPT-6.1 Sol, GPT-6 Luna는 API가 없는 프로그램을 포함해 웹사이트와 데스크톱 앱을 직접 조작할 수 있다. 버그를 조사해 코드를 고친 뒤 브라우저로 제품을 열어 수정이 먹혔는지 확인하는 일까지 한 흐름으로 맡길 수 있다는 설명이다. 오픈AI는 API나 연결된 도구로 바로 할 수 있는 일은 그쪽을 쓰고, 화면을 읽고 버튼을 누르고 양식을 채워야 할 때만 컴퓨터 사용을 쓰라고 했다. 자체 앱에 넣으려면 브라우저에는 플레이라이트, 데스크톱 앱에는 PyAutoGUI를 붙이라고 안내했다.
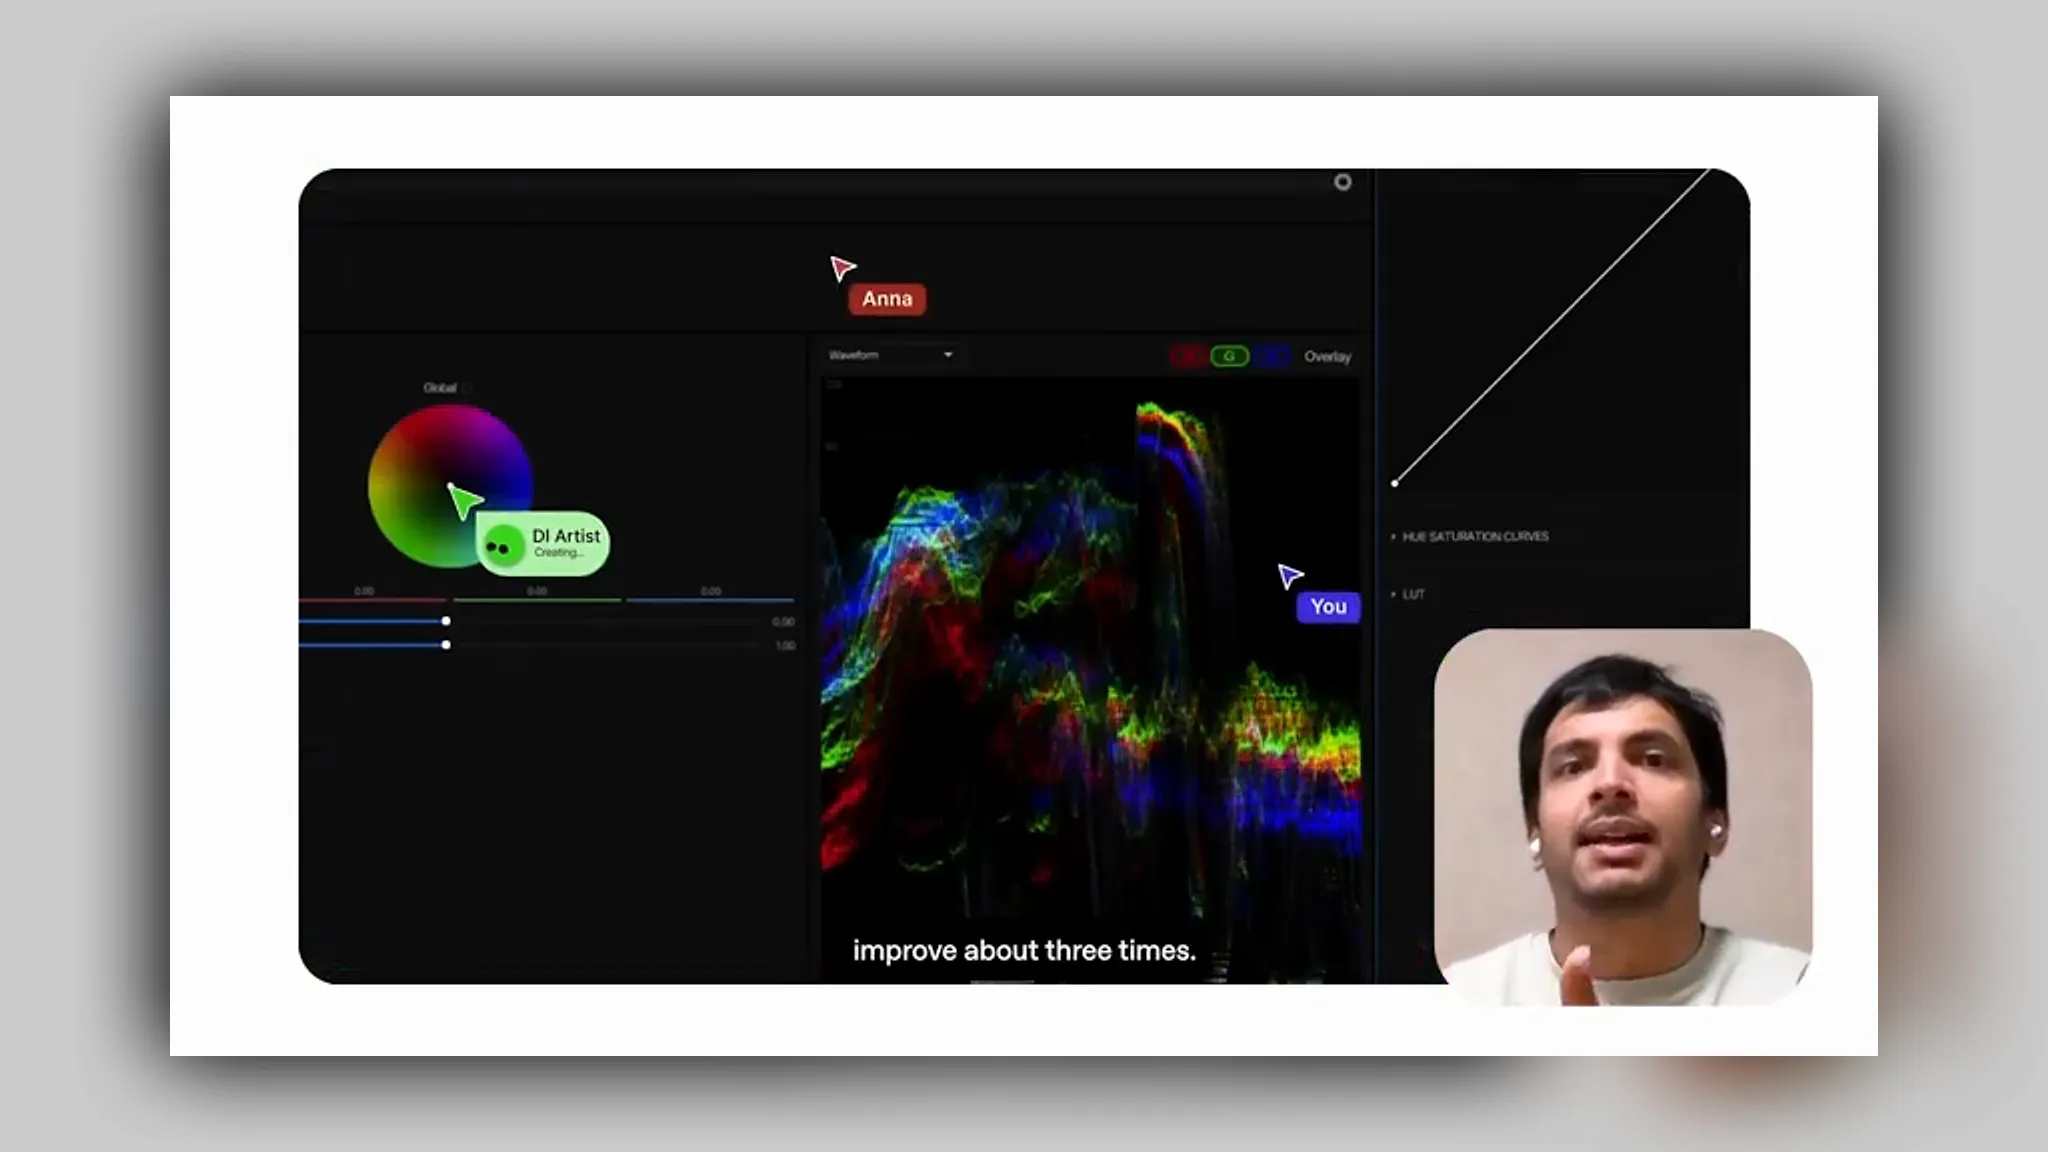
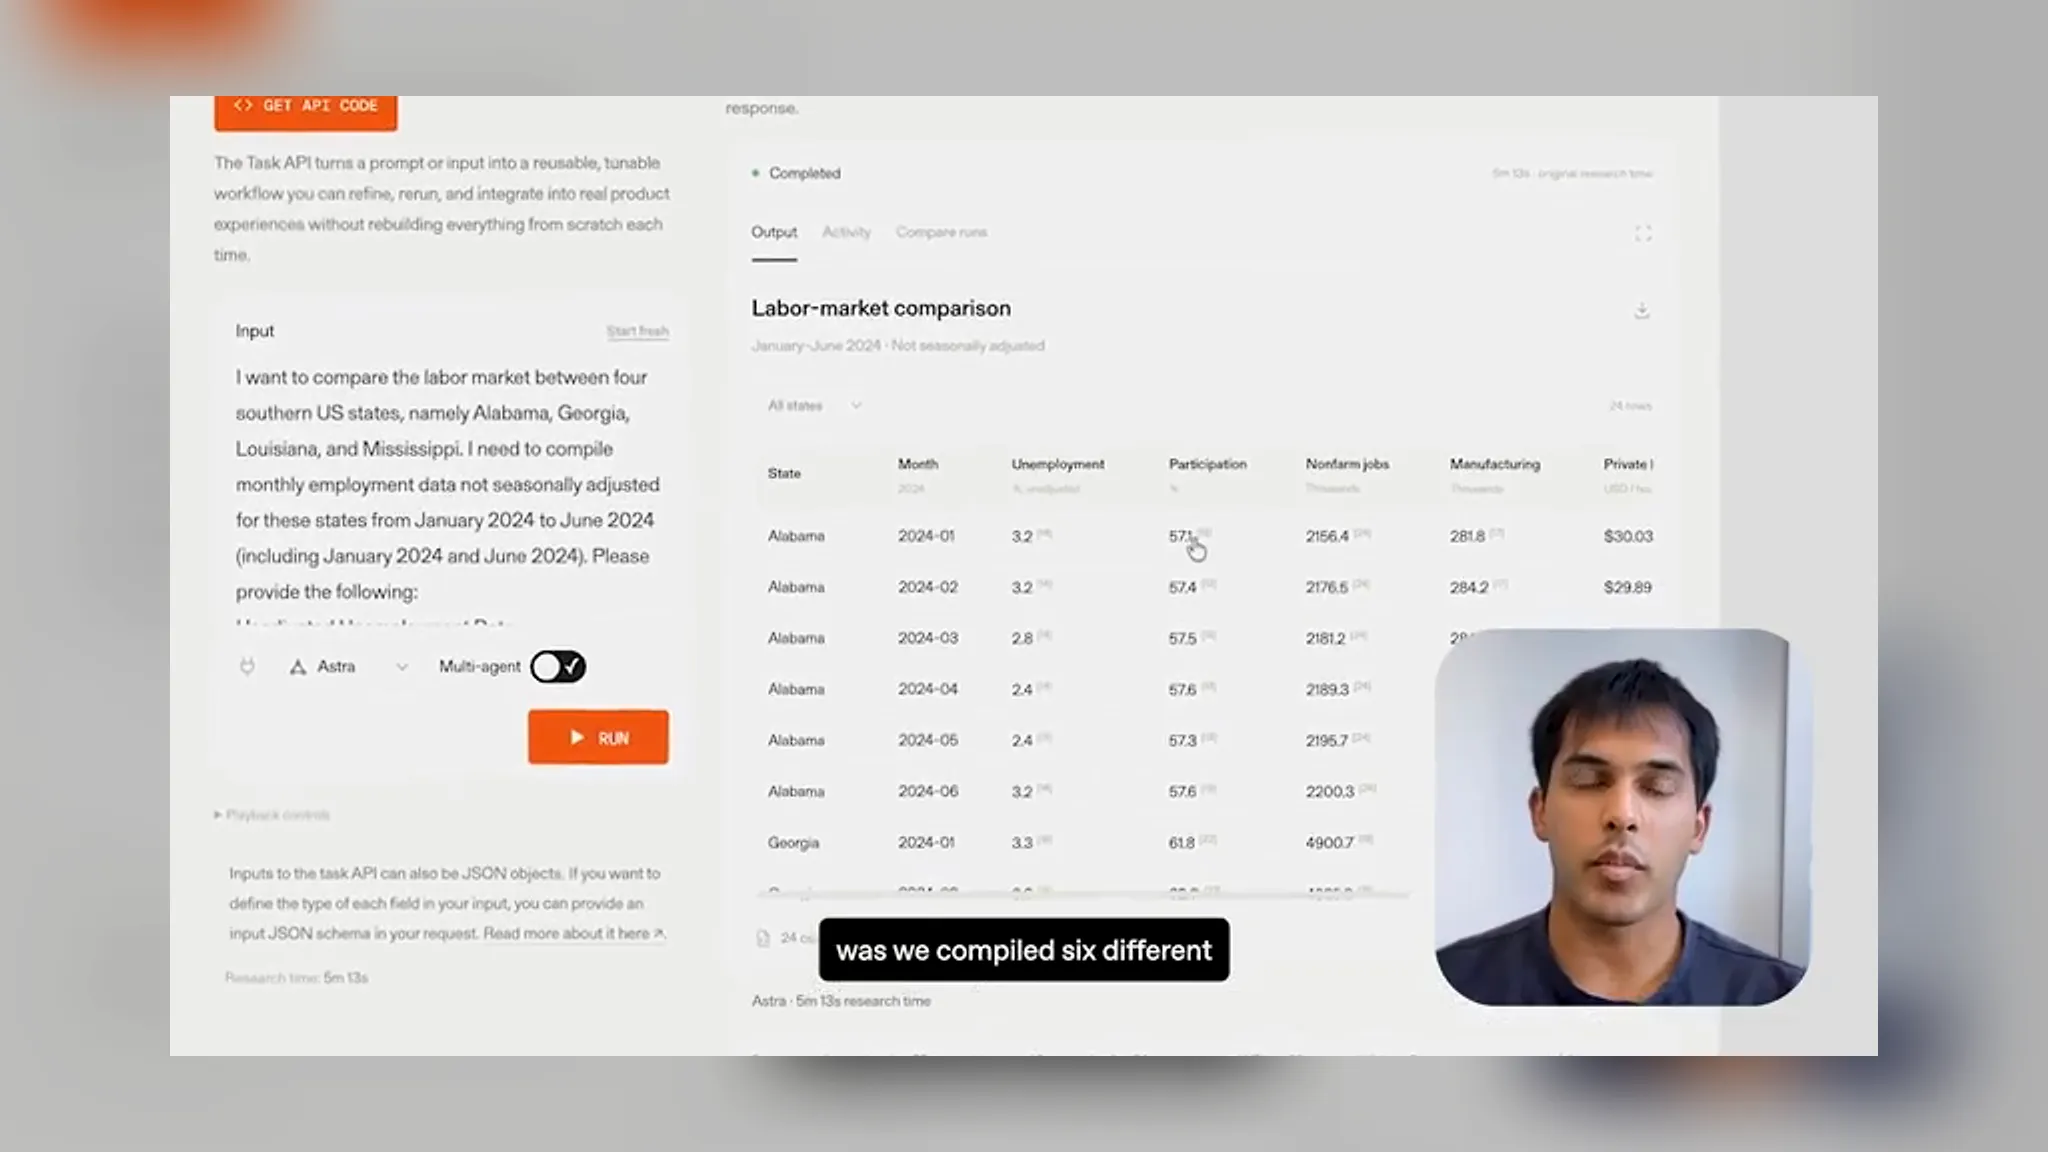
가이드에는 GPT-6 Astra를 실제 서비스에 쓰는 기업 사례 네 건도 실렸다. 법률 AI 기업 하비는 법원 정보와 판례, 로펌 문서, 변호사의 선호를 합쳐 초안을 맞춤 작성한다. 공동창업자 게이브 페레이라는 "모델에 더 많은 맥락을 줄 수 있고, 점점 더 잘 구조화된 결과물을 만들 수 있다"고 말했다. 코그니션은 데빈 안에서 GPT-6 Astra로 소프트웨어를 시험하고 근거를 돌려받는데, 아이폰 게임 사례에서 데빈은 시뮬레이터 녹화 영상과 함께 통과한 검사와 시험하지 못한 영역을 나눈 보고서를 냈다. 헥스는 판매 채널 성과에 관한 질문을 지역별 분석이 담긴 글과 대화형 대시보드로 바꾸고, 숫자가 말이 되는지 모델에 다시 따져 보게 한다. 인비디오는 색 보정 작업 성공률이 약 3배로 올랐고, 편집자 몇 명이 하루에 효과 약 50개를 만들었다고 밝혔다.
메탈은 오픈AI의 GPT-6.1 Sol 공개를 보도한 바 있으며, 이번 가이드는 Sol 출시 사흘 뒤 세 모델의 쓰임새를 오픈AI가 직접 나눠 정리한 공식 문서다. 메탈이 확인한 가이드 원문에는 모델 카드 그림과 함께, GPT-6 Astra로 비동기 워커 리팩터링을 오래 돌린 개발자와 Ultrafast와 실시간 조종으로 아이패드 호환성을 고친 개발자의 경험담이 실려 있다.
AI 엔지니어와 기술 프로젝트 매니저의 눈으로 보면 이 가이드가 옮겨 놓은 무게중심은 분명하다. 성능을 끌어올리는 일은 더 긴 프롬프트를 쓰는 일이 아니라, 무엇을 맡기고 어디서 멈출지와 무엇이 완료인지를 정하는 일이 됐다. 비용 관리도 모델 하나를 고르는 문제에서 캐시 구조와 추론 강도, 속도 옵션을 조합하는 설계 문제로 바뀌었고, 오픈AI가 제시한 측정 단위는 토큰 단가가 아니라 성공한 작업 하나당 비용이다. 모델이 며칠짜리 일을 맡는 단계에서 개발팀의 핵심 산출물은 코드만큼이나 경계와 완료 기준을 적은 지침 문서가 되고 있다.
댓글