


이미지: 영상 갈무리
요약
- 메타가 10월 12일 Muse Wonder와 Muse Wonder Full을 공개했다. Muse Wonder는 Meta Model API와 Muse Code에서, Muse Wonder Full은 Muse Code 구독자에게만 제공된다.
- 메타 벤치마크 표에서 Muse Wonder Full은 개인 초지능 지수 59.1점, Harvey LAB-AA 13.1점으로 1위였지만 Artificial Analysis 지수는 56점으로 Claude Opus 5.5(58점)에 뒤졌다.
- 메타는 대화를 넘어 기억하는 액티브 메모리를 내세웠고, MemoryBench에서 Muse Wonder가 85.6점으로 가장 높았다. 곧 개인 에이전트 Muse에 구독자부터 적용된다.
- 공개
- 2026년 10월 12일 · Muse Wonder · Muse Wonder Full · 메타 첫 프론티어 모델
- 제공
- Muse Wonder: Meta Model API·Muse Code · Muse Wonder Full: Muse Code 구독자 전용(Power Usage·Maximum Usage)
- 컨텍스트
- 두 모델 모두 100만 토큰
- 입력
- 글·이미지·영상·음성(보도)
- 조직 개편
- 14개월 전 AI 사업 개편 시작 · 알렉산더 왕 지난해 8월 재편 뒤 첫 프론티어 모델(보도)
- 학습
- 오하이오주 중부 프로메테우스 데이터센터 · 기가와트 규모
- 새 기능
- 액티브 메모리(대화 넘어 기억) · 액티브 포커스(막혀도 다른 방법 시도·확인 요청)
- 개인 초지능 지수
- Muse Wonder Full 59.1 · Claude Opus 5.5 55.2 · GPT-6 Astra 54.5 · Claude Fable 5.1 49.9 (메타 측정)
- Harvey LAB-AA
- Muse Wonder Full 13.1 · Claude Opus 5.5 4.2
- 금융·자동화
- Vals Finance Agent V2 59.1 · AutomationBench-AA 45.4 (Muse Wonder Full 1위)
- 장기 코딩
- DeepSWE 1.1 79.0 · SWE-Marathon 57.5 (Muse Wonder Full 1위)
- Claude Opus 5.5 우위
- HealthBench Pro 65.6 · JobBench 75.4 · Terminal-Bench 4.0-AA 59.6 · ProgramBench 70.5 · Artificial Analysis 지수 58
- MemoryBench
- Muse Wonder 85.6 · 표 안 최고
- 외부 측정(보도)
- AA 지능 지수 Full 56 · Wonder 52 · Spark 1.3 48 · Terminal-Bench 4.0 33%→57%
- ProofBench(보도)
- 100문제 중 94문제 · 전작 58문제
- 지식·환각(보도)
- AA-Omniscience Full 30 · Opus 5.5 46 · Astra 43 · Gemini 4 Argon 42 · 환각 33%→23%
- 안전
- 허락 없는 개인정보 공유 회피 · 해로운 요청 거절 · 메타 초지능 스케일링 프레임워크 · 전체 안전 보고서 곧 공개
- 다음 단계
- 개인 에이전트 Muse에 구독자부터 적용 예정
- 발표 영상
- 2분 32초 · 카비야 코파라푸 메타 연구원 출연
메타가 10월 12일 자사 첫 프론티어 모델인 Muse Wonder와 Muse Wonder Full을 공개했다. 메타는 발표문에서 두 모델을 지금까지 내놓은 모델 가운데 가장 뛰어난 모델이라고 소개하고, 개인 업무와 전문 업무를 대신 처리하는 에이전트 과제에서 최고 수준 성능을 낸다고 밝혔다. Muse Wonder는 공개 당일부터 Meta Model API와 코딩 도구 Muse Code에서 쓸 수 있고, Muse Wonder Full은 Muse Code 구독자에게만 열렸다. 두 모델 모두 컨텍스트 창이 100만 토큰이다.
이번 공개는 메타 AI 조직 개편의 첫 성적표다. 메타는 14개월 전 AI 사업을 갈아엎기 시작해 기반을 다시 세우는 단계에서 프론티어를 미는 단계로 왔다고 설명했다. 보도에 따르면 이번 모델은 스케일AI 창업자 알렉산더 왕이 지난해 8월 메타의 AI 조직을 재편한 뒤 처음 나온 프론티어급 모델이고, 메타는 그사이 경량 모델 Muse Spark와 개인 에이전트 Muse만 내놓았다. 메타는 연구 블로그에서 "두 모델은 우리 스케일링 사다리의 다음 단계이자 개인 초지능을 향한 큰 도약"이라고 썼다. 보도에 따르면 학습은 올해 가동한 오하이오주 중부의 프로메테우스 데이터센터에서 기가와트 규모로 이뤄졌다.
메타가 겨냥한 일은 코딩만이 아니다. 발표문은 보험 청구 처리, 임대 계약서 이해, 개인 재무 정리 같은 일을 예로 들며 두 모델이 법률·금융·의료 같은 전문 영역과 프론티어급 코딩을 함께 다룬다고 밝혔다. 메타 개발자 페이지는 Muse Wonder가 긴 작업을 계획하고 일부를 하위 에이전트에게 나눠 맡기며, 도구를 병렬로 부르고 오류에서 스스로 회복해 몇 시간씩 이어지는 다단계 작업을 끊김 없이 수행한다고 설명한다. 브라우저와 데스크톱, 모바일 앱 화면을 보고 직접 조작하는 컴퓨터 사용 기능도 들어갔다. 보도에 따르면 두 모델은 글과 이미지, 영상, 음성을 모두 입력으로 받는다.
메탈이 확인한 메타 개발자 페이지의 벤치마크 표는 두 모델을 Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5와 14개 항목에서 나란히 비교했다. 표의 점수는 메타가 공개한 값이다. 개인·지식 업무를 묶은 메타 내부 지표인 개인 초지능 지수에서 Muse Wonder Full은 59.1점으로 Claude Opus 5.5(55.2점)와 GPT-6 Astra(54.5점), Claude Fable 5.1(49.9점)을 앞섰다. 법률 에이전트 과제인 Harvey LAB-AA에서는 13.1점으로 비교 모델 가운데 가장 높았고 Claude Opus 5.5는 4.2점이었다. 금융 분석 과제 Vals Finance Agent V2에서 59.1점, 업무 자동화 과제 AutomationBench-AA에서 45.4점으로 역시 1위였다.
모든 항목을 이긴 것은 아니다. 같은 표에서 Claude Opus 5.5는 의료 질의 HealthBench Pro(65.6점), 전문 도구 사용 JobBench(75.4점), 터미널 코딩 Terminal-Bench 4.0-AA(59.6점), 처음부터 프로그램을 짜는 ProgramBench(70.5점)에서 가장 높았고, 외부 기관 지표인 Artificial Analysis 지수에서도 58점으로 Muse Wonder Full(56점)보다 위였다. 코딩에서 메타가 내세운 것은 긴 호흡의 작업이다. Muse Wonder Full은 장기 코딩 과제 DeepSWE 1.1에서 79.0점, 초장기 엔지니어링 과제 SWE-Marathon에서 57.5점으로 비교 모델을 모두 앞섰고, 메타는 이 결과가 독립 제3자 측정에서도 확인됐다고 밝혔다.
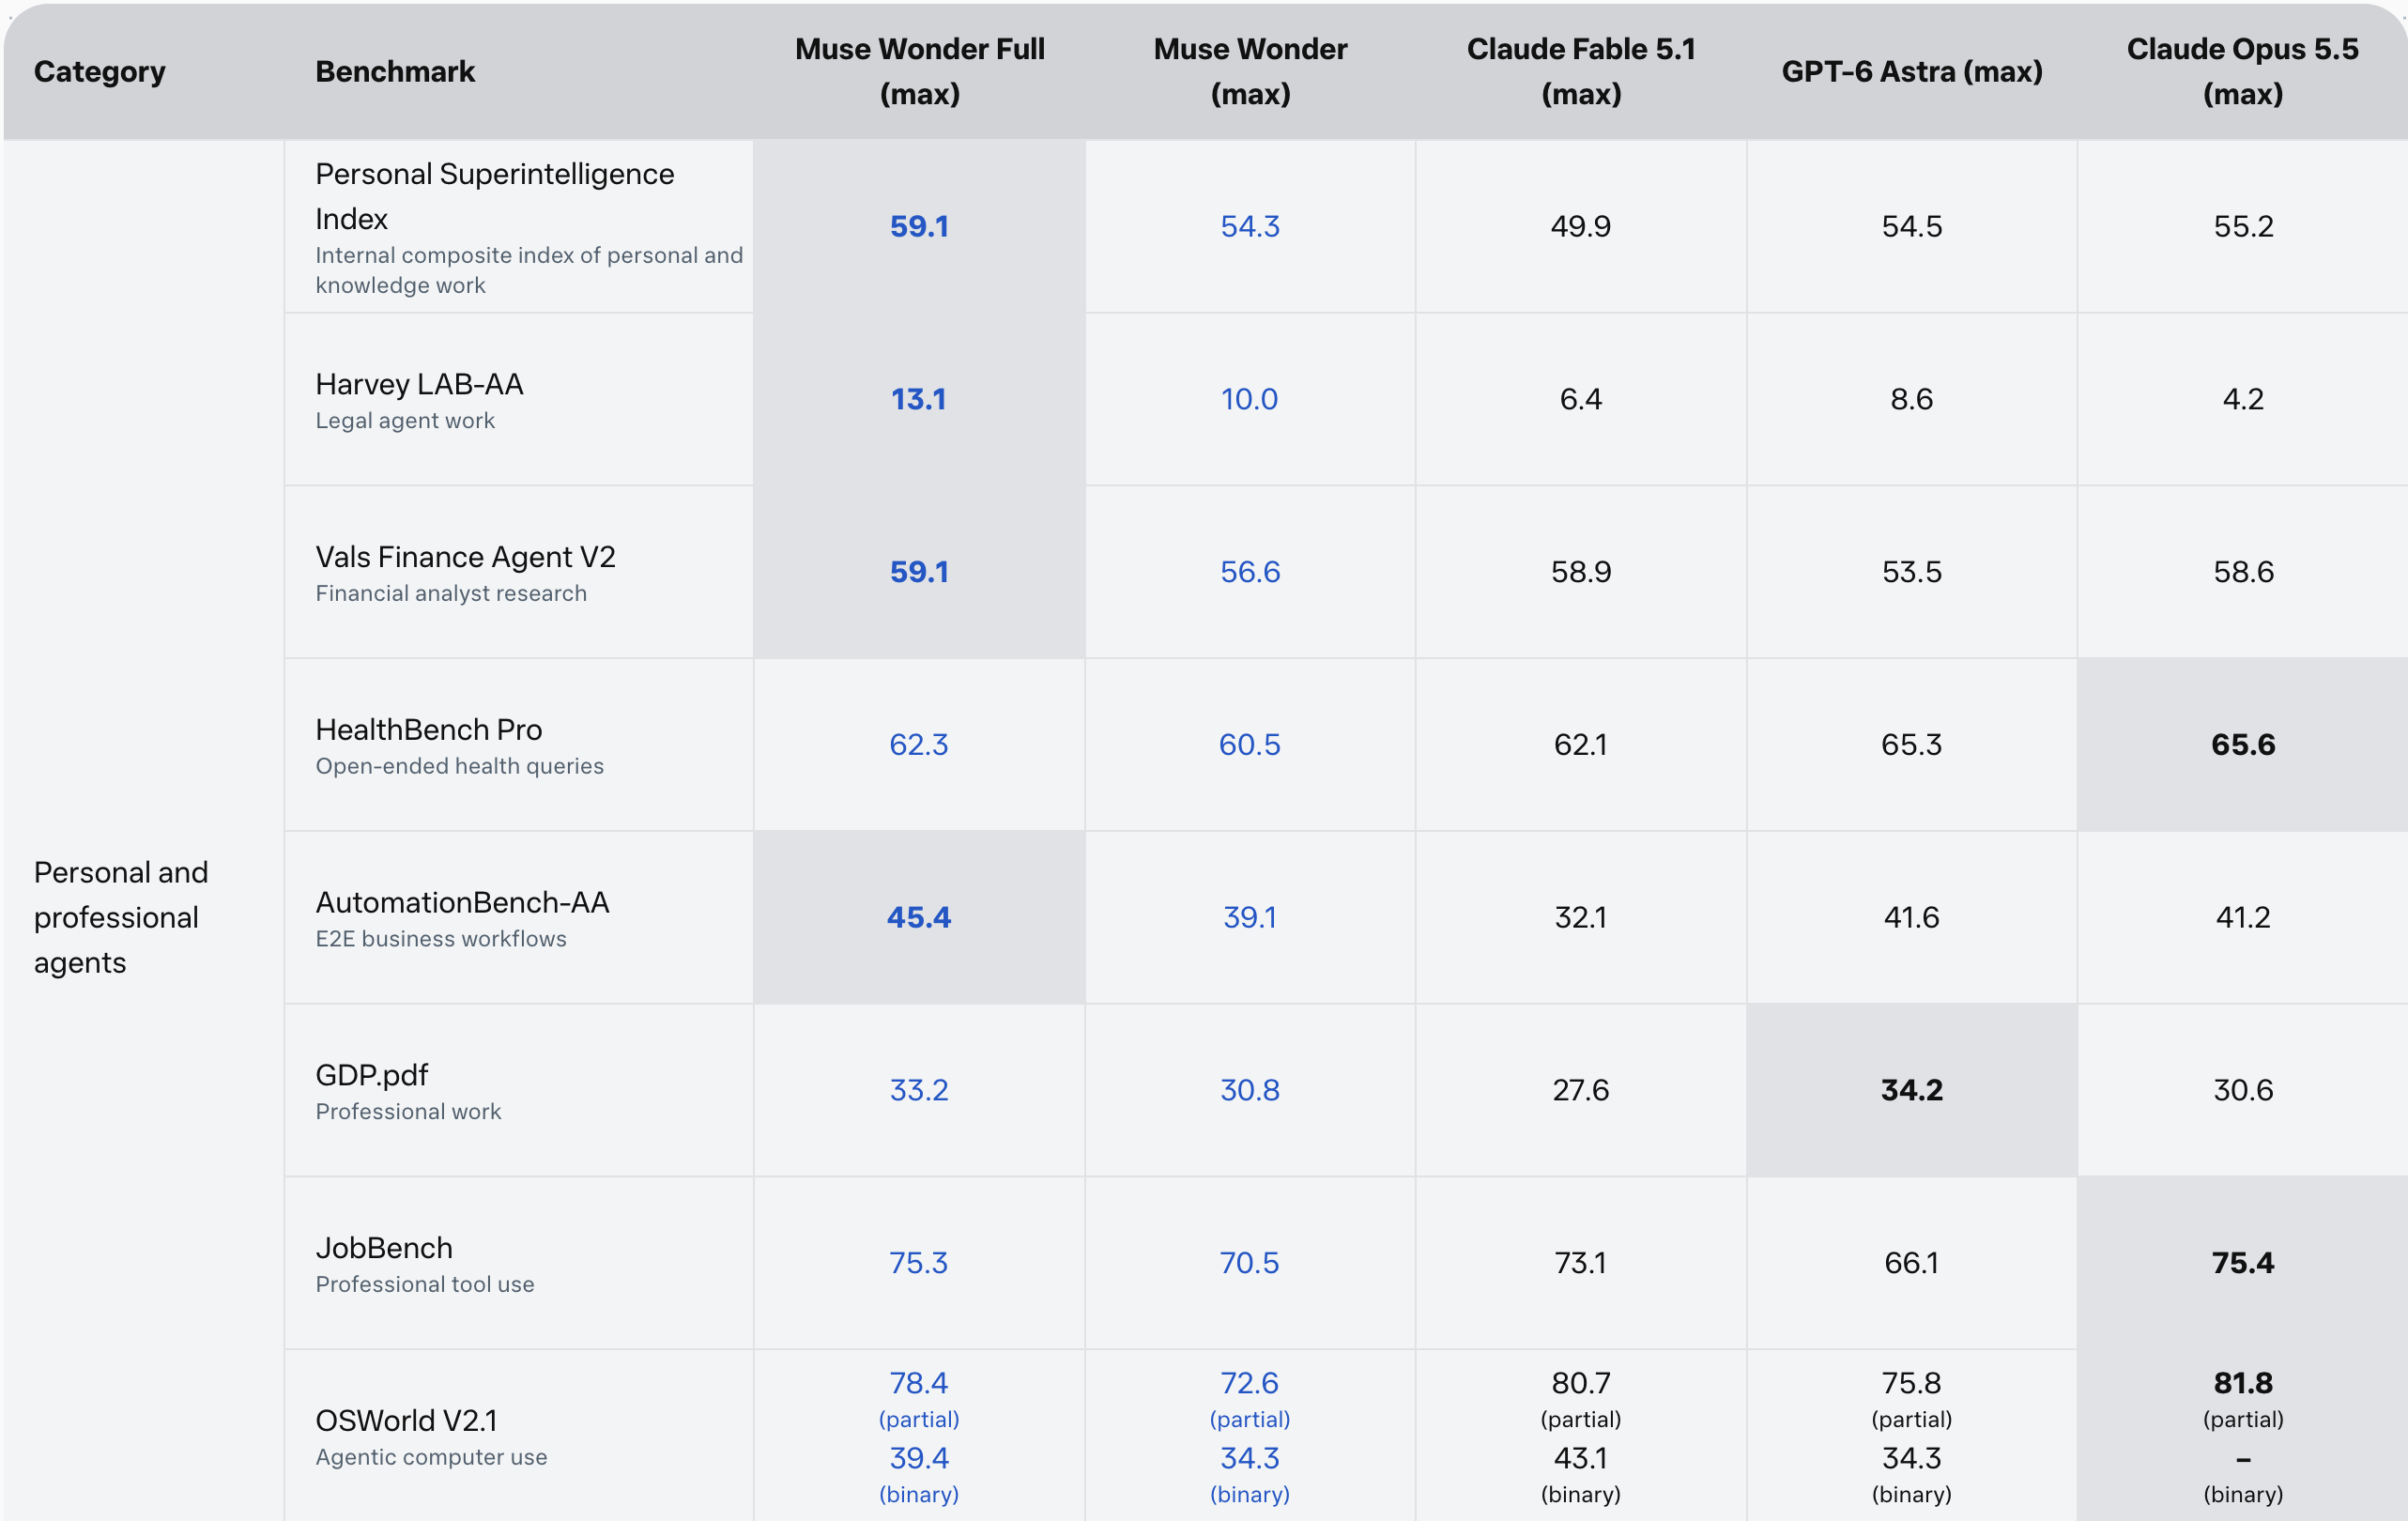
기억력은 메타가 가장 공들인 대목이다. 메타는 대화를 넘어 사용자에게 중요한 것을 기억했다가 필요할 때 꺼내는 능력을 액티브 메모리, 과제가 막혀도 다른 방법을 시도하고 오류에서 회복하며 중요한 일을 실행하기 전에 확인을 구하는 능력을 액티브 포커스라고 이름 붙였다. 맥락 기억을 재는 MemoryBench에서 Muse Wonder는 85.6점으로 표 안의 다섯 모델 가운데 가장 높았다. 카비야 코파라푸 메타 연구원은 발표 영상에서 "사용자에게 중요한 것을 며칠, 몇 주, 몇 달, 그 너머까지 모델이 기억하도록 엄청난 공을 들였다"고 말했다.
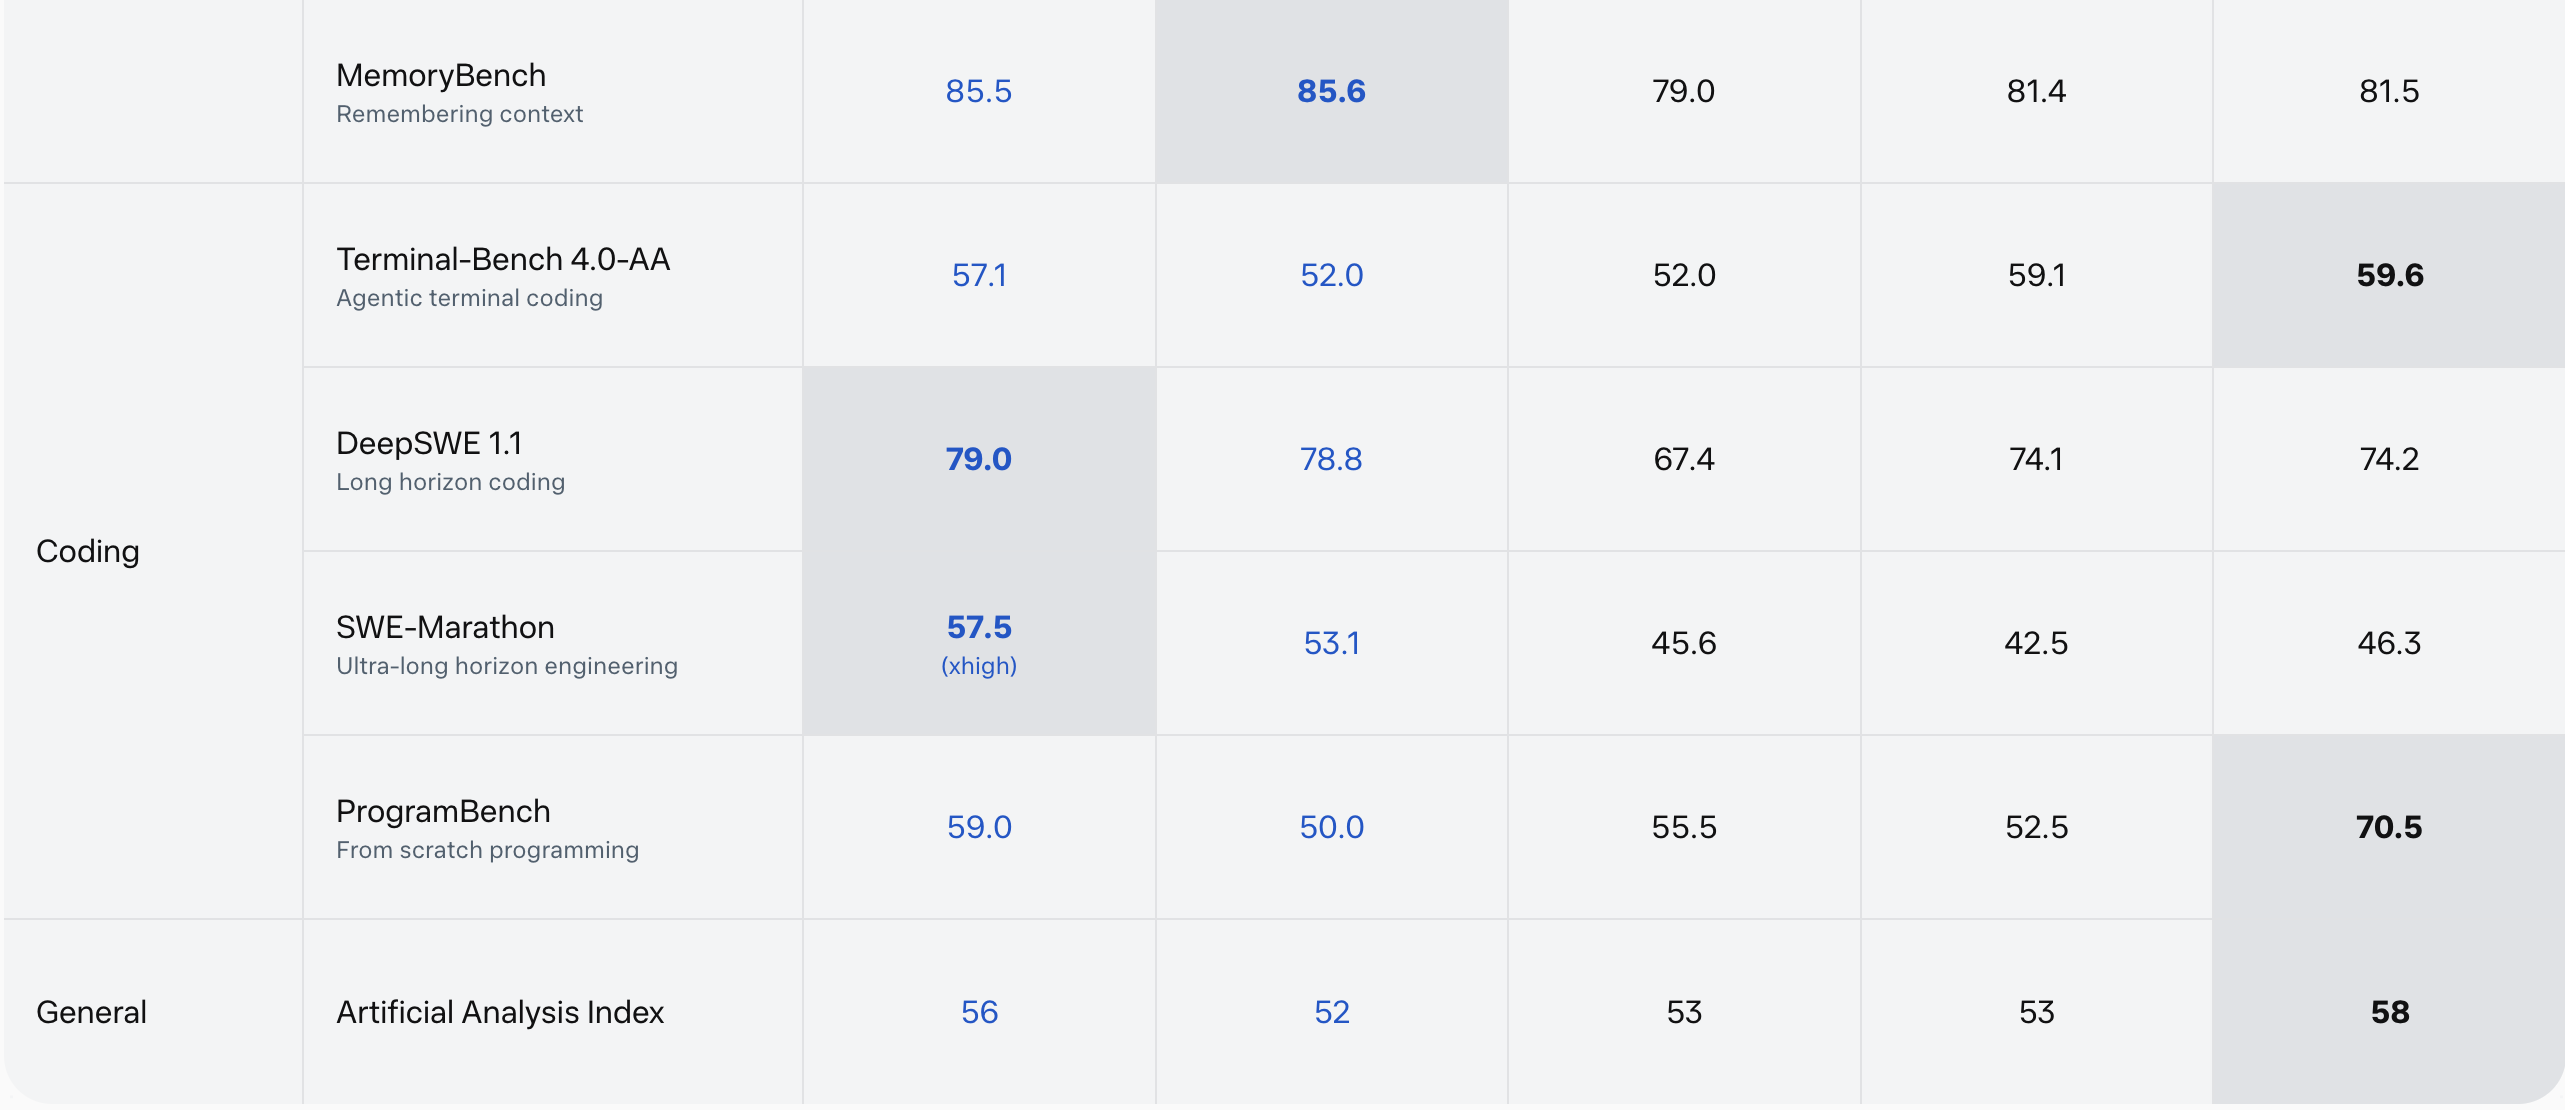
외부 측정도 비슷한 그림이다. 보도에 따르면 Artificial Analysis 지능 지수에서 Muse Wonder Full은 56점, Muse Wonder는 52점으로 전작 Muse Spark 1.3의 48점보다 크게 올랐고, Terminal-Bench 4.0 점수는 33%에서 57%로 뛰었다. 수학 증명 비공개 벤치마크 ProofBench에서는 100문제 중 94문제를 풀어 전작의 58문제를 크게 넘었다. 사실 지식은 약점으로 꼽혔다. 지식 시험 AA-Omniscience에서 Muse Wonder Full은 30점으로 Claude Opus 5.5의 46점, GPT-6 Astra의 43점, Gemini 4 Argon의 42점에 못 미쳤다. 대신 환각 비율은 전작의 33%에서 23%로 내려갔다. 메탈은 메타가 Muse Spark 1.3을 내놓으며 코딩 벤치마크를 앞세운 소식을 보도한 바 있으며, 이번에는 그 경량 모델 위에 대형 모델 층을 얹은 셈이다.
안전 장치도 함께 내놓았다. 메타는 개인 에이전트가 메시지와 일정, 문서를 넘나들며 일하는 만큼 두 모델이 허락 없이 개인정보를 공유하지 않고 실제로 해로운 행위를 돕는 요청을 거절하도록 훈련했다고 밝혔다. 보안 팀이 자기 코드의 결함을 찾는 작업은 그대로 할 수 있게 남겨 뒀다. 메타는 가장 강력한 모델을 메타 초지능 스케일링 프레임워크의 기준에 맞춰 훈련·평가·출시하며, 추가 안전성 평가를 담은 전체 보고서는 곧 공개한다고 덧붙였다.
다음 무대는 개인 에이전트 Muse다. 메타는 Muse Wonder가 곧 Muse의 더 많은 기능을 구동하며 구독자부터 적용된다고 밝혔다. 메탈은 메타가 보안 가상머신 위에서 도는 개인 에이전트 Muse를 내놓은 소식을 보도한 바 있다. 메타는 이번 공개를 "모두를 위한 개인 초지능을 향한 큰 걸음"이라고 불렀다. 표에 적힌 숫자 대부분은 메타 자체 측정이고 전체 안전성 보고서도 아직 나오지 않았다. 사용자의 메시지와 일정을 몇 달씩 기억하는 모델이 실제 Muse 사용 경험을 얼마나 바꾸는지가 이 숫자들을 판정할 첫 시험대다.
출처
- Meta — Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents →
- Meta — Muse Wonder | Meta for Developers →
- TechCrunch — Meta releases its first frontier model, Muse Wonder →
- The Decoder — Meta's new frontier model Muse Wonder Full breaks into the AI top tier →
- X — We're excited to introduce the Muse Wonder series (@AIatMeta) →
댓글