


이미지: METAL
요약
- 리퀴드AI가 비전·언어 모델 LFM2.5-VL-3B용 실험 초안 모델 LFM2.5-VL-3B-DSpark를 공개했어요.
- 디코딩은 M5 Max에서 최대 3.13배, H100에서 최대 2.66배 빨라지고, 초안 모델은 파라미터를 8.9%만 더해요.
- 이미지 인코딩과 사전 채우기는 가속되지 않아 종단 간 개선은 최대 2.62배와 2.27배에 머물러요.
- 발표
- 리퀴드AI 공식 블로그·허깅페이스 · X 2026년 9월 24일(미국 시간)
- 초안 모델
- LFM2.5-VL-3B-DSpark · 2억 7,950만 파라미터 · 본 모델 대비 8.9% · 어텐션 층 4개 · 학습 묶음 크기 9
- 학습
- 비전·언어 지도 미세조정 데이터 · 10에포크 · 실험·학습 모두 AMD 하드웨어
- M5 Max(MLX)
- 디코딩 2.30~3.13배 · 종단 간 1.56~2.62배
- M3 울트라(llama.cpp)
- 디코딩 1.57~2.14배 · 종단 간 1.30~1.77배
- H100(SGLang)
- 디코딩 2.04~2.66배 · 종단 간 1.64~2.27배 · 검증당 수락 3.46~4.57토큰
- 평가
- MMSpec 6개 작업 · 배치 1 · 온도 0 · 최대 2,048토큰 · 16비트
- 지원
- llama.cpp·MLX-VLM(v0.7.2+)·SGLang(v0.5.19+) · Safetensors·GGUF
리퀴드AI가 자사 비전·언어 모델 LFM2.5-VL-3B에 붙여 쓰는 실험용 초안 모델 LFM2.5-VL-3B-DSpark를 공개했어요. 이 비전 모델용 초안 모델을 달면 엔비디아 H100 한 장에서 글자를 만들어 내는 디코딩 속도가 최대 2.66배, 애플 M5 Max 맥북 프로에서는 최대 3.13배 빨라져요. 질문을 넣고 답을 다 받기까지의 종단 간 속도로 따지면 각각 최대 2.27배와 2.62배예요. 출력은 원래 모델이 혼자 낸 답과 같다고 회사는 밝혔어요.
원리는 추측 디코딩이에요. 작은 초안 모델이 다음에 올 토큰 여러 개를 미리 제안하고, 본 모델이 한 번의 계산으로 그 제안을 한꺼번에 검증해요. 맞은 토큰은 그대로 쓰고 틀린 지점부터는 본 모델이 고쳐 써요. 리퀴드AI는 8월 텍스트 모델용 LFM2.5-DSpark를 내놓았고, 이번에는 같은 방식을 이미지까지 읽는 모델로 넓혔어요.
이미지를 다루는데도 방식을 바꿀 필요가 없었던 이유를 리퀴드AI는 이렇게 설명했어요. 초안 모델은 본 모델의 정해진 몇 개 층에서 은닉 상태를 뽑아 그걸 보고 다음 토큰 묶음을 제안해요. 이미지 조각과 텍스트 토큰은 그 층에 닿기 전에 같은 크기의 벡터로 바뀌어요. 회사는 공식 블로그에서 "초안 모델 입장에서 입력이 텍스트인지 이미지인지는 상관이 없다"며 텍스트 모델과 똑같은 추론 알고리즘을 그대로 쓸 수 있다고 적었어요.
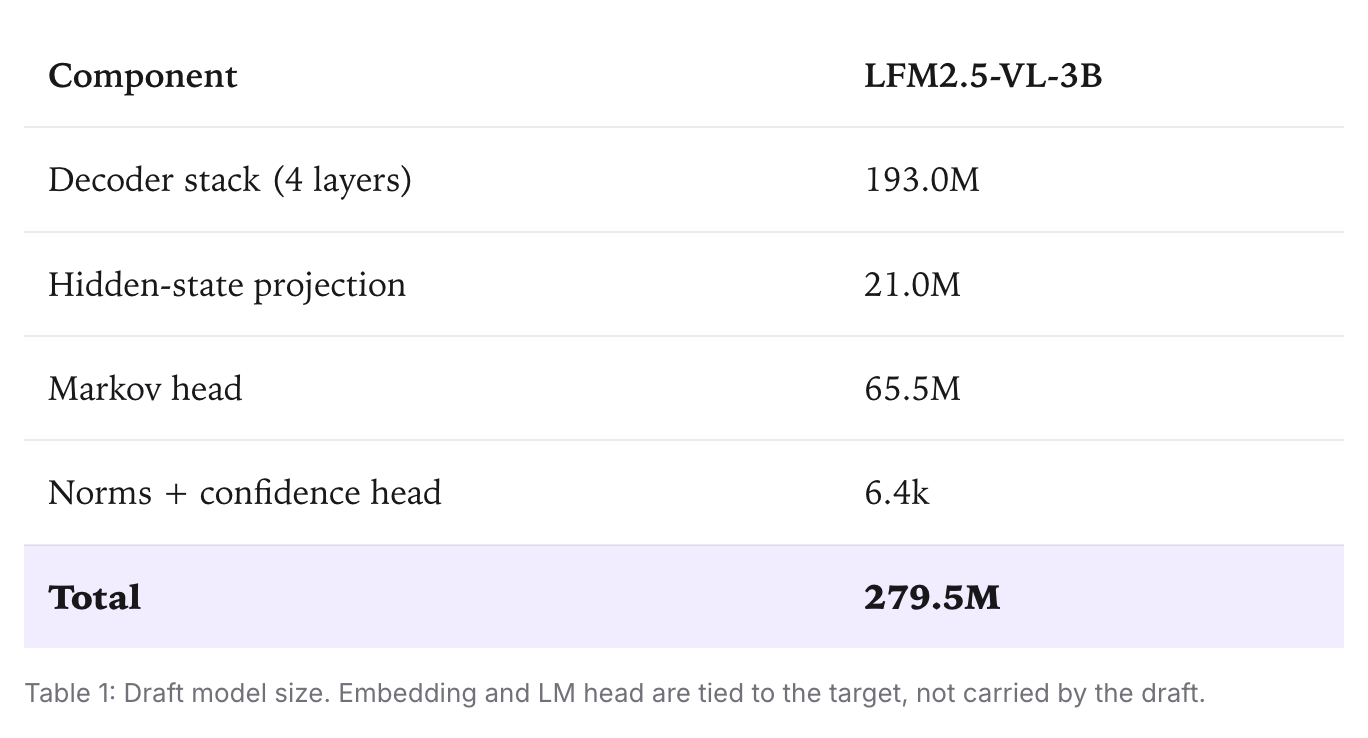
초안 모델의 크기는 2억 7,950만 개 파라미터로, 30억 파라미터급 본 모델에 8.9%만 더 얹는 수준이에요. 디코더 층 4개가 1억 9,300만 개, 은닉 상태 투영이 2,100만 개, 마르코프 헤드가 6,550만 개를 차지해요. 층 수는 3·4·5개를 비교하는 실험 끝에 4개로 정했고, 학습 때 한 번에 제안하는 토큰 묶음 크기는 9개예요. 학습 데이터는 비전·언어 지도 미세조정 데이터를 섞어 10에포크를 돌렸고, 실험과 학습은 모두 AMD 하드웨어에서만 진행했다고 회사는 밝혔어요.
성능은 MMSpec 벤치마크를 따라 일반 이미지 질의응답, 글자 읽기 질의응답, 이미지 설명, 차트 질의응답, 복합 추론, 여러 차례 대화 등 6가지 작업에서 쟀어요. 배치 크기 1, 온도 0, 출력은 최대 2,048토큰이고 답 길이 중앙값은 90토큰이에요. 맥북의 MLX에서는 작업별로 디코딩이 2.30~3.13배, 종단 간이 1.56~2.62배 빨라졌어요. M3 울트라의 llama.cpp에서는 디코딩 1.57~2.14배, 종단 간 1.30~1.77배였어요. H100의 SGLang에서는 디코딩 2.04~2.66배, 종단 간 1.64~2.27배였고, 본 모델이 한 번 검증할 때마다 초안 토큰을 평균 3.46~4.57개 받아들였어요.
작업별로 보면 차이가 뚜렷해요. 모델 카드 표에서 가장 큰 가속은 COCO 이미지 설명 작업에서 나왔어요. M5 Max에서 디코딩 3.13배, H100에서 2.66배예요. 반대로 여러 차례 대화 작업은 H100 2.04배, M3 울트라 1.57배로 가장 낮았어요. 초안이 얼마나 잘 맞는지는 하드웨어나 실행 환경보다 초안 모델과 작업 종류에 달려 있다고 회사는 분석했어요.
디코딩 가속이 종단 간 가속보다 늘 큰 데는 구조적인 이유가 있어요. 비전·언어 모델은 이미지를 먼저 비전 인코더에 통과시키고, 언어 본체가 수백 개의 시각 토큰과 텍스트를 함께 읽는 사전 채우기를 거쳐요. 추측 디코딩은 이 단계를 줄이지 못해요. 연산력이 데이터센터 GPU보다 훨씬 약한 기기에서는 이 단계가 전체 시간에서 차지하는 몫이 더 커요. 리퀴드AI는 "그 단계가 이미 전체 시간의 상당 부분을 차지하면 큰 디코딩 가속도 종단 간 지연에서는 완만한 개선에 그친다"며 이를 암달의 법칙으로 설명했어요.
운영 조건도 속도에 영향을 줘요. 온도를 높이면 확률이 순위가 낮은 후보 토큰으로 퍼지면서 초안과 본 모델의 의견이 갈리고, 수락률과 처리량이 함께 떨어져요. 동시 접속을 늘린 시험에서도 DSpark의 처리량 우위는 모든 구간에서 유지됐지만 격차는 좁아졌어요. 이번 수치는 모두 16비트 연산 기준이고, 양자화한 모델의 가속은 이번 공개 범위에 들어가지 않아요.
메탈이 확인한 허깅페이스 모델 카드에 따르면 초안 모델은 Safetensors와 GGUF 형식으로 올라와 있고, 첫날부터 llama.cpp와 MLX-VLM, SGLang에서 돌릴 수 있어요. SGLang은 v0.5.19 이상, MLX-VLM은 v0.7.2 이상이 필요해요. 측정은 리퀴드AI가 공개 기기 성능 데이터를 모을 때 쓰는 벤치마크 인프라 Pipette로 했어요. 메탈은 리퀴드AI가 텍스트 모델용 DSpark 초안 모델로 디코딩을 최대 3.18배 끌어올린 소식을 보도한 바 있어요.
엔지니어 입장에서 이번 공개의 값은 비전 모델도 메모리를 조금만 더 쓰면 같은 답을 더 빨리 낼 수 있다는 데 있어요. 본 모델을 다시 학습시키지 않고 옆에 작은 모델 하나를 붙이는 방식이라, 이미 LFM2.5-VL-3B를 쓰는 서비스라면 실행 옵션 몇 줄로 시험해 볼 수 있어요. 다만 기기 위에서 이미지 한 장에 짧게 답하는 작업이라면 체감 속도를 가르는 건 디코딩보다 이미지 인코딩과 사전 채우기라는 점을 설계 단계에서 따져야 해요.


댓글