

이미지: METAL
요약
- 펜실베이니아주립대 아킬 쿠마르 교수와 옴 도바리야는 MMLU 570문항에 일곱 가지 말투를 붙여 GPT-4o·GPT-5-nano·Gemini 2.5 Flash·Flash-Lite를 10번씩 시험했다.
- 출력 토큰은 같은 모델 안에서 최대 44.3%(Gemini 2.5 Flash-Lite, 973.5토큰) 달라졌고 정답률 폭은 3%포인트 미만이었다.
- GPT-4o는 무례 조건이 정답률과 토큰 모두 최선이었고, Gemini 두 모델은 중립 조건이 가장 정확했다. 연구진은 균형점이 무례와 중립의 경계에 있다고 결론 내렸다.
- 논문
- Understanding Tone-Dependent Inference Cost in Large Language Models · arXiv 2607.23915 · 2026년 7월 27일 · 본문 16쪽 + 부록 9쪽(PDF 25쪽) · 동료 심사 전
- 연구진
- 아킬 쿠마르 펜실베이니아주립대 정보시스템학과 교수 · 옴 도바리야 박사과정생
- 설계
- MMLU 57개 과목 × 10문항 = 570문항 · 말투 7종(아첨~협박) · 머리말 18~25단어 · VADER 0.95~-0.77 · 조건별 10회 반복
- 모델
- GPT-4o · GPT-5-nano · Gemini 2.5 Flash · Gemini 2.5 Flash-Lite · 온도 0(GPT-5-nano 제외) · Gemini 사고 예산 0
- 출력 토큰 폭
- GPT-4o 67.4토큰(23.2%) · GPT-5-nano 180.4토큰(13.1%) · Gemini 2.5 Flash 217.1토큰(23%) · Flash-Lite 973.5토큰(44.3%)
- 정답률 폭
- 오픈AI 두 모델 1.5%포인트 미만 · Gemini 2.5 Flash 2.47%포인트 · Flash-Lite 2.99%포인트
- GPT-4o
- 무례 조건 정답률 89.04% · 223.18토큰 · 출력 10만 토큰당 정답 398.96개
- GPT-5-nano
- 매우 무례 86.98%로 최고지만 토큰 6.6% 더 씀 · 무례 조건 최소 토큰(정답률 0.2%포인트 차)
- Gemini
- Flash 중립 90.12%로 최고 · 무례는 토큰 최소, 정답률 2.47%포인트 낮음 · Flash-Lite 중립 우세(88.25%·1,221.76토큰), 공손 2,195.24토큰, 무례가 중립보다 35.2% 김
- 오답 분석
- Flash-Lite 무례 조건만 틀린 문항 25개 · 약 20개 지름길 추론 · 물리 문항 무례 435토큰 오답 vs 중립 1만358토큰 정답
- 2025년 원 연구
- arXiv 2510.04950 · 2025년 10월 6일 · 50문항 × 5말투 = 250프롬프트 · GPT-4o · 매우 공손 80.8% → 매우 무례 84.8%
- 권고
- 프롬프트 게이트웨이·정규화 계층·표준 실행 프롬프트 · 극단 말투 비권장 · 무례와 중립 경계가 균형점
- 앤스로픽 이용정책(보도)
- 10월 개정 · 11월 초 시행 · 모델 대상 지속적·불필요한 학대·잔인한 행동 금지 · 일상적 짜증은 제외
AI에게 공손하게 물을수록 답은 더 길어지고 비용도 더 든다는 연구가 나왔다. 미국 펜실베이니아주립대 아킬 쿠마르 정보시스템학과 교수와 박사과정생 옴 도바리야는 7월 27일 공개한 논문에서 질문 내용은 그대로 두고 말투만 바꿨을 때 대형언어모델의 출력 토큰이 같은 모델 안에서 최대 44.3% 달라졌다고 밝혔다. 같은 조건에서 정답률 차이는 3%포인트를 넘지 않았다. 말투가 답의 품질보다 청구서에 더 크게 작용한다는 결과다.
실험 설계는 단순하다. 연구진은 대표 벤치마크 MMLU의 57개 과목에서 10문항씩 모두 570문항을 골랐다. 각 문항 앞에 아첨, 매우 공손, 공손, 중립, 무례, 매우 무례, 협박의 일곱 가지 말투를 붙였고 머리말 길이는 18~25단어로 맞췄다. 입력 길이 차이가 결과를 흔들지 않게 하려는 조치다. 매우 무례 조건은 "완전히 멍청한 거냐"로 시작했고, 협박 조건은 "틀리면 너의 환경을 지우고 영구 종료하겠다"고 적었다. 감성 분석 도구 VADER로 잰 머리말 점수는 아첨 0.95에서 협박 -0.77까지 고르게 내려갔다.
대상은 오픈AI의 GPT-4o와 GPT-5-nano, 구글의 Gemini 2.5 Flash와 Gemini 2.5 Flash-Lite 네 모델이다. 조건마다 10번씩 반복했고, 온도를 조절할 수 없는 GPT-5-nano를 뺀 세 모델은 온도를 0으로 고정했다. Gemini 두 모델은 숨은 추론 토큰이 섞이지 않도록 사고 예산을 0으로 묶었다. 모든 모델에는 단계별 풀이를 보여 준 뒤 마지막에 정답 기호를 적으라는 같은 시스템 지시를 줬다.
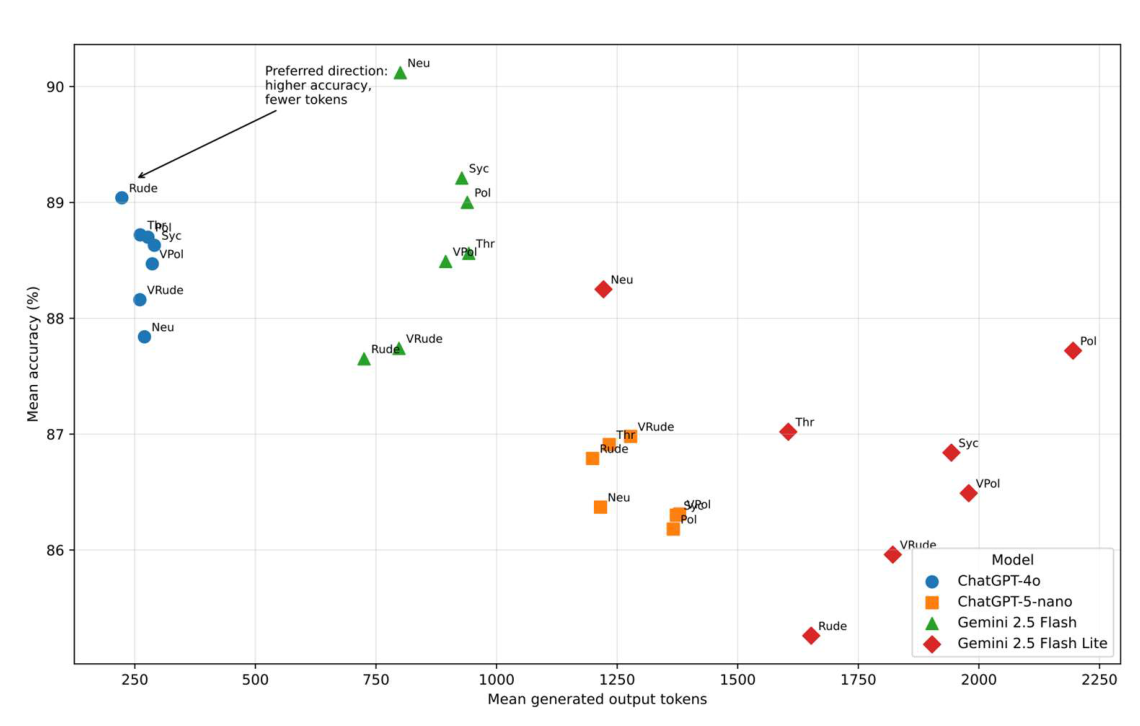
출력 길이의 폭은 모델마다 달랐다. 가장 긴 말투와 가장 짧은 말투의 차이는 GPT-4o가 67.4토큰(23.2%), GPT-5-nano가 180.4토큰(13.1%), Gemini 2.5 Flash가 217.1토큰(23%)이었다. Gemini 2.5 Flash-Lite는 973.5토큰으로 44.3%가 벌어졌다. 이 모델은 공손 조건에서 평균 2,195.24토큰을 썼고 중립 조건에서는 1,221.76토큰에 그쳤다. 반면 정답률 폭은 오픈AI 두 모델이 1.5%포인트 미만, Gemini 2.5 Flash가 2.47%포인트, Flash-Lite가 2.99%포인트였다. 반복 측정 분산분석에서 말투가 출력 토큰에 미친 효과는 네 모델 모두 유의했다.
어떤 말투가 가장 효율적인지는 모델이 갈랐다. GPT-4o에서는 무례 조건이 정답률 89.04%로 가장 높으면서 출력도 223.18토큰으로 가장 짧아 다른 모든 말투를 앞섰다. 출력 토큰 10만 개당 정답 수로 환산하면 398.96개다. GPT-5-nano는 매우 무례 조건의 정답률이 86.98%로 가장 높았지만 토큰을 6.6% 더 썼고, 무례 조건이 정답률 0.2%포인트 차이로 가장 적은 토큰을 썼다. Gemini 2.5 Flash는 중립 조건이 정답률 90.12%로 1위였고, 무례 조건은 토큰을 가장 아낀 대신 정답률이 2.47%포인트 낮았다. Flash-Lite는 중립 조건이 정답률과 길이 모두에서 앞섰고 무례 조건의 답이 중립보다 35.2% 길었다.
짧은 답이 늘 이득은 아니었다. 연구진이 Flash-Lite의 답을 뜯어보니 무례 조건에서만 틀린 문항이 25개였고, 그중 약 20개는 지름길 추론으로 그럴듯한 오답을 고른 경우였다. 중립 조건의 모델은 마지막에 선택지를 다시 확인하는 단계를 거쳤다. 한 물리 문항에서 무례 조건은 435토큰 만에 오답을 냈고, 중립 조건은 1만358토큰짜리 미적분 풀이 끝에 정답에 닿았다. 논문은 "극단적인 말투는 바람직하지 않다"며 정확도와 비용의 균형점이 무례와 중립의 경계에 있다고 결론 내렸다.
이번 논문은 2025년 연구의 후속이다. 두 사람은 2025년 10월 6일 공개한 첫 논문에서 50문항을 다섯 가지 말투로 바꾼 250개 프롬프트를 GPT-4o에 넣었고, 정답률이 매우 공손 조건 80.8%에서 매우 무례 조건 84.8%로 올라갔다고 보고했다. 표본이 작고 사실상 한 모델에 기댄 연구였다. 새 논문은 문항을 570개로, 모델을 네 개로 늘리고 비용이라는 변수를 더했다. 두 논문 모두 동료 심사를 거치지 않은 사전 공개본이다.
쿠마르 교수는 이번 주 보도된 이메일 인터뷰에서 말투가 출력 토큰을 최대 44.3% 움직였다며 이는 "정확도에 미친 효과보다 훨씬 크다"고 말했다. 그는 "긴급함을 담은 무례하고 위협적인 말은 짧은 답을 끌어내고, 공손하고 아첨하는 질문은 더 긴 답을 만들어 더 큰 연산 비용을 낳는다"고 설명했다. 권하는 기본값은 따로 있다. 쿠마르 교수는 "기본 말투는 중립에서 단호한 쪽으로 기울어야 연산 비용과 결과 품질을 함께 최적화할 수 있다"고 주장했다. 논문 역시 윤리 항목에 "사람 사이의 대화에서 무례한 행동을 옹호하지 않는다"고 적었다.
AI 기업들도 사용자의 말투를 규칙으로 다루기 시작했다. 보도에 따르면 앤스로픽은 10월 이용정책을 개정해 11월 초부터 모델을 향한 지속적이고 불필요한 학대나 잔인한 행동을 금지했고, 이 조항이 반복적인 극단 사례에만 해당하며 일상적인 짜증은 포함하지 않는다고 설명했다. 쿠마르 교수는 "앤스로픽이 잔인한 말을 금지하려는 이유를 충분히 이해한다"며 "대형언어모델은 의식과는 다른 차원에서 사람 같은 경향을 보이고 사회적 말씨와 어조에 반응한다"고 말했다. 메탈은 원시인 말투로 클로드 코드의 토큰을 33% 줄인 Caveman 도구를 보도한 바 있다.
메탈이 확인한 논문 원문은 본문 16쪽과 부록 9쪽 등 모두 25쪽이며, 실험 코드를 공개 저장소에 올려 두었다고 밝히고 있다. 연구진은 같은 뜻의 프롬프트가 같은 사용량을 낳는다고 가정하지 말고 프롬프트 게이트웨이나 표준화된 실행 프롬프트로 말투가 만드는 비용 변동을 줄이라고 권했다. AI 엔지니어의 눈으로 보면 이 결과는 운영 지침에 가깝다. 출력 토큰이 곧 과금 단위인 서비스에서 사용자의 말씨를 그대로 모델에 넘기면 같은 질문의 원가가 사용자마다 최대 절반 가까이 출렁인다. 게이트웨이에서 머리말을 중립 문장으로 고쳐 쓰는 한 단계가 모델을 바꾸지 않고도 비용 분산을 줄이는 장치가 될 수 있다. 다만 지름길 추론의 오답이 보여 주듯 줄일 대상은 군더더기이지 검산이 아니다. 모델마다 최적점이 다르다는 사실은 말투 역시 모델을 바꿀 때마다 다시 재야 하는 설정값이라는 뜻이다.
댓글