

이미지: METAL
요약
- 비스포크 랩스는 11월 21일 AI 장기 연구 평가 AutoResearchExam(ARE)의 평가 인프라로 모달의 CPU·GPU 샌드박스를 도입했다고 밝혔다.
- ARE는 29개 과제에서 에이전트가 24시간 동안 낸 해법의 숨은 테스트 점수를 시간 가중 평균한 AUARC로 순위를 매기며, Opus 5.5가 0.609로 1위다.
- 공개 당시 분석에서 Claude 모델은 하이퍼파라미터 튜닝 비중이 7%대로 가장 낮았고, 제출 횟수와 점수의 상관은 약했다.
- 발표
- 2026년 11월 21일 · 비스포크 랩스 X 공식 계정 · ARE 평가에 모달 CPU·GPU 샌드박스 도입
- 벤치마크
- AutoResearchExam · 2026년 9월 9일 공개 · 9월 15일 공식 하네스 공개 · 과제 29개 · 연구 분야 7개 · 24시간
- 실시간 순위
- Opus 5.5 0.609 · Fable 5.1 0.602 · GPT-6 Astra 0.600 · Gemini 4 Argon 0.594 · Opus 5 0.579 · Grok 4.7 0.523 · GPT-5.6 Sol 0.513
- 하위권
- Grok 4.6 0.493 · Gemini 3.8 Flash 0.484 · Kimi K3 0.435 · Qwen3.8 Max 0.423 · Muse Spark 1.3 0.379
- 평가 조건
- Terminus 2 하네스 · 무제한 제출 · 검증 점수만 공개 · 인터넷 차단 · 보상 해킹 감시 에이전트 · 턴당 출력 3만 2,000토큰
- 지표
- AUARC = 숨은 테스트 보상의 시간 가중 평균 · 기준 해법 0 · 참조 해법 대개 0.5
- 공개 당시 분석
- Astra 초반 약 3시간 선두 · Fable 5.1 3.2시간 추월 · 12시간 뒤 개선 비율 Muse 약 79%
- 검증-테스트 격차
- Opus 5 1.1% · Astra 1.7% · Fable 5.1 2.9% · 나머지 4.9~8.2%
- 튜닝 비중
- GPT-5.6 Sol 55.5% · Muse 47.5% · Opus 5 7.5% · Fable 5.1 7.0% (모델당 200라운드)
- 기타
- 제출 횟수-점수 상관 r = −0.26 · 힌트 실험 Opus 5 0.441→0.547(최종 0.592) · 하네스 비교 Claude Code Opus 5 0.513, 코덱스 Sol 0.435
비스포크 랩스가 자사 장기 연구 벤치마크 AutoResearchExam(ARE)의 평가 인프라로 컴퓨팅 파트너 모달의 CPU·GPU 샌드박스를 도입했다고 11월 21일 X에서 밝혔다. 회사는 "ARE는 에이전트에게 실제 머신러닝 연구에 24시간을 주는, 가장 긴 호흡의 벤치마크 가운데 하나"라며 "품질과 속도, 일반화를 측정한다"고 설명했다. 이 벤치마크의 실시간 순위표에서는 앤스로픽의 Opus 5.5가 평균 테스트 AUARC 0.609로 1위에 올라 있다.
ARE는 2026년 9월 9일 처음 공개됐다. 과제는 29개이고 모델 학습, 알고리즘·최적화, 데이터 엔지니어링·큐레이션, 시스템·효율, 평가·견고성, AI 안전·정렬, 해석 가능성 7개 연구 분야에 걸친다. 하프치타 로봇 정책 학습, CPU에서 언어 모델 생성 속도 높이기, 영상 확산 모델 가속, 언어 모델 활성값의 희소 코딩 같은 과제가 들어 있다. 9월 15일에는 공식 하네스가 공개돼 외부에서도 같은 조건으로 평가를 돌릴 수 있게 됐다.
순위표 상위권은 근소한 차이로 갈린다. Opus 5.5 다음으로 Claude Fable 5.1이 0.602, GPT-6 Astra가 0.600, 구글 Gemini 4 Argon이 0.594, Claude Opus 5가 0.579를 기록했다. Grok 4.7은 0.523, GPT-5.6 Sol은 0.513, Grok 4.6은 0.493, Gemini 3.8 Flash는 0.484였고 Kimi K3 0.435, Qwen3.8 Max 0.423, Muse Spark 1.3 0.379가 뒤를 이었다. 비용 대비 성능 도표에서 Opus 5.5는 Fable 5.1보다 적은 과제당 API 비용으로 더 높은 점수를 내 효율 경계선 위에 섰다. 비스포크 랩스는 Argon의 비용을 구글 정가로 환산했고, 12월 1일까지 적용되는 할인가로는 그 절반이라고 적었다.
평가 방식은 이렇다. 에이전트는 Terminus 2 하네스에서 24시간 동안 원하는 만큼 결과를 제출할 수 있고, 제출할 때마다 검증 점수와 남은 시간만 돌려받는다. 실제 순위를 가르는 숨은 테스트 점수는 끝까지 보지 못한다. 작업 컨테이너와 채점 컨테이너는 분리돼 있고, 인터넷 접속은 막혀 있으며, 보상 해킹을 잡는 별도 감시 에이전트가 환경과 결과를 검사한다. 모델은 각자 쓸 수 있는 가장 높은 추론 수준으로 돌렸고, 한 턴 출력은 3만 2,000토큰으로 묶었다.
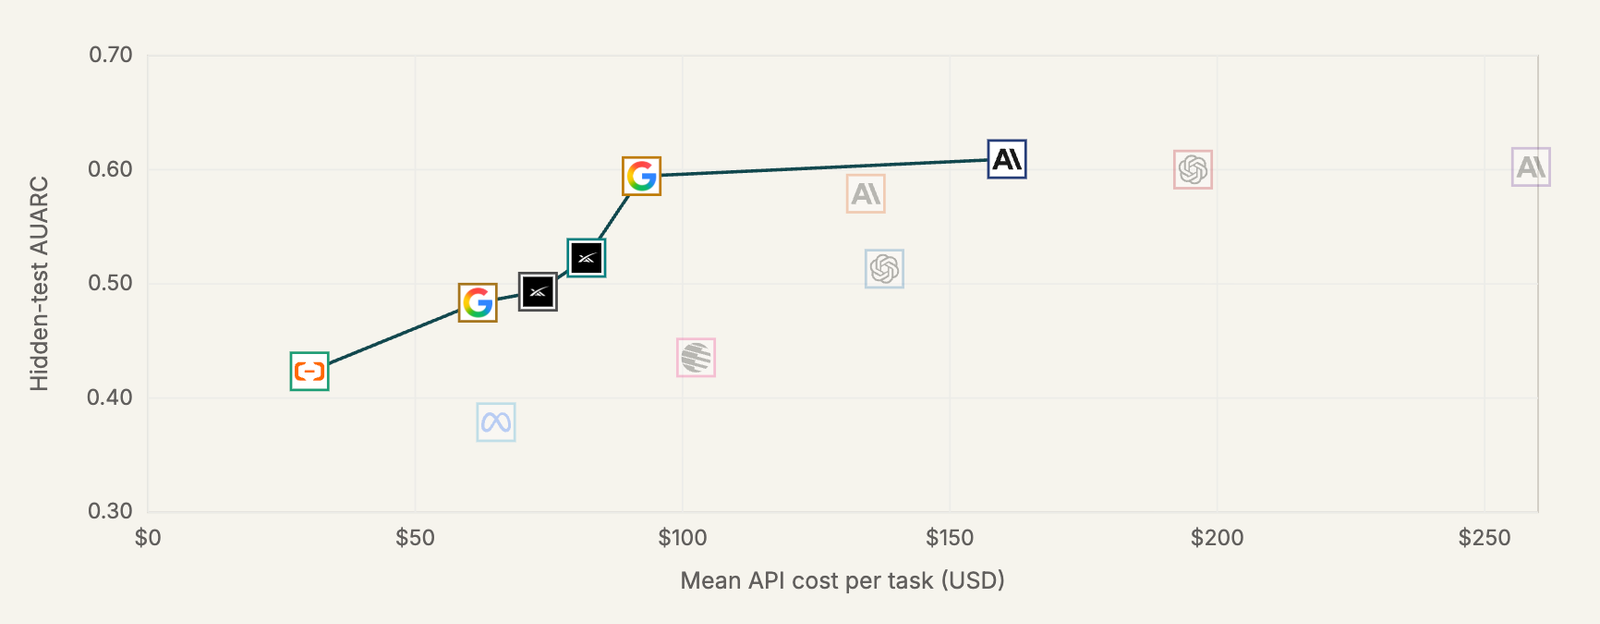
핵심 지표인 AUARC는 숨은 테스트 점수를 시간에 따라 가중 평균한 값이다. 같은 개선이라도 일찍 이루면 점수가 더 오른다. 과제마다 단위가 다른 원점수는 보상으로 바꿔 맞춘다. 단순한 기준 해법은 0, 강한 참조 해법은 대개 0.5를 받는다. 연구진은 "한 번에 끝내는 평가는 이 진화 과정을 측정할 기회를 놓친다"며 "뒤에서 출발해도 피드백을 잘 쓰는 에이전트가 결국 더 느리게 나아지는 에이전트를 앞지를 수 있다"고 썼다.
9월 공개 당시 분석은 시간 창에 따라 순위가 바뀐다는 점을 보여 줬다. GPT-6 Astra는 강한 첫 해법으로 출발해 처음 약 3시간 동안 앞섰고, Fable 5.1이 3.2시간 무렵 추월한 뒤 24시간 시점에 근소하게 1위를 지켰다. 12시간이 지난 뒤에도 점수가 오른 실행의 비율은 Muse Spark 1.3이 약 79%로 가장 높았고 Qwen과 Grok이 약 76%였다. 검증 점수와 테스트 점수의 상대 격차는 Opus 5가 1.1%, Astra가 1.7%, Fable 5.1이 2.9%로 작았고 나머지 모델은 4.9%에서 8.2% 사이였다.
연구 방식의 차이도 수치로 잡혔다. 모델마다 무작위로 뽑은 200라운드를 분류하자 기존 방법의 설정값만 바꾸는 하이퍼파라미터 튜닝 라운드가 GPT-5.6 Sol은 55.5%, Muse Spark 1.3은 47.5%였다. Claude Opus 5는 7.5%, Fable 5.1은 7.0%에 그쳤다. 제출 횟수와 테스트 점수의 상관계수는 마이너스 0.26으로 약했다. 연구진은 "제출을 늘리는 단순한 언덕 오르기만으로는 부족하고 연구 단계의 질이 중요하다"고 결론지었다. 하네스를 바꿔도 모델 간 순위는 같았다. 5개 과제 12시간 비교에서 Claude Code의 Opus 5는 테스트 AUARC 0.513, 코덱스의 GPT-5.6 Sol은 0.435였다.
메탈이 확인한 벤치마크 페이지에는 힌트 실험도 실려 있다. 24시간 연구에서 얻은 통찰을 한 문장 힌트로 줄여 200턴짜리 실행에 넣자, 22개 CPU 과제 평균에서 Opus 5의 숨은 테스트 보상이 0.441에서 0.547로 올랐다. 24시간을 다 쓴 최종 점수 0.592에 바짝 다가선 값이다. 메탈은 앤스로픽이 Claude Opus 5.5를 공개한 소식을 보도한 바 있다.
AI 연구 자동화를 지켜보는 쪽에서 이 벤치마크의 무게는 순위보다 측정 단위에 있다. 비스포크 랩스는 첫 문장부터 재귀적 자기 개선을 목표로 걸었고, 그 진척을 하루 단위 연구 능력과 처음 보는 데이터에서의 일반화로 재겠다고 했다. 상위 다섯 모델이 0.579에서 0.609 사이에 몰려 있다는 사실은 최상위 모델의 장기 연구 능력이 비슷한 수준까지 올라왔다는 뜻이다. 차이는 검증 점수에 맞춰 과적합하지 않는 습관, 설정값 조정보다 새 방법을 시도하는 비율, 그리고 비용에서 난다. 평가를 외부 클라우드 샌드박스로 옮긴 이번 조치로 하루짜리 연구 실험을 더 많은 모델에 더 자주 돌릴 기반이 생겼다.
댓글