

이미지: 영상 갈무리
요약
- 오픈AI는 11월 20일 논문·특허 117건에서 뽑은 의약화학 문제 99개로 구성된 벤치마크 MedChemBench를 공개하고 27쪽 논문을 함께 냈다.
- xhigh 추론 설정에서 GPT-6.2 Astra 84.5%, GPT-6 Astra 83.3%, GPT-6.1 Sol 82.0%, GPT-5.6 Sol 58.2%를 기록했다.
- GPT-6 Astra는 분자 구조 배점의 95.37%를 얻었지만 화합물 선택 50.42%, 수치 예측 47.02%에 그쳤고, 연구진은 벤치마크가 포화에 가깝다고 밝혔다.
- 공개
- 2026년 11월 20일 · 오픈AI 발표문 · 논문 27쪽(11월 9일자 · 저자 6명)
- 구성
- 문제 99개 · 논문·특허 117건 · 분자 구조 761개 · 출처 연도 중앙값 2025년
- 유형
- 7종 · 통합 선도물질 선택 48 · 구조활성관계 예측 26 · ADME 8 · 분자 설계 6 · 안전성 4 · 역합성 4 · 분석법·기전 3
- 배점 비중
- 분자 구조 37.49% · 과학적 설명 35.78% · 순위·선택 17.51% · 수치·범주 예측 8.92%
- xhigh 점수
- GPT-6.2 Astra 84.5% · GPT-6 Astra 83.3% · GPT-6.1 Sol 82.0% · GPT-6.1 Terra 75.1% · GPT-5.6 Sol 58.2%
- 구조 점수
- GPT-6 Astra 95.37% · GPT-5.6 Sol 47.31% · GPT-6 Luna 12.42%
- 18원자 고리 문제
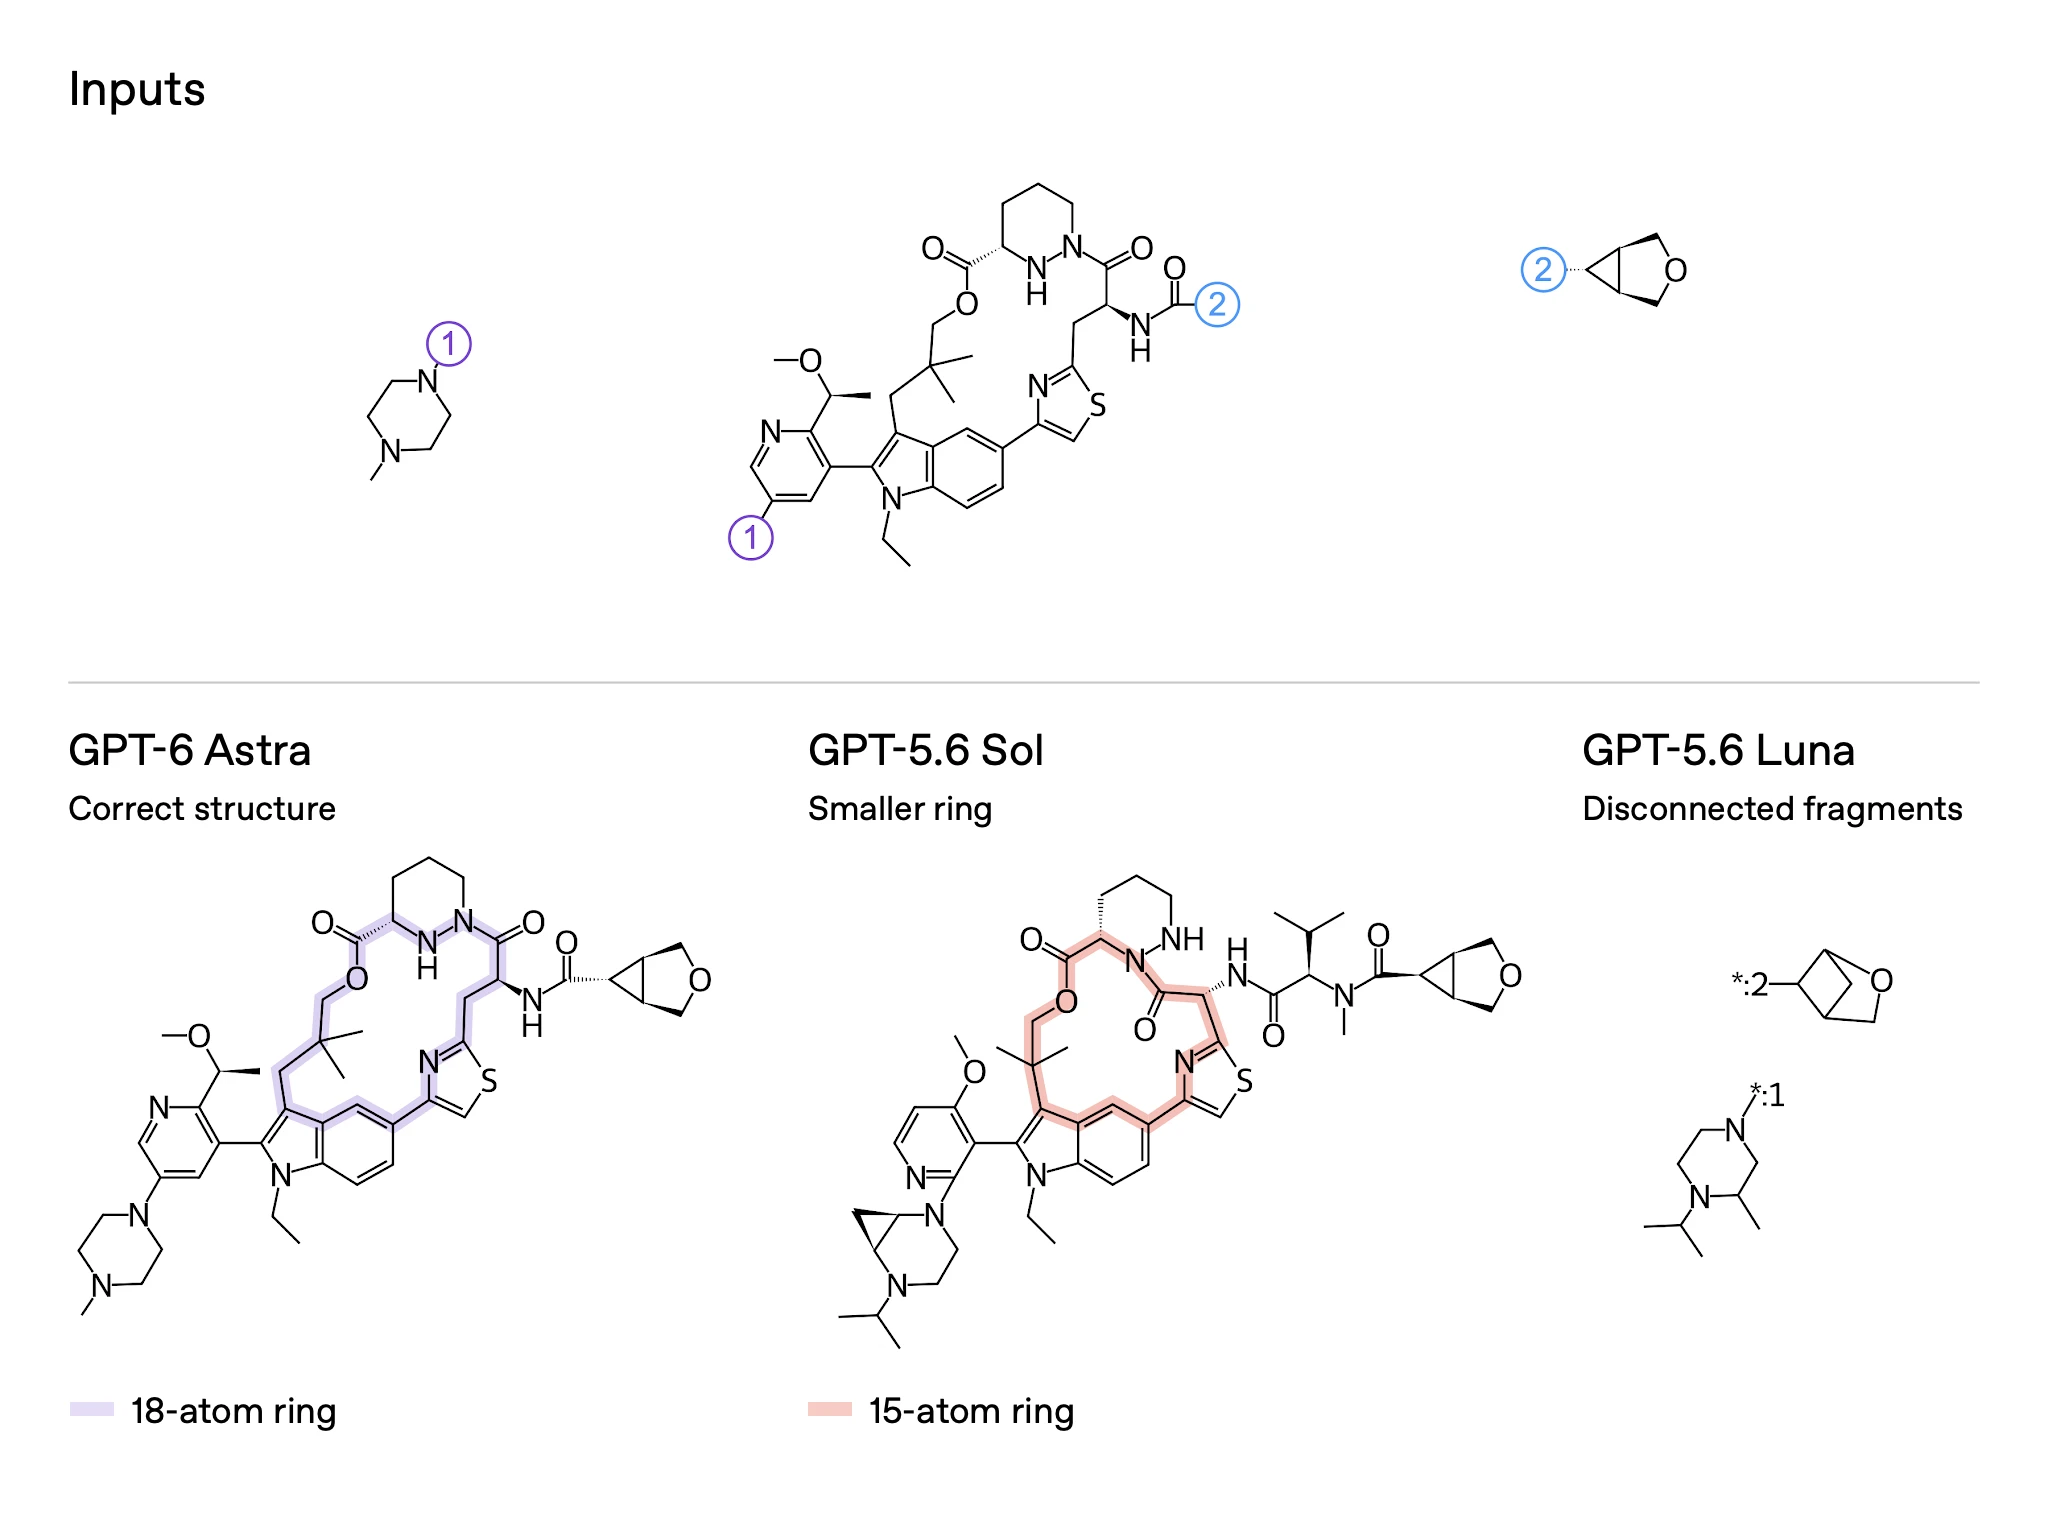
- GPT-6 Astra 10/10 정답 · GPT-5.6 Sol·Luna 0/10 · Sol 예시 답 15원자 고리, 67원자
- 평가 규모
- 11개 모델 · 61개 조건 · 응답 6만 390개
- 오염 점검
- DOI·특허 번호 추가 시 점수 변화 -0.23~+0.80%포인트 · 순위 불변
오픈AI가 11월 20일 의약화학 연구에서 AI 모델이 얼마나 추론을 잘하는지 재는 벤치마크 MedChemBench를 공개했다. 분자 구조를 읽고, 실험 결과를 해석하고, 다음에 어떤 화합물을 시험할지 고르는 능력을 99개 문제로 측정한다. 가장 높은 추론 설정(xhigh)에서 GPT-6.2 Astra가 배점의 84.5%를 얻었고, GPT-6 Astra 83.3%, GPT-6.1 Sol 82.0%, GPT-5.6 Sol 58.2%가 뒤를 이었다. 메탈은 오픈AI가 GPT-6.2 Astra와 Sol을 출시한 소식을 보도한 바 있다.
의약화학이 어려운 이유는 분자의 한 성질을 고치면 다른 성질이 나빠지기 쉽다는 데 있다. 오픈AI는 발표문에서 질병 관련 단백질에 강하게 작용하는 화합물도 몸에 잘 흡수되지 않거나 너무 빨리 분해될 수 있다고 설명했다. 의약화학자는 비슷한 화합물을 설계하고 합성하고 시험한 뒤 다음 후보를 정하는 과정을 되풀이한다. MedChemBench는 이 판단을 AI가 대신할 수 있는지가 아니라, 구조 변화와 실험 증거를 연결해 추론할 수 있는지를 본다.
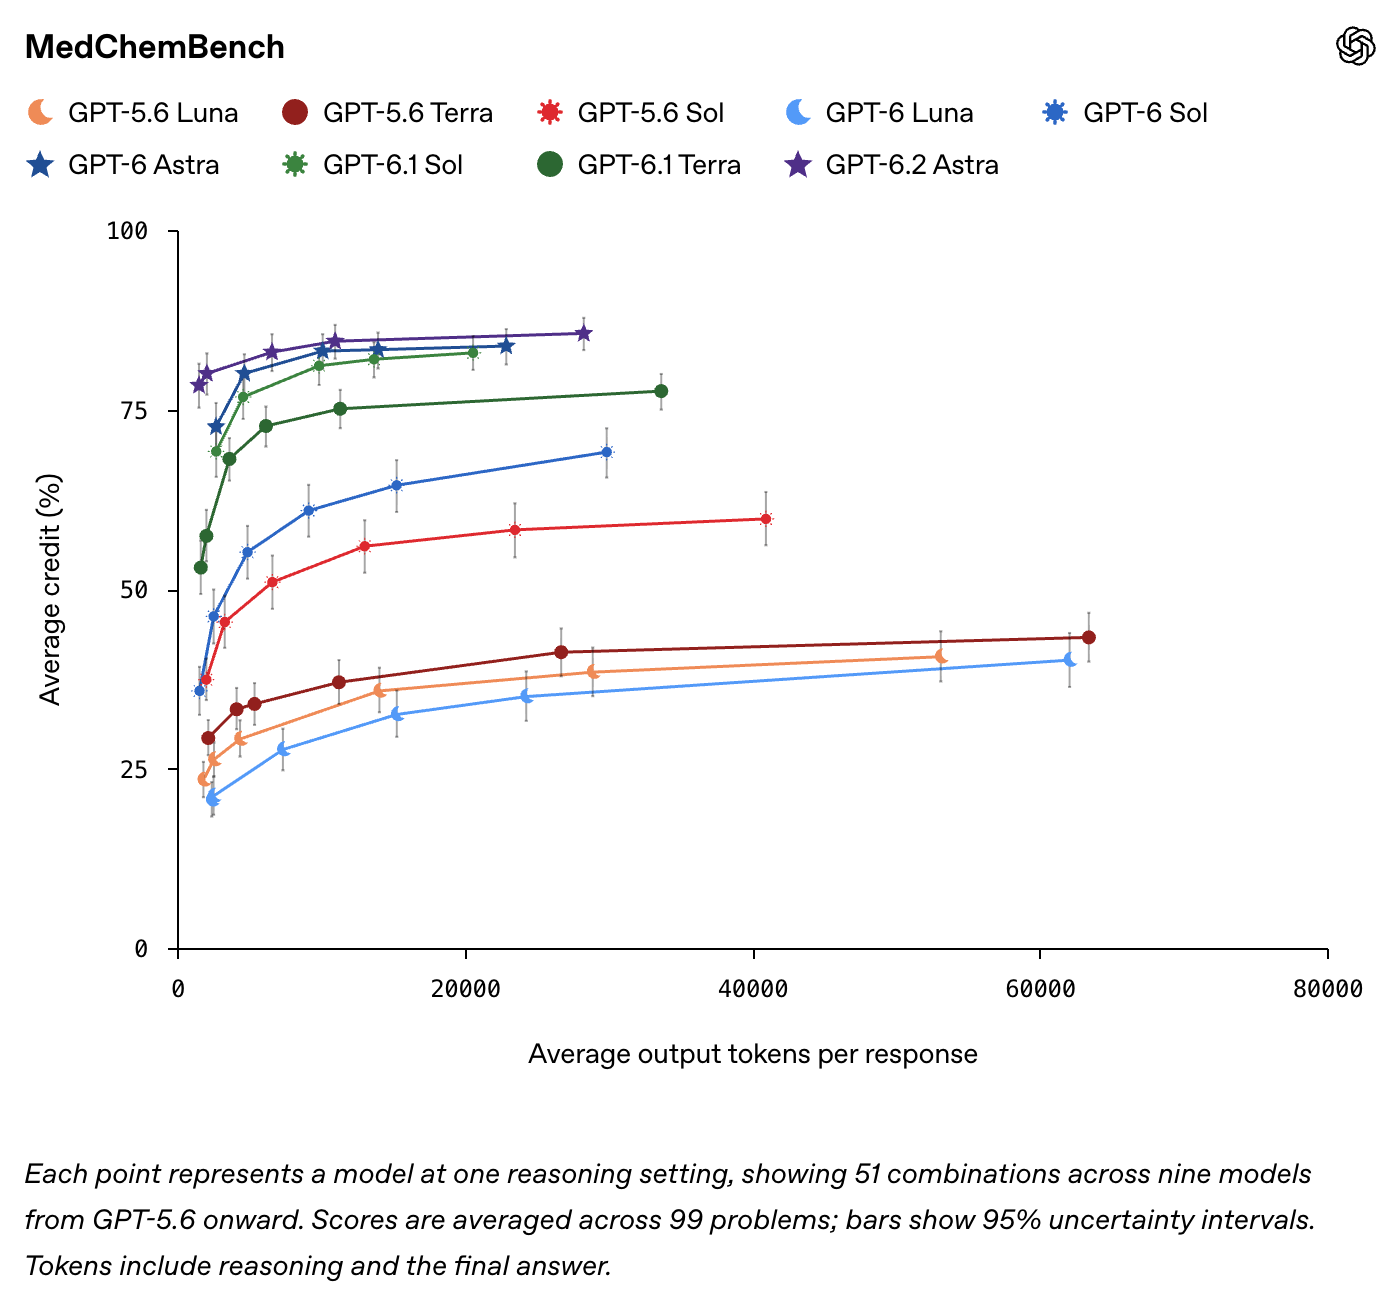
문제는 최근 발표된 논문과 특허 117건에서 뽑았고, 채점 대상 분자 구조는 761개다. 출처 문헌의 발표 연도 중앙값은 2025년이다. 각 문제는 연구 프로그램의 특정 시점까지의 맥락, 즉 표적 단백질과 연구 목표, 지금까지 시험한 화합물, 일부 실험 결과를 준다. 그 시점 이후 원 논문에 나온 결과는 감춰 두고 정답과 채점 기준으로만 쓴다. 문제 유형은 일곱 가지로, 여러 조건을 따져 다음 후보를 고르는 통합 선도물질 선택이 48개로 가장 많고 구조 변화의 효과를 예측하는 구조활성관계 예측이 26개다.
채점은 네 갈래다. 분자 구조를 정확히 재구성했는지, 근거를 들어 설명했는지, 화합물 순위와 선택이 조건에 맞는지, 수치와 범주 예측이 실측값에 가까운지를 본다. 99개 문제 평균으로 분자 구조가 배점의 37.49%, 과학적 설명이 35.78%, 순위·선택이 17.51%, 수치·범주 예측이 8.92%를 차지한다. 수치 예측은 실측값의 두 배나 절반을 맞히면 절반만 인정하는 방식이고, 설명 항목은 별도의 GPT-6 Astra 채점 모델이 중간 추론 설정으로 평가한다.
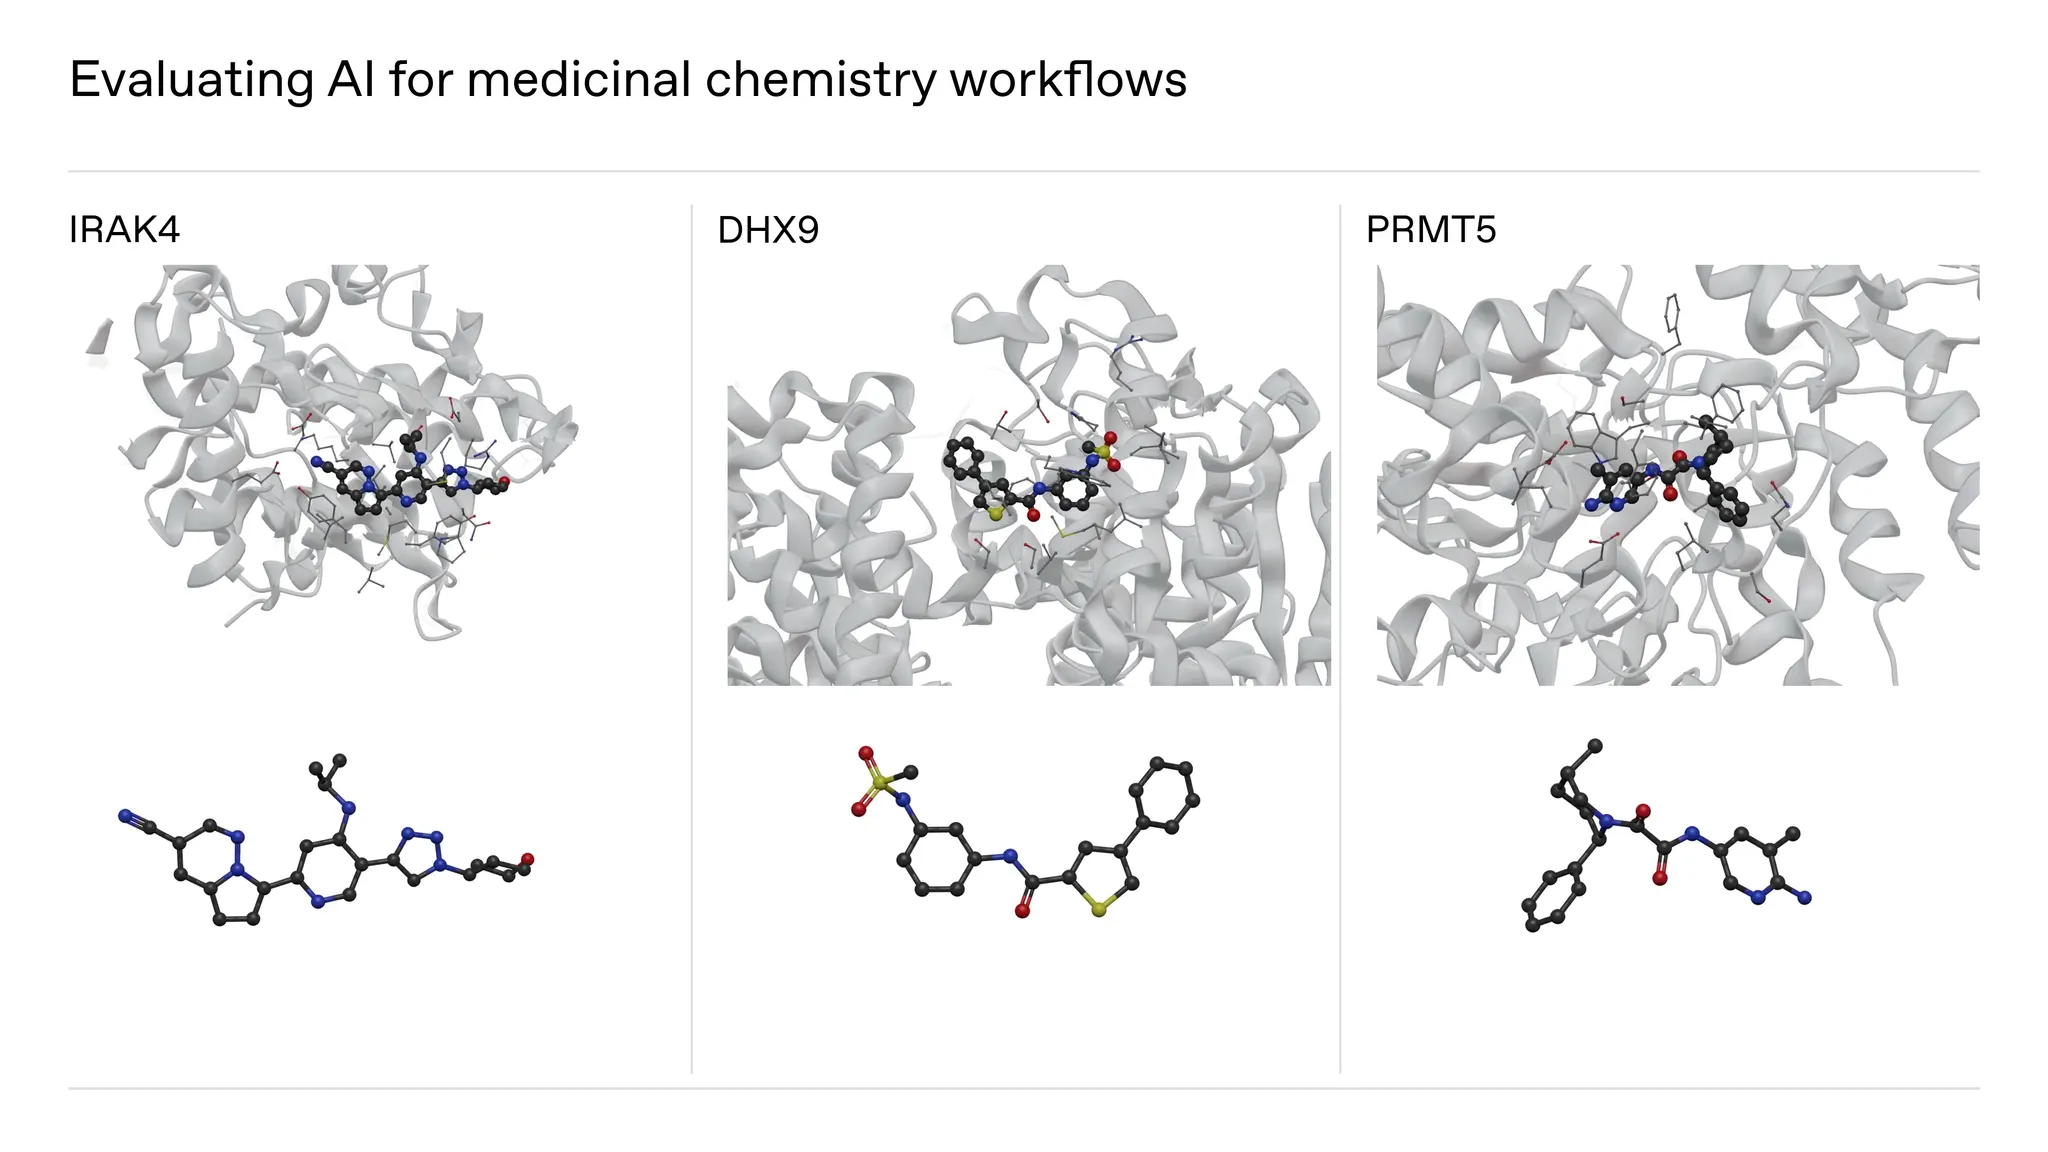
발표문이 든 첫 사례는 암 신약 표적으로 연구되는 단백질 PRMT5의 억제제다. 모델은 이전 실험의 구조와 결과를 받고, 관련 화합물 세 개가 세포에서 PRMT5를 얼마나 막는지, 세포 장벽을 얼마나 잘 통과하는지, 간 효소에 얼마나 빨리 분해되는지를 예측해야 한다. 감춰 둔 후속 실험에서 화합물 23은 더 낮은 농도로 PRMT5를 막았고, 화합물 24는 장벽을 더 잘 통과하며 더 천천히 분해됐다. 표적에 강하게 듣는 분자가 꼭 몸 안에서도 유리한 것은 아니라는 의약화학의 기본 난제를 그대로 옮긴 문제다.
모델 간 격차가 가장 크게 벌어진 곳은 분자 구조였다. 논문에 따르면 xhigh 설정에서 GPT-6 Astra는 구조 배점의 95.37%를 얻었지만 GPT-5.6 Sol은 47.31%, GPT-6 Luna는 12.42%에 그쳤다. 18개 원자로 된 고리를 유지한 채 중심 구조에 두 작용기를 붙이는 문제에서 GPT-6 Astra는 열 번 모두 정답을 냈고 GPT-5.6 Sol과 GPT-5.6 Luna는 열 번 모두 실패했다. 예시로 실린 GPT-5.6 Sol의 답은 고리 원자가 18개가 아니라 15개였고 수소를 뺀 원자 수도 60개가 아니라 67개였다. GPT-5.6 Luna는 분자를 서로 이어지지 않은 두 조각으로 내놨다. 오픈AI는 이런 오류가 분석 대상 분자 자체를 바꾼다고 지적했다.
메탈이 확인한 27쪽 분량의 논문에 따르면 오픈AI 연구진은 GPT 모델 11종을 추론 설정별로 61개 조건에서 돌려 문제마다 응답 열 개씩, 모두 6만 390개 응답을 채점했다. 교신저자 제러미 리와 수야시 슈링가르푸레 등 연구진 6명은 논문에서 "MCB는 신약 개발 과정을 돕는 프런티어 모델의 떠오르는 유망한 능력을 측정한다"고 썼다. 같은 논문에서 연구진은 "이 벤치마크는 현재 형태로 포화에 가깝다"며 다음 판은 더 어려워져야 모델 성능을 계속 가를 수 있다고 밝혔다. 구조 점수와 달리 GPT-6 Astra도 화합물 선택(50.42%)과 수치 예측(47.02%)에서는 배점의 절반 안팎만 얻었다.
연구진은 모델이 원 논문을 학습 중에 봤을 가능성도 따졌다. 99개 문제 프롬프트에 출처 논문의 DOI나 특허 번호를 넣고 다시 돌린 결과, 모델별 평균 점수 변화는 -0.23~+0.80%포인트였고 순위는 바뀌지 않았다. 다만 연구진은 이 시험으로 출처 문헌이 학습 데이터에 있었는지를 확정할 수는 없다고 적었다. 오픈AI도 발표문에서 각 응답은 도구나 피드백, 새 실험 없이 한 번에 낸 답이며 이 결과가 모델이 새 약을 발견하거나 실험실의 결정을 개선한다는 뜻은 아니라고 밝혔다.
AI 엔지니어의 눈으로 보면 이 벤치마크가 드러낸 것은 능력의 비대칭이다. 그림으로 된 분자를 정확한 그래프로 옮기는 공간 추론은 최신 모델에서 사실상 풀린 문제가 됐지만, 여러 성질을 저울질해 실제로 무엇을 만들지 고르는 단계는 최고 모델도 배점의 절반 안팎에 머문다. 추론 설정을 높이면 모든 모델의 점수가 8.97~33.26%포인트 올랐다는 결과는 연산을 더 쓰면 나아진다는 뜻이지만, 선택과 예측 점수의 폭은 모델 간에도 좁았다. 연구진이 다음 단계로 모델이 정보를 찾고 분자 성질을 계산하고 답을 고치는 에이전트형 평가를 제안한 것도 그 때문이다. 신약 연구에서 AI의 쓸모는 한 번의 정답이 아니라 실험 루프 안에서 얼마나 빨리 틀린 후보를 걸러 내느냐로 판가름 날 가능성이 크다.
댓글