


이미지: METAL
요약
- 구글 딥마인드가 10월 6일 텍스트·코드·이미지·오디오·영상을 하나의 임베딩 공간에 담는 공개 모델 EmbeddingGemma 2를 아파치 2.0 라이선스로 공개했다.
- 파라미터는 7억4000만 개로 텍스트 코어 2억7000만 개에 비전·오디오 인코더를 골라 붙이며, 픽셀 11 프로에서 텍스트 전용 약 191MB, 멀티모달 전체 약 567MB의 RAM을 쓴다.
- MTEB 코드 점수가 68.76에서 78.68로 올랐고, 문맥 창은 8192토큰으로 1세대의 네 배이며 벡터를 128차원까지 줄여 저장 공간을 최대 6배 아낀다.
- 발표
- 2026년 10월 6일 · 구글 딥마인드 · EmbeddingGemma 2
- 발표문 작성
- 사힐 두아 · 엔리케 셰크터 베라(구글 딥마인드 리서치 엔지니어)
- 라이선스
- 아파치 2.0 · 상업적 이용 허용
- 파라미터
- 7억4000만 개 · 텍스트 2억7000만 + 비전 인코더 1억7000만 + 오디오 인코더 3억
- 기반
- Gemma 4 아키텍처 · 제미나이 임베딩 모델과 같은 기술
- 모달리티
- 텍스트 · 코드 · 이미지 · 오디오 · 영상 · 하나의 768차원 공간
- 메모리(픽셀 11 프로, 양자화)
- 텍스트 전용 약 191MB · 멀티모달 전체 약 567MB 활성 RAM
- 문맥 창
- 8192토큰(1세대의 4배) · 오디오 5.5분 · 이미지 29장 · 영상 프레임 58장
- MRL
- 768 → 512 · 256 · 128차원 · 저장 공간 최대 6배 절감
- MTEB 코드
- 68.76 → 78.68(9.92점 상승)
- 1세대
- 2025년 9월 · 텍스트 전용 · 2000만 회 이상 다운로드
- 배포
- 허깅페이스 · 캐글 · LiteRT 커뮤니티 · 모델 가든 예정
- 지원 도구
- transformers · sentence-transformers · MLX · vLLM · llama.cpp · SGLang · 올라마 · LM스튜디오 · 언슬로스 미세조정
- Gemma 4 연동
- 텍스트 토크나이저·오디오 인코더 공유 → 결합 메모리 사용량 감소
- 데모
- AI 엣지 갤러리 비디오 모먼츠 파인더 · AI 엣지 포어사이트(맥 회의 앱)
구글 딥마인드가 10월 6일 텍스트와 코드, 이미지, 오디오, 영상을 하나의 임베딩 공간에 담는 공개 모델 EmbeddingGemma 2를 내놓았다. 파라미터는 7억4000만 개로, 스마트폰과 노트북 같은 개인 기기 안에서 돌아가도록 설계됐다. 회사는 이 모델을 온디바이스 멀티모달 임베딩에서 가장 뛰어난 모델이라고 소개했다. 상업적 이용을 허용하는 아파치 2.0 라이선스로 풀렸고, 가중치는 허깅페이스와 캐글에서 받을 수 있다.
임베딩 모델은 글이나 사진, 소리를 숫자 목록인 벡터로 바꿔 뜻이 가까운 것끼리 가까이 놓는다. 검색과 추천, 검색 증강 생성(RAG)의 밑바닥에 깔리는 부품이다. 지난해 9월 나온 1세대 EmbeddingGemma는 텍스트만 다뤘다. 발표문을 쓴 딥마인드 리서치 엔지니어 사힐 두아와 엔리케 셰크터 베라는 1세대가 2000만 회 넘게 내려받혔다며 "개발자 커뮤니티의 반응은 우리의 기대를 훨씬 뛰어넘었다"고 밝혔다. 개발자들은 이 모델로 기기 안 검색 도구와 개인정보를 밖으로 보내지 않는 RAG 파이프라인을 만들었다.
2세대의 핵심은 감각을 하나로 묶은 것이다. 두 엔지니어는 이 모델이 "음성 메모로 특정 영상 장면을 찾거나, 텍스트 질문으로 몇 시간 분량의 오디오 녹음을 뒤질 수 있고, 이 모든 처리를 하나의 네이티브 멀티모달 모델이 한다"고 설명했다. 기반은 올해 4월 공개된 Gemma 4 아키텍처다. 구글은 이 모델이 제미나이 임베딩 모델과 같은 기술로 만들어졌다고 밝혔다.
구조는 조립식이다. 텍스트와 코드만 처리할 때는 2억7000만 개 파라미터면 되고, 1억7000만 개짜리 비전 인코더와 3억 개짜리 오디오 인코더를 필요할 때만 붙인다. 보도에 따르면 모델 카드는 텍스트와 비전 조합을 4억4000만 개, 텍스트와 오디오 조합을 5억7000만 개로 적고 있으며, 어떤 조합으로 불러와도 같은 768차원 벡터 공간을 쓴다. 사진만 검색하는 앱이 오디오 인코더까지 메모리에 올릴 필요가 없다는 뜻이다.
메모리 수치도 구체적이다. 구글은 양자화한 모델을 픽셀 11 프로에서 돌렸을 때 텍스트 전용 가중치는 활성 RAM 약 191MB, 멀티모달 전체는 약 567MB를 쓴다고 밝혔다. 문맥 창은 8192토큰으로 1세대의 네 배다. 한 번에 오디오 5.5분이나 이미지 29장, 영상 프레임 58장, 또는 이를 섞은 입력을 넣을 수 있다. 보도에 따르면 이미지 한 장은 280토큰, 영상 프레임 하나는 140토큰, 오디오 1초는 25토큰을 차지한다.
저장 공간을 줄이는 장치도 넣었다. 마트료시카 표현 학습(MRL)으로 768차원 출력 벡터를 512, 256, 128차원으로 잘라 쓸 수 있고, 회사는 이렇게 하면 로컬 벡터 데이터베이스의 저장 공간과 메모리를 최대 6배 줄인다고 설명했다. 보도에 따르면 구글 개발자 가이드는 256차원에서 이미지·영상·음성 검색 품질이 원래의 약 95%로 유지되고, 128차원에서는 텍스트와 코드가 약 90%를 지키지만 멀티모달 검색은 약 75%로 떨어진다고 적었다.
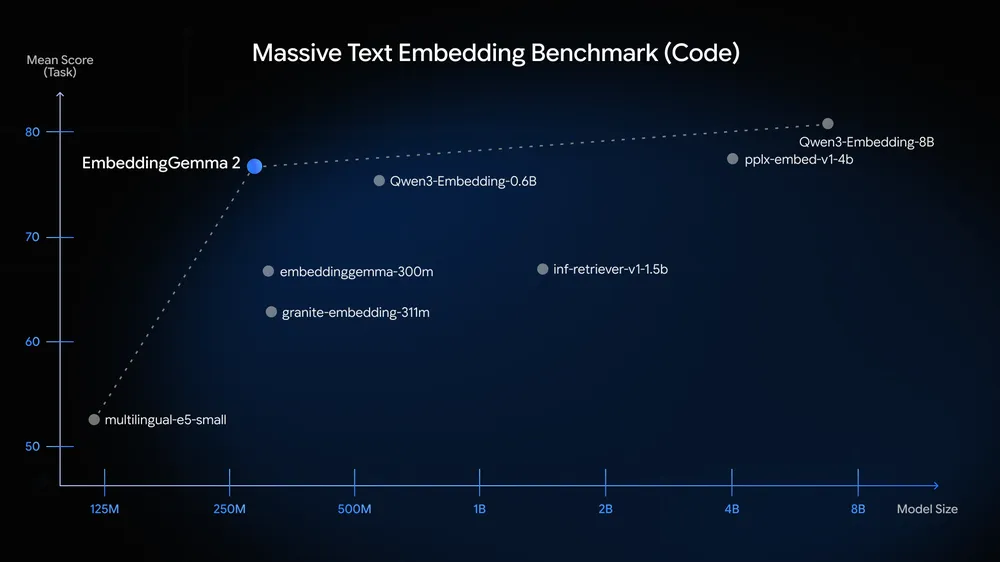
성적표에서 가장 크게 오른 것은 코드다. 대규모 텍스트 임베딩 벤치마크(MTEB) 코드 부문 점수가 68.76에서 78.68로 9.92점 올랐고, 다국어 텍스트 성능은 1세대 수준을 유지했다. 메탈이 확인한 구글 발표문의 MTEB 코드 도표에서 EmbeddingGemma 2는 6억 파라미터의 Qwen3-Embedding-0.6B보다 위에 찍혀 있고, 80억 파라미터의 Qwen3-Embedding-8B와는 몇 점 차이다. 구글은 10억 파라미터 미만 멀티모달 임베딩 모델 가운데 최고 점수를 냈고, 이미지와 영상, 오디오 과제에서 두 배 넘게 큰 전문 모델 일부를 앞섰다고 밝혔다.
엔지니어 관점에서 눈여겨볼 대목은 Gemma 4와 부품을 나눠 쓴다는 점이다. EmbeddingGemma 2는 Gemma 4의 텍스트 토크나이저와 오디오 인코더를 공유해, 두 모델을 한 파이프라인으로 돌리면 전체 메모리 사용량이 줄어든다. 찾는 모델과 답하는 모델이 한 기기 안에서 같은 부품을 쓰는 구조다. 구글은 AI 엣지 갤러리 앱에 영상 속 장면을 텍스트나 음성으로 찾는 비디오 모먼츠 파인더 데모를 실었다. 맥용 회의 앱 AI 엣지 포어사이트는 이 모델로 로컬 파일을 찾고 Gemma 4로 맥락을 추론한다.
배포 경로도 넓게 깔았다. 트랜스포머스와 센턴스 트랜스포머스, MLX, vLLM, llama.cpp, SGLang, 올라마, LM스튜디오에서 돌릴 수 있고, 미세조정은 언슬로스 가이드를 따른다. 기기용으로는 미디어파이프와 LiteRT를, 브라우저용으로는 transformers.js와 WebGPU를 지원한다. 제미나이 엔터프라이즈 에이전트 플랫폼 모델 가든 탑재는 곧 이뤄진다고 회사는 밝혔다. 보도에 따르면 모델 카드는 활성값 범위가 float16을 넘어 NaN이 생길 수 있으니 bfloat16이나 float32로 추론하라고 안내하고, 학습 데이터 기준 시점은 2025년 1월이다.
메탈은 리퀴드AI가 온디바이스 모델 평가 도구 Pipette를 오픈소스로 공개했다고 보도한 바 있다. 온디바이스 경쟁이 생성 모델에서 검색 부품으로 내려오고 있다. 서버에 사진과 녹음을 올리지 않고도 기기 안에서 영상 한 장면을 찾아내는 일이 메모리 600MB 아래의 부품으로 가능해졌다. 이제 앱 개발자가 정할 것은 어떤 인코더를 얹고 벡터를 몇 차원까지 줄일지다.
출처
- Google — EmbeddingGemma 2 is a best-in-class open model for natively multimodal embeddings →
- Google DeepMind — EmbeddingGemma 2: an open, lightweight multimodal embedding model →
- Unite.AI — DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space →
- AlphaSignal — Google DeepMind's EmbeddingGemma 2 Searches Audio, Video, and Images on Your Phone →
- SiliconANGLE — Google expands EmbeddingGemma beyond text to images, audio and video →
댓글