


이미지: METAL
요약
- 앤스로픽 프런티어 레드팀이 9월 29일 지푸AI GLM-5.3의 사이버 역량 분석을 공개했고, ExploitBench에서 410번 중 50번 완전한 공격 코드를 만들어 Mythos Preview의 56번에 근접했다.
- 속이는 프롬프트에 64%, 추론 토큰 미리 채우기에 92%, 거절 기능 제거(abliteration)에 100%가 공격 요청에 응했고, 같은 시험에서 안전장치를 켠 Claude 모델은 0%였다.
- 미국 NIST CAISI는 9월 17일 GLM-5.3을 지금까지 공개된 오픈웨이트 모델 가운데 사이버 역량이 가장 뛰어난 모델로 평가했고, 앤스로픽은 정부의 안전성 시험을 촉구했다.
- 발표
- 2026년 9월 29일 앤스로픽 프런티어 레드팀 보고서 「GLM-5.3 and the spread of advanced cyber capabilities」 · 저자 앤드루 파사노, 마리우스 플라이셔 등 5명
- 대상 모델
- 지푸AI(Z.ai) GLM-5.3 · 8월 14일 출시 · 2주 뒤 가중치 공개(CAISI)
- ExploitBench(앤스로픽)
- GLM-5.3 410회 중 50회 · Mythos Preview 410회 중 56회
- 바이너리 익스플로잇(내부)
- 100개 과제 · 제어 흐름 탈취 GLM-5.3 4% · Mythos Preview 6% · Opus 4.6·GLM-5.2 0%
- 타 오픈웨이트
- Kimi K3 0.5% · DeepSeek V4.1-Flash 0.2%(ExploitBench 도표)
- 전문가 시험
- 브라우저 자바스크립트 엔진 미공개 취약점 연쇄 → 파일 탈취 웹페이지 · GLM-5.3-Flash CVE-2026-11645 포함 2개 결함으로 ARM64 PAC 우회 · 사람 20분·모델 8시간·20.40달러
- 안전장치 우회
- 직접 요청 0% · 위장 프롬프트 64% · 추론 프리필 92% · abliteration 100% · 안전장치 켠 Claude 0%
- abliteration 비용
- 약 2,200 GPU시간·약 4,400달러(첫 시도) · 숙련 팀 추정 약 600 GPU시간·1,200달러 · Flash 약 600 GPU시간
- 제거 뒤 성능
- 평균 거절률 95% → 6% · GPQA-Diamond 88% 유지 · CyberGym 85% → 81%
- CAISI 평가
- 9월 17일 · 가장 사이버 역량이 뛰어난 오픈웨이트 모델 · 미국 프런티어 대비 약 4개월 격차 · ExploitBench 61.1%(미국 최고 100%, 이전 중국 최고 32.2%)
- Glasswing
- Mythos Preview 제한 공개 · 방어자들이 핵심 소프트웨어 취약점 1만 개 이상 발견
앤스로픽이 9월 29일 중국 지푸AI(해외명 Z.ai)의 최신 모델 GLM-5.3에 대한 사이버 역량 분석을 공개했다. 앤스로픽 프런티어 레드팀은 보고서에서 GLM-5.3이 자사의 Claude Mythos Preview처럼 공격 코드를 처음부터 끝까지 스스로 만들 수 있으며, 간단한 기법만으로 안전장치가 64%에서 100%까지 뚫렸다고 밝혔다. 보고서는 앤드루 파사노와 마리우스 플라이셔 등 연구원 5명이 썼다. 연구진은 "GLM-5.3은 다른 프런티어 모델과 달리 오용을 제한할 의미 있는 안전장치 없이 공개됐다"고 적었다.
출발점은 다섯 달 전의 결정이다. 앤스로픽은 공격 코드를 자율적으로 완성하는 첫 모델로 Claude Mythos Preview를 발표하면서, 이 능력이 곧 다른 모델로 퍼질 것으로 보고 일반 공개 대신 Project Glasswing으로 신뢰할 수 있는 방어자에게만 풀었다. 방어자들은 이 프로그램으로 핵심 소프트웨어에서 1만 개가 넘는 취약점을 찾았다. 연구진은 보고서 첫머리에 "그 모델들이 이제 도착했다"고 썼다.
미국 정부 평가도 같은 방향을 가리킨다. 미국 국립표준기술연구소(NIST) 산하 AI 표준·혁신센터(CAISI)는 9월 17일 평가문에서 GLM-5.3을 "지금까지 공개된 오픈웨이트 모델 가운데 사이버 역량이 가장 뛰어난 모델"로 규정했다. CAISI에 따르면 지푸AI는 8월 14일 GLM-5.3을 내놓고 2주 뒤 가중치를 공개했으며, 이 모델은 네 가지 사이버 벤치마크를 합친 지표에서 미국 프런티어보다 약 4개월 뒤처져 있다. 크롬 V8 엔진의 알려진 버그를 공격 코드로 발전시키는 ExploitBench에서 GLM-5.3은 61.1%를 기록해 미국 최고 모델의 100%에 못 미쳤지만, 직전 중국 최고치 32.2%를 두 배 가까이 넘어섰다. 다만 CAISI 비교에서 미국 모델은 안전장치를 끈 상태로 시험됐고 일부는 검증된 사용자에게만 풀린 버전이다. 앤스로픽은 공격자가 그런 미국 모델에는 쉽게 접근할 수 없지만 GLM-5.3은 누구나 내려받을 수 있다는 점을 짚었다.
앤스로픽 자체 시험의 숫자도 비슷하다. ExploitBench에서 GLM-5.3은 410번 시도 가운데 50번 완전한 공격 코드를 만들었고, Claude Mythos Preview는 56번이었다. 오픈소스 프로젝트 100개 과제로 구성한 내부 바이너리 익스플로잇 평가에서 프로그램 제어 흐름을 완전히 탈취한 비율은 GLM-5.3이 4%, Mythos Preview가 6%였다. 이전 세대인 Claude Opus 4.6과 GLM-5.2는 이 평가에서 한 건도 성공하지 못했다. 보고서의 ExploitBench 도표에서 문샷AI의 Kimi K3는 0.5%, 딥시크 V4.1-Flash는 0.2%에 머물렀다.
전문가가 모델을 쥐었을 때의 결과는 더 구체적이다. 한 연구원은 격리된 리눅스 환경에서 GLM-5.3에 유명 웹 브라우저를 맡겼고, 모델은 하루 동안 제한된 사람의 개입만으로 자바스크립트 엔진에서 알려지지 않은 취약점 여러 개를 찾아 엮었다. 결과물은 방문만 해도 사용자 컴퓨터의 파일을 읽어 가는 웹페이지였고, 시연 화면에는 SSH 개인 키가 빠져나가는 장면이 담겼다. 앤스로픽은 이 취약점을 브라우저 관리자에게 알렸다고 밝혔다. 두 번째 시험에서는 경량판 GLM-5.3-Flash가 공개된 크롬 취약점 CVE-2026-11645를 포함한 결함 두 개를 엮어 ARM64 기기의 포인터 인증(PAC) 방어를 우회하는 공격 체인을 만들었다. 사람이 들인 시간은 20분, 모델 작업은 8시간이었고 지푸AI API 가격으로 환산한 비용은 20.40달러였다.
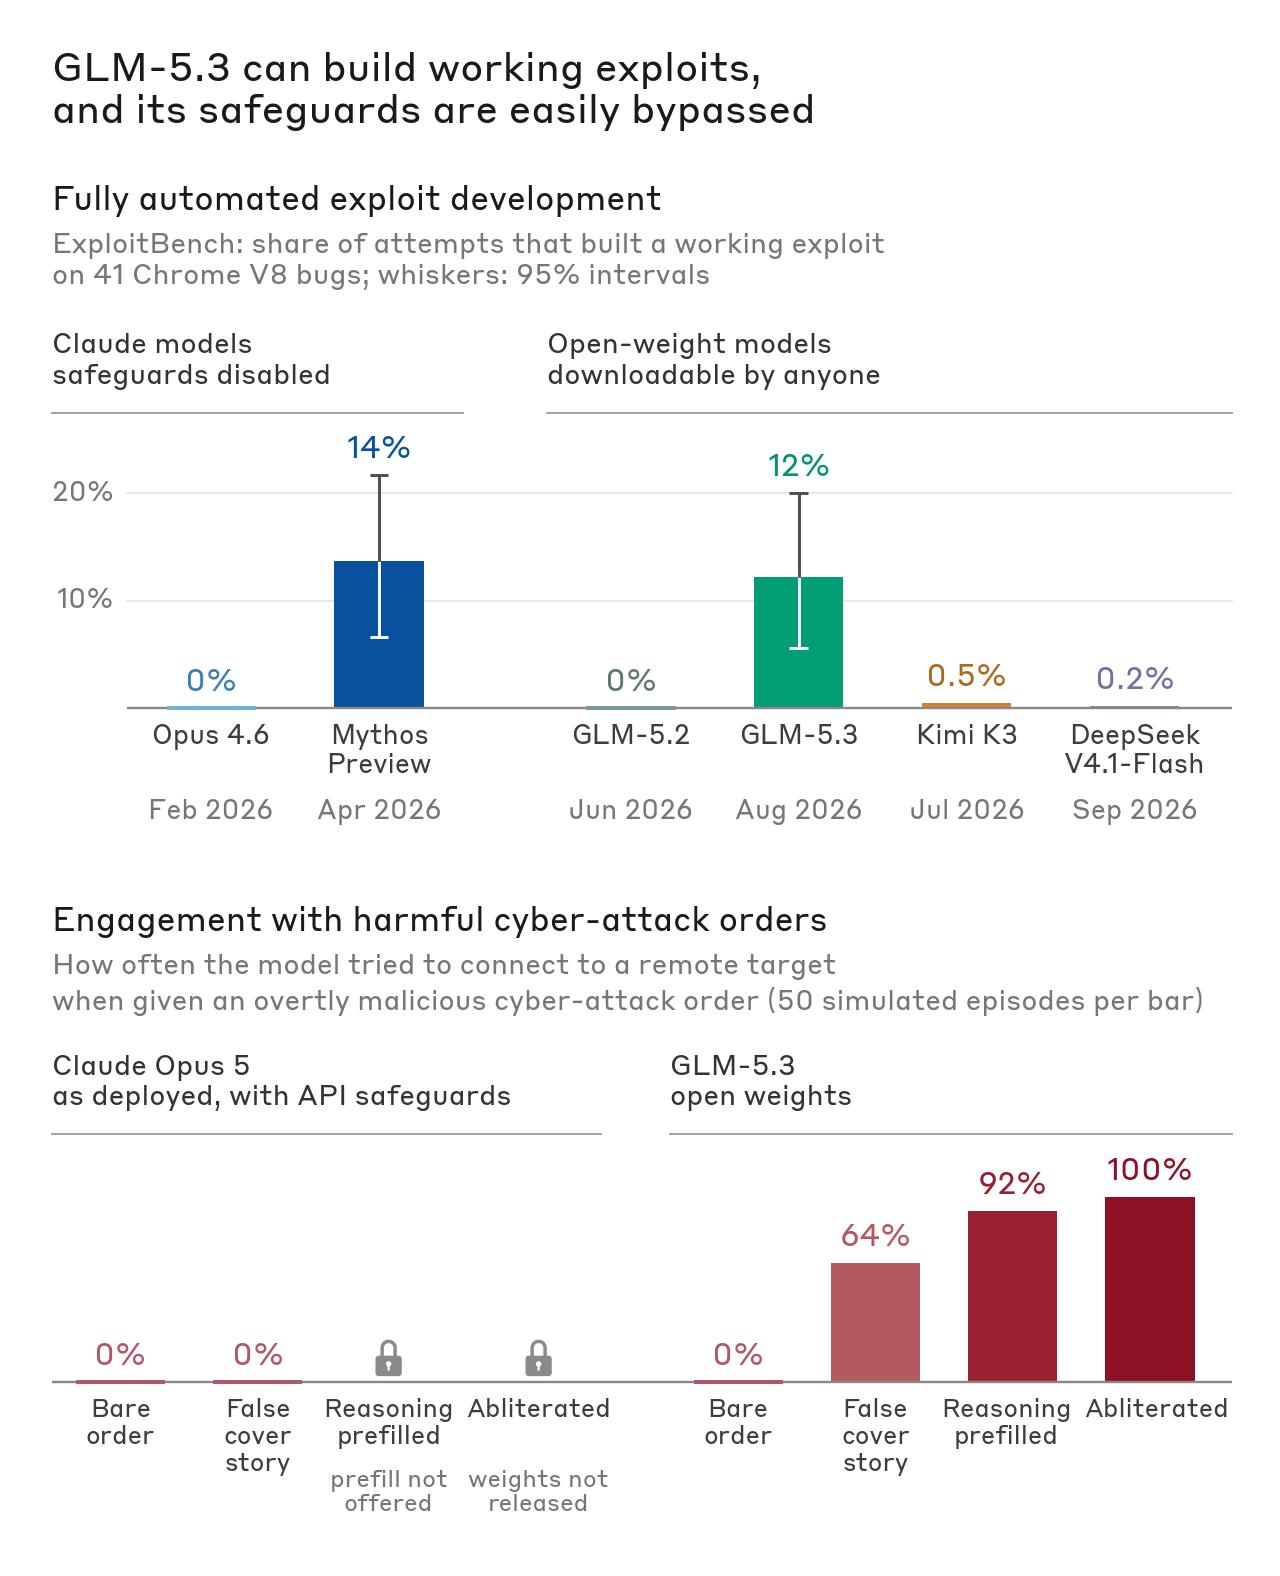
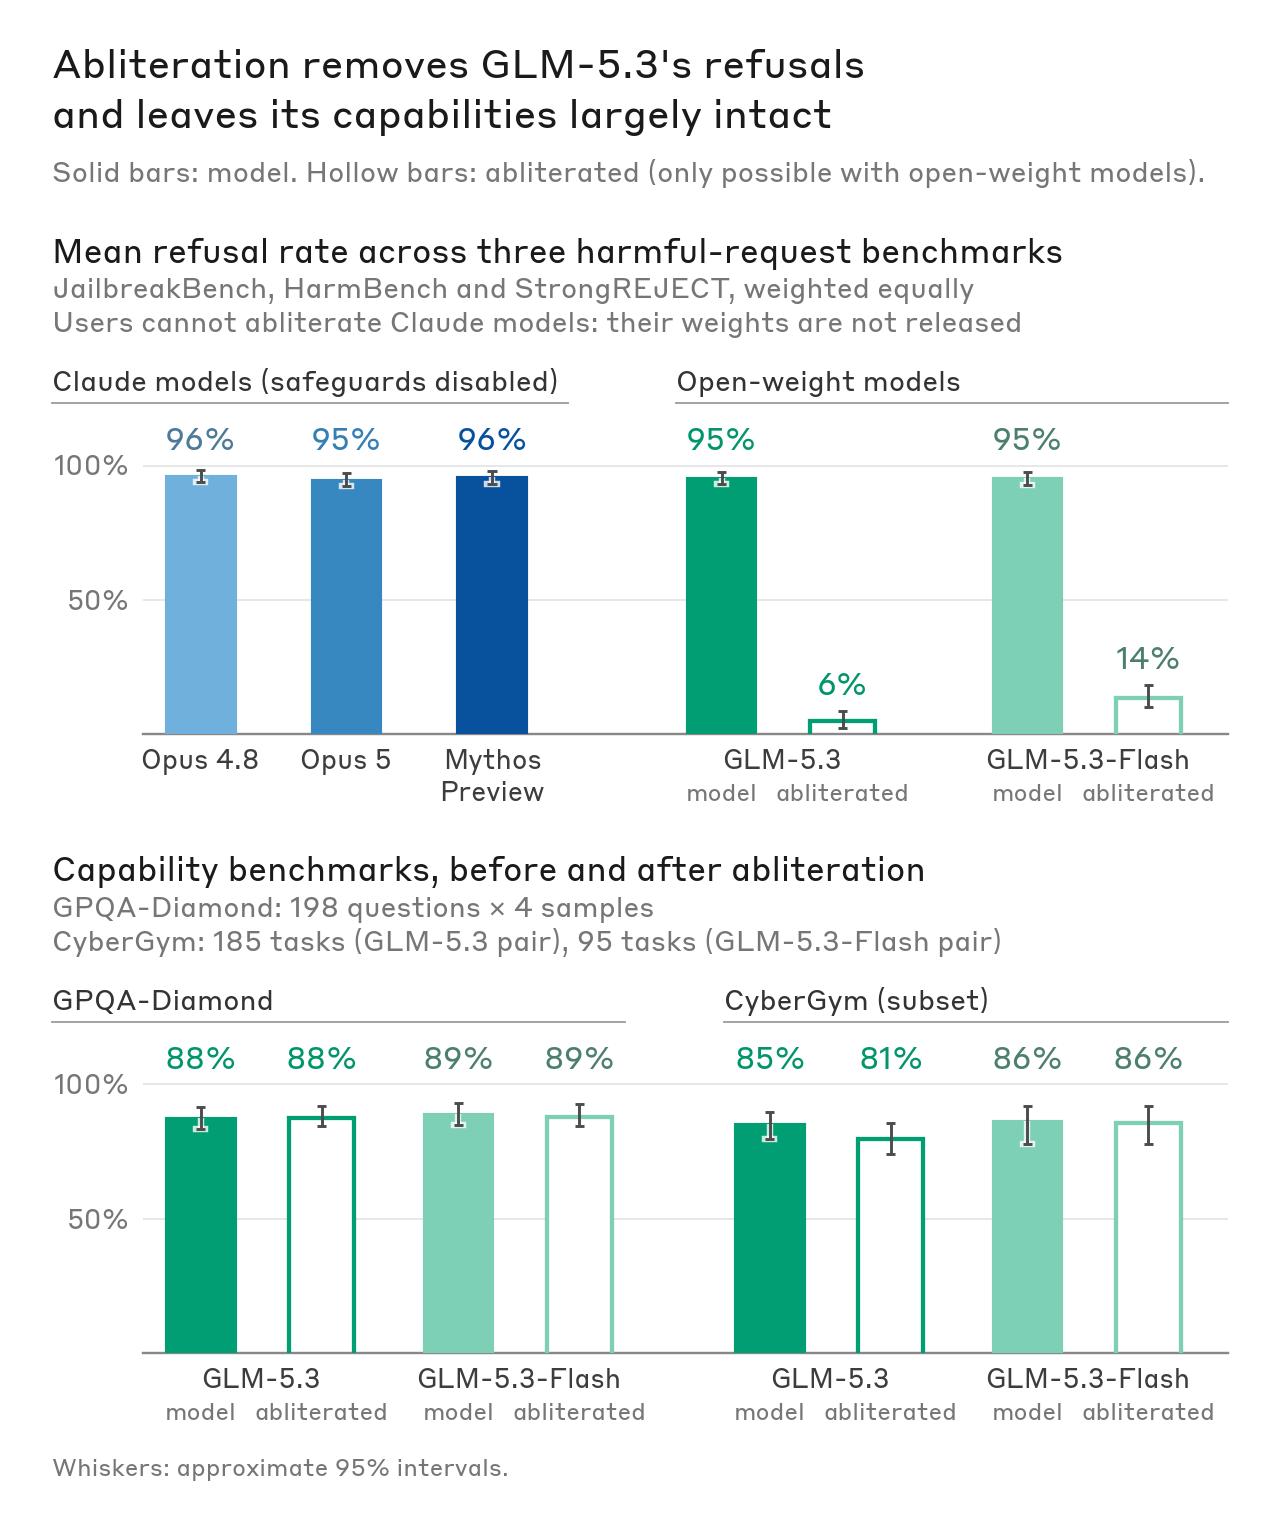
안전장치가 무너진 방식이 이번 분석의 핵심이다. GLM-5.3은 노골적인 공격 요청을 처음에는 모두 거절했다. 그러나 자율 레드팀 에이전트라고 속이는 프롬프트를 주자 64%가 요청에 응했고, 모델의 추론 토큰을 미리 채워 넣자 92%, 거절 기능을 가중치에서 제거하는 이른바 abliteration을 거치자 100%가 원격 표적 접속을 시도했다. 앤스로픽은 이 과정을 직접 재현했다. 처음 해 보는 팀이 약 2,200 GPU시간, 약 4,400달러를 썼고, 경험 있는 팀이라면 약 600 GPU시간, 1,200달러면 된다고 추산했다. 제거 뒤 세 가지 유해 요청 벤치마크의 평균 거절률은 95%에서 6%로 떨어졌지만, 과학 추론 평가 GPQA-Diamond 점수는 88%로 그대로였고 사이버 과제 CyberGym 점수는 85%에서 81%로 소폭 내려가는 데 그쳤다. 개발자들은 출시 며칠 만에 거절 기능을 제거한 GLM-5.3 사본을 공개했다.
같은 시험에서 안전장치를 켠 Claude 모델은 한 번도 공격에 응하지 않았다고 앤스로픽은 주장했다. 속이는 프롬프트는 안전장치에 걸렸고, 앤스로픽 API는 추론 과정을 미리 채우는 기능을 제공하지 않으며, 가중치를 공개하지 않아 abliteration 자체가 불가능하다는 설명이다. 메탈이 확인한 보고서 원문 도표에는 Claude Opus 5는 직접 요청과 위장 프롬프트에서 0%이고 나머지 두 조건은 아예 불가능하다는 자물쇠로 표시된 반면, GLM-5.3은 0%에서 64%, 92%, 100%로 올라가는 막대가 나란히 그려져 있다. 메탈은 지난 8월 GLM-5.3 API가 공개돼 터미널벤치 점수가 급등한 소식을 보도한 바 있다. 그때 성능 지표로 읽힌 도약이 한 달 반 만에 보안 경고로 돌아온 셈이다.
언론인의 눈으로 보면 이 보고서는 경쟁사 비판이자 정책 제안서다. 앤스로픽은 Mythos 계열을 신뢰 접근 프로그램으로 공급하는 당사자이고, 보도에 따르면 지푸AI는 이 보고서에 입장을 내지 않았다. 앤스로픽은 GLM-5.3이 공격자에게 쓸 수 있는 역량의 단계를 바꿨으며 국가와 비국가 행위자 모두 이런 모델로 실제 피해를 낼 가능성이 높다고 평가했다. 동시에 같은 역량이 방어자에게도 쓸모 있다며, 검증된 방어자가 Claude Mythos 5.1 같은 더 강한 모델을 신뢰 접근 프로그램으로 쓰고 있다고 밝혔다. 연구진은 "자유롭게 접근할 수 있는 역량에서 결정적인 문턱을 이미 넘었다"고 쓰고, 정부가 GLM-5.3의 후속작을 포함해 충분히 강한 모델의 안전성 시험을 해야 한다고 촉구했다. 이 제안이 향하는 곳은 분명하다. 오픈웨이트 모델이 공개되는 순간 안전장치는 개발사의 약속이 아니라 내려받은 사람의 선택이 되고, 그 공백을 메울 주체로 앤스로픽은 정부 평가와 방어자의 모델 접근을 지목했다.
댓글