


이미지: METAL
요약
- 트위치가 크리에이터 콘텐츠를 모기업 아마존의 생성형 AI 모델 학습에 사용하되, 기본값은 학습 허용이고 거부하려면 크리에이터가 직접 옵트아웃해야 한다
- 트위치 최고제품책임자 마이크 민튼은 라이브 방송에서 옵트인 방식을 쓰지 않은 이유에 대해 "이게 옵트인이었다면 아무도 하지 않았을 것"이라고 말했다
- 메타도 공개 게시물을 AI 학습에 활용하지만 영국 이용자만 별도 거부가 가능하고, 다른 지역은 계정을 비공개로 돌리는 수밖에 없다
- 정책 방향
- 트위치 콘텐츠, 아마존 생성형 AI 학습에 기본 허용
- 거부 방식
- 크리에이터가 설정에서 직접 옵트아웃해야 함
- 발언자
- 트위치 CPO 마이크 민튼, 커뮤니티총괄 메리 키시
- 발표 방식
- 약 3,000명이 지켜본 공식 트위치 채널 라이브 방송
- 유사 사례
- 메타는 공개 게시물 학습, 영국 이용자만 옵트아웃 가능
무엇이 나왔나
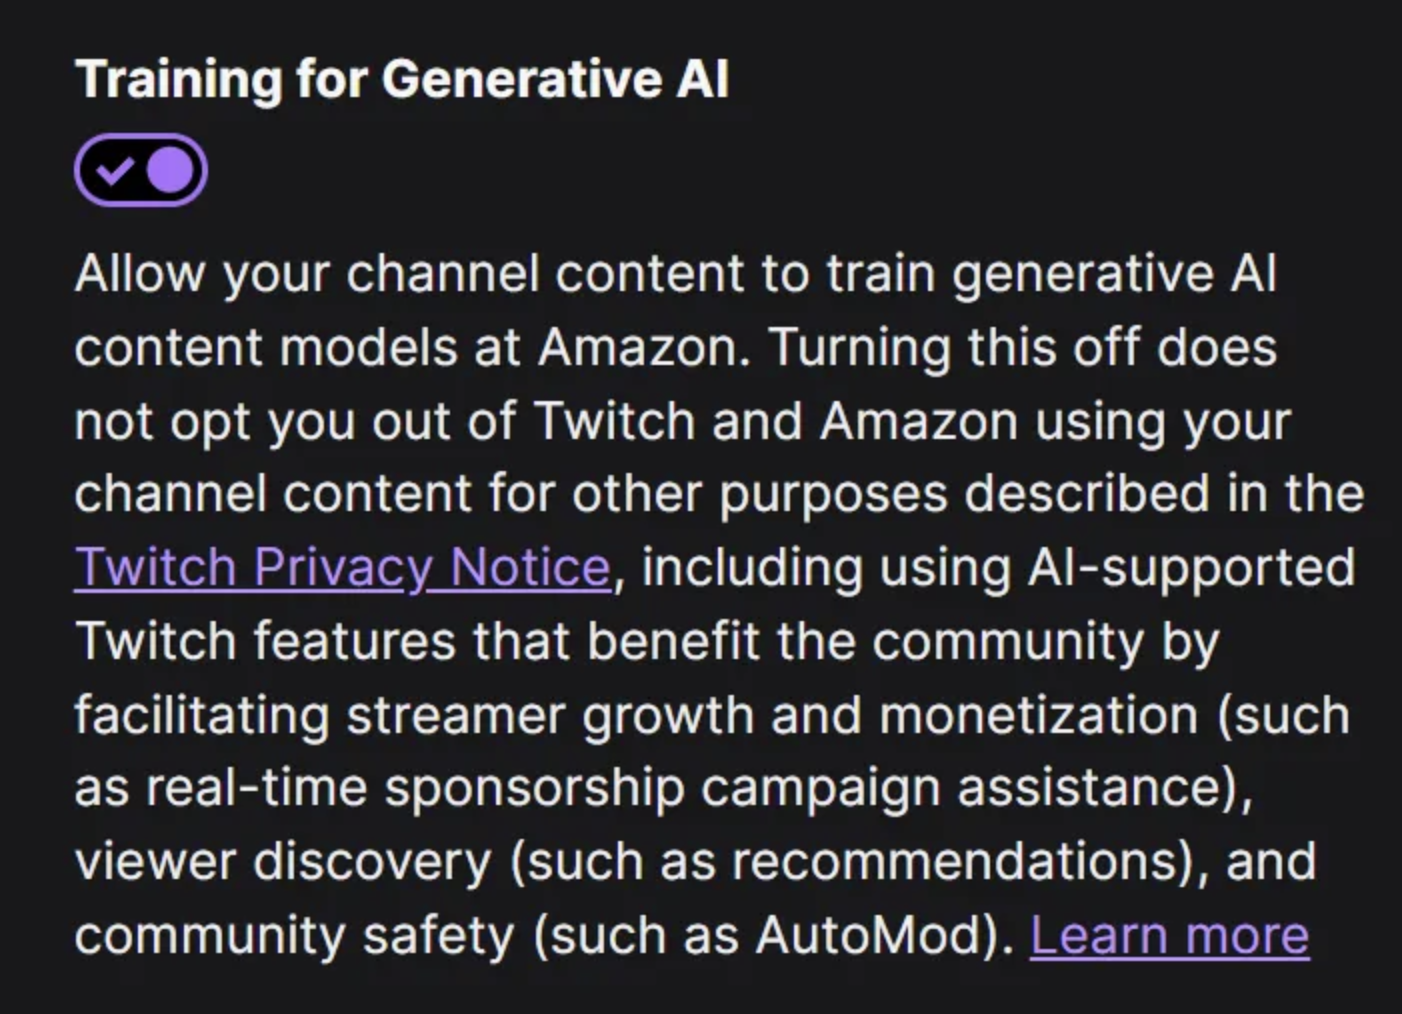
트위치가 크리에이터들의 스트림 영상과 음성을 모기업 아마존의 생성형 AI 모델 학습에 사용하기로 했다. 문제는 방식이다. 이 회사는 이를 새 기능이 아니라 "생성형 AI 모델 학습에 채널 콘텐츠가 쓰이는 것을 거부할 수 있는 설정을 추가했다"는 식으로 공지했다. 즉 기본값은 학습 허용이고, 원하지 않는 크리에이터가 직접 나서서 꺼야 하는 구조다.
공식 트위치 채널에서 진행된 라이브 방송에는 약 3,000명이 몰려들어 항의성 채팅을 쏟아냈다. 트위치 최고제품책임자(CPO) 마이크 민튼은 왜 옵트인이 아니냐는 질문에 에둘러 가지 않았다. "이게 옵트인이었다면 아무도 하지 않았을 것"이라고 말했다. 누군가는 이미 자신의 영상이 학습에 쓰였는지 물었지만, 민튼은 "아마존이 어떤 모델 학습에 무엇을 썼는지 나도 모른다"고 답했다.
이게 무슨 얘긴가
트위치 스트리머는 일주일에 수십 시간씩 자신의 얼굴과 목소리, 게임 플레이 화면을 그대로 방송한다. 다른 어떤 플랫폼보다 밀도 높은 음성·영상 데이터가 매일 쌓이는 곳이다. 아마존 입장에서 이 데이터는 자사 AI 모델을 훈련시킬 대량의 실사 콘텐츠 원료다. 하지만 크리에이터 입장에서 보면, 자신의 방송 자산이 동의 없이 회사의 AI 사업 밑천으로 흘러갈 수 있다는 뜻이기도 하다.
생성형 AI 업계는 인터넷에서 긁어모은 책·이미지·영상을 동의 없이 학습에 써온 전례가 많다. 트위치 커뮤니티는 이런 관행에 대체로 부정적이었고, 트위치도 이를 모르지 않았다. 커뮤니티총괄 메리 키시는 옵트아웃 설정 자체가 "이 커뮤니티의 목소리에 반응한 결과"라고 인정했다. 동시에 그는 트위치만의 문제가 아니라는 점도 짚었다. 메타는 페이스북·인스타그램의 공개 게시물을 AI 학습에 이미 활용 중이고, 영국 거주자만 별도로 거부할 수 있다. 다른 지역 이용자는 계정을 비공개로 바꾸는 것 말고는 방법이 없는데, 수익을 위해 계정을 공개해야 하는 크리에이터에게는 사실상 선택지가 아니다.
스냅챗, 완전 AI 생성 콘텐츠에는 보상하지 않는다
그래서 뭐가 달라지나
트위치 크리에이터라면 설정 메뉴에서 AI 학습 관련 옵트아웃 항목을 직접 찾아 켜야 한다. 가만히 있으면 자동으로 학습 대상에 포함되는 구조이기 때문이다. 더 큰 흐름에서 보면, 대형 플랫폼들이 이용자 콘텐츠를 AI 학습 자원으로 편입시키는 방식은 갈수록 '동의를 구하는 것'에서 '거부할 권리를 주는 것'으로 옮겨가고 있다. 스냅챗이 완전 AI 생성 콘텐츠의 보상을 끊은 것과는 반대 방향이다. 한쪽은 AI가 만든 결과물을 걸러내려 하고, 다른 한쪽은 사람이 만든 원본 콘텐츠를 AI 학습에 끌어들이려 한다. 크리에이터 입장에서는 두 흐름 모두를 신경 써야 하는 셈이다.


댓글