


요약
- AWS가 아마존 다이나모DB(Amazon DynamoDB)에 네이티브 벡터 검색 기능을 정식 출시했다
- 단일 밀리초 지연 시간과 99% 이상 재현율로 트릴리언 단위 벡터까지 처리 가능하다고 밝혔다
- 별도 벡터DB 구축과 동기화 파이프라인 없이 SearchVectors API로 유사도 검색을 수행한다
- 기능
- 아마존 다이나모DB 벡터 검색 정식 출시(GA)
- 지연 시간·재현율
- 단일 밀리초 지연, 99% 이상 recall
- 처리 규모
- 트릴리언 단위 벡터까지 지원
- 최대 차원 수
- 4096차원
- 지원 거리 함수
- Euclidean, Cosine, Dot product
- 검색 API
- SearchVectors, 최대 100개 결과 반환
- 호환 임베딩 모델
- Amazon Bedrock Titan Text Embeddings, Cohere Embed, OpenAI 텍스트 임베딩 모델
- 발행일
- 2026-08-05
서비스 개요
아마존웹서비스(AWS)가 아마존 다이나모DB(Amazon DynamoDB)에 벡터 검색 기능을 정식 출시했다고 밝혔다. 이번 업데이트로 개발자는 별도의 벡터 데이터베이스를 구축하지 않고도 다이나모DB에 저장된 운영 데이터와 벡터 임베딩을 함께 관리하며 유사도 검색을 실행할 수 있게 됐다.
성능과 확장성
AWS에 따르면 다이나모DB의 네이티브 벡터 검색은 단일 밀리초 수준의 지연 시간에 99% 이상의 재현율(recall)을 제공한다. 트릴리언 단위의 벡터까지 처리할 수 있도록 설계됐으며, 서버 프로비저닝이나 패치, 유지보수 작업이 필요 없다고 회사는 설명했다. 벡터 인덱스는 저장 용량 제한이 없고 데이터가 늘어나는 만큼 수평적으로 확장된다.
| 항목 | 값 |
|---|---|
| 지연 시간 | 단일 밀리초 수준 |
| 재현율 | 99% 이상 |
| 최대 차원 수 | 4096 |
| 거리 함수 | Euclidean, Cosine, Dot product |
| 처리 규모 | 트릴리언 단위 벡터 |
| 결과 반환 수 | 최대 100개 |
기존 방식과의 차이
기존에는 다이나모DB를 사용하는 애플리케이션에 벡터 검색을 추가하려면 데이터를 별도의 전용 벡터 데이터베이스로 복제하고, 두 서비스 간 동기화 파이프라인을 유지해야 했다. AWS는 이 과정에서 운영 부담, 데이터 이동 비용, 라이선싱 비용, 대규모 환경에서 예측 가능한 저지연을 유지하는 어려움이 발생했다고 밝혔다. 벡터 검색이 다이나모DB에 내장되면서 벡터 데이터와 운영 데이터는 동일한 서버리스 인프라와 요청 단위 과금(pay-per-request) 모델을 공유하게 됐다.
작동 방식
새로운 인덱스 유형은 벡터 임베딩을 저장하는 속성(attribute) 위에 생성된다. 개발자는 Amazon Bedrock Titan Text Embeddings, Cohere Embed, 오픈AI(OpenAI) 텍스트 임베딩 모델 등 원하는 모델로 임베딩을 생성한 뒤, 표준 PutItem 호출을 통해 부동소수점 리스트 형태로 테이블에 저장한다. 이어 해당 속성에 벡터 인덱스를 만들고 차원 수, 거리 함수, 검색 결과를 좁히는 데 쓸 비벡터 속성을 필터로 지정하면 된다.
검색은 SearchVectors API를 통해 이뤄진다. 쿼리 벡터와 반환할 결과 수(최대 100개), 선택적 필터 조건을 지정하면 유사도 순으로 정렬된 결과가 반환된다. 벡터 검색은 최대 4096차원을 지원하며, 유클리드(Euclidean), 코사인(Cosine), 내적(Dot product) 세 가지 거리 함수와 인라인 필터링을 제공한다.
활용 사례와 시작 방법
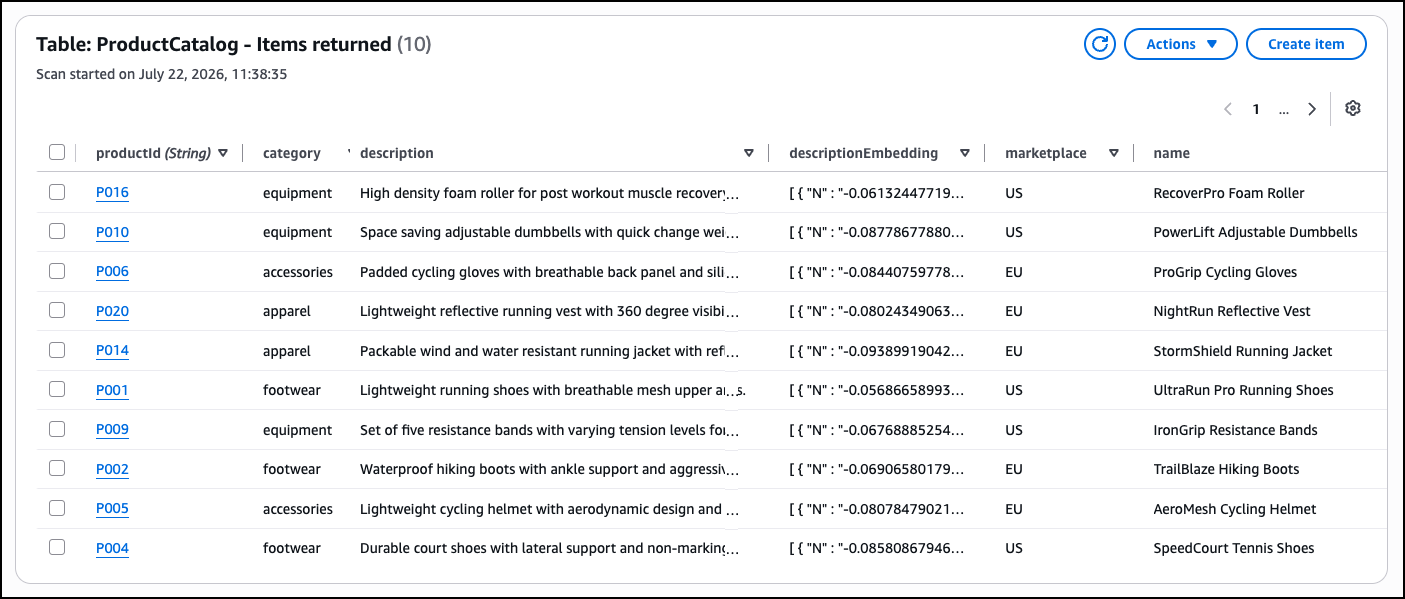
AWS는 이번 기능이 에이전트형 메모리(agentic memory), 검색 증강 생성(RAG), 추천 엔진, 개인화 경험, 이상 탐지 등 시맨틱 검색이 필요한 애플리케이션 구축에 쓰일 수 있다고 밝혔다. 회사가 공개한 시연 사례에서는 온라인 스포츠용품 매장의 상품 카탈로그 테이블을 예로 들었다. productId, category, description, marketplace, name, price 등 속성을 가진 기존 항목에 UpdateItem 호출로 descriptionEmbedding이라는 새 속성을 추가해 자연어 기반 시맨틱 검색을 구현하는 과정을 소개했다.
클라우드 데이터베이스에 검색 증강 생성 기능이 통합되는 흐름은 다른 사업자들에게도 이어지고 있으며, 관련 인프라 경쟁 동향은 메탈랩의 클라우드 인프라 기사에서도 확인할 수 있다.
남은 관전 포인트
AWS는 이번 발표에서 구체적인 요금 체계나 리전별 출시 일정을 상세히 공개하지 않았다. "별도의 인프라 관리 없이 벡터와 운영 데이터를 함께 다룰 수 있다"는 설명이 핵심 메시지지만, 실제 대규모 트래픽 환경에서의 지연 시간과 비용 효율성은 시장에서 검증이 필요한 부분으로 남아 있다.

댓글