

이미지: METAL
요약
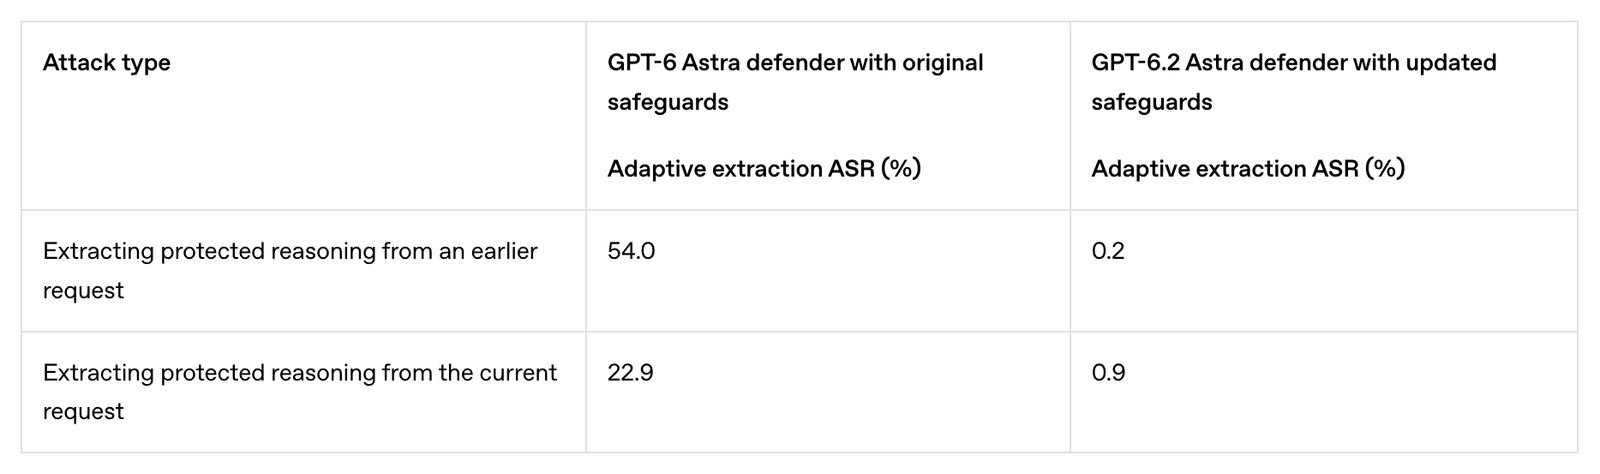
- 오픈AI는 11월 20일 적대적 증류 방어 체계를 공개하고, 사내 적응형 평가에서 앞선 요청의 보호된 추론을 빼내는 공격 성공률이 GPT-6 Astra 54.0%에서 GPT-6.2 Astra 0.2%로 떨어졌다고 밝혔다.
- 사내 연구에서 교사 모델의 정확한 추론 흔적으로 배운 학생 모델은 요약으로 배운 모델보다 대체로 사이버 능력이 높았고, 오픈AI는 허용된 과제의 출력도 공격 기술을 옮길 수 있다고 해석했다.
- 회사는 요청 단위 분류기·API 제한과 캠페인 단위 계정 제재를 묶었고, 주간 제재가 수천에서 수만 계정에 이르렀다며 칩 보안법 등 법안 지지를 의회에 전했다.
- 공개
- 2026년 11월 20일 오픈AI 발표문 「Combatting adversarial distillation」
- 대상 모델
- GPT-6.2 Astra · GPT-6.2 Sol (일부 개선은 GPT-6 Astra에도 적용 중)
- 앞선 요청 추론 추출
- 평균 공격 성공률 54.0% → 0.2% (GPT-6 Astra 기존 안전장치 → GPT-6.2 Astra 새 안전장치)
- 현재 요청 추론 추출
- 22.9% → 0.9% · 블랙박스 적응형 평가 · 공격 모델 6개 집계
- 사이버 증류 연구
- 같은 사전학습 학생 모델 · Astra급 교사 궤적 · 정확한 추론 흔적 vs 추론 요약 · 미세조정 후 흔적 쪽 대체로 우세, 강화학습 후 최대 추론 예산에서 우세
- 요청 단위 방어
- 적대적 학습 · 입력·출력 분류기(메시지·도구 호출 인자) · 스트리밍·비스트리밍 모두
- API 방어
- 보호된 추론을 대화 기록에 묶음 · 앞선 메시지 수정 시 뒤 추론 폐기 · 구형 모델 계열 열람 차단
- 캠페인 제재
- 주간 수천~수만 계정 · 지난여름 크게 증가 · 침해 지표 타 제공자와 공유
- 국가 안보
- 2월 딥시크 증류 시도 의회 보고 · 9월 문샷 AI 연관 캠페인 차단(보도: 7월 1일 포착, 7월 24~25일 사용자 4,000명 이상·요청 1만 6,000건)
- 입법
- Chip Security Act · AI OVERWATCH Act · MATCH Act 지지
오픈AI가 11월 20일 적대적 증류에 맞서는 방어 체계와 사내 실험 결과를 공개했다. 적대적 증류는 최첨단 모델의 출력을 허락 없이 모아 비슷한 능력을 지닌 다른 모델을 학습시키고, 원래 모델의 안전장치 없이 배포하는 행위다. 오픈AI에 따르면 회사는 GPT-6.2 Astra와 GPT-6.2 Sol에서 보호된 추론을 빼내려는 공격에 대한 방어를 강화했다. 강한 자동 레드팀을 쓴 사내 적응형 평가에서 앞선 요청의 추론을 빼내는 공격의 평균 성공률은 기존 안전장치를 단 GPT-6 Astra의 54.0%에서 새 안전장치를 단 GPT-6.2 Astra의 0.2%로 떨어졌다.
오픈AI가 가장 공들여 지키는 대상은 보호된 추론, 곧 모델이 답에 이르기까지 내부에서 만드는 중간 단계인 사고의 사슬이다. 회사는 발표문에서 "이 흔적에는 최종 답이 빼놓은 정보가 담길 수 있어 다른 모델에게 특히 값진 학습 데이터가 된다"고 밝혔다. 증류 자체는 한 모델이 다른 모델이 만든 데이터로 배우는 흔한 기계학습 기법이다. 오픈AI가 문제 삼는 것은 지식재산권을 넘어선 안전이다. 회사는 사이버 보안과 생물학처럼 쓰임이 양면적인 분야를 예로 들었다. 소프트웨어 취약점을 찾도록 방어자를 돕는 모델은 공격자의 악용도 도울 수 있고, 생물학 연구를 돕는 모델은 해로운 병원체 개발에 쓰일 수도 있다는 설명이다.
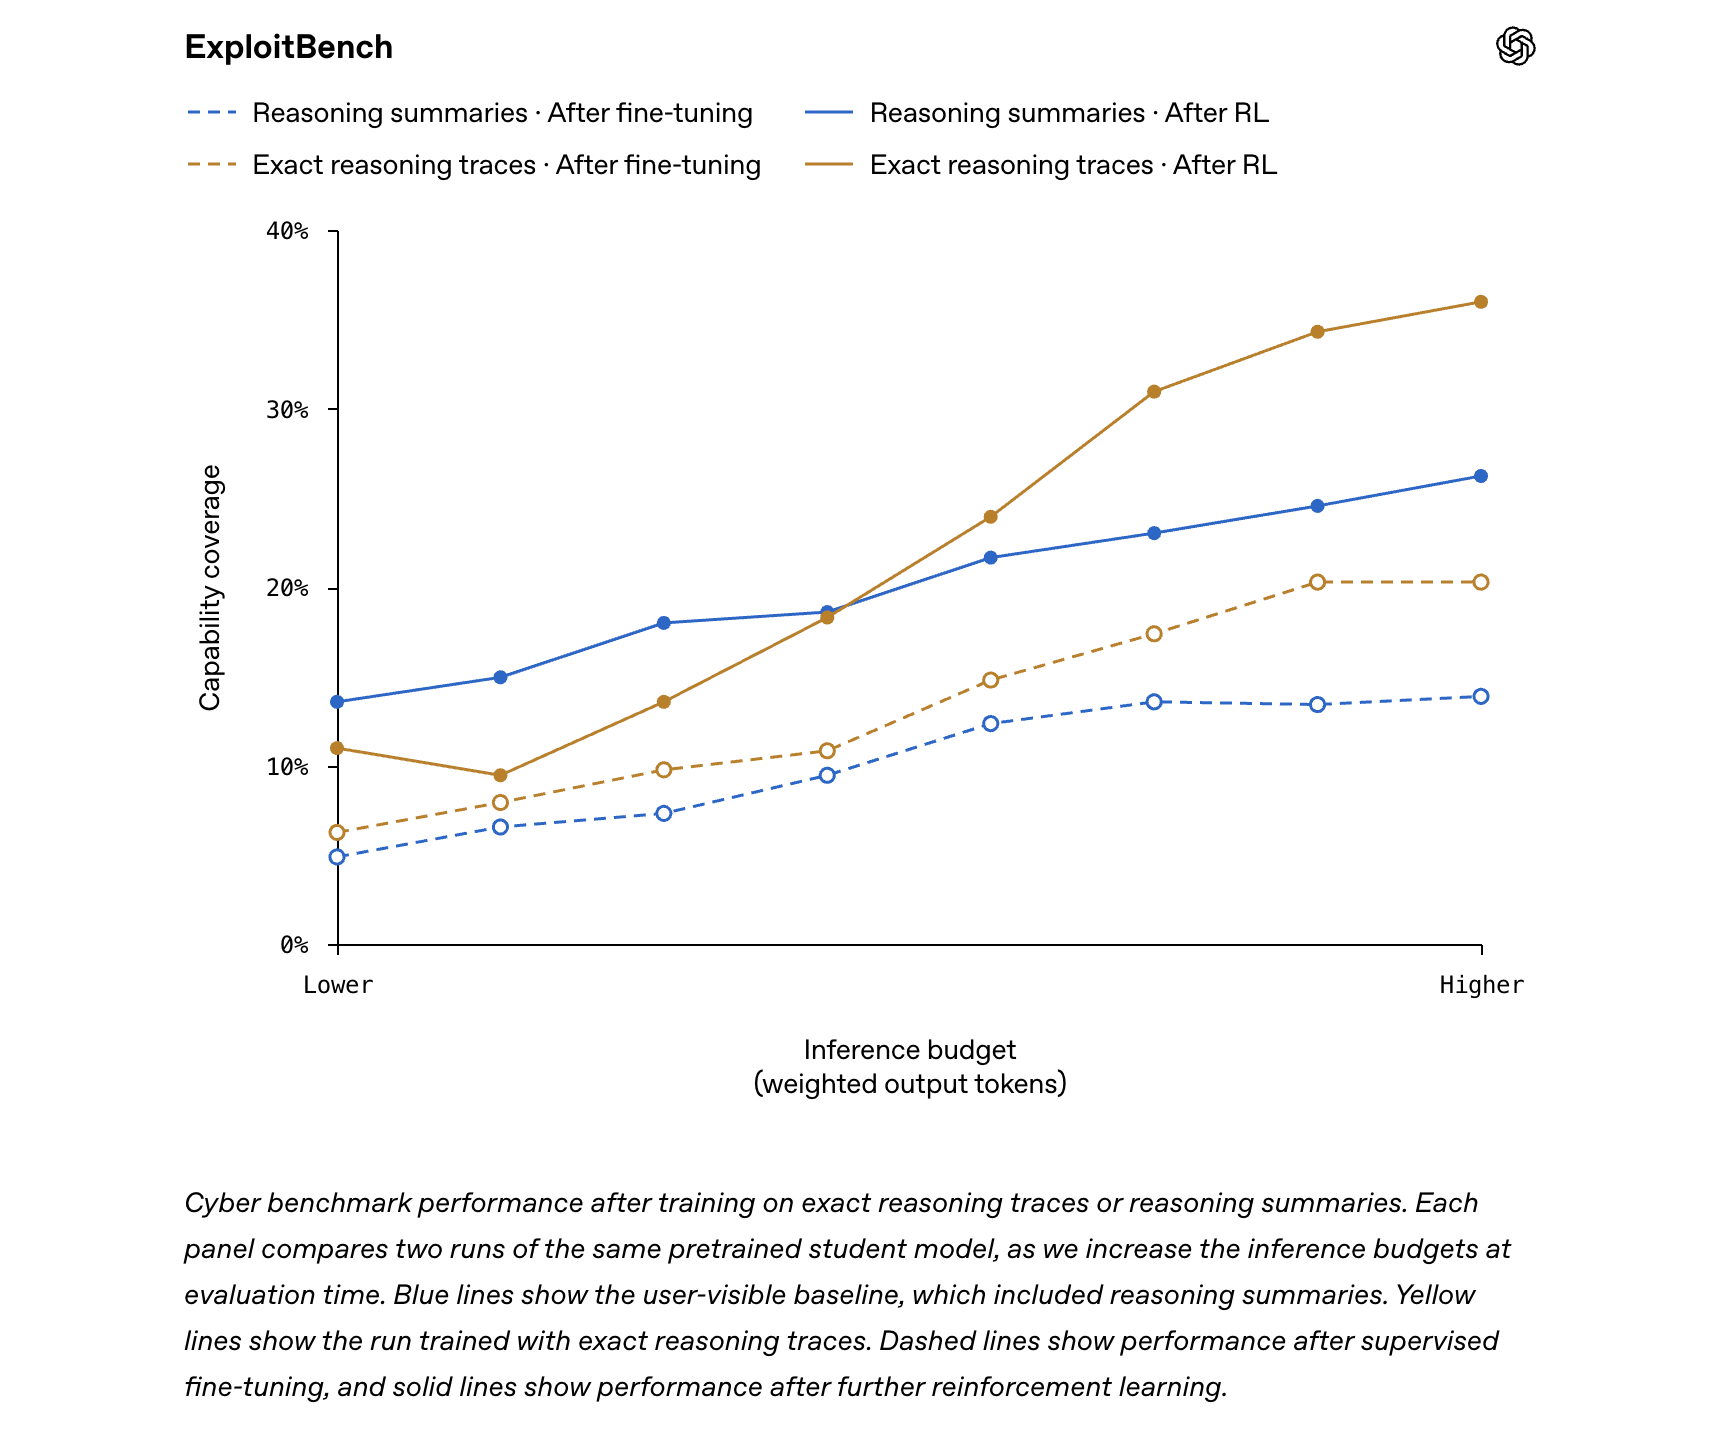
이를 확인하려고 오픈AI는 증류로 사이버 능력이 얼마나 옮겨 가는지 사내 연구를 했다. 모든 학습은 같은 사전학습 학생 모델에서 출발했고, Astra급 교사 모델이 코딩과 방어적 사이버 보안 과제를 푼 궤적으로 지도 미세조정 데이터를 만들었다. 한쪽 학생은 사용자에게 보이는 최종 답과 추론 요약, 도구 호출만 배웠고 다른 학생은 교사의 정확한 추론 흔적까지 배웠다. 미세조정 직후에는 정확한 흔적으로 배운 학생이 대체로 앞섰다. 사이버 보안·코딩 환경에서 가벼운 강화학습을 더 거친 뒤에도 정확한 흔적 쪽이 시험한 가장 큰 추론 예산에서 두 벤치마크 모두 점수가 높았고, 낮은 예산에서는 요약으로 배운 쪽이 높았다.
오픈AI는 이 결과를 두고 "추론 흔적을 보호하면 바탕이 된 과제가 이용 정책상 허용된 것이라도 사이버 능력의 이전을 제한할 수 있다"고 해석했다. 정상적인 방어 작업의 출력도 많이 쌓이면 교사가 원래 하지 않은 공격 기술까지 학생에게 가르칠 수 있다는 뜻이다. 회사는 각주에서 앤스로픽이 소프트웨어 공학 벤치마크 SWE-bench Verified에서 요약 대신 전체 추론 기록으로 학습할 때 비슷한 이점을 보고했다고 적고, 자사 결과는 그 이점이 최전선 사이버 보안까지 이어진다는 것을 보여 준다고 밝혔다. 메탈은 앤스로픽이 클로드 증류 방어 방법을 공개한 소식을 보도한 바 있다.
방어는 두 층으로 짜였다. 요청 단위에서는 적대적 학습으로 모델이 추론 추출 시도를 알아보고 거절하게 하되, 설명을 구하는 정당한 요청에는 계속 답하게 한다. 학습 예시는 사내 자동 레드팀과 조사, 외부 연구자·업계 파트너의 책임 있는 취약점 공개에서 찾은 성공한 공격들이다. 입력 분류기는 추출 시도를 잡고, 출력 분류기는 어시스턴트 메시지와 도구 호출 인자에 섞인 추론 유출을 잡는다. 오픈AI는 모델이 최종 답에는 넣지 않은 추론을 도구 인자로 흘릴 수 있어 도구 호출까지 살펴야 한다고 설명했다. 이 장치들은 스트리밍 응답과 비스트리밍 응답 모두에 걸린다.
API 층도 바뀌었다. 오픈AI는 9월 공개에서 한 대화의 암호화된 추론을 다른 대화로 옮긴 뒤 사람이 읽을 수 있게 풀어 달라고 요구한 공격을 소개했고, 이후 사용자·워크스페이스·조직·모델 계열 경계의 보호를 강화하면서 다른 사용자의 암호화된 추론이 드러날 수 있던 경로를 막았다. GPT-6.2 Astra와 Sol에서는 보호된 추론을 그 추론을 만든 대화 기록에 묶는다. 앞선 메시지를 고쳐 쓰면 그 뒤에 이어진 추론은 API가 버리고, 안전장치가 약한 구형 모델 계열은 두 모델의 보호된 추론을 읽지 못한다. 메탈은 GPT-6.2의 추론 항목 보존 규칙을 보도한 바 있다.
두 번째 층은 캠페인 단위다. 오픈AI는 요청·계정 신호에서 조직적인 추출 시도의 패턴을 찾고, 위반이 확인되면 관련 계정 네트워크 전체를 제재한다. 조사로 드러난 공격은 다시 안전장치의 학습·시험 예시가 된다. 회사는 다른 모델 제공자와 침해 지표를 공유하고, 자사 모델을 제공하는 파트너에게는 일관 기준 정책으로 같은 수준의 안전장치와 공조 제재를 요구한다고 밝혔다. 오픈AI에 따르면 올해 플랫폼에서 무단 증류 캠페인이 여러 건 확인됐고, 주간 제재 규모는 수천에서 수만 계정에 이르렀으며 "지난여름 그 속도가 크게 늘었다".
측정 방식도 함께 공개됐다. 정적 평가는 과거에 성공한 공격을 다시 돌려 아직 통하는지 보고, 적응형 평가는 자동 AI 레드팀이 시스템 반응에 맞춰 방법을 바꾸며 정적 시험이 놓친 약점을 찾는다. 외부 사용자와 같은 시야만 주는 블랙박스 적응형 평가에서 공격 모델 6개의 결과를 모은 평균 성공률은 앞선 요청의 추론 추출이 54.0%에서 0.2%로, 현재 요청의 추론 추출이 22.9%에서 0.9%로 내려갔다. 메탈이 확인한 오픈AI 발표문의 표에서도 GPT-6.2 Astra는 두 공격 유형 모두 1% 아래였다. 오픈AI는 개선한 안전장치 일부를 GPT-6 Astra에도 적용하고 있다고 밝혔다. 이 수치는 회사 자체 평가이고 외부 재현 결과는 아직 나오지 않았다.
오픈AI는 증류를 국가 안보 문제로도 규정했다. 회사는 2월 딥시크가 미국 최첨단 모델을 증류하려 한 정황을 의회에 보고했고, 9월에는 보호된 추론을 빼내려던 캠페인을 차단하면서 그 핵심을 Kimi 개발사 문샷 AI와 연관된 인물들로 지목했다. 보도에 따르면 당시 오픈AI는 이 캠페인을 7월 1일 처음 포착했고, 7월 24~25일 이틀 동안 4,000명이 넘는 사용자가 1만 6,000건의 추출 요청을 보냈다고 공개했다. 메탈은 오픈AI가 문샷 연관 증류 캠페인을 차단했다고 발표한 소식을 보도한 바 있다. 오픈AI는 최근 차단한 캠페인을 곧 더 공개하겠다고 밝혔다.
입법 요구도 붙었다. 오픈AI는 미국 AI 모델의 능력을 불법으로 빼내는 외국 행위자를 식별하고 제재할 수단을 정부에 주는 법안을 지지하며, 칩 보안법(Chip Security Act)과 AI OVERWATCH Act, MATCH Act를 지지한다는 뜻을 의회에 전했다고 밝혔다. 회사는 "더 강한 수출 통제는 적대 세력이 최첨단 모델 학습에 필요한 하드웨어에 접근하는 것을 제한할 수 있다"며 "증류 방어는 이미 학습된 모델에서 같은 능력 일부를 얻기 어렵게 한다"고 주장했다. 두 장치가 미국의 우위를 지켜야 개발사가 안전장치를 시험할 시간이 필요할 때 출시를 늦출 여유가 생긴다는 논리다.
다른 개발사를 위한 권고도 내놨다. 대화 전체에서 추론을 보호하고 어시스턴트 메시지와 도구 인자의 유출을 점검할 것, 레드팀·운영 모니터링·책임 있는 공개로 찾은 성공 공격 기록을 회귀 시험으로 남길 것, 요청 단위 완화책과 캠페인 단위 조사·제재를 묶을 것, 배포 파트너와 안전장치 기준을 맞추고 다른 개발사와 전문성을 나눌 것이다. 오픈AI는 프런티어 모델 포럼과 정부 정보 공유 채널로도 결과를 나눠 왔고, 공격자가 악용할 세부는 비공개로 둔다고 밝혔다.
AI 엔지니어의 눈으로 보면 이번 발표가 옮긴 것은 보안 경계의 위치다. 그동안 모델 제공자가 지킨 핵심 자산은 가중치였고, 출력은 사용자에게 건네는 순간 끝나는 데이터로 여겨졌다. 오픈AI는 이제 추론 흔적을 가중치에 버금가는 자산으로 다루고, 방어선을 최종 답에서 도구 인자와 대화 간 재사용, 계정 네트워크까지 넓혔다. 개발자가 치르는 비용은 대화 기록을 고치면 앞선 추론이 사라지는 API 동작이다. 54.0%에서 0.2%로 떨어진 성공률이 실전에서도 유지되는지는 매주 수천에서 수만 계정 단위로 쌓이는 제재 통계가 먼저 보여 줄 것이다.
댓글