

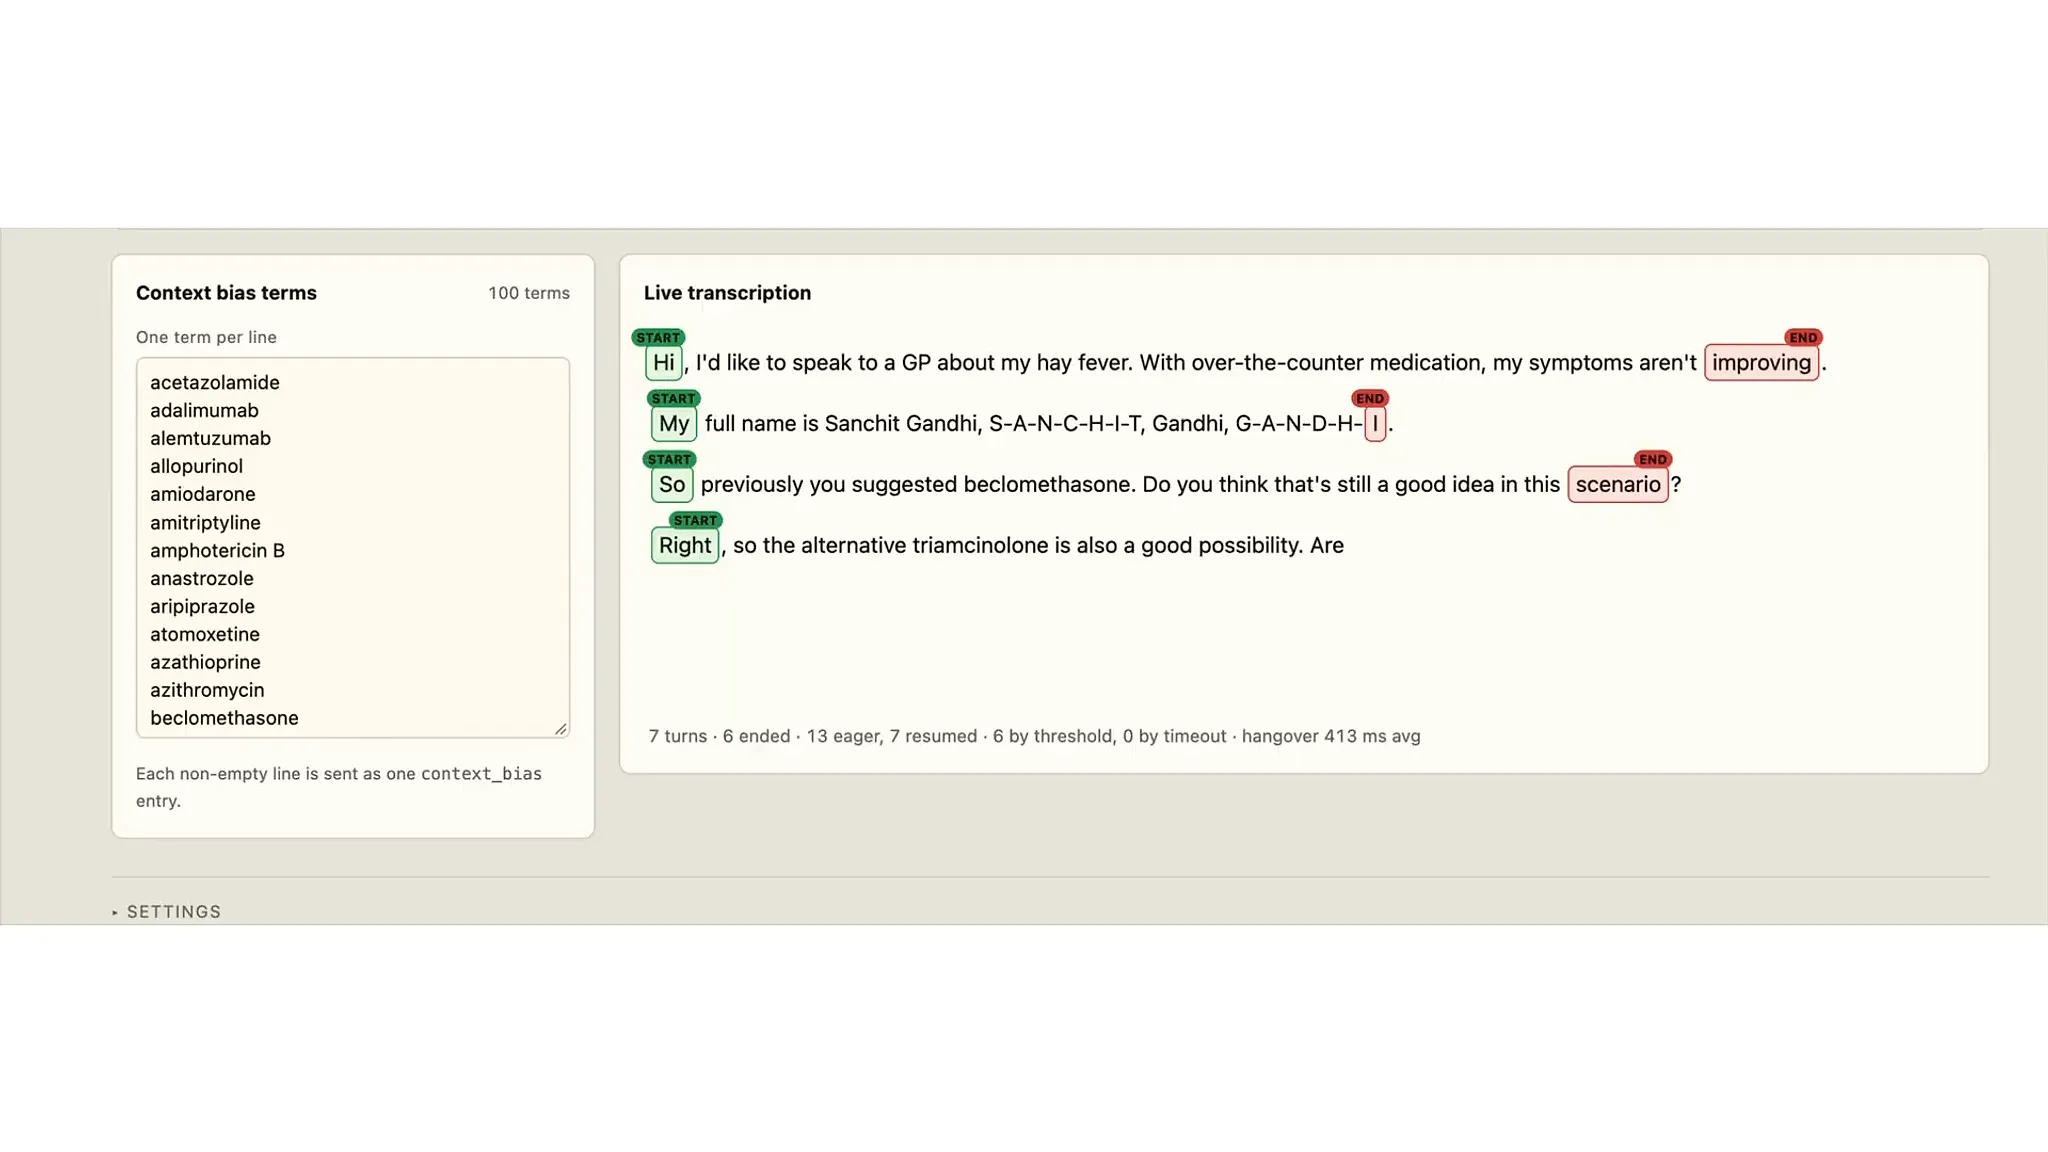
이미지: @MistralAI (X) 영상 갈무리
요약
- 미스트랄은 11월 9일 X에서 Voxtral 3 Transcribe로 AI Engineer Paris 메인 무대 발표를 모두 실시간 전사했다고 밝히고 43초 시연 영상을 공개했다.
- 연사 이름과 기술 용어를 미리 넣는 맥락 편향을 썼고, 보도에 따르면 맥락을 넣으면 핵심 어구 재현율이 81.4%에서 94.6%로 오른다.
- 10월 20일 공개된 Voxtral 3는 받아쓰기 세 종, 음성 합성 한 종, 라이브킷 기반 음성 에이전트 SDK로 이뤄졌고 실시간 모델 지연은 80~2,400밀리초에서 고른다.
- 발표
- 2026년 11월 9일 @MistralAI X 게시물 · 43초 시연 영상 · 조회수 9,516회(약 세 시간 반 뒤)
- 현장
- AI Engineer Paris 메인 무대 발표 전부 실시간 전사 · 일정표의 연사 이름·기술 용어로 맥락 편향
- 영상 장면
- 맥락 편향 용어 100개(약 이름) · 진료 상담 실시간 전사 · 이름 철자 불러 주기 · 베클로메타손·트리암시놀론
- Voxtral 3
- 2026년 10월 20일 공개 · 받아쓰기 3종·음성 합성 1종·음성 에이전트 SDK
- 실시간 모델
- Voxtral Mini Transcribe Realtime 3 · 지연 80~2,400ms · 턴 종료 감지·맥락 편향·화자 분리 · 웹소켓 · 공개 프리뷰
- FLEURS 35 실시간 WER
- 2,400ms 5.7% · 960ms 6.0% · 480ms 6.4% · 240ms 7.4% · Gemini 3.5 Realtime 4.2% · GPT Live Transcribe 8.4% · Scribe v2 Realtime 8.7%
- FLEURS 45 배치 WER
- Small 4.0~4.1% · MAI-Transcribe-2 4.0~4.1% · Mini(40억 매개변수) 4.5~4.6% · Whisper large-v3 14.9~16.0%
- 맥락 편향 효과(보도)
- Earnings 22 핵심 어구 재현율 맥락 有 94.6% · 無 81.4%
- 화자 분리·외부 평가(보도)
- cpWER Small 18.4% · MAI-Transcribe-2 20.3% · Artificial Analysis AA-WER 2.1% 3위
- 언어
- 배치 50개(EU 공식어 24개 포함) · 실시간 35개 이상 · TTS 35개 이상·방언 50개 이상 · 프리셋 18개 언어
- 음성 에이전트 SDK
- 라이브킷 기반 · 주고받기 1초 미만 · 끼어들면 멈춤 · SIP·WebRTC · 모델 교체 가능
- 배포
- 유럽 호스팅 API 또는 자체 인프라 · 유럽·미국·글로벌 엔드포인트 · 오픈 웨이트 미발표(보도)
미스트랄이 11월 9일 X에 Voxtral 3 Transcribe로 파리에서 열린 AI 엔지니어 콘퍼런스 AI Engineer Paris의 메인 무대 발표를 전부 실시간으로 받아 적었다고 밝히고, 실시간 전사 시연 영상을 함께 올렸다. 미스트랄은 콘퍼런스 일정표에 실린 연사 이름과 기술 용어를 모델에 미리 넣어 주는 맥락 편향으로 정확도를 끌어올렸다고 설명했다. 회사는 게시물 끝에 "같은 기술을 여러분의 행사와 앱에서도 쓸 수 있다"고 적었다. 게시물은 올라온 지 약 세 시간 반 만에 조회수 9,516회를 기록했다.
메탈이 확인한 43초 분량의 영상은 콘퍼런스 무대가 아니라 진료 상담 장면을 실시간으로 받아 적는 화면이다. 왼쪽 맥락 편향 용어 창에는 100개 용어가 한 줄에 하나씩 들어가 있고, 아세타졸아마이드와 아달리무맙, 알로푸리놀처럼 철자가 까다로운 약 이름이 알파벳 순으로 이어진다. 오른쪽 전사 창에는 일반 의약품을 먹어도 꽃가루 알레르기가 낫지 않는다는 환자의 말이 문장 단위로 쌓인다. 환자가 자기 이름을 한 글자씩 불러 주는 대목과 베클로메타손, 트리암시놀론 같은 약 이름도 올바른 철자로 화면에 찍힌다. 화면 아래쪽에는 말하는 차례가 몇 번 바뀌었는지와 끝난 발화 수를 세는 상태 줄이 계속 갱신된다.
시연에 쓰인 모델 군은 미스트랄이 10월 20일 공개한 Voxtral 3다. 받아쓰기 모델 세 종과 음성 합성 모델 한 종, 그리고 이를 묶는 음성 에이전트 SDK로 이뤄졌다. 미스트랄은 발표문에서 "신뢰할 수 있는 음성 에이전트는 네 가지를 동시에 아주 잘해야 한다"고 밝혔다. 여러 언어와 억양, 끼어들기 속에서 정확히 듣고, 사용자의 뜻을 맥락 안에서 추론하고, 감정을 실어 자연스럽게 말하고, 연결된 시스템을 거쳐 여러 단계의 행동을 해내는 일이다. 메탈은 삼성이 앞장선 미스트랄의 30억 유로 투자 유치와 오픈AI의 GPT-Live 음성 프리셋 추가를 보도한 바 있다.
AI Engineer Paris 시연의 핵심인 맥락 편향은 핵심 용어나 자유로운 문장을 입력해 받아쓰기 결과를 그쪽으로 기울이는 기능이다. 미스트랄은 이 기능 덕분에 분야별 어휘가 많은 현장에서도 별도 미세조정 없이 모델을 쓸 수 있다고 설명했다. Voxtral 3의 받아쓰기 모델은 모두 이 기능과 화자 분리, 곧 누가 언제 말했는지 가려내는 기능을 지원한다. 보도에 따르면 기업 실적 발표 통화를 모은 Earnings 22 데이터에서 Voxtral Small Transcribe 3의 핵심 어구 재현율은 맥락을 넣었을 때 94.6%, 넣지 않았을 때 81.4%였다.
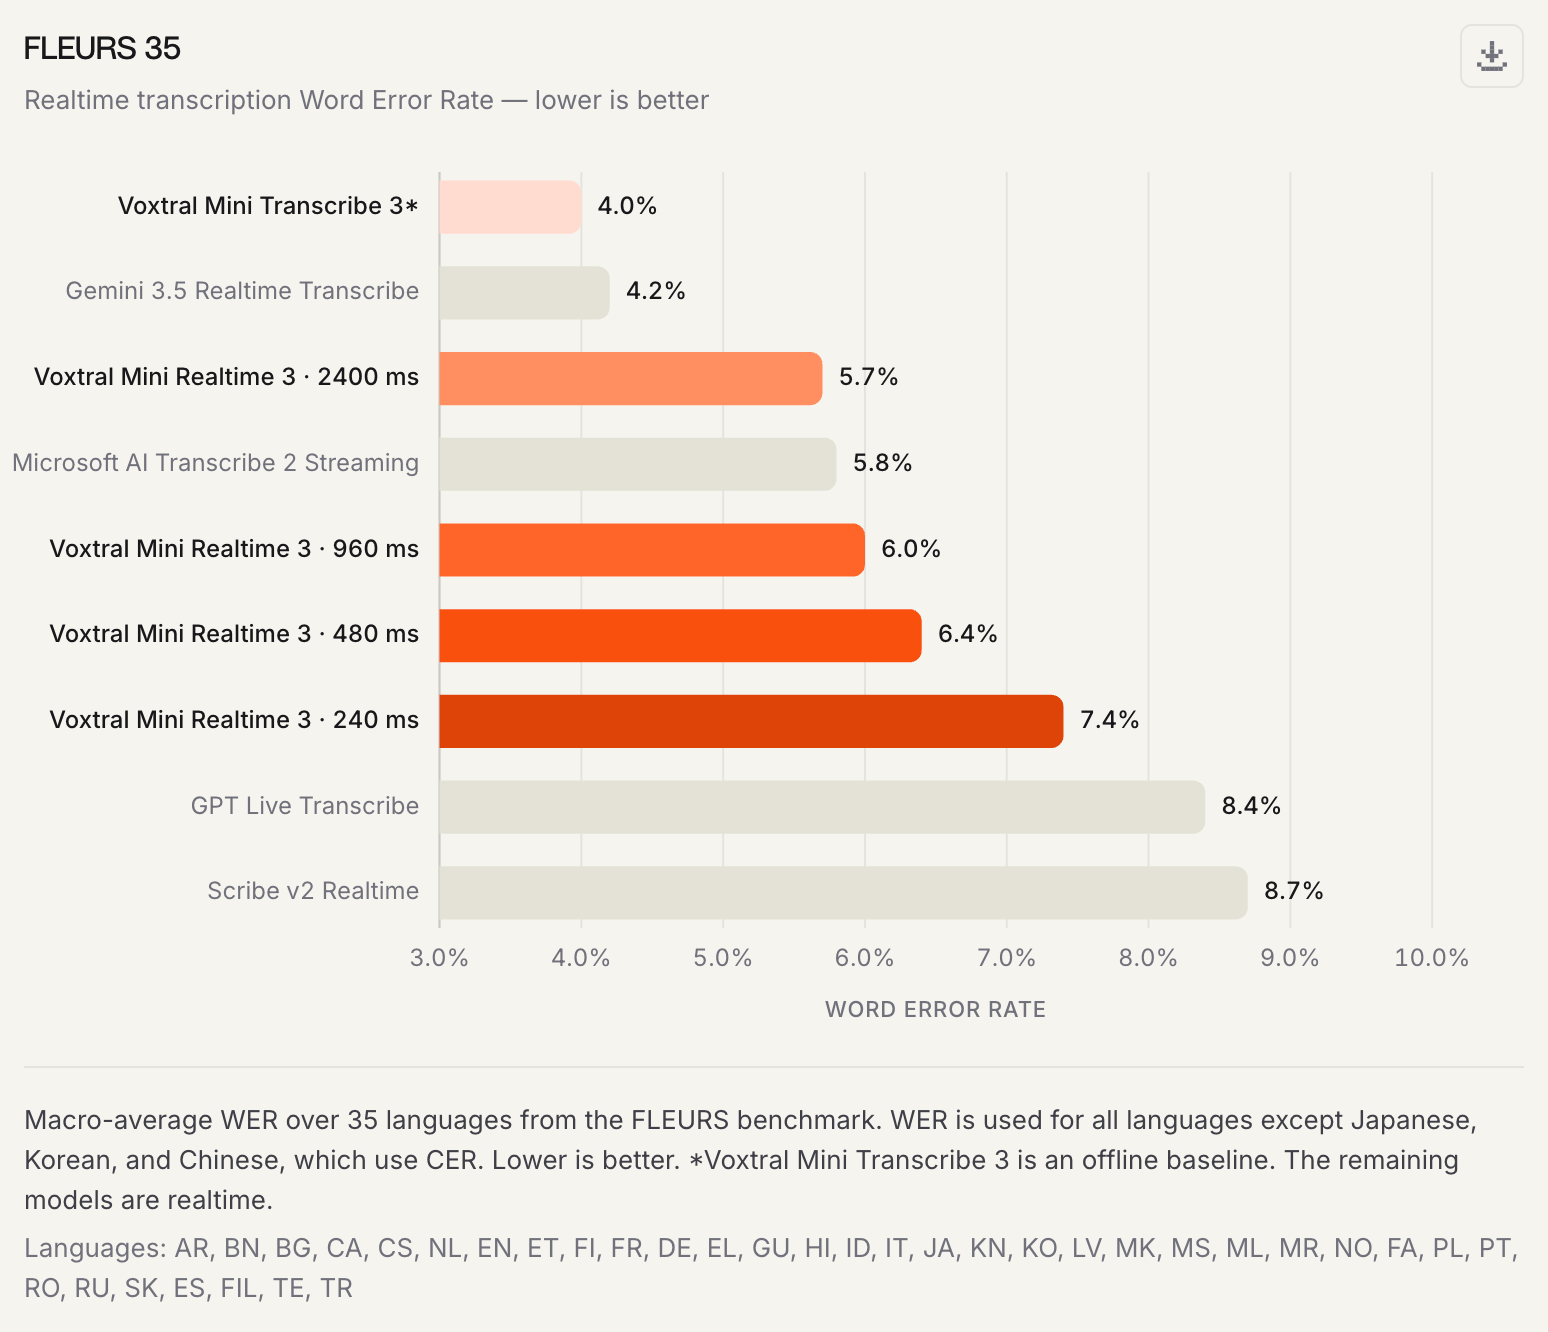
무대 발표를 실시간으로 받아 적은 모델은 Voxtral Mini Transcribe Realtime 3다. 미스트랄 문서에 따르면 이 모델은 지연 시간을 80밀리초에서 2,400밀리초 사이에서 고를 수 있고, 말이 끝났는지 판단하는 턴 종료 감지와 맥락 편향, 화자 분리를 웹소켓 스트리밍 세션 하나에서 처리한다. 발표문은 35개가 넘는 언어에서 500밀리초 미만의 지연으로 전사한다고 밝혔다. 35개 언어 FLEURS 벤치마크의 단어 오류율은 지연을 2,400밀리초로 두면 5.7%, 960밀리초 6.0%, 480밀리초 6.4%, 240밀리초 7.4%로 지연을 줄일수록 올라갔다. 같은 도표에서 구글의 Gemini 3.5 Realtime Transcribe는 4.2%, 마이크로소프트의 스트리밍 모델은 5.8%, 오픈AI의 GPT Live Transcribe는 8.4%, 일레븐랩스의 Scribe v2 Realtime은 8.7%였다.
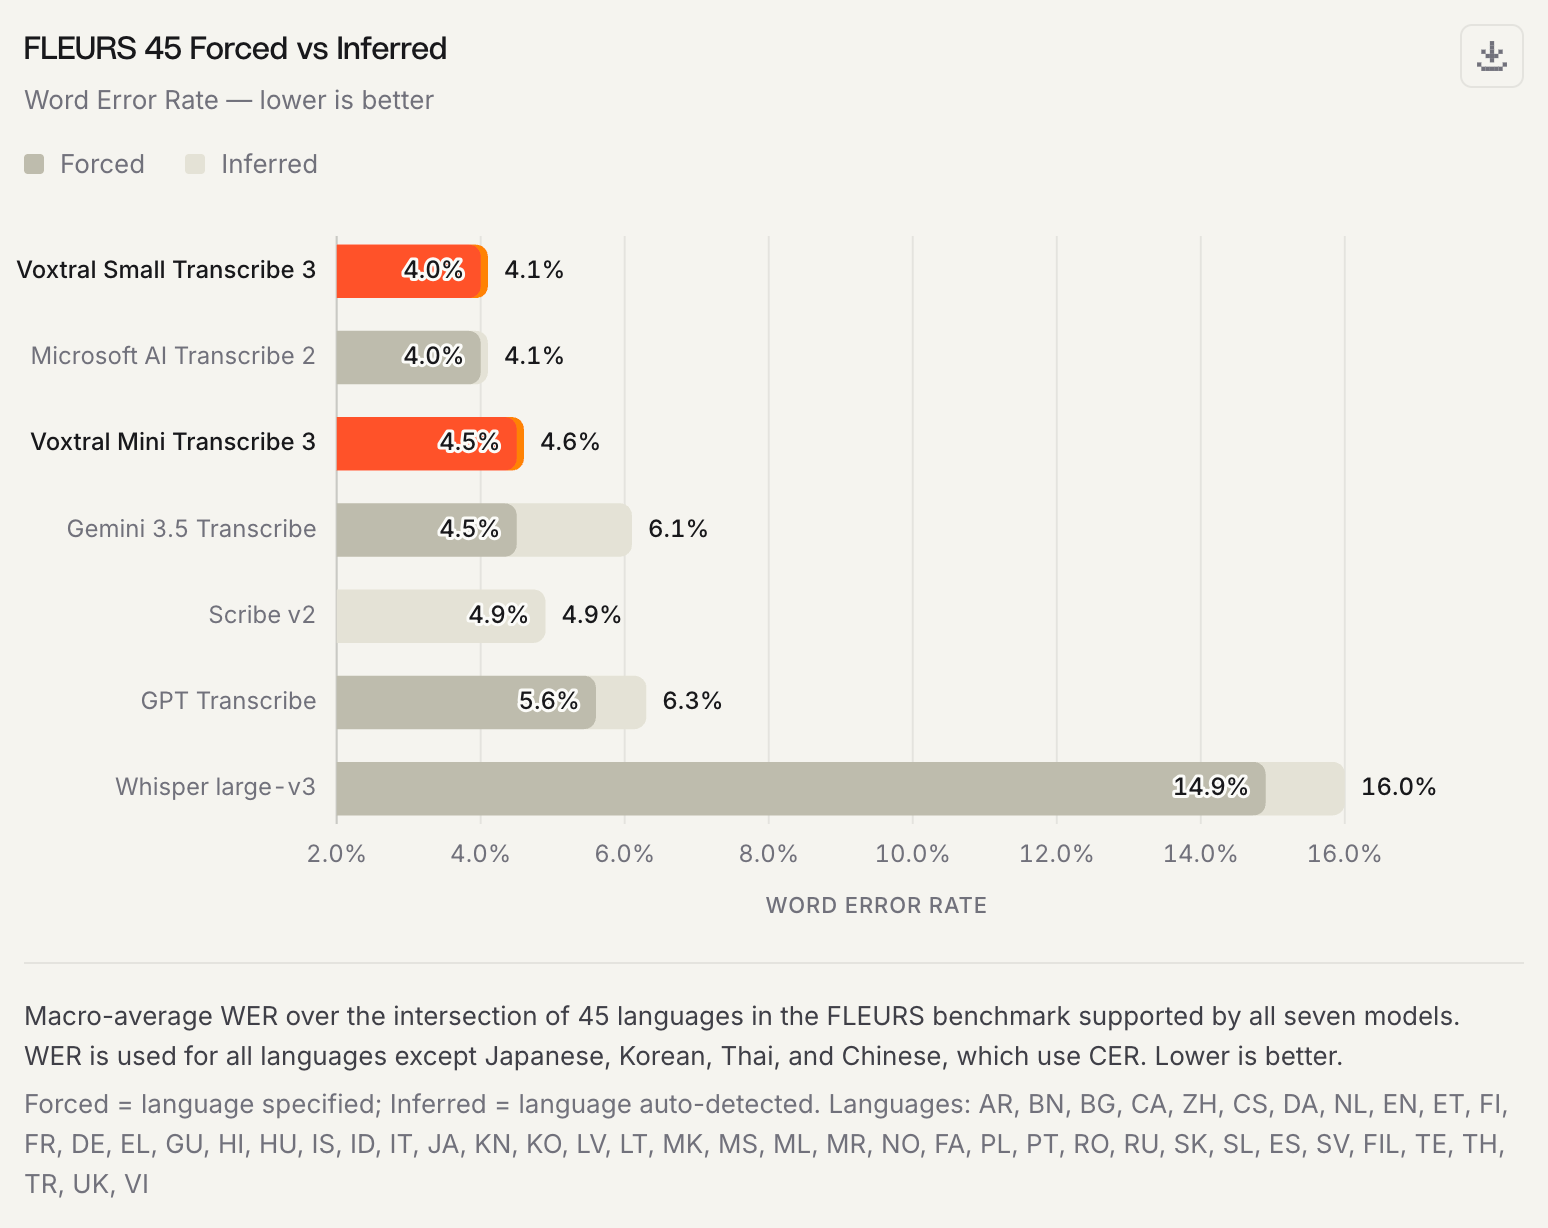
녹음 파일을 한꺼번에 처리하는 배치 모델에서는 미스트랄이 수치상 선두권에 섰다. 대표 모델 Voxtral Small Transcribe 3는 유럽연합 공식 언어 24개를 포함한 50개 언어를 받아 적는다. 일곱 개 모델이 모두 지원하는 45개 언어 FLEURS 평가에서 Small의 단어 오류율은 4.0~4.1%로 마이크로소프트의 MAI-Transcribe-2와 같았고, 매개변수 40억 개짜리 Mini는 4.5~4.6%, 오픈AI의 Whisper large-v3는 14.9~16.0%였다. 보도에 따르면 다섯 개 공개 데이터셋에서 잰 화자 분리 오류율은 Small 18.4%, MAI-Transcribe-2 20.3%였고, 외부 평가 기관 Artificial Analysis 순위에서 Small은 오류율 2.1%로 3위에 올랐다.
음성 합성 모델 Voxtral Mini TTS 3는 35개가 넘는 언어와 50개가 넘는 방언을 지원하고, 대화 맥락에 맞춰 감정과 속도, 강조를 바꾼다. 전문가용 Pro Voice는 30분 분량의 음성만으로 화자의 말투와 감정 폭을 여러 언어에 걸쳐 재현한다. 기본 음성 프리셋은 아랍어와 한국어, 베트남어를 포함한 18개 언어로 나왔다. 라이브킷 위에 만든 음성 에이전트 SDK는 듣기와 추론, 말하기를 하나의 스트리밍 흐름으로 돌린다. 미스트랄은 "어떤 단계도 앞 단계를 기다리지 않는다"며 한 차례 주고받기가 1초 안에 끝나고, 상대가 끼어들면 에이전트가 말을 멈춘다고 밝혔다. 전화는 SIP로, 브라우저와 앱은 WebRTC로 연결하며, 단계마다 모델이 따로라서 추론 모델이나 목소리, 언어를 에이전트를 다시 짜지 않고 바꿀 수 있다.
배포 방식은 미스트랄의 오랜 주권 노선을 따른다. Voxtral 3는 유럽에서 호스팅하는 미스트랄 API로 쓰거나 기업이 자체 인프라에 직접 설치할 수 있고, 음성을 어디서 처리하고 대화를 남길지 기업이 정한다. API는 유럽과 미국, 글로벌 엔드포인트로 열려 있고, 실시간 받아쓰기 모델은 공개 프리뷰 단계다. 보도에 따르면 이번 공개에서 누구나 내려받는 오픈 웨이트 모델은 발표되지 않았다.
콘텐츠마케터의 눈으로 보면 이번 실시간 전사 시연이 겨냥한 고객은 행사와 미디어를 만드는 쪽이다. 콘퍼런스 자막이 무너지는 지점은 대개 연사 이름과 제품명, 업계 약어 같은 고유명사인데, 미스트랄은 그 해법으로 이미 손에 있는 일정표를 내밀었다. 연사 명단과 세션 제목이 곧 정확도를 올리는 입력 자료가 되는 셈이다. 실시간 자막이 쌓이면 다시보기 영상의 자막, 발표 요약, 검색 가능한 기록으로 이어지는 콘텐츠 재가공의 출발점도 생긴다. 회사가 무대 시연 대신 약 이름이 쏟아지는 진료 상담 화면을 영상으로 고른 것은 전문 용어가 많은 현장 어디에나 같은 방식이 통한다는 메시지로 읽힌다.
댓글