

이미지: METAL
요약
- 구글 리서치가 11월 4일 주관적인 범주의 AI 이미지 분류기를 사람과 함께 다듬는 틀 애자일 딜리버레이션을 공개하고 코드를 깃허브에 오픈소스로 풀었다.
- 18회의 실시간 사용자 세션에서 이 틀로 만든 분류기는 제로샷보다 F1 점수가 평균 10.5%, 자동 분해 방식보다 7.5% 높았다.
- 수작업 숙의보다 노력과 스트레스 점수가 유의하게 낮았고, 참가자 전원이 애자일 딜리버레이션을 선호했다.
- 발표
- 2026년 11월 4일(현지 시각) · 구글 리서치 블로그 · CVPR 2026 논문(11쪽) · 깃허브 오픈소스 · Colab 데모
- 저자
- 오틸리아 스트레트쿠(연구과학자) · 레이제 왕(학생 연구원) 등 · 구글 리서치·구글·워싱턴대
- 방식
- 개념 범위 정하기 → 개념 반복(경계 이미지 5장 이하 제시 · 정의 후보 중 F1 최고 선택)
- 모델
- 개념 분해 제미나이 2.5 프로 · 나머지 제미나이 2.5 플래시 · 추가 학습 없음
- 실험
- 전문가 5명 인터뷰·정의 20건 분석 · 참가자 9명 × 2세션 = 18세션 · 세션당 약 90분 · 개념당 시험 이미지 200장
- 성능
- F1 제로샷 대비 평균 +10.5% · 모델링 콜라보레이터 대비 +7.5% · 페이 투 플레이 11% 대 8% · 건강한 음식 10% 대 -3%
- 설문
- 노력 3.11 대 4.67 · 스트레스 1.67 대 3.00(p<.05) · 수작업 검색어 평균 7.3개 · 전원 애자일 선호
구글 리서치가 11월 4일(현지 시각) 사람마다 경계가 다른 범주를 AI 이미지 분류기로 만드는 틀 애자일 딜리버레이션(Agile Deliberation)을 공개했다. 사용자가 개념을 하위 개념으로 쪼개도록 돕고, 판단이 갈리는 경계 사례 이미지를 골라 보여 준 뒤, 그 판단을 분류기 프롬프트에 자동으로 반영하는 방식이다. 18회의 실시간 사용자 세션에서 이 틀로 만든 분류기는 제로샷 분류기보다 F1 점수가 평균 10.5% 높았다. 코드는 깃허브에 오픈소스로 공개됐다.
연구를 이끈 구글 리서치의 오틸리아 스트레트쿠 연구과학자와 레이제 왕 학생 연구원은 블로그에서 문제의 출발점부터 짚었다. 이들은 기계학습이 "라벨을 붙이는 사람이 시작하기 전에 범주에 대해 명확하고 안정적인 정의를 갖고 있다"는 가정 위에 서 있다고 적었다. 정지 표지판이나 골든 리트리버처럼 경계가 분명한 대상에는 맞는 가정이다. 하지만 건강한 음식, 영감을 주는 미술, 콘텐츠 모더레이션처럼 문화와 개인의 철학, 운영 정책에 따라 경계가 움직이는 범주에는 맞지 않는다는 것이 연구진의 진단이다.
틀은 두 단계로 돈다. 첫 단계인 개념 범위 정하기에서 시스템은 사용자가 큰 개념을 하위 개념과 명시적인 제외 항목으로 나누도록 돕는다. 건강한 음식이라면 샐러드, 곡물 볼, 저지방 단백질을 포함 항목으로, 가공식품과 조리하지 않은 날 재료를 제외 항목으로 정하는 식이다. 둘째 단계인 개념 반복에서는 시각언어모델(VLM)이 지금의 정의로는 판단이 애매한 경계 이미지를 찾아 보여 준다. 블로그가 든 예는 과일 스무디다. 생과일이 들어갔으니 건강한 음료인지, 당분이 많으니 제외할 가공식품인지 사용자가 정해야 한다.
메탈이 확인한 CVPR 2026 논문 원문에 따르면 경계 이미지는 분류기의 확신도가 아니라 의미 공간에서 고른다. 논문은 VLM의 출력이 사람의 이해에 맞게 보정돼 있지 않아, 사람이 애매하다고 느끼는 사례에 높은 확신을 매기기도 한다고 이유를 댔다. 시스템은 경계 검색어를 만들어 이미지를 모으고, 비슷한 시각 특징끼리 묶은 뒤, 다중 슬롯머신 방식으로 다음에 보여 줄 묶음을 고르고, 한 번에 다섯 장 이하를 내놓는다. 사용자가 라벨과 짧은 이유를 남기면 언어모델이 정의 후보 여러 개를 쓰고, 지금까지의 라벨에 대해 F1 점수가 가장 높은 후보가 다음 정의가 된다. 구현에는 개념 분해에 제미나이 2.5 프로를, 나머지 작업에 제미나이 2.5 플래시를 추가 학습 없이 썼다.
실험은 벤치마크 대신 사람으로 했다. 연구진은 콘텐츠 모더레이션 전문가 5명을 인터뷰하고 그들이 실무에서 쓴 개념 정의 20건을 분석해 설계를 정했다. 평가에는 전문 모더레이션 경험이 없는 참가자 9명이 각자 두 세션씩 모두 18세션에 참여했고, 세션마다 약 90분이 걸렸다. 개념은 두 가지였다. 하나는 건강한 음식이고, 다른 하나는 온라인 오락과 게임에서 비현실적인 보상을 약속하는 클릭 유도 이미지를 가리키는 페이 투 플레이(pay to play)다. 페이 투 플레이에는 1억 장 규모의 자체 이미지 데이터, 건강한 음식에는 WebLI 데이터가 쓰였고, 개념마다 200장의 시험 이미지로 성능을 쟀다.
결과는 사람의 숙의가 들어간 쪽이 앞섰다. 논문에 따르면 애자일 조건 참가자들의 제로샷 분류기는 F1 점수가 0.5에 못 미쳤다. 애자일 딜리버레이션은 제로샷보다 평균 10.5%, 언어모델이 개념을 스스로 쪼개는 모델링 콜라보레이터 방식보다 7.5% 높은 F1 점수를 냈다. 수작업 숙의와 견주면 제로샷 대비 향상 폭이 페이 투 플레이에서 11% 대 8%, 건강한 음식에서 10% 대 마이너스 3%였다. 정확도 향상은 주로 정밀도에서 나왔고 재현율은 조금 내려갔다.
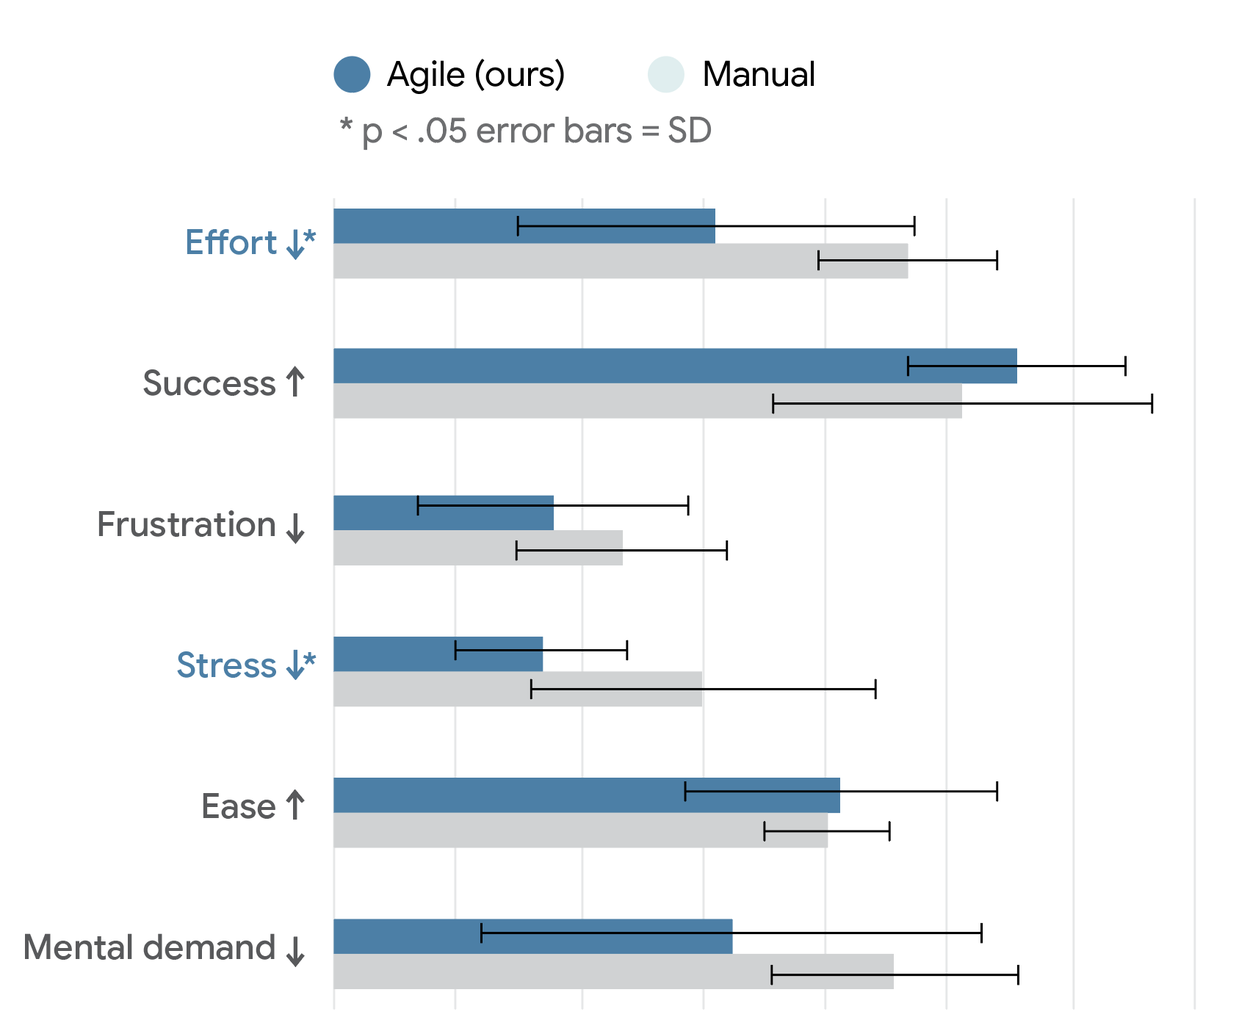
숫자보다 눈에 띄는 대목은 사람의 피로였다. 수작업 조건 참가자들은 경계 이미지를 찾으려고 평균 7.3개의 검색어를 시도했다. 한 참가자는 "내 정의의 경계가 어디인지 모를 때가 있어서, 내 정의에 반하는 검색어를 떠올리기가 어렵다"고 말했다. 설문에서 좋은 성능을 내는 데 든 노력은 3.11 대 4.67, 불안·스트레스·짜증은 1.67 대 3.00으로 애자일 쪽이 통계적으로 유의하게 낮았다. 참가자 전원이 수작업보다 애자일 딜리버레이션을 골랐고, 다른 참가자는 "경계 사례를 비교해 나열해 줘서 내 수고가 줄었다"고 평가했다.
사회학의 눈으로 보면 이 연구가 다루는 것은 분류를 누가 정하느냐의 문제다. 무엇이 건강한 음식이고 무엇이 해로운 광고인지는 원래 사람마다, 조직마다 다르게 그어진다. 지금까지의 분류기는 그 선을 누군가 이미 정해 두었다고 가정하고 라벨만 받았다. 애자일 딜리버레이션은 선을 긋는 과정 자체를 기계와의 대화로 끌어낸다. 연구진은 블로그에서 이 틀이 사람의 라벨로 AI가 배우기만 하는 "일방통행"을 사람과 AI가 함께 개념을 다듬는 "양방향 협업"으로 바꾼다고 밝혔다. 논문은 이 방식이 분류기 만들기를 전문가 밖으로 넓혀 더 많은 사람이 자기 가치와 관점을 시각 시스템에 담게 한다고 적었다.
이 연구는 구글 리서치와 구글 애즈의 협업으로 나왔고, 연구 참가자는 회사 안의 공개 모집으로 뽑혔다. 메탈은 미스트랄의 오픈웨이트 안전 분류기 쉴드스트랄 1.0 3B 공개를 보도한 바 있다. 정책을 글로 받아 판단하는 분류기가 늘수록, 그 글을 누가 어떻게 쓰는지가 분류 결과를 좌우한다. 연구진은 건강한 음식 예제를 따라 해 볼 수 있는 Colab 데모도 함께 내놓았다.
댓글