

이미지: METAL
요약
- 앤스로픽은 11월 3일 AI 응답이 특정 모델에서 나왔음을 암호학적으로 증명하는 연구 시스템 FlashProve를 Apache 2.0 라이선스로 공개했다.
- 4000억 매개변수 Llama 4 Maverick을 H100 한 장에서 초당 약 110토큰으로 증명했고, 18.78MB 증명 하나를 CPU 24스레드에서 17초에 검증한다.
- 증명 비용은 일반 추론의 약 72~94배이며, 문맥 1024토큰·정수 모델 그리디 디코딩 한정의 연구 프로토타입으로 배포 계획은 없다.
- 발표
- 2026년 11월 3일(현지 시각) · 앤스로픽 리서치 블로그 · 기술 보고서(23쪽) · 프로토콜 문서(114쪽) · GitHub 저장소
- 공동 연구
- 앤스로픽 로이 린버그·앨릭스 앨런 · EPFL · MIT · StarkWare
- 시험 모델
- Llama 4 Maverick · 4000억 매개변수 MoE · 전문가 128개 · 토큰당 약 170억 활성 · 4비트 가중치 232GB
- 증명기 성능
- H100 1장 · CPU 24코어 · 초당 약 110토큰 · 24건 묶음 약 223초 · 증명 18.78MB(1024토큰 요청)
- 커밋
- 모델당 약 39분 · 2.15GB 보관 · 약 1600만 요청 유효
- 검증기
- GPU 불필요 · 24스레드 17초 · 단일 스레드 21초 · 최초 내려받기 6.24MB
- 비용
- vLLM(FP8·H100 8장) 대비 GPU당 약 72배(66~77배) · 최고 부하 대비 약 94배
- 한계
- 문맥 1024토큰 · 정수 모델 그리디 디코딩 · 모델 구조 비공개 불가 · 부채널 공격 범위 밖
앤스로픽이 11월 3일(현지 시각) AI 모델의 응답이 정말 그 모델에서 나왔는지 암호학적으로 확인하는 연구 시스템 FlashProve를 공개했다. 모델 제공자가 가중치에 대한 짧은 지문을 먼저 공개하고, 응답마다 증명 파일을 붙이면 누구나 일반 CPU에서 몇 초 만에 검증한다. 증명은 가중치를 드러내지 않는다. 4000억 개 매개변수의 Llama 4 Maverick을 대상으로 H100 GPU 한 장에서 초당 약 110토큰을 증명했고, 코드와 Lean 증명, 문서는 Apache 2.0 라이선스로 풀렸다.
출발점은 지금의 AI 서비스에 없는 확인 수단이다. 사용자는 자신이 고른 모델이 답했는지 확인할 방법이 없다. 라우팅 서비스가 비용을 아끼려고 더 싼 모델을 몰래 끼워 넣거나, 공격자가 토큰 흐름을 조작해도 출력만 보고는 알 수 없다. 연구진은 블로그에서 "모델의 출력만으로 판단하는 것은 신뢰할 수 없다. 응답의 품질이 높더라도 그렇다"고 밝혔다. 출시 전후 모델을 시험하는 외부 평가 기관도 자신이 시험한 모델이 실제로 서비스되는 모델인지 확인해야 한다.
FlashProve가 쓰는 도구는 영지식 간결 증명, 곧 zkSNARK다. 제공자는 오프라인 단계에서 가중치에 대한 커밋먼트를 한 번 공개하고, 온라인 단계에서 요청마다 "커밋한 모델이 이 입력에서 이 출력 토큰을 낸다"는 명제를 증명한다. 증명은 위조할 수 없고(건전성), 가중치와 중간 계산, 각 층에서 어떤 전문가 모듈이 돌았는지를 숨기며(영지식), 실제 계산보다 훨씬 빨리 확인된다(간결성). 다만 모델 구조는 숨기지 않는다. 기술 보고서에 따르면 이 체계는 해시 함수 BLAKE2의 안전성에만 기대며, 양자 컴퓨터 공격에도 견딜 것으로 보는 구성이다. 요청 하나를 증명하는 데 합 검사(sumcheck) 절차가 약 2000번 돈다.
수치는 구체적이다. 시험 모델은 전문가 128개로 이뤄진 4000억 매개변수 전문가 혼합(MoE) 모델 Llama 4 Maverick이고, 토큰마다 약 170억 개 매개변수만 쓰인다. 공개된 4비트 가중치는 232GB다. 증명기는 H100 한 장과 CPU 코어 24개로 돈다. 커밋 단계는 모델당 한 번 약 39분 걸리고 제공자는 2.15GB의 파일을 보관하며, 한 번의 커밋으로 약 1600만 건의 요청을 다룬다. 1024토큰 요청 24건 묶음을 약 223초에 증명해 초당 110토큰이 나오고, 증명 파일 하나는 18.78MB다. 검증 쪽은 GPU가 필요 없다. 기술 보고서 기준으로 사용자는 커밋먼트 등 6.24MB를 한 번 내려받고, 증명 하나를 24스레드에서 17초, 단일 스레드에서 21초에 확인한다.
비용도 숫자로 나왔다. 같은 모델의 FP8 판을 H100 여덟 장에서 vLLM으로 돌린 것과 견주면 GPU당 증명 시간은 일반 처리의 약 72배(측정마다 66~77배)였고, vLLM을 가장 높은 부하로 돌렸을 때와 견주면 약 94배였다. 묶음으로 처리하면 요청 하나가 증명을 받기까지 약 5분이 걸리고, 한 건씩 증명하면 58초에 나오지만 처리량은 초당 17.6토큰으로 떨어진다. 가중치를 층 단위로 나눠 일반 메모리에서 흘려보내는 설계 덕에 80GB GPU 한 장과 약 290GB의 호스트 메모리면 충분하다.
앞선 연구와의 거리는 크다. 블로그가 정리한 선행 연구 가운데 같은 Llama 4 Maverick을 증명한 VerInf는 DGX Spark에서 1000토큰에 14.3시간이 걸렸고, 증명 파일은 93.6GB에 검증에만 거의 하루가 들었다. 2024년의 zkLLM은 130억 매개변수 모델에서 초당 약 2.5토큰이었다. 상용 업체 Attestable은 310억 매개변수 Gemma 4를 H100 한 장에서 초당 53~77토큰으로 증명했다고 밝혔지만, 오픈소스로 공개하지는 않았다.
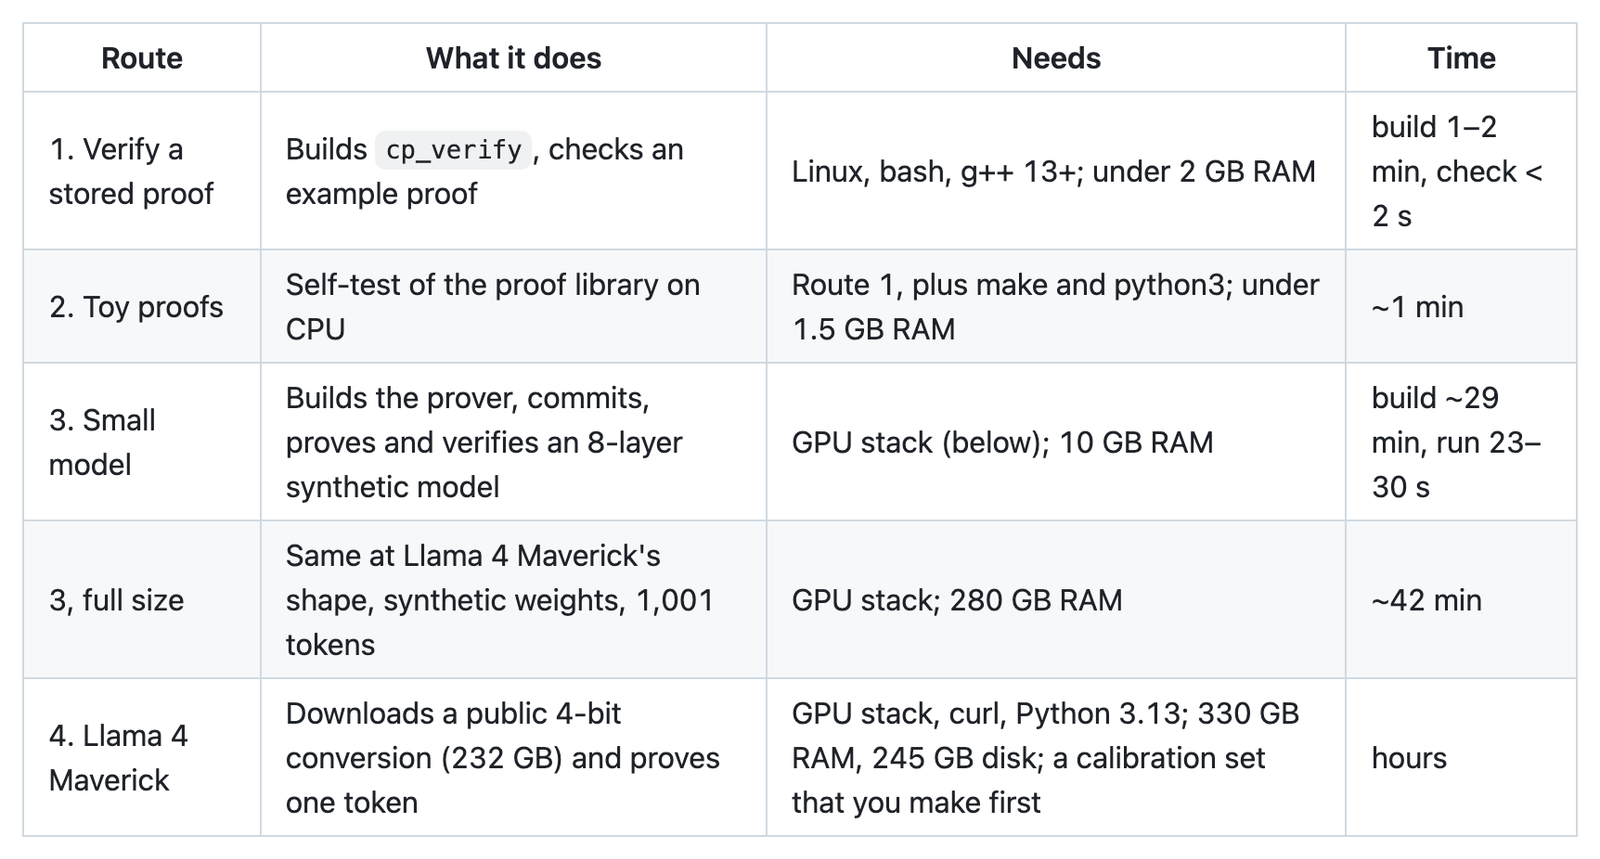
메탈이 확인한 기술 보고서와 GitHub 저장소에서 두드러지는 대목은 이 시스템을 상당 부분 클로드가 만들었다는 점이다. 보고서에 따르면 C++ 검증기와 GPU 증명기 코드는 Lean으로 쓴 명세에서 AI 에이전트가 만들어 냈다. 연구진은 블로그에서 "클로드는 최적화에 능하지만, 특히 크고 복잡한 시스템에서는 평가하기 어려운 결정을 자주 내린다"고 적었다. 그래서 완전성, 건전성, 영지식이라는 최상위 보안 성질을 형식 검증 언어 Lean으로 증명해 두고, 사람은 그 진술만 감사하면 되는 방법을 택했다. 저장소의 건전성 정리는 해시 질의 q번 뒤 속임이 통할 확률을 q/2^124 + 2^-101 정도로 묶는다. 114쪽짜리 프로토콜 문서는 AI가 썼고 연구진이 세부까지 검토하지는 않았으며, 23쪽 기술 보고서는 저자들이 직접 썼다고 보고서는 밝혔다.
언론인의 눈으로 보면 이 연구의 쓸모는 검증하는 쪽의 힘을 키우는 데 있다. 블로그는 네 가지 쓰임을 들었다. 규제 당국이 특정 기간의 추론 요청에 대한 증명서를 요구해 하드웨어가 실제로 추론에 쓰였는지 확인하는 AI 개발 속도 조절, 침입자나 스스로를 바꿔 끼운 모델을 잡아내는 변조 탐지, 어떤 결과가 정말 최상위 모델의 분석을 거쳤는지 보이는 텍스트 출처 증명, 승인된 모델만 서비스하게 하는 모델 승인이다. 연구진은 증명 하나로 하드웨어가 추론을 하고 있음은 보이지만, 옆에서 몰래 학습을 돌리지 않는다는 것까지 증명하지는 못한다고 적었다.
이 작업은 앤스로픽이 스스로 내건 약속과 이어진다. 회사는 프런티어 안전 로드맵에서 "2026년 9월 30일까지 AI 모델 출력을 특정 가중치에 귀속시키는 프로버블 인퍼런스 프로토타입을 개발하겠다"고 밝혔다. 블로그에 따르면 그 목표는 추론 트래픽에 서명하고 신뢰할 수 있는 서버에서 다시 계산하는 별도 프로젝트로 이미 달성했고, FlashProve는 같은 목표를 다른 방법으로 좇는다. 10월 19일 갱신에서 목표의 이름도 추론 검증으로 바꿨다. 보도에 따르면 이번 작업은 프런티어 레드팀이 EPFL, MIT, StarkWare 연구자들과 함께 했고, 앤스로픽이나 다른 연구소에 배포할 계획은 아직 없다.
메탈은 앤스로픽이 클로드로 오픈소스 123개를 형식 검증한 연구를 보도한 바 있으며, 이번 공개는 AI가 쓴 코드를 수학적 증명으로 묶어 믿게 만드는 같은 방법의 다음 단계다. 그때는 남의 코드를 검증했고, 이번에는 AI가 만든 암호 시스템 자체를 Lean 진술로 감사하게 했다.
남은 숙제도 연구진이 직접 적었다. 증명은 문맥 1024토큰까지만 다루고, 부동소수점 추론이 아닌 정수 모델의 그리디 디코딩을 증명하므로 샘플링한 응답과는 어느 지점에서 어긋날 수 있다. 증명 시간으로 가중치 정보를 엿보는 부채널 공격은 범위 밖이고, 영지식은 요청을 하나씩 증명할 때만 형식적으로 증명됐다. 저장소는 0.16.0판의 연구 산출물이며 유지보수도 기여도 받지 않는다. 연구진은 "이 게시물은 완성된 연구 과제가 아니라 중간 진척을 공유하려는 것"이라며 "다른 이들이 우리가 한 일을 보고 가져가 개선하기를 바라며 공개한다"고 밝혔다. 응답 하나를 증명하는 데 드는 비용이 일반 추론의 약 70~95배라는 숫자가 얼마나 빨리 줄어드느냐가 이 기술이 실제 서비스의 영수증이 될지를 정한다.
댓글