

이미지: @OpenAIDevs (X) 영상 갈무리
요약
- 오픈AI는 10월 23일 저장 플랫폼 해비탯 확장기 2편에서 애저 코스모스 DB를 공용·전용·공용 세 단계로 운영해 온 과정을 밝혔다.
- 가장 큰 코스모스 DB 계정은 수십 페타바이트를 저장하고 초당 2000만 건이 넘는 쿼리를 처리한다.
- 근처 지역 복제·지역 내 캐시·러스트 재작성으로 전 세계 읽기 지연 중앙값을 12배 줄였고, 엑사바이트급 자체 저장 시스템을 개발 중이다.
- 발표
- 2026년 10월 23일 · 오픈AI 엔지니어링 블로그 Part II · @OpenAIDevs X
- 필자
- 존 리 · 흐라차 하코비안 · 차오민 위 (오픈AI 기술 스태프)
- 해비탯 규모
- 40개 지역 · 사용자 10억 명 이상 · 데이터 500페타바이트 이상
- 고객 제품
- 챗GPT · API · 코덱스 · 내부 서비스
- 세 단계
- 공용 컨테이너 → 전용 컨테이너 → 공용 컨테이너 기본값 복귀
- 파티션 한도
- 논리 파티션 키당 1만 RU/s(실제 한도는 물리 파티션)
- 약한 파티션
- 분할 시 처리량 절반(1만 → 5000 RU/s × 2)
- 전용 컨테이너 부담
- 0→100만 QPS 신규 기능이 내부 시험 대비 1000배 부하
- 복귀 수단
- 핫 키 조절 · 요청 등급제(QoS) · 애저 신규 서버리스 모드
- 서버리스 모드
- 기존 파티션당 5000 RU/s → 신규 1만 RU/s · 사용량 기준 분할
- 사고
- 변경 뒤 몇 달간 용량 배정·이웃 간섭 사고 0건(회사 발표)
- 최대 계정
- 수십 페타바이트 · 초당 2000만 쿼리 이상
- 2024년 말 장애
- 주 지역 정전 → 장애조치 몇 시간 · 약 한 달 뒤 복귀 중 접속 폭주 장애
- 읽기 비중
- 해비탯 요청의 90% 이상
- 복제
- 인증 메타데이터 등 고복제 계정 · 일부 계정은 애저 40개 지역 전체 복제
- 캐시
- 밸키 · 변경 데이터 캡처로 몇 초 안 전역 무효화
- 지연
- 읽기 p50 약 120ms → 약 10ms · 12배
- CDC
- 초당 수백만 변경 · 수천 컨테이너 · 카프카 토픽 100개 이상
- 다음 단계
- 엑사바이트급 자체 저장 시스템 · RocksDB Cloud 코어 + Raft 복제
오픈AI가 챗GPT와 API, 코덱스를 떠받치는 저장 플랫폼 해비탯(Habitat)의 확장기 2편을 10월 23일 엔지니어링 블로그에 공개했다. 이번 편은 해비탯 아래에서 실제 데이터를 담는 마이크로소프트의 분산 데이터베이스 애저 코스모스 DB(Azure Cosmos DB)를 어떻게 키웠는지 다룬다. 해비탯은 40개 지역에 흩어진 10억 명 이상의 사용자에게 밀리초 단위로 응답해야 하고, 지금 500페타바이트가 넘는 데이터를 다룬다. 오픈AI는 애저 팀과 함께 저장 구조를 고쳐 전 세계 읽기 지연의 중앙값을 약 120밀리초에서 약 10밀리초로 12배 줄였다고 밝혔다.
글은 존 리(Jon Lee), 흐라차 하코비안(Hrachya Hakobyan), 차오민 위(Chaomin Yu) 오픈AI 기술 스태프가 썼다. 9월에 나온 1편이 해비탯을 파이썬 라이브러리에서 서비스로 떼어 낸 과정을 다뤘다면, 2편은 데이터베이스를 여러 제품이 나눠 쓰는 멀티테넌트 구조를 두고 오간 세 단계를 기록했다. 하나의 공용 컨테이너로 시작해 제품마다 전용 컨테이너를 따로 두었다가, 다시 공용 컨테이너를 기본값으로 되돌아온 여정이다.
첫 단계의 문제는 구조 안에 숨어 있었다. 코스모스 DB는 논리 파티션 키 하나에 초당 1만 요청 단위(RU/s)라는 한도를 문서로 밝히지만, 실제 한도는 여러 논리 키가 함께 올라가는 물리 파티션에서 걸린다. 초기 API가 파티션 키 선택을 제품 쪽에 그대로 맡긴 탓에 user_id나 workspace_id 같은 흔한 키가 여러 제품 사이에서 겹쳤다. 그 결과 틈새 기능의 작업이 로그인과 가입 같은 핵심 흐름을 방해했다. 데이터가 불어나 물리 파티션이 쪼개지면 각 파티션이 받는 처리량이 절반으로 줄어, 요청량이 그대로여도 저장량만으로 성능이 떨어지는 일도 생겼다.
두 번째 단계에서 오픈AI는 중요한 서비스마다 전용 컨테이너를 붙였다. 사이트 전체가 멈추는 장애는 줄었지만 새 부담이 생겼다. 공용 컨테이너에서는 초당 0건에서 100만 건으로 뛰는 신규 기능도 전체 사용량을 크게 흔들지 않았는데, 전용 컨테이너에서는 같은 기능이 내부 시험 때보다 1000배 많은 부하가 된다. 제품팀이 출시 전에 용량을 미리 늘리는 일을 잊으면 출시 당일 장애 대응실에서 막판 증설을 해야 했다. 저자들은 "중앙에서 계획하는 팀이 하나도 없자 많은 팀이 계획을 엉망으로 세웠다"고 적었다.
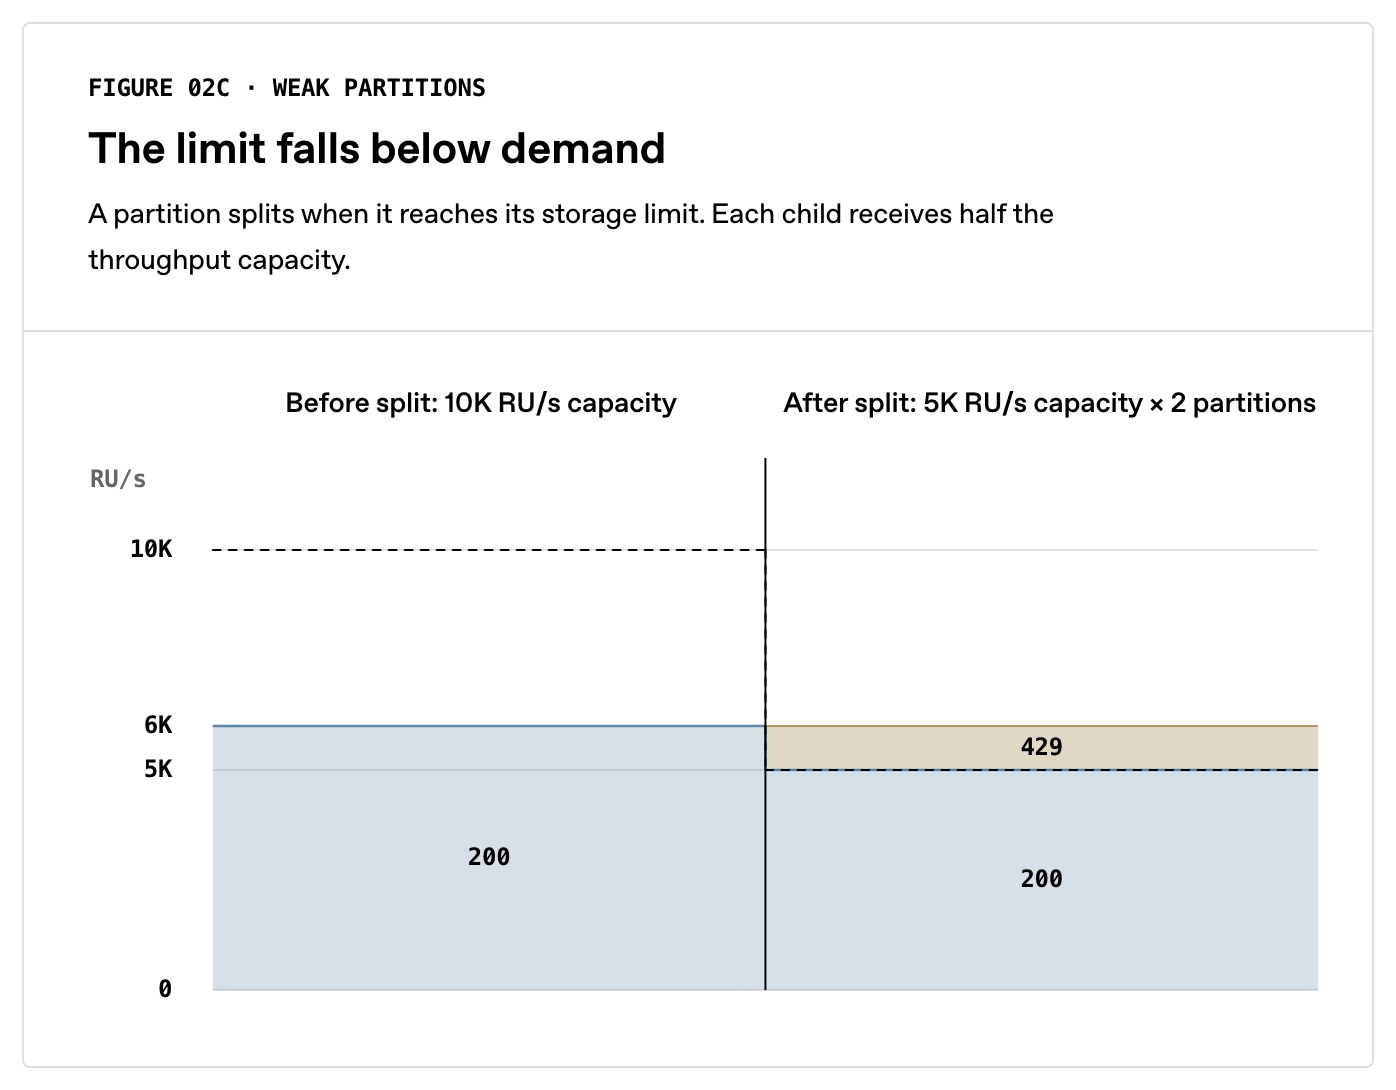
세 번째 단계는 공용 구조로의 복귀였다. 오픈AI는 가장 뜨거운 키부터 먼저 속도를 늦추는 핫 키 조절, 대량 입력이나 데이터 추출 같은 오프라인 작업에 낮은 우선순위를 주는 요청 등급제를 도입했다. 기존 코스모스 DB 서버리스 모드는 물리 파티션당 5000 RU/s로 묶여 있었는데, 애저 팀이 오픈AI를 위해 새로 만든 서버리스 모드는 파티션마다 1만 RU/s까지 늘고 저장량뿐 아니라 사용량을 기준으로도 파티션을 나눈다. 회사는 이 변경 뒤 몇 달 동안 용량 배정이나 이웃 간섭으로 인한 사고가 한 건도 없었다고 밝혔다.
규모는 관계도 바꿨다. 오픈AI의 가장 큰 코스모스 DB 계정은 수십 페타바이트를 저장하고 초당 2000만 건이 넘는 쿼리를 처리한다. 저자들은 "우리가 아는 한 애저 코스모스 DB를 이 규모로 배포한 회사는 우리뿐"이라며 "오픈AI 규모로 커지면 관리형 서비스는 덜 관리형이 된다"고 말했다. 계기는 2024년 말 장애였다. 대형 계정의 주 지역에 정전이 나자 보조 지역으로 넘기는 데 몇 시간이 걸렸고, 약 한 달 뒤 원래 지역으로 되돌리다 접속이 한꺼번에 몰려 또 한 번 큰 장애가 났다. 지금 두 회사 엔지니어는 운영 계정과 같은 규모의 시험 계정에서 변경을 함께 시험하고, 지원 창구를 거치지 않고 서로를 직접 호출한다.
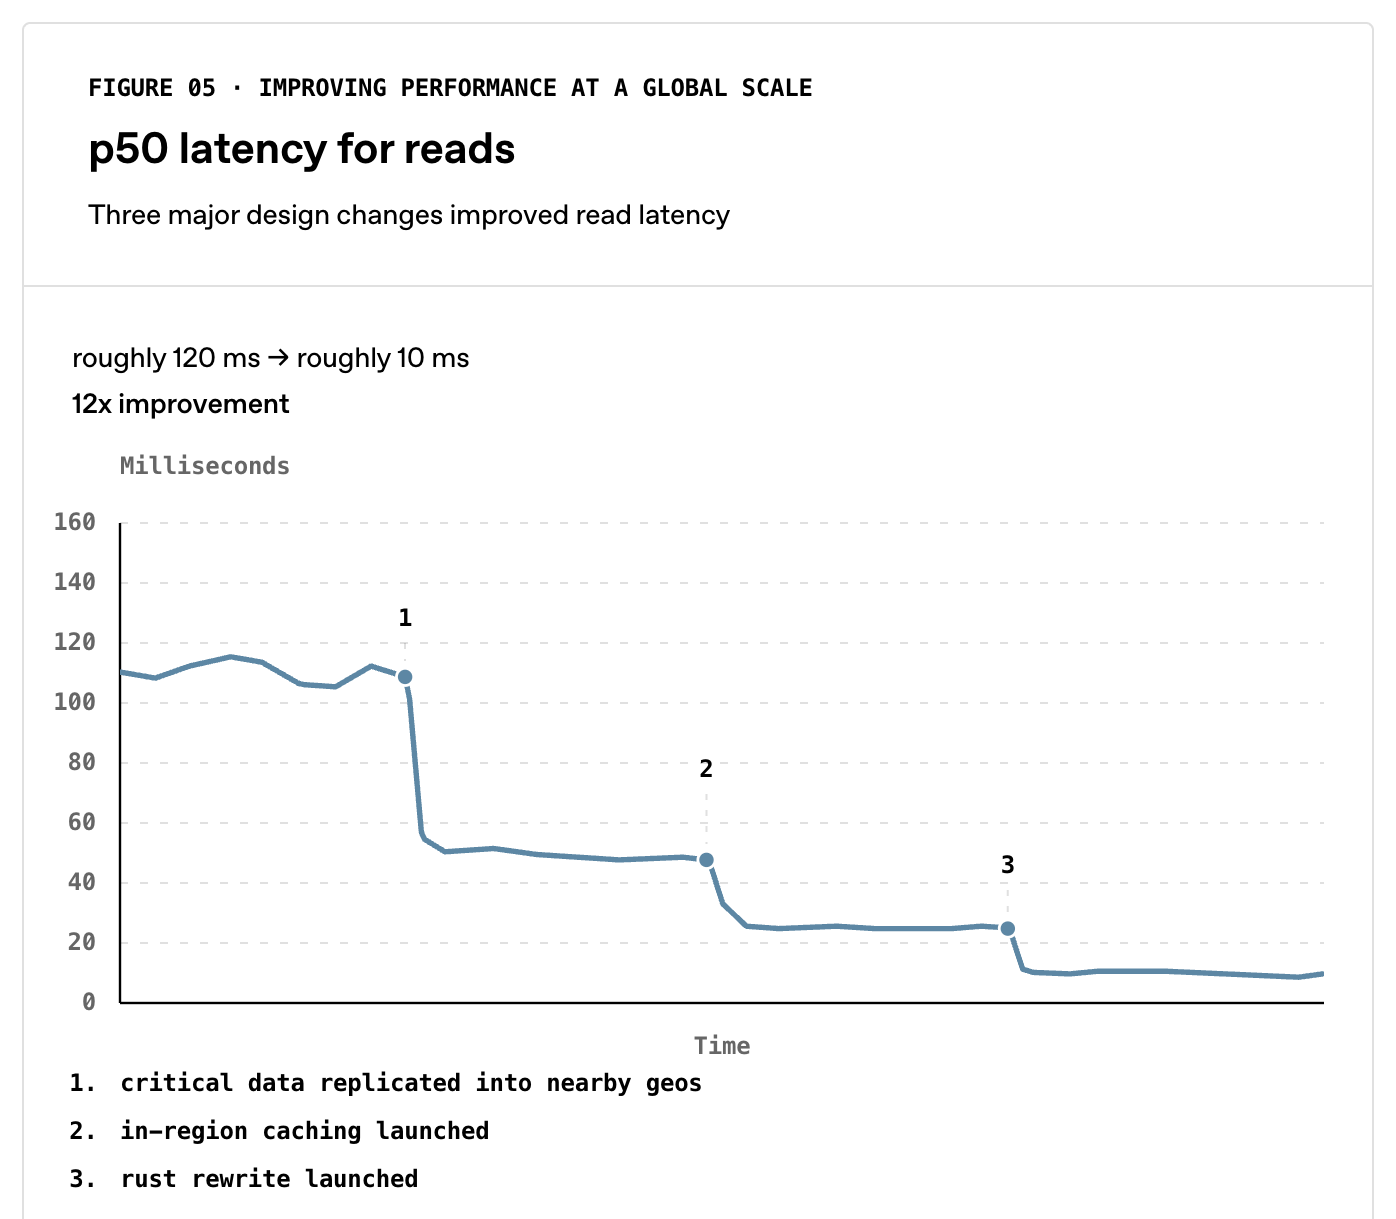
속도 개선은 2026년의 과제였다. 해비탯 요청의 90% 이상이 읽기다. 오픈AI는 데이터를 사용자 가까이 두되, 데이터센터 용량과 전력, 냉각이 모자란 지역에서는 저장소를 가까이 둘지 서빙용 컴퓨트를 더 둘지 직접 저울질해야 한다고 설명했다. 모든 요청에 필요한 인증 메타데이터처럼 작고 지연에 민감한 데이터는 보조 지역을 많이 둔 계정에 담고, 그중 일부 계정은 서비스 중인 애저 40개 지역 전체에 복제한다. 나머지는 사용자 가까이 둔 밸키(Valkey) 캐시가 맡고, 메타의 TAO 같은 방식을 따라 변경 데이터 캡처(CDC)로 몇 초 안에 전 세계 캐시를 무효화한다. 해비탯 서비스를 파이썬에서 러스트로 다시 쓴 것까지 더해 읽기 지연이 세 번에 걸쳐 내려갔다.
메탈이 확인한 블로그 원문의 도표를 보면 지연 곡선은 가까운 지역 복제, 지역 내 캐시 도입, 러스트 재작성 세 지점에서 계단식으로 떨어진다. 캐시를 떠받치는 변경 데이터 캡처는 수천 개 컨테이너와 수백만 개 파티션에서 초당 수백만 건의 변경을 받아 100개가 넘는 카프카 토픽으로 흘려보낸다. 메탈은 오픈AI가 초당 7천만 요청을 파이썬으로 버틴 해비탯 1편을 보도한 바 있다.
다음 수순은 자체 저장 시스템이다. 오픈AI는 다음 10억 명을 맞으려면 데이터 복제를 훨씬 큰 규모로 풀어야 한다며 엑사바이트급 자체 온라인 저장 시스템을 개발하고 있다고 밝혔다. 록셋의 RocksDB Cloud 코어에 Raft 기반 복제를 얹고 코스모스 DB와 같은 문서 모델을 쓰되, 저장 장치를 분리하고 물리 복제를 써서 필요한 플래시 용량을 줄이는 대신 최대 처리량은 낮춘 설계다. 클라우드 업체와 한 몸처럼 일해 한계를 넘긴 회사가 결국 가장 무거운 데이터부터 직접 담는 길로 들어선 셈이다.
댓글