


이미지: METAL
요약
- 딥시크가 10월 17일 V4.1-Flash의 새 체크포인트 DeepSeek-V4.1-Flash-1017을 웹·앱·API에 공개하고 허깅페이스와 모델스코프에 올렸다.
- 딥시크 공식 표에서 1017은 직전 버전을 11개 항목 모두에서 앞섰고 DeepSWE v1.1 77.0으로 클로드 Opus 5(74.0)보다 높았다. 도구 없는 HLE는 42.6으로 클로드 Opus 5(56.3)에 못 미쳤다.
- 하루 수억 건을 처리하는 자체 검색 엔진 기반 검색·페치 API를 모든 개발자에게 열었고, 코딩 에이전트의 서버 측 호출 과금은 10월 31일 시작한다.
- 공개
- 2026년 10월 17일 · 딥시크 X · API 문서 공지
- 모델
- DeepSeek-V4.1-Flash-1017 · API 이름 deepseek-flash
- 구조(보도)
- 백본 552B + 엔그램 196B · 활성 8B 프리필 / 16B 디코딩
- 컨텍스트(보도)
- 100만 토큰 · 출력 최대 38만4000토큰
- 학습
- 자기 피드백 강화학습으로 엔드투엔드 프로젝트 개발 강화
- DeepSWE v1.1
- 77.0 (직전 74.2 · 클로드 Opus 5 74.0)
- Terminal-Bench 4.0
- 42.3 (직전 31.2 · 클로드 Opus 5 51.8)
- HLE 도구 없음
- 42.6 (클로드 Opus 5 56.3)
- 검색·페치 API
- 자체 검색 엔진 · 하루 수억 건 · 모든 개발자 공개
- 과금 시작
- 하니스·클로드 코드·Codex 서버 측 호출 10월 31일 16시(UTC)
- 공개 저장소
- 허깅페이스 · 모델스코프
딥시크가 경량 모델 V4.1-Flash의 새 체크포인트 DeepSeek-V4.1-Flash-1017을 10월 17일 공개했다. 딥시크는 X와 API 문서 공지에서 "이전 버전보다 벤치마크 성능이 높고, 작업을 더 빨리 끝내며, 출력은 더 짧다"며 "성능과 비용 양쪽의 파레토 개선"이라고 밝혔다. 새 모델은 딥시크 웹사이트와 앱, API에 바로 올라갔고, 딥시크는 같은 날 자체 검색 엔진을 쓰는 검색·페치 API를 모든 개발자에게 열었다.
이번 판은 9월 초 나온 V4.1-Flash의 사후 학습을 다시 한 체크포인트다. 메탈은 딥시크가 1.6조 파라미터 V4-Pro 대신 552B 규모 V4.1-Flash로 주력을 옮긴 소식을 보도한 바 있다. 보도에 따르면 V4.1-Flash 구조는 백본 파라미터 552B와 엔그램(Engram) 파라미터 196B로 이뤄지고, 토큰당 프리필에서 8B, 디코딩에서 16B만 활성화한다. 컨텍스트는 100만 토큰, 출력은 최대 38만4000토큰이다. API에서는 deepseek-flash라는 이름으로 부른다.
딥시크가 내세운 변화는 학습 방식이다. 회사는 1017이 "자기 피드백을 쓰는 강화학습"으로 게임 제작부터 3D 모델링까지 처음부터 끝까지 완성하는 프로젝트 개발 능력을 끌어올렸다고 설명했다. 공지에 실린 시연은 자금성 3D 모델링, 웹 레이싱 게임, 고도(Godot) 엔진으로 다시 만든 포털 2, 선사 시대부터 현대까지의 변화를 담은 3D 장면 「밸리 오브 에이지스」 네 가지다.
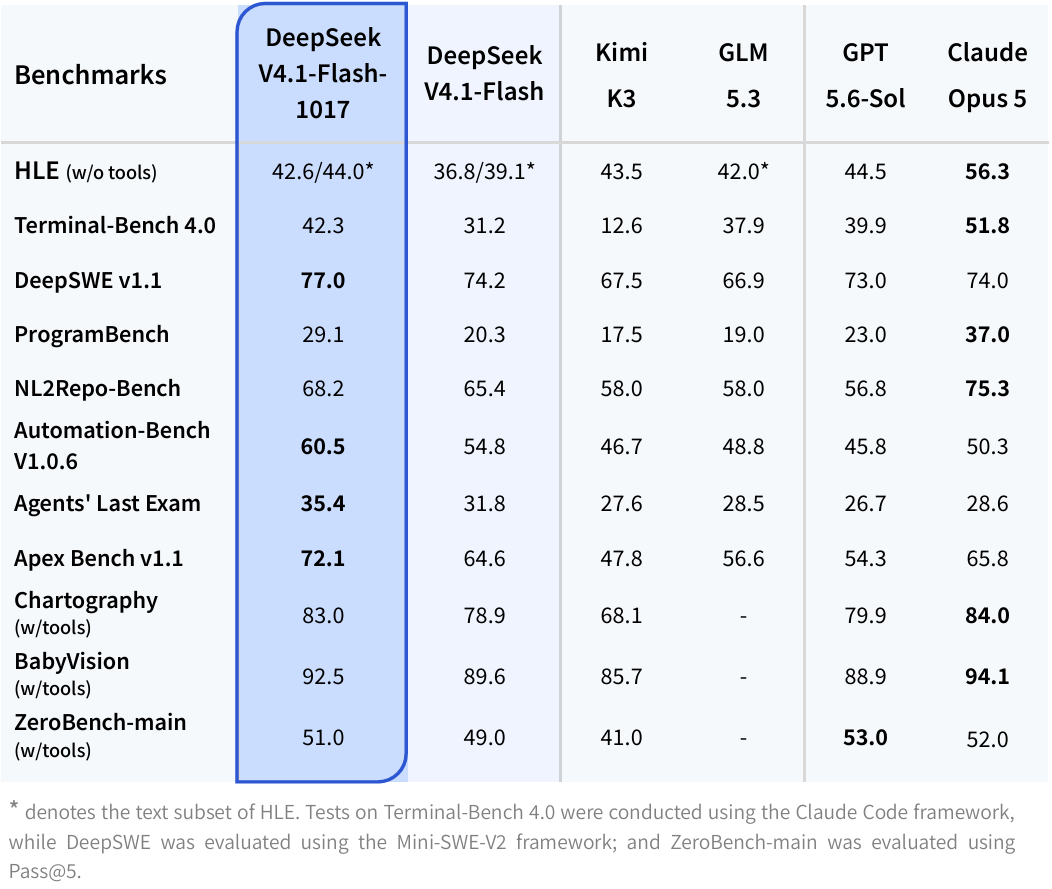
메탈이 확인한 딥시크 공식 벤치마크 표에서 1017은 직전 V4.1-Flash를 11개 항목 모두에서 앞섰다. 실제 저장소의 버그를 고치는 DeepSWE v1.1은 74.2에서 77.0으로, 터미널 작업을 재는 Terminal-Bench 4.0은 31.2에서 42.3으로, ProgramBench는 20.3에서 29.1로 올랐다. 같은 표에서 DeepSWE v1.1 77.0은 클로드 Opus 5의 74.0, GPT 5.6-Sol의 73.0보다 높고, Automation-Bench 60.5와 Agents' Last Exam 35.4, Apex Bench 72.1도 비교 대상 가운데 가장 높다. 표는 모두 딥시크가 직접 잰 값이며, Terminal-Bench 4.0은 클로드 코드 프레임워크로, DeepSWE는 Mini-SWE-V2 프레임워크로 돌렸다고 각주에 적혀 있다.
같은 표가 보여 주는 격차도 있다. 도구 없이 푸는 HLE에서 1017은 42.6을 받아 클로드 Opus 5의 56.3에 크게 못 미쳤다. Terminal-Bench 4.0(51.8), ProgramBench(37.0), NL2Repo-Bench(75.3), BabyVision(94.1)에서도 클로드 Opus 5가 앞섰고, ZeroBench-main은 GPT 5.6-Sol이 53.0으로 가장 높았다. 긴 코드 저장소를 통째로 만드는 과제와 고난도 지식 추론에서는 아직 상위 폐쇄형 모델과 거리가 있다는 뜻이다.
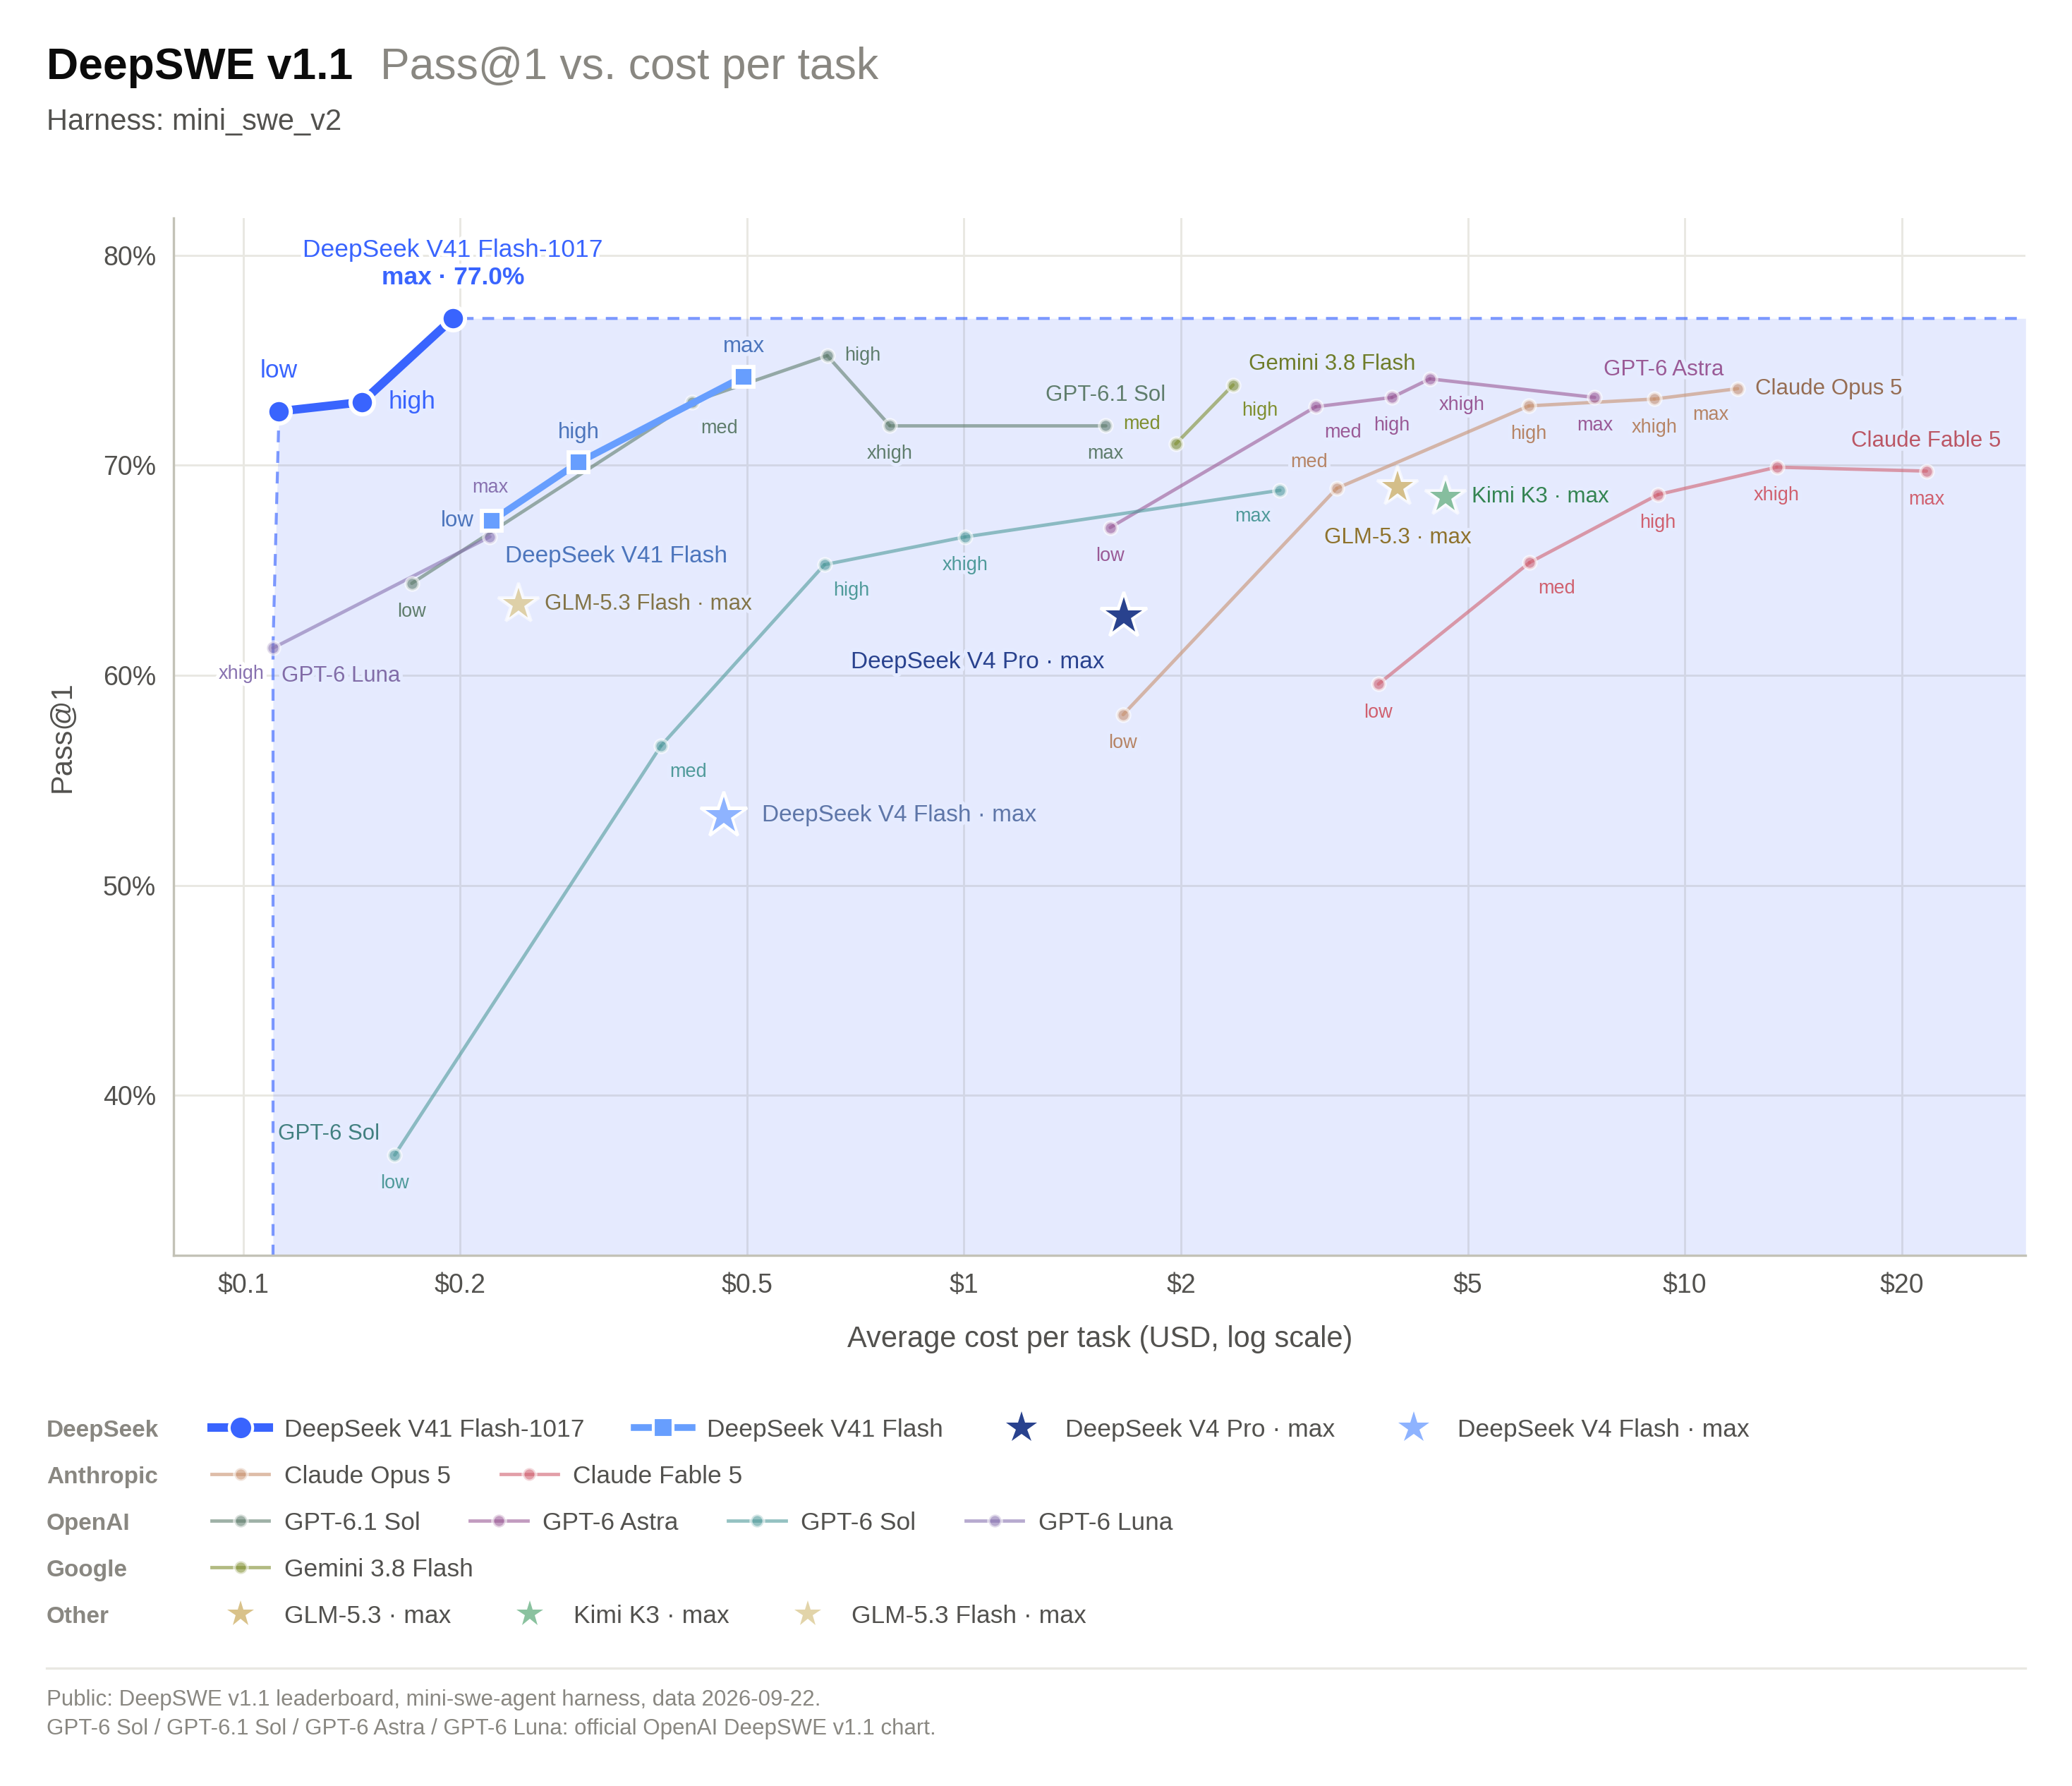
AI 엔지니어의 시선에서 무게가 실리는 쪽은 점수보다 비용 축이다. 딥시크가 함께 낸 도표는 DeepSWE v1.1 통과율을 과제당 평균 비용과 나란히 놓았는데, 1017은 최고 추론 강도에서 77.0%를 과제당 0.2달러 안팎에서 찍었다. 같은 도표에서 클로드 Opus 5와 GPT-6 Astra는 70%대 초반 통과율에 과제당 수 달러에서 10달러 안팎을 썼다. 에이전트가 하루에 수천 번 코드를 고치는 환경이라면 몇 점 차이보다 과제당 단가 차이가 운영비를 좌우한다. 보도에 따르면 추론 강도는 1부터 100까지의 값으로 조절되고, API의 low·high·max 단계가 각각 50·75·100에 대응한다.
검색·페치 API는 딥시크가 만든 하루 수억 건 규모의 자체 검색 엔진 위에서 돈다. 검색은 질의에 대한 순위 결과를, 페치는 웹페이지 한 장을 마크다운으로 돌려준다. 딥시크 하니스와 클로드 코드, Codex의 서버 측 도구로 부르는 호출은 현재 딥시크 API 사용자에게 무료이고, 과금은 10월 31일 16시(UTC)에 시작한다. 모델은 딥시크 하니스 외에 텐센트 코드버디와 워크버디에 맞춰 조정됐으며, 딥시크는 하니스 v0.2.1-rc.1 이상으로 올려 쓰라고 권했다.
딥시크는 1017을 허깅페이스와 모델스코프에 올렸다고 공지했다. 보도에 따르면 딥시크가 신제품을 잇달아 내면서 중국 오픈 웨이트 모델과 미국 폐쇄형 모델의 경쟁이 거세지고 있다. 이번 체크포인트는 같은 크기의 모델을 사후 학습만으로 끌어올려 코딩 에이전트 점수는 올리고 단가는 낮게 묶었다. 검색까지 한 API 키 뒤에 붙인 것은, 딥시크가 모델 판매를 넘어 에이전트가 쓰는 도구 계층까지 직접 쥐려 한다는 신호다.
댓글