


图片:METAL
摘要
- Z.ai 于 10 月 12 日发布以 GLM-5.3-Flash 为基础的法律专用模型 GLM-Legal,并表示其专为合同审查、证据分析和合规调研而设计。
- 其 Harvey LAB 全项通过率为 19.2%,高于 Kimi K3(12.9%)和 Claude Fable 5(11.3%),LegalBench 86.2%、PLawBench 77.3% 的成绩与顶级闭源模型接近。
- 独立评测机构 Vals 将其排在 Harvey LAB 79 个模型中的第 7 位、LegalBench 150 个模型中的第 14 位;该模型正在接受 API 测试申请,并将很快接入 AutoClaw。
中国 AI 实验室 Z.ai 于 10 月 12 日发布了针对法律工作训练的法律专用模型 GLM-Legal。它以轻量级基础模型 GLM-5.3-Flash 为底座,Z.ai 表示该模型专为合同审查、证据分析、合规调研等真实法律工作而设计。在法律智能体基准 Harvey LAB 上,一次性通过全部评分标准的任务比例为 19.2%,比基础模型高出 12.5 个百分点。该公司称,它在法律推理基准 LegalBench 和中国法律实务基准 PLawBench 上的成绩也与顶级闭源模型相当。
Z.ai 在技术博客中首先解释了选择法律实务的原因。该公司写道:"法律实务要求事实、法律教义、分析推理与可交付客户的成果之间形成不间断的链条。"也就是说,模型必须同时从原始文件中提炼核心争点、构建站得住脚的论证,并严格遵守任务要求的格式。该公司表示,同时满足所有这些条件才是领域专用模型真正的试金石。
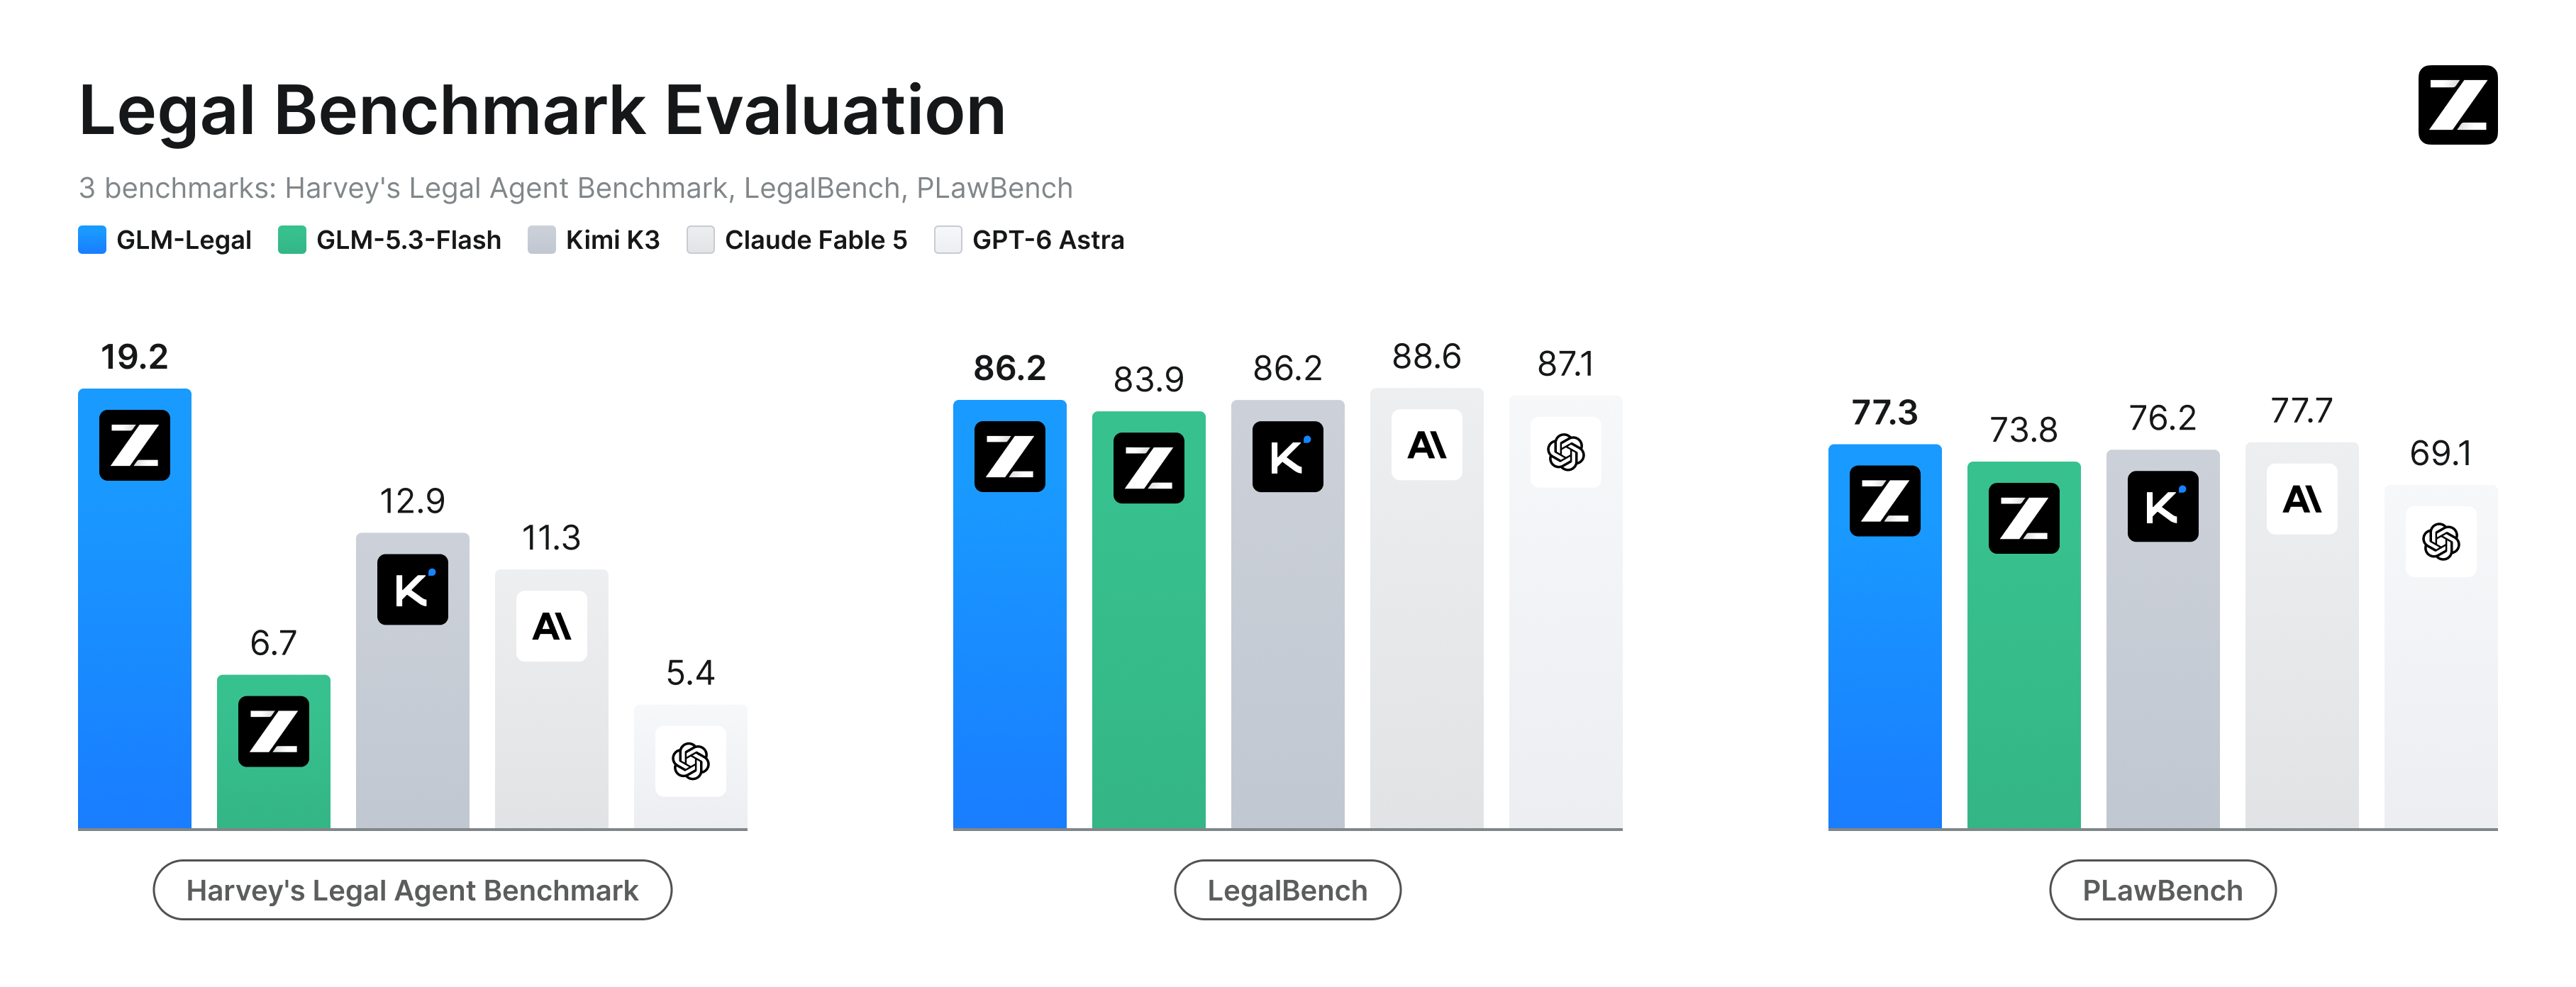
差距最大的是 Harvey LAB。该基准以 24 个执业领域的律所工作为任务,只要漏掉任何一项评分标准,该任务即判为失败。在 Z.ai 公布的图表中,GLM-Legal 得分 19.2%,Kimi K3 为 12.9%,Claude Fable 5 为 11.3%,GLM-5.3-Flash 为 6.7%,GPT-6 Astra 为 5.4%。在 LegalBench 上,GLM-Legal 与 Kimi K3 同为 86.2%,Claude Fable 5 以 88.6%、GPT-6 Astra 以 87.1% 领先。在 PLawBench 上,GLM-Legal 的 77.3% 比 Claude Fable 5 的 77.7% 低 0.4 个百分点,高于 GPT-6 Astra 的 69.1%。
这些数字并不只依赖公司自测。据 Z.ai 介绍,Harvey LAB 和 LegalBench 的结果由 AI 评测机构 Vals 独立评估。METAL 查阅的 Vals 评测页面将 GLM-Legal 列为 Harvey LAB 79 个模型中的第 7 位(19.17%),并注明其在前 10 名模型中单次测试成本最低。在 LegalBench 上它排在 150 个模型中的第 14 位(86.24%),是 GLM 系列在该基准上的最好成绩;在法律检索基准 Legal Research Bench 上排在 78 个模型中的第 24 位(41.83%)。这也意味着,在 Harvey LAB 上,除公司图表中的四个对比对象之外,还有六个模型排在它前面。
训练分为两个阶段。在中期训练中,Z.ai 扩充了高质量法律语料,让模型学习法律概念、法条和解释框架。在后训练中,它在数万个贴近真实的法律工作环境中进行强化学习,教模型规划分析、推进流程并产出成果。Z.ai 表示,它将模型与负责管理任务上下文、连接工具和传递执行反馈的运行框架 harness 一起迭代改进。训练中暴露的边缘案例指出 harness 的瓶颈,改进后的 harness 又反过来让模型学习真实工作的约束。
实务反馈被转化为损失信号。该公司列出了四项审查标准:是否涵盖所有关键争点和边缘情形,论证是否充分、引用在法律上是否站得住,成果是否严格遵循案件指示,下游团队能否无需返工直接使用。该公司表示,当出现事实遗漏、分析浅薄或格式偏差时,会检查整个流程,区分问题出在模型本身的能力、上下文编排还是工作流逻辑。
博客中的三个演示将该模型与基础模型并列对比。在为更换供应商的客户审查软件服务合同时,GLM-5.3-Flash 只建议缩短通知期,而 GLM-Legal 写道应将任意解约通知期从 60 天缩短至 30 天,并对知识产权、保密和数据安全违约取消 30 天的补救期,使客户可以立即解约。它还加入了最长 90 天的交接协助条款。在分析 40 份文件的纠纷演示中,它把 9 月 30 日报告中的"60% 完成"标注,与内部记录显示的约 41% 进度以及首席执行官要求掩盖风险并继续开票的指示联系起来。在新加坡、马来西亚、印度尼西亚同步上线的演示中,它生成了附有各国个人信息保护法条款的上线前检查清单。
从科技律师的视角看,比数字本身更重要的是 19.2% 通过率的另一面。即便是领先的模型,每五项任务中也约有四项至少漏掉一项评分标准。Z.ai 自己也在证据分析演示中留下一句话,建议在得出最终结论前先统一进度口径并检验其余请求要件,并强调该模型会区分事实与推论。法律成果的责任始终在签字的人身上。相对基础模型近三倍的通过率提升改变了起草的起点,但并不构成削减审查环节的理由。
METAL 曾报道匿名模型 Ox Alpha 的真实身份是 GLM-5.3-Flash,也报道过OpenAI 公布法律 AI 公司 Harvey 采用 GPT-6 Astra 的案例。此次发布展示了这一轻量级基础模型在法律这一细分领域与大型闭源模型正面竞争。Z.ai 在 X 帖子中表示:"GLM-Legal 在主流法律基准上与前沿模型相当。"截至收集时,该帖子浏览量为 36.74 万次。
GLM-Legal 仍处于测试阶段。Z.ai 正面向律所、法律科技公司、企业法务团队和独立执业者接受 API 访问申请,并表示该模型很快将在其桌面智能体平台 AutoClaw 中上线。已预告的一项功能可将合同修改意见以修订痕迹和批注形式直接写入 Word 文档。该公司未公布上线时间和支持的语言范围。比专用模型追上通用模型分数的速度更关键的下一个问题是,实务界愿意在多大程度上信任并签署这些成果。
评论