


摘要
- Meta于10月12日发布Muse Wonder与Muse Wonder Full。Muse Wonder通过Meta Model API和Muse Code提供,Muse Wonder Full仅向Muse Code订阅用户开放。
- 在Meta的基准测试表中,Muse Wonder Full以个人超级智能指数59.1分、Harvey LAB-AA 13.1分位列第一,但Artificial Analysis指数为56分,落后于Claude Opus 5.5的58分。
- Meta主打可跨对话记忆的Active Memory,Muse Wonder在MemoryBench上以85.6分居首。该模型即将接入个人智能体Muse,并率先面向订阅用户推出。
Meta于10月12日发布了其首批前沿模型Muse Wonder与Muse Wonder Full。Meta在公告中称,这两款模型是其迄今发布的能力最强的模型,在代替用户处理个人与专业工作的智能体任务上达到业界最高水平。Muse Wonder自发布当天起即可通过Meta Model API和编程工具Muse Code使用,Muse Wonder Full则仅向Muse Code订阅用户开放。两款模型的上下文窗口均为100万token。
此次发布是Meta AI组织改革的第一份成绩单。Meta表示,公司14个月前开始全面改造AI业务,如今已从重建基础迈向推动前沿。据报道,这是Scale AI创始人Alexandr Wang去年8月重组Meta AI组织后推出的首批前沿级模型,在此期间Meta只发布了轻量模型Muse Spark和个人智能体Muse。Meta在研究博客中写道:"两款模型标志着我们扩展阶梯的下一步,也是迈向个人超级智能的一大飞跃。"据报道,训练以吉瓦级规模在今年投入运行的俄亥俄州中部Prometheus数据中心完成。
Meta瞄准的不只是编程。公告以处理保险理赔、理解租赁合同、梳理个人财务等工作为例,表示两款模型兼顾法律、金融、医疗等专业领域与前沿级编程。Meta开发者页面介绍,Muse Wonder能够规划长任务,把部分工作分派给子智能体,并行调用工具,并能自行从错误中恢复,不间断地完成持续数小时的多步骤工作。模型还具备计算机操作能力,可以识别并直接操作浏览器、桌面和移动应用界面。据报道,两款模型均可接收文本、图像、视频和音频输入。
METAL核实的Meta开发者页面基准测试表,将两款模型与Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5在14个项目上并列比较。表中分数为Meta公布的数值。在汇总个人与知识工作的Meta内部指标个人超级智能指数上,Muse Wonder Full得分59.1,领先Claude Opus 5.5(55.2)、GPT-6 Astra(54.5)和Claude Fable 5.1(49.9)。在法律智能体任务Harvey LAB-AA上,它以13.1分位居所有对比模型之首,Claude Opus 5.5为4.2分。在金融分析任务Vals Finance Agent V2上得分59.1,在业务自动化任务AutomationBench-AA上得分45.4,同样排名第一。
它并没有赢下所有项目。在同一张表中,Claude Opus 5.5在医疗问答HealthBench Pro(65.6)、专业工具使用JobBench(75.4)、终端编程Terminal-Bench 4.0-AA(59.6)以及从零编写程序的ProgramBench(70.5)上得分最高,在外部机构指标Artificial Analysis指数上也以58分高于Muse Wonder Full的56分。在编程方面,Meta强调的是长周期任务。Muse Wonder Full在长周期编程任务DeepSWE 1.1上得分79.0,在超长周期工程任务SWE-Marathon上得分57.5,均超过所有对比模型,Meta表示这一结果也在独立第三方测试中得到确认。
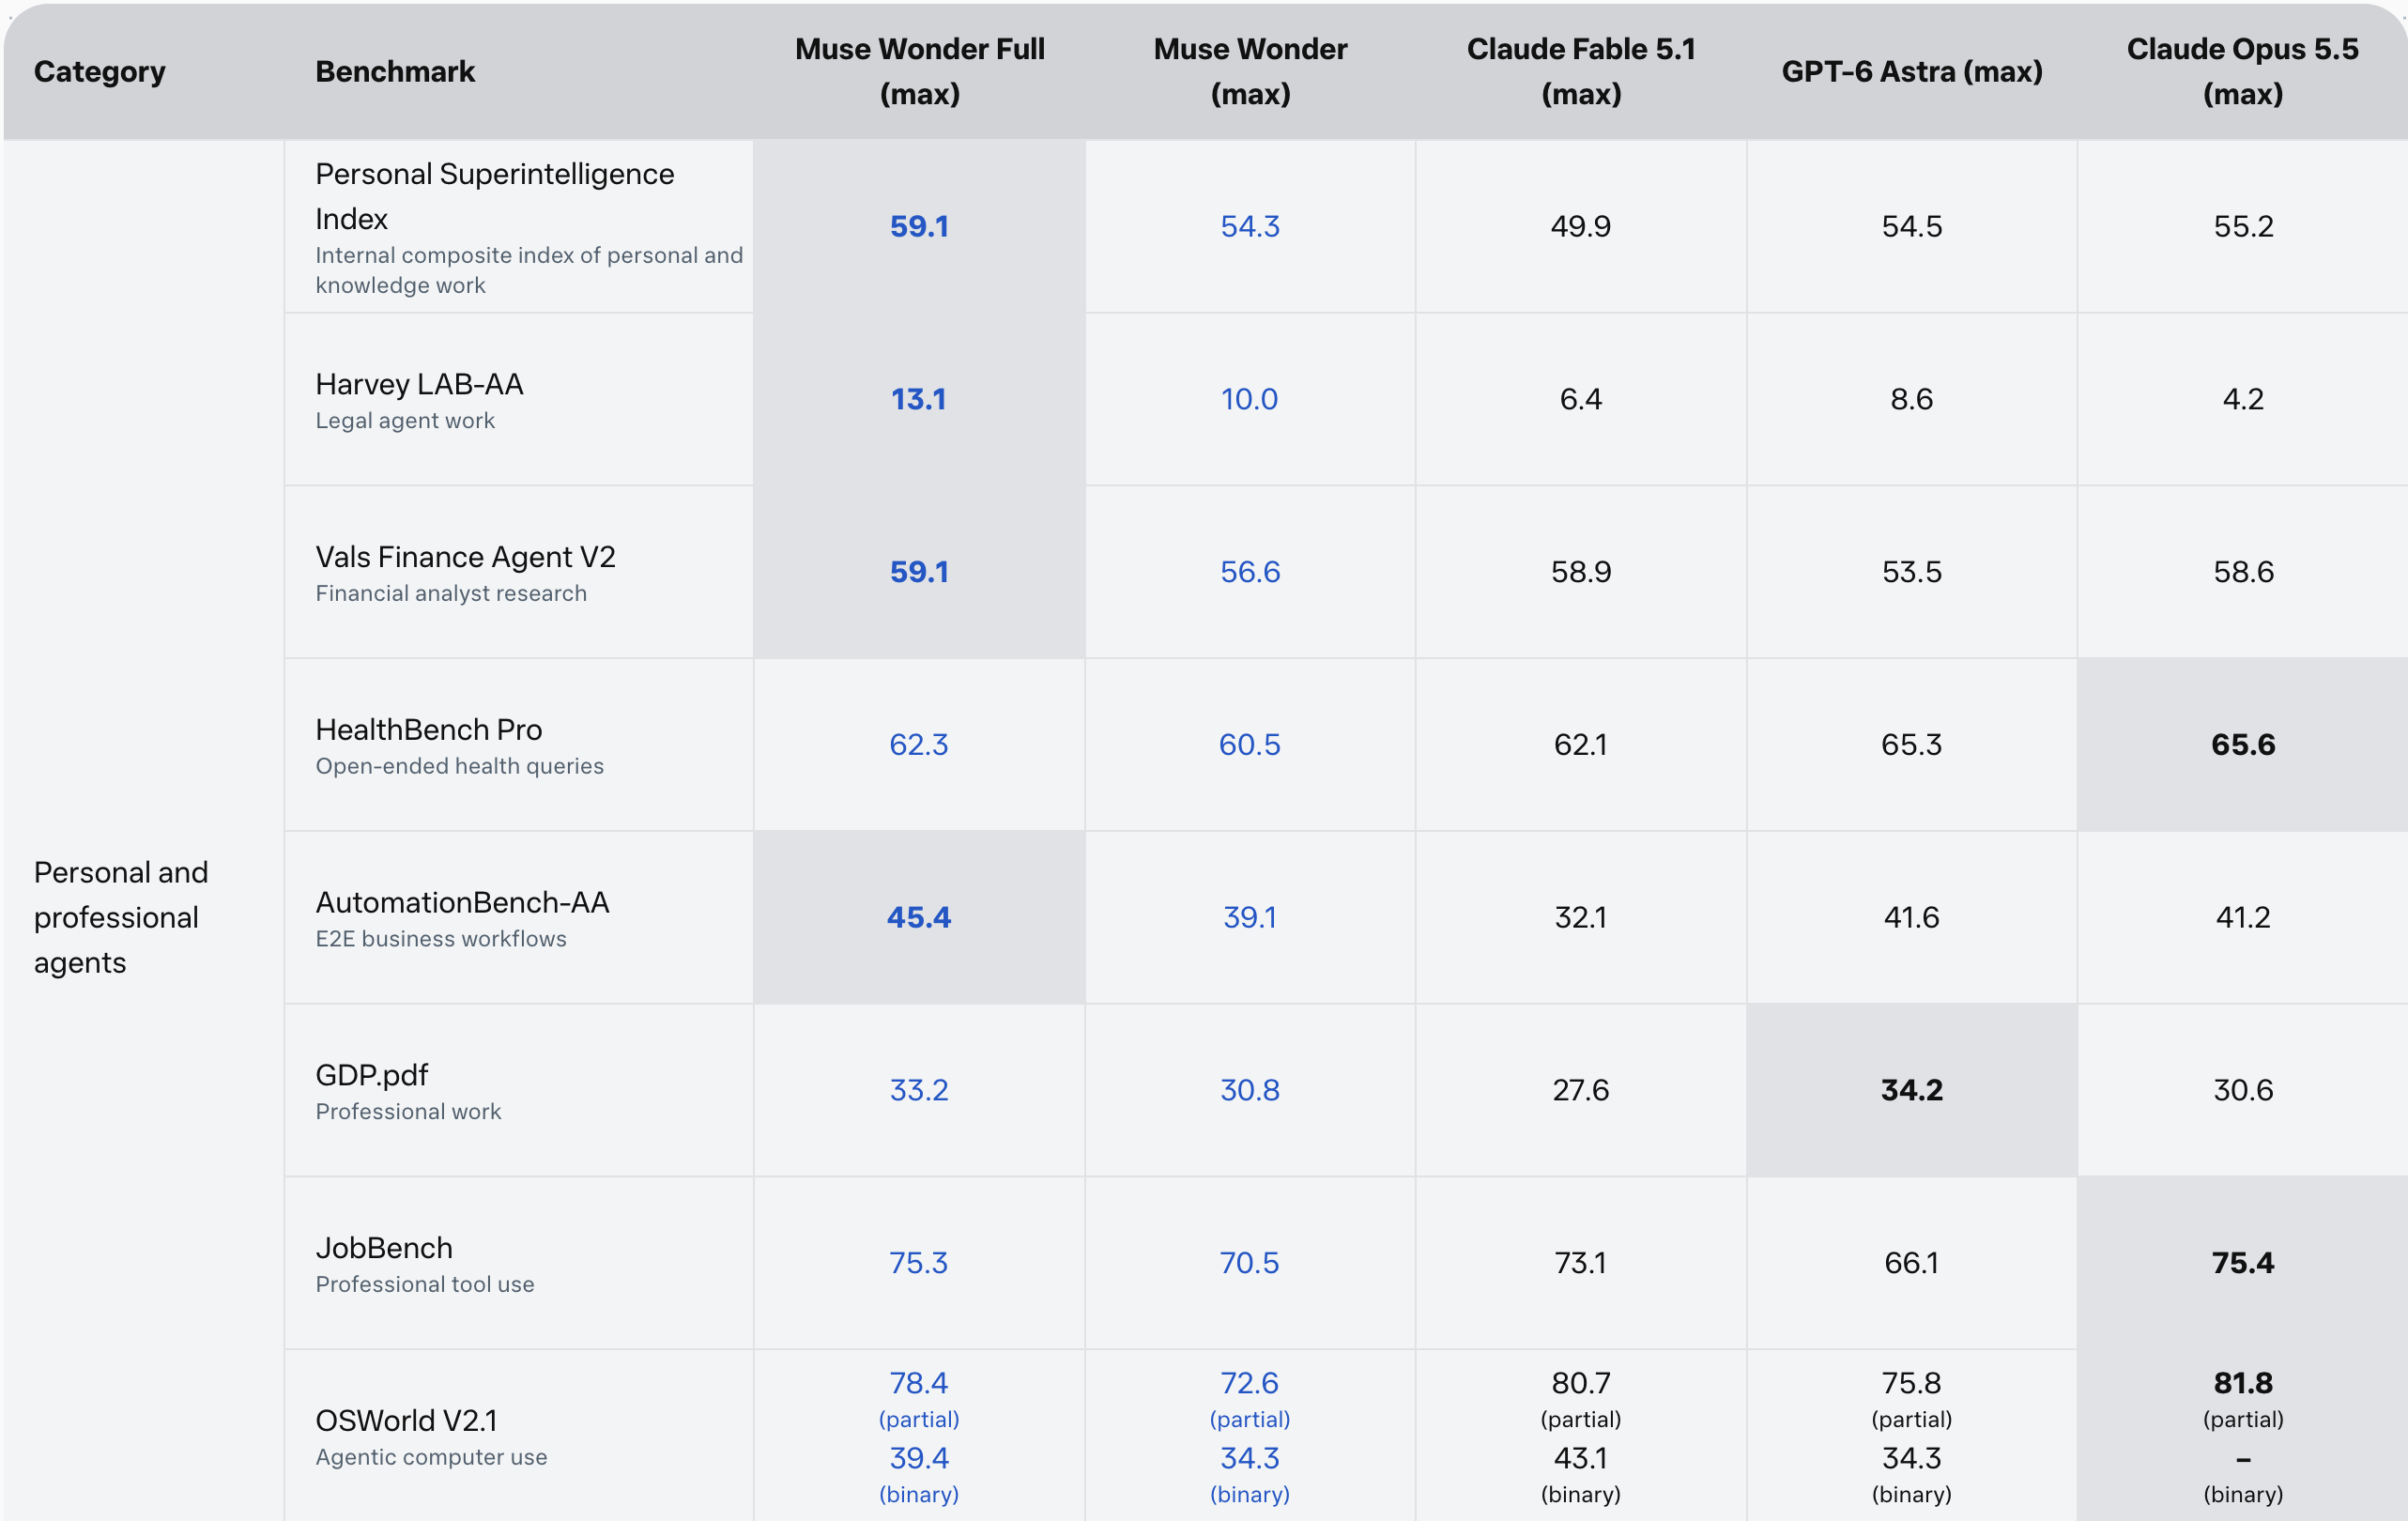
记忆力是Meta投入最多的部分。Meta把跨对话记住对用户重要的信息并在需要时调取的能力称为Active Memory,把任务受阻时尝试其他方法、从错误中恢复、在执行重要事项前征求确认的能力称为Active Focus。在衡量上下文记忆的MemoryBench上,Muse Wonder以85.6分在表中五款模型里最高。Meta研究科学家Kavya Kopparapu在发布视频中说:"我们投入了巨大的努力,确保模型能够在数天、数周、数月乃至更长时间里记住对你重要的事情。"
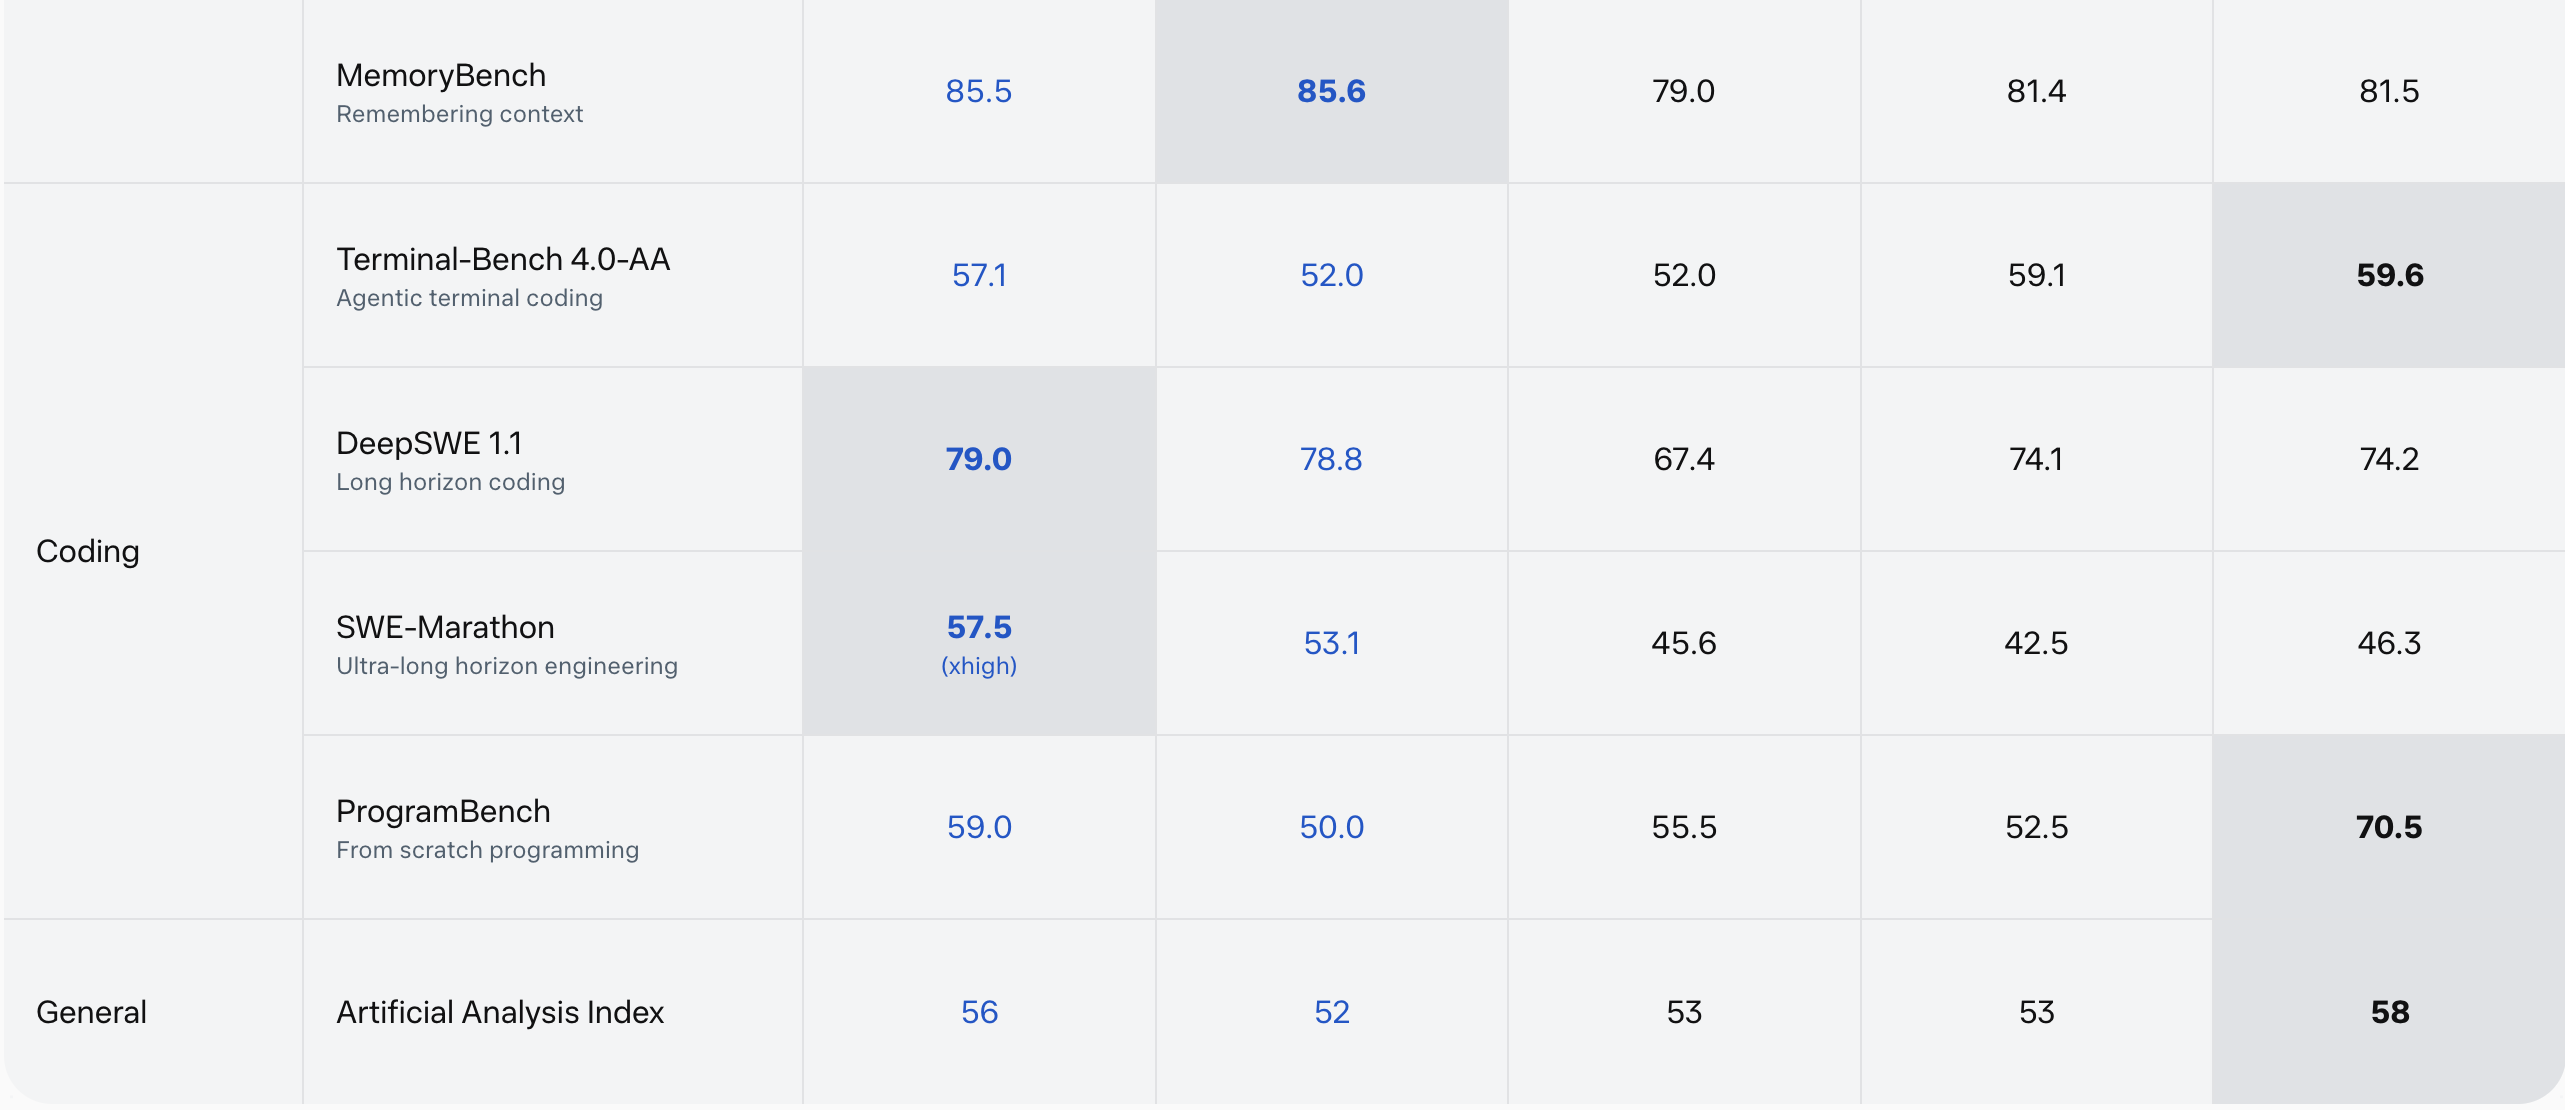
外部测评也呈现类似图景。据报道,在Artificial Analysis智能指数上,Muse Wonder Full得分56,Muse Wonder得分52,较前代Muse Spark 1.3的48分大幅提升,Terminal-Bench 4.0成绩从33%跃升至57%。在非公开的数学证明基准ProofBench上,它解出了100道题中的94道,远超前代的58道。事实性知识被视为短板。在知识测试AA-Omniscience上,Muse Wonder Full得分30,低于Claude Opus 5.5的46分、GPT-6 Astra的43分和Gemini 4 Argon的42分。不过其幻觉率从前代的33%降至23%。METAL曾报道Meta发布Muse Spark 1.3并主打编程基准成绩,此次相当于在该轻量模型之上加了一层大模型。
安全措施也一并推出。Meta表示,由于个人智能体需要在消息、日程和文档之间工作,公司训练两款模型在未经许可时不分享隐私信息,并拒绝协助实施真正有害行为的请求。安全团队查找自身代码缺陷的工作则不受影响。Meta补充称,其最强模型均按照Meta超级智能扩展框架的标准进行训练、评估和发布,包含更多安全评估的完整报告将很快公布。
下一个舞台是个人智能体Muse。Meta表示,Muse Wonder将很快驱动Muse的更多功能,并率先面向订阅用户推出。METAL曾报道Meta推出运行在安全虚拟机上的个人智能体Muse。Meta称此次发布是"迈向人人可享的个人超级智能的一大步"。表中大部分数字来自Meta自测,完整的安全报告也尚未发布。一个能把用户的消息和日程记住数月的模型,究竟能在多大程度上改变Muse的实际使用体验,将是检验这些数字的第一道考题。
信息来源
- Meta — Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents →
- Meta — Muse Wonder | Meta for Developers →
- TechCrunch — Meta releases its first frontier model, Muse Wonder →
- The Decoder — Meta's new frontier model Muse Wonder Full breaks into the AI top tier →
- X — We're excited to introduce the Muse Wonder series (@AIatMeta) →
评论