


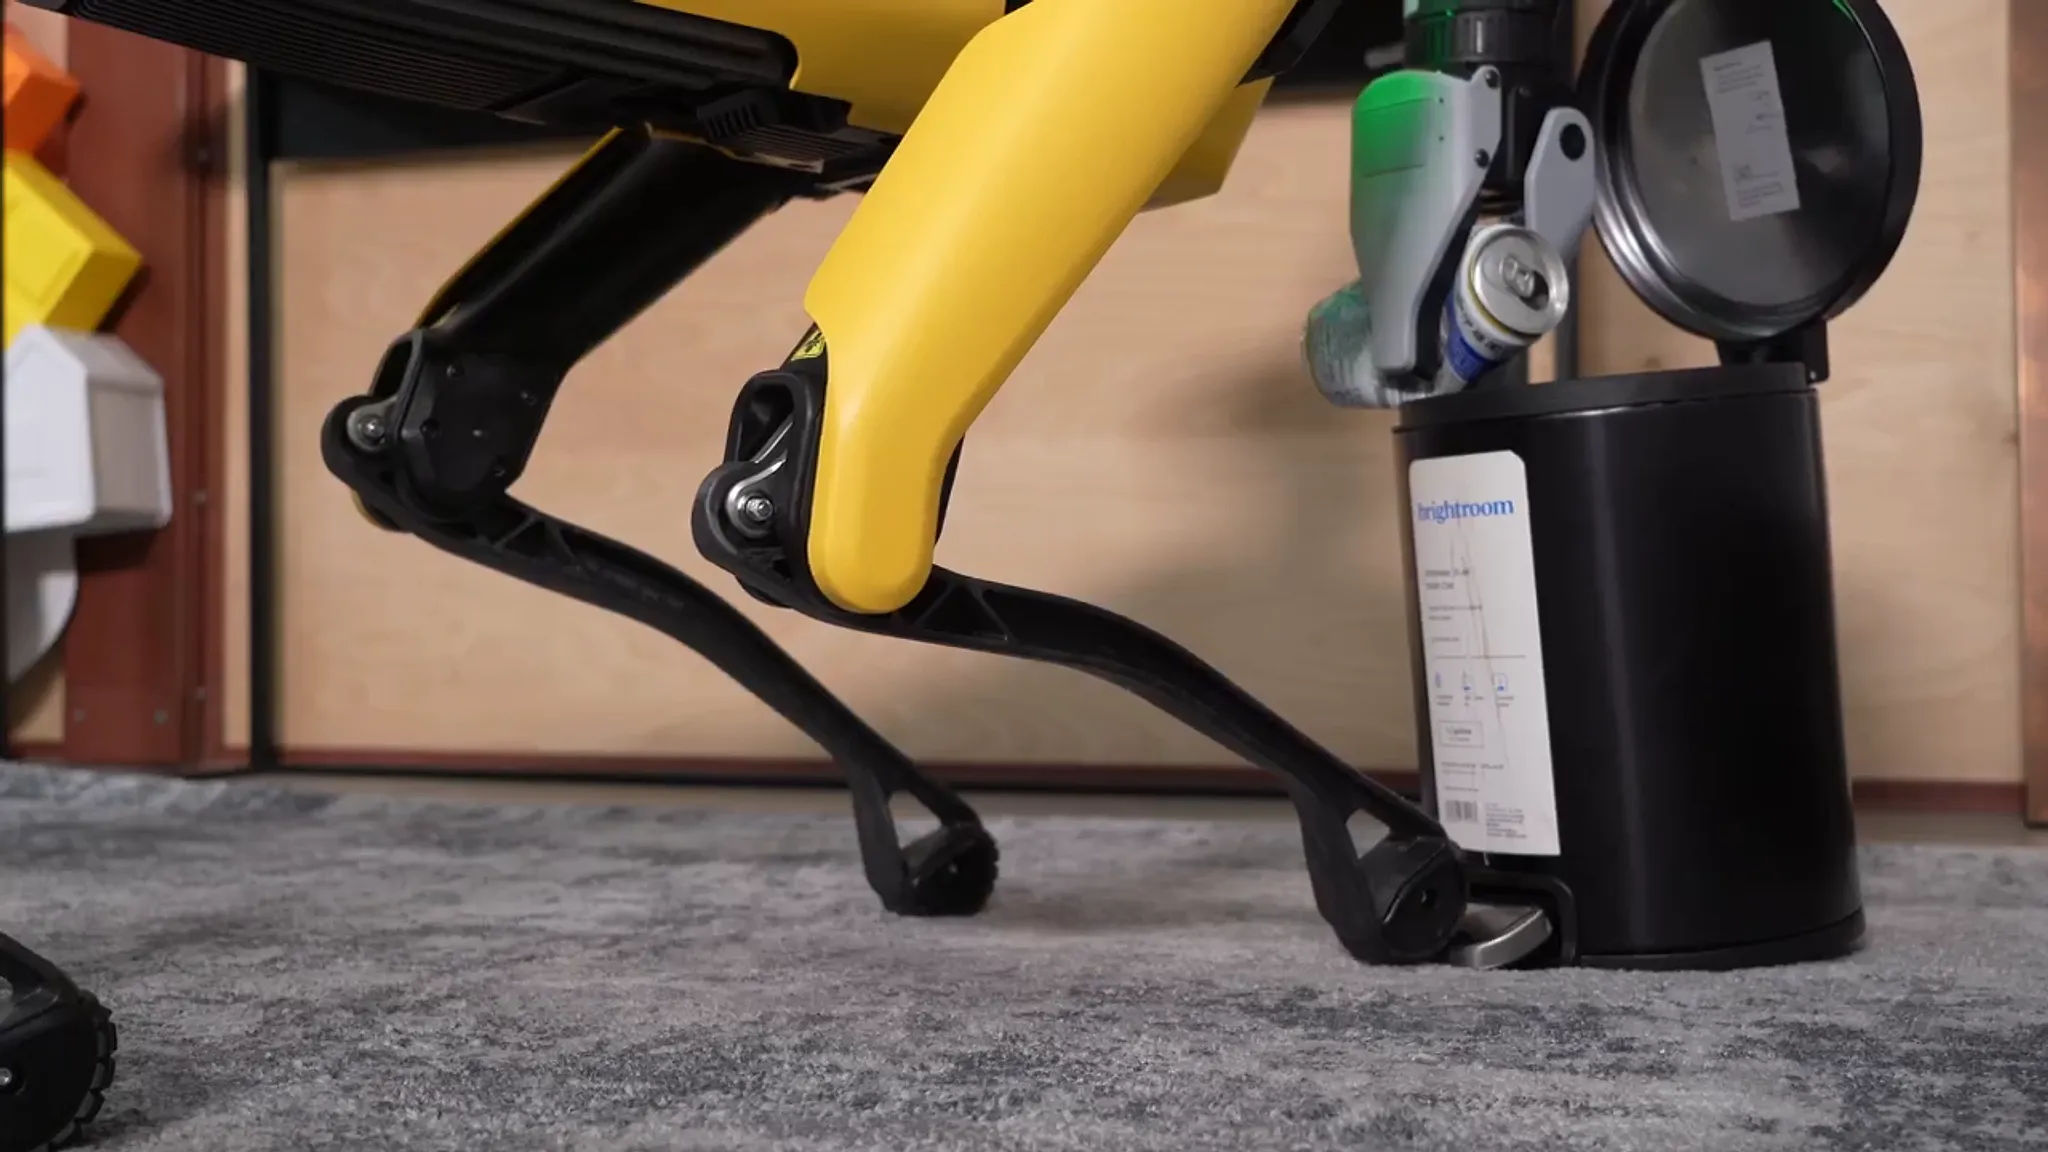
이미지: 영상 갈무리
요약
- 구글 딥마인드는 10월 13일 Gemini 4 Argon을 로봇 제어·Real2Sim·물리 이해·연구와 자기 개선 네 영역에 쓰는 사례를 공개했다.
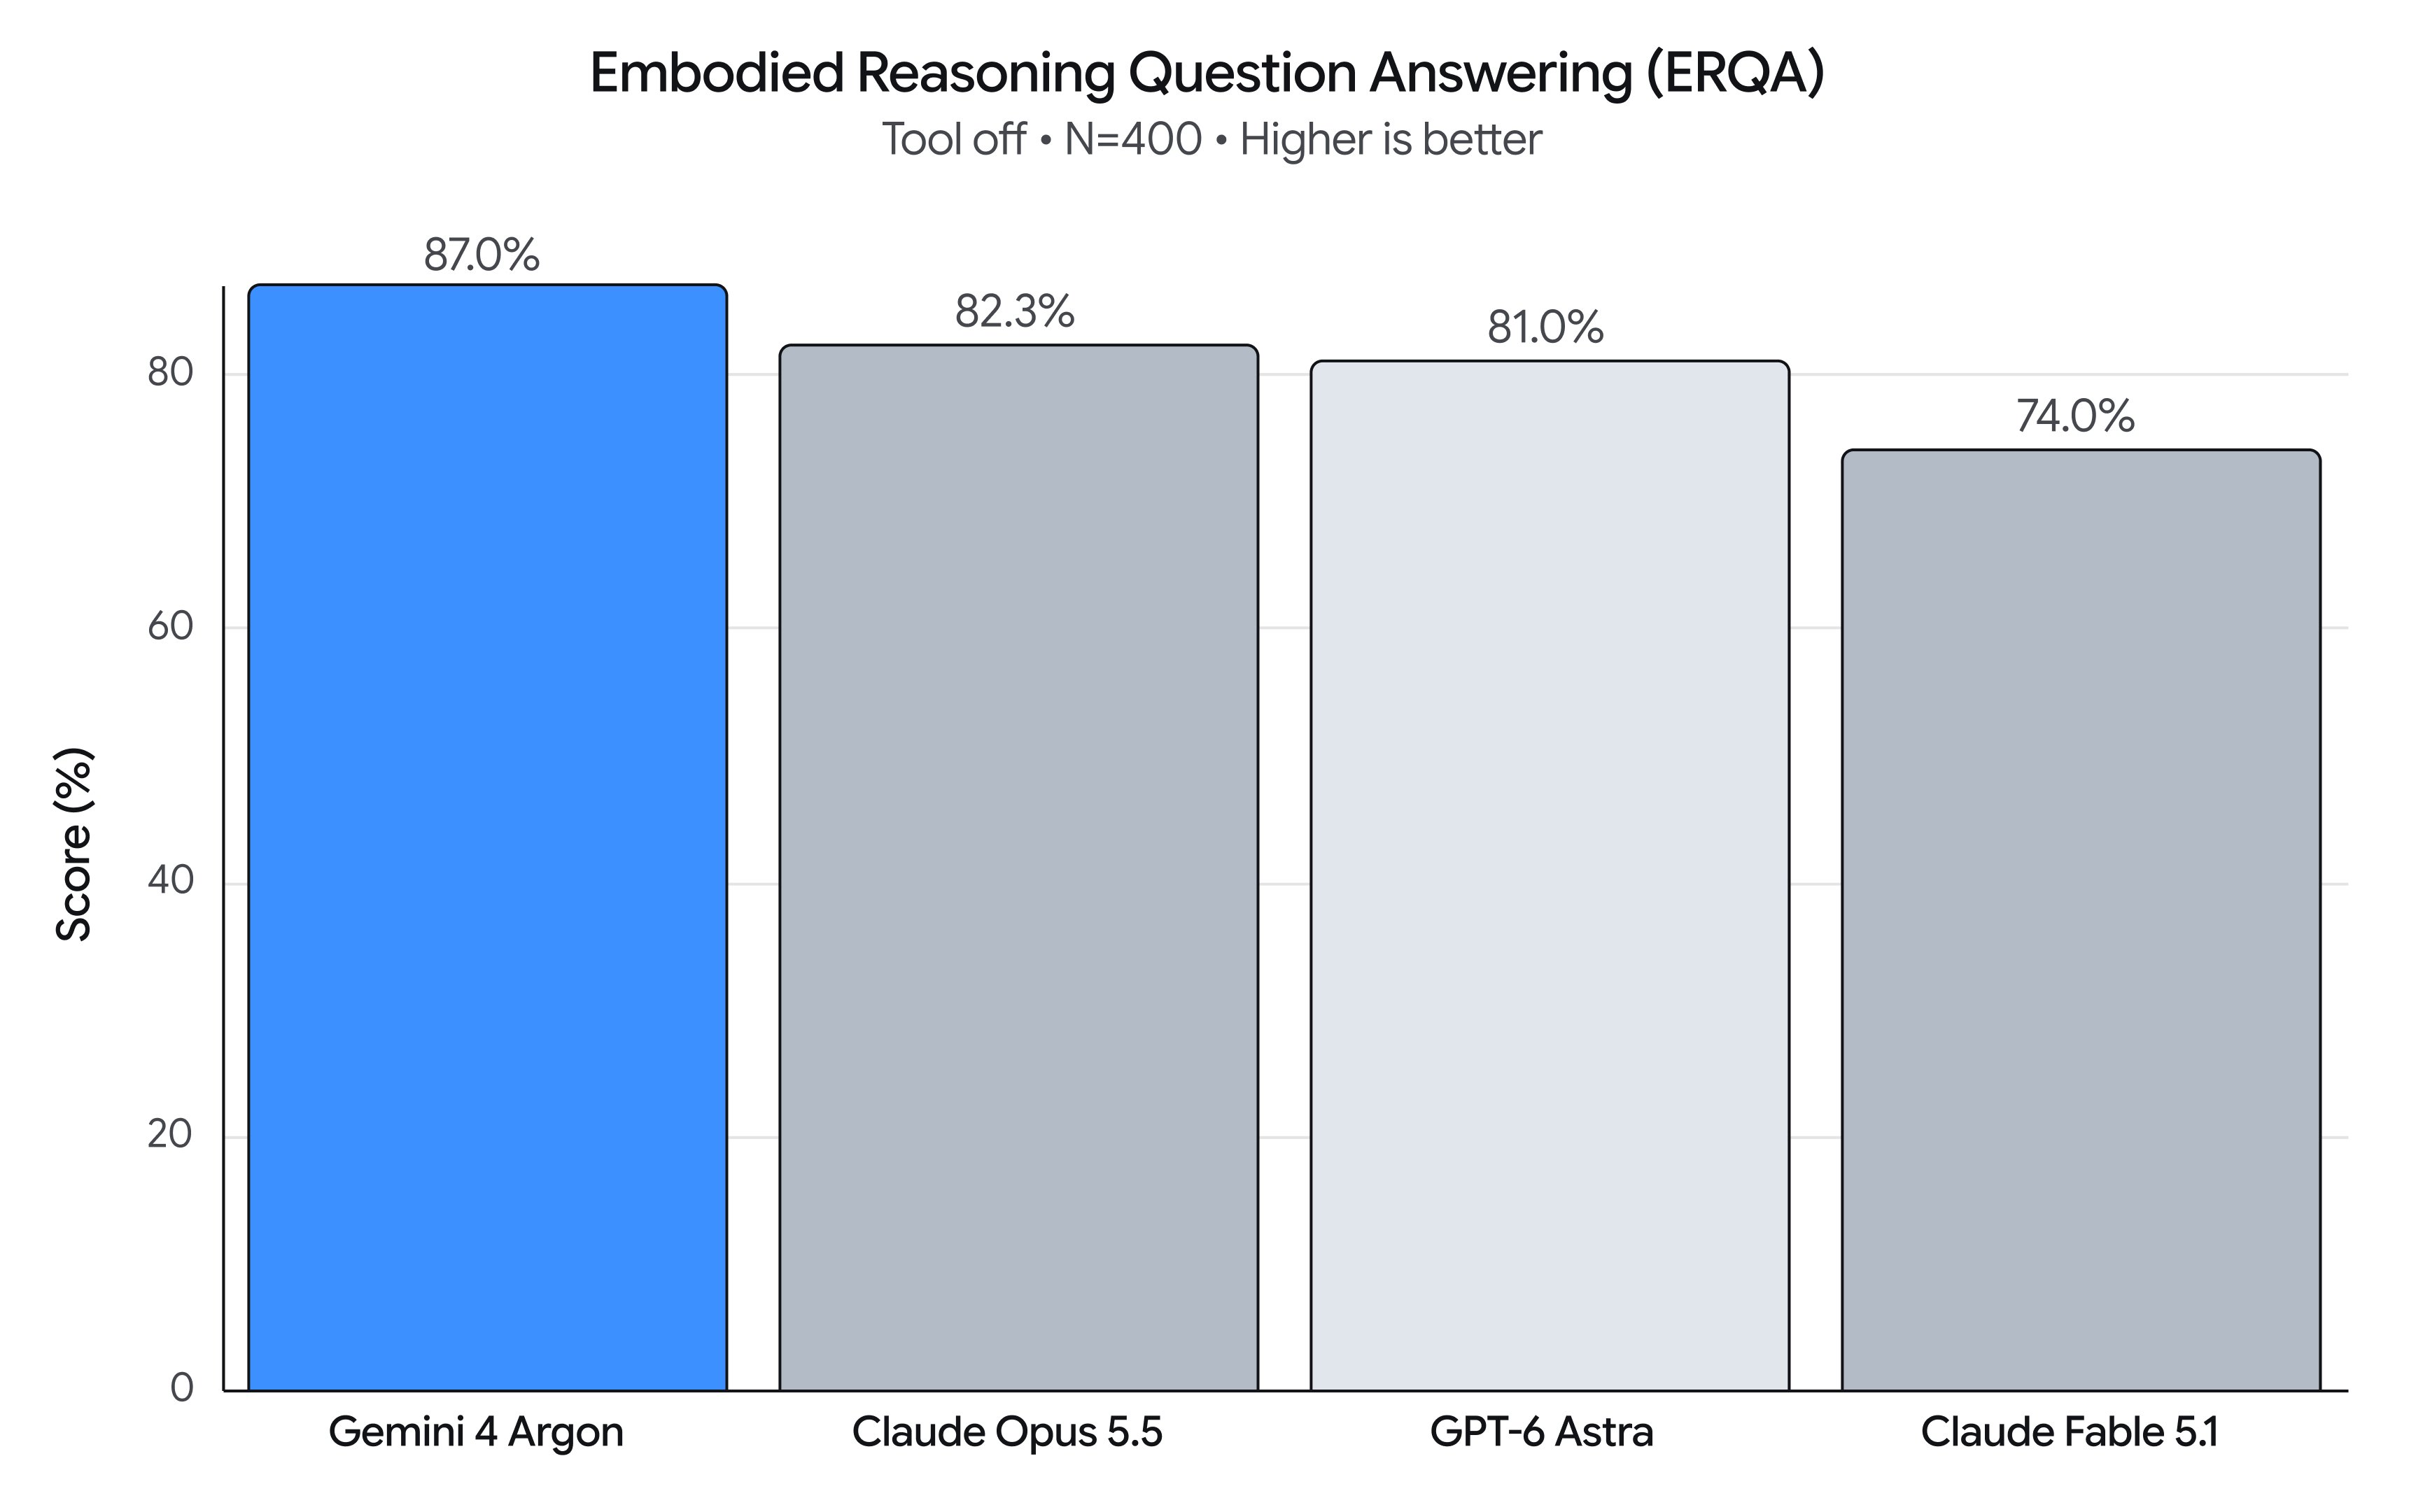
- Argon은 ERQA에서 도구 없이 87.0%를 기록해 Claude Opus 5.5(82.3%)·GPT-6 Astra(81.0%)를 앞섰고, Spot이 MuJoCo에서 먼저 연습한 뒤 페달식 휴지통에 캔을 버렸다.
- 사진 한 장으로 만든 시뮬레이션에서 4500개 넘는 에피소드를 생성해 실제 로봇 성공률을 56%에서 75%로 올렸으며, 모델은 AI Studio·Gemini API 유료 등급·Antigravity에서 쓸 수 있다.
- 공개
- 2026년 10월 13일 · 구글 딥마인드 블로그 → 구글 개발자 블로그 · 카니슈카 라오 수석 소프트웨어 엔지니어
- 네 영역
- 로봇 제어 · Real2Sim · 물리 이해 · 연구와 자기 개선
- ERQA
- 도구 끔·400문항 · Gemini 4 Argon 87.0% · Claude Opus 5.5 82.3% · GPT-6 Astra 81.0% · Claude Fable 5.1 74.0%
- Spot
- 다리 12자유도+팔 6자유도 · MuJoCo 디지털 트윈 연습 · 페달식 휴지통 캔 버리기 · 검증 에이전트 2개
- 제로샷 제어
- 로봇 팔로 머그잔 세우고 냅킨 넣기 · 2cm 좌표 격자
- Gemini Omni
- 스크래블 타일 5개 A-R-G-O-N 정렬 · 33단계 조종
- Real2Sim 제약
- 팔 관절 0.55라디안 · 손 관절 0.65라디안 이내 · 외력·충돌 해제 금지
- 사람 영상→시뮬레이션
- 76자유도 양팔 휴머노이드 · 손 22자유도 · 500Hz
- 스케치→시뮬레이션
- Apollo 2 공 던지기 · 상자 6개 전부 쓰러뜨림 · 140단계 2.80초 · 골반 흔들림 3cm 미만
- 사후 라벨링
- ALOHA 2 종이접기 136초 · 세부 과제 6개 · 기본 동작 17개 · 실수 구간 0.15~0.25배
- 가치 함수
- 60초 고리 분류 영상 · 28개 구간
- 당구공 퍼즐
- Franka FR3 두 대 · 공 12개 · 3번 계량
- 시뮬레이션 데이터
- 소품 9개 · 과제 77개 · 에피소드 4500개 이상 · 성공률 56%→75% · 완료 시간 35초→24초
- SO-101 자기 개선
- 58.9초 → 22.9초 → 17.4초
- 논문 재현
- 브라우저 MuJoCo 실험실 68개
- 제공
- AI Studio(구글 AI 울트라) · Gemini API 유료 등급 gemini-4-argon · Antigravity
구글 딥마인드가 10월 13일 프런티어 모델 Gemini 4 Argon을 로봇 개발 전 과정에 쓰는 활용 사례를 공개했다. 구글 개발자 블로그에 실린 글은 로봇 제어, 실제 장면을 시뮬레이션으로 옮기는 Real2Sim, 물리 이해, 연구와 자기 개선의 네 갈래로 프롬프트와 결과 영상을 묶었다. 3D 환경의 물리·공간 문제 풀이를 재는 체화 추론 벤치마크 ERQA에서 Argon은 도구 없이 순수 추론만으로 87%를 기록했고, 구글은 이 점수가 다른 모든 프런티어 모델을 앞선다고 밝혔다.
글을 쓴 카니슈카 라오 구글 수석 소프트웨어 엔지니어는 "Gemini 4 Argon은 물리 이해와 코드 생성, 시각·의미 추론에서 계단식 도약을 이뤘다"며 "로보틱스 스택 전반에 새 작업 흐름을 열고 물리 AGI를 향한 진전을 앞당긴다"고 밝혔다. 구글이 공개한 ERQA 도표는 400문항을 도구 없이 푼 조건이다. Argon이 87.0%, Claude Opus 5.5가 82.3%, GPT-6 Astra가 81.0%, Claude Fable 5.1이 74.0%였다.
가장 눈에 띄는 사례는 보스턴다이내믹스의 사족보행 로봇 Spot이다. 다리 12자유도와 팔 6자유도를 가진 Spot이 발로 페달을 밟아 여는 휴지통에 음료 캔을 버리는 새 기술을 익히는 과정이다. Argon은 먼저 물리 시뮬레이터 MuJoCo 안에 페달식 휴지통의 관절 구조까지 담은 디지털 트윈을 만들어 세 다리로 균형을 잡는 동작을 연습했고, 그다음 실제 페달을 밟았다. 프롬프트는 페달을 밟기 전 앞 카메라로 오른쪽 앞발이 페달 중앙에 놓였는지 확인하게 했고, 발 검증과 손 검증을 나눠 맡은 에이전트 2개가 캔을 놓기 전 위치를 교차 확인하게 했다. 공개 영상에는 캔이 휴지통 가장자리에 너무 가깝다는 것을 앞 카메라가 잡아내 손을 가운데로 옮기는 장면이 담겼다.
사전 학습 없이 처음 보는 과제를 푸는 제로샷 제어도 시연됐다. Argon은 단순한 로봇 팔로 넘어진 머그잔을 세우고 구겨진 냅킨을 그 안에 넣었다. 손목 카메라 화면에 2cm 간격의 좌표 격자를 겹쳐 놓고, 잡기·놓기·이동 같은 동작 함수를 여러 차례 호출하며 화면을 보고 다음 동작을 고쳤다. 구글의 비디오 월드 모델 Gemini Omni 안에서는 흩어진 스크래블 타일 5개를 A-R-G-O-N 순서로 늘어놓도록 로봇 손을 조종했다. 지시문 하나로 끝내지 않고 중간 결과 장면을 보며 시간표가 붙은 지시문을 다시 써, 33단계에 걸쳐 영상을 이끌었다.
Real2Sim 사례에서 Argon은 실제 로봇 원격 조종 기록을 보고 시뮬레이션 쌍둥이를 만든다. 카메라 3대의 화면과 손끝 촉각 센서 값이 실제 기록과 맞을 때까지 물체의 형상과 질량, 마찰을 반복해 조정한다. 프롬프트는 로봇 명령이 기록된 궤적에서 팔 관절 0.55라디안, 손 관절 0.65라디안 넘게 벗어나지 못하게 했고, 물체에 외력을 가하거나 충돌을 끄는 식의 편법을 금지했다. 사람이 머리에 단 카메라로 찍은 영상을 76자유도 양팔 휴머노이드로 옮기는 사례도 실렸다. 다섯 손가락 손은 각각 22자유도이고 시뮬레이션은 초당 500번 계산된다. 펜으로 그린 스케치 한 장으로는 휴머노이드 Apollo 2가 공을 던져 3-2-1로 쌓은 상자 6개를 넘어뜨리는 장면을 만들었다. Argon은 2.80초 동안 140단계로 이뤄진 전신 투구 궤적을 합성했고, 골반 흔들림을 3cm 안으로 묶은 채 상자 6개를 모두 쓰러뜨렸다고 구글은 밝혔다.
물리 이해 영역에서 Argon은 영상에 사후 라벨을 붙이는 도구로 쓰였다. 양팔 로봇 ALOHA 2가 정사각형 종이로 136초 동안 여우를 접는 영상을 받아 전체 목표 1개, 세부 과제 6개, 접촉 단위 기본 동작 17개로 나눴고, 머뭇거리거나 다시 시도한 구간은 행동 복제 학습 가중치를 0.15~0.25배로 낮추게 표시했다. 사람이 그리퍼를 들고 60초 동안 고리를 분류하는 영상에서는 작업 진척도를 그래프로 그리고 28개 구간으로 나눠 진척·정체·후퇴를 판정했다. 강화학습에서 가치 함수가 맡는 역할이다. 겉모습이 같은 당구공 12개 가운데 무게가 다른 하나를 양팔 저울로 3번 만에 찾는 고전 퍼즐은 Franka FR3 팔 두 대가 들어간 시뮬레이션 환경째로 만들어 카메라 영상만으로 풀었다.
숫자로 성과가 드러난 대목은 연구·자기 개선 영역이다. Argon은 실제 탁자 사진 한 장에서 파티 소품 9개를 재현한 MuJoCo 시뮬레이션을 만들고, 77개 과제 커리큘럼을 정의해 4500개가 넘는 에피소드를 생성했다. 이 데이터로 시각·언어·행동 모델을 미세조정하자 실제 로봇의 성공률은 56%에서 75%로 올랐고, 작업 완료 시간은 35초에서 24초로 줄었다. 6자유도 소형 팔 SO-101은 레고 블록을 집어 나무 상자에 넣는 작업을 스스로 진단하며 되풀이해 1회차 58.9초, 2회차 22.9초, 3회차 17.4초로 줄였다. 2회차에는 상자 모서리를 스쳤고 3회차에는 정중앙에 떨어뜨렸다. 로봇 제어 논문을 프롬프트 한 번으로 브라우저용 MuJoCo 실험실로 재현한 사례는 68개에 이른다.
메탈이 확인한 원문은 사례마다 실제로 쓴 프롬프트 전문을 함께 실었다. 시뮬레이션에서 무엇을 조정해도 되고 무엇은 안 되는지, 실물 하드웨어를 움직이기 전에 어떤 확인을 거쳐야 하는지가 문장으로 적혀 있다. SO-101 사례의 프롬프트는 1단계에서 로봇을 움직이지 말고 계획표만 출력하라고 지시했고, 2단계에서 손목 카메라로 위치를 검증한 뒤 3단계에서야 안전 규칙 안에서 직접 실행하게 했다.
메탈은 구글 딥마인드가 9월 30일 Gemini 4 Argon을 공개하고 사이버 방어자에게 먼저 배포했다고 보도한 바 있으며, 휴머노이드 Apollo가 부엌일을 가장 어려워했다는 딥마인드 영상도 전했다. 2주 전 공개가 코딩과 보안 성능에 초점을 맞췄다면, 이번 글은 같은 모델을 로봇 개발 도구로 내세웠다.
언론인의 눈으로 보면 이번 발표에서 읽어야 할 것은 87%라는 점수보다 발표의 형식이다. 구글은 로봇 전용 모델을 따로 내놓는 대신, 범용 모델이 시뮬레이터를 짜고 학습 데이터를 만들고 실물 로봇을 조종하는 장면을 프롬프트째 공개했다. 로봇 개발의 병목으로 꼽혀 온 데이터 수집과 시뮬레이션 구축을 언어 모델의 코딩 능력으로 메우겠다는 주장이다. 공개된 결과는 모두 구글이 고른 시연이고, 성공률 75%는 넷 가운데 한 번은 여전히 실패한다는 뜻이기도 하다.
Gemini 4 Argon은 구글 AI 울트라 구독자에게 AI Studio와 에이전트 개발 환경 Antigravity에서 제공되고, Gemini API 유료 등급에서는 gemini-4-argon이라는 이름으로 Interactions API에서 쓸 수 있다. 라오 엔지니어는 "이 핵심 지능을 만들어 사람과 함께 일하며 복잡한 문제를 푸는 로보틱스를 가능하게 하는 것이 우리의 목표"라고 밝혔다. 로봇이 시뮬레이션에서 먼저 연습하고 스스로 실수를 고치는 이번 활용 사례가 연구실 시연을 넘어 현장의 기본 절차가 될지가 다음 질문이다.
댓글