


摘要
- Google DeepMind 于 10 月 13 日公开了将 Gemini 4 Argon 用于机器人控制、Real2Sim、物理理解以及研究与自我改进四个领域的案例。
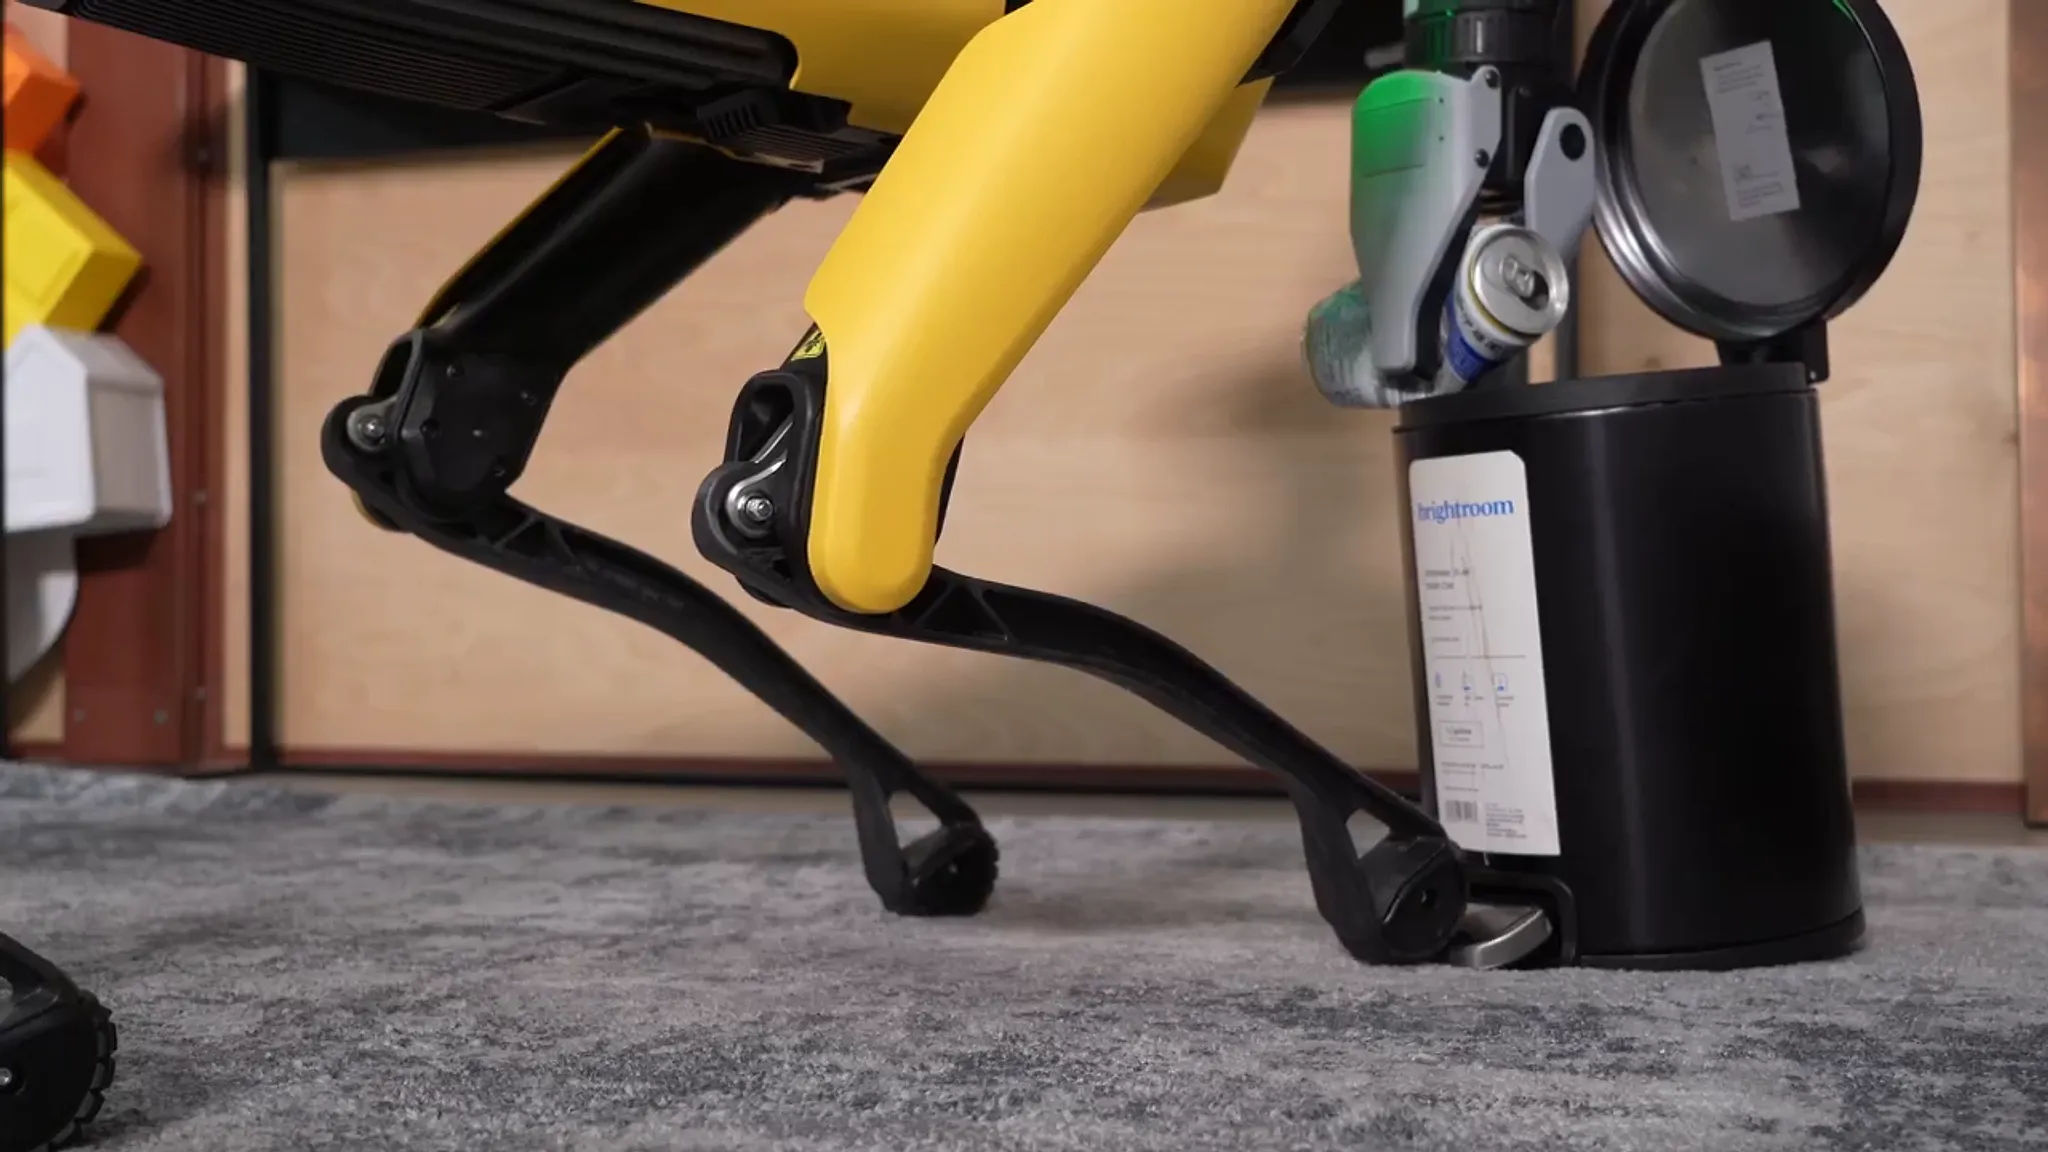
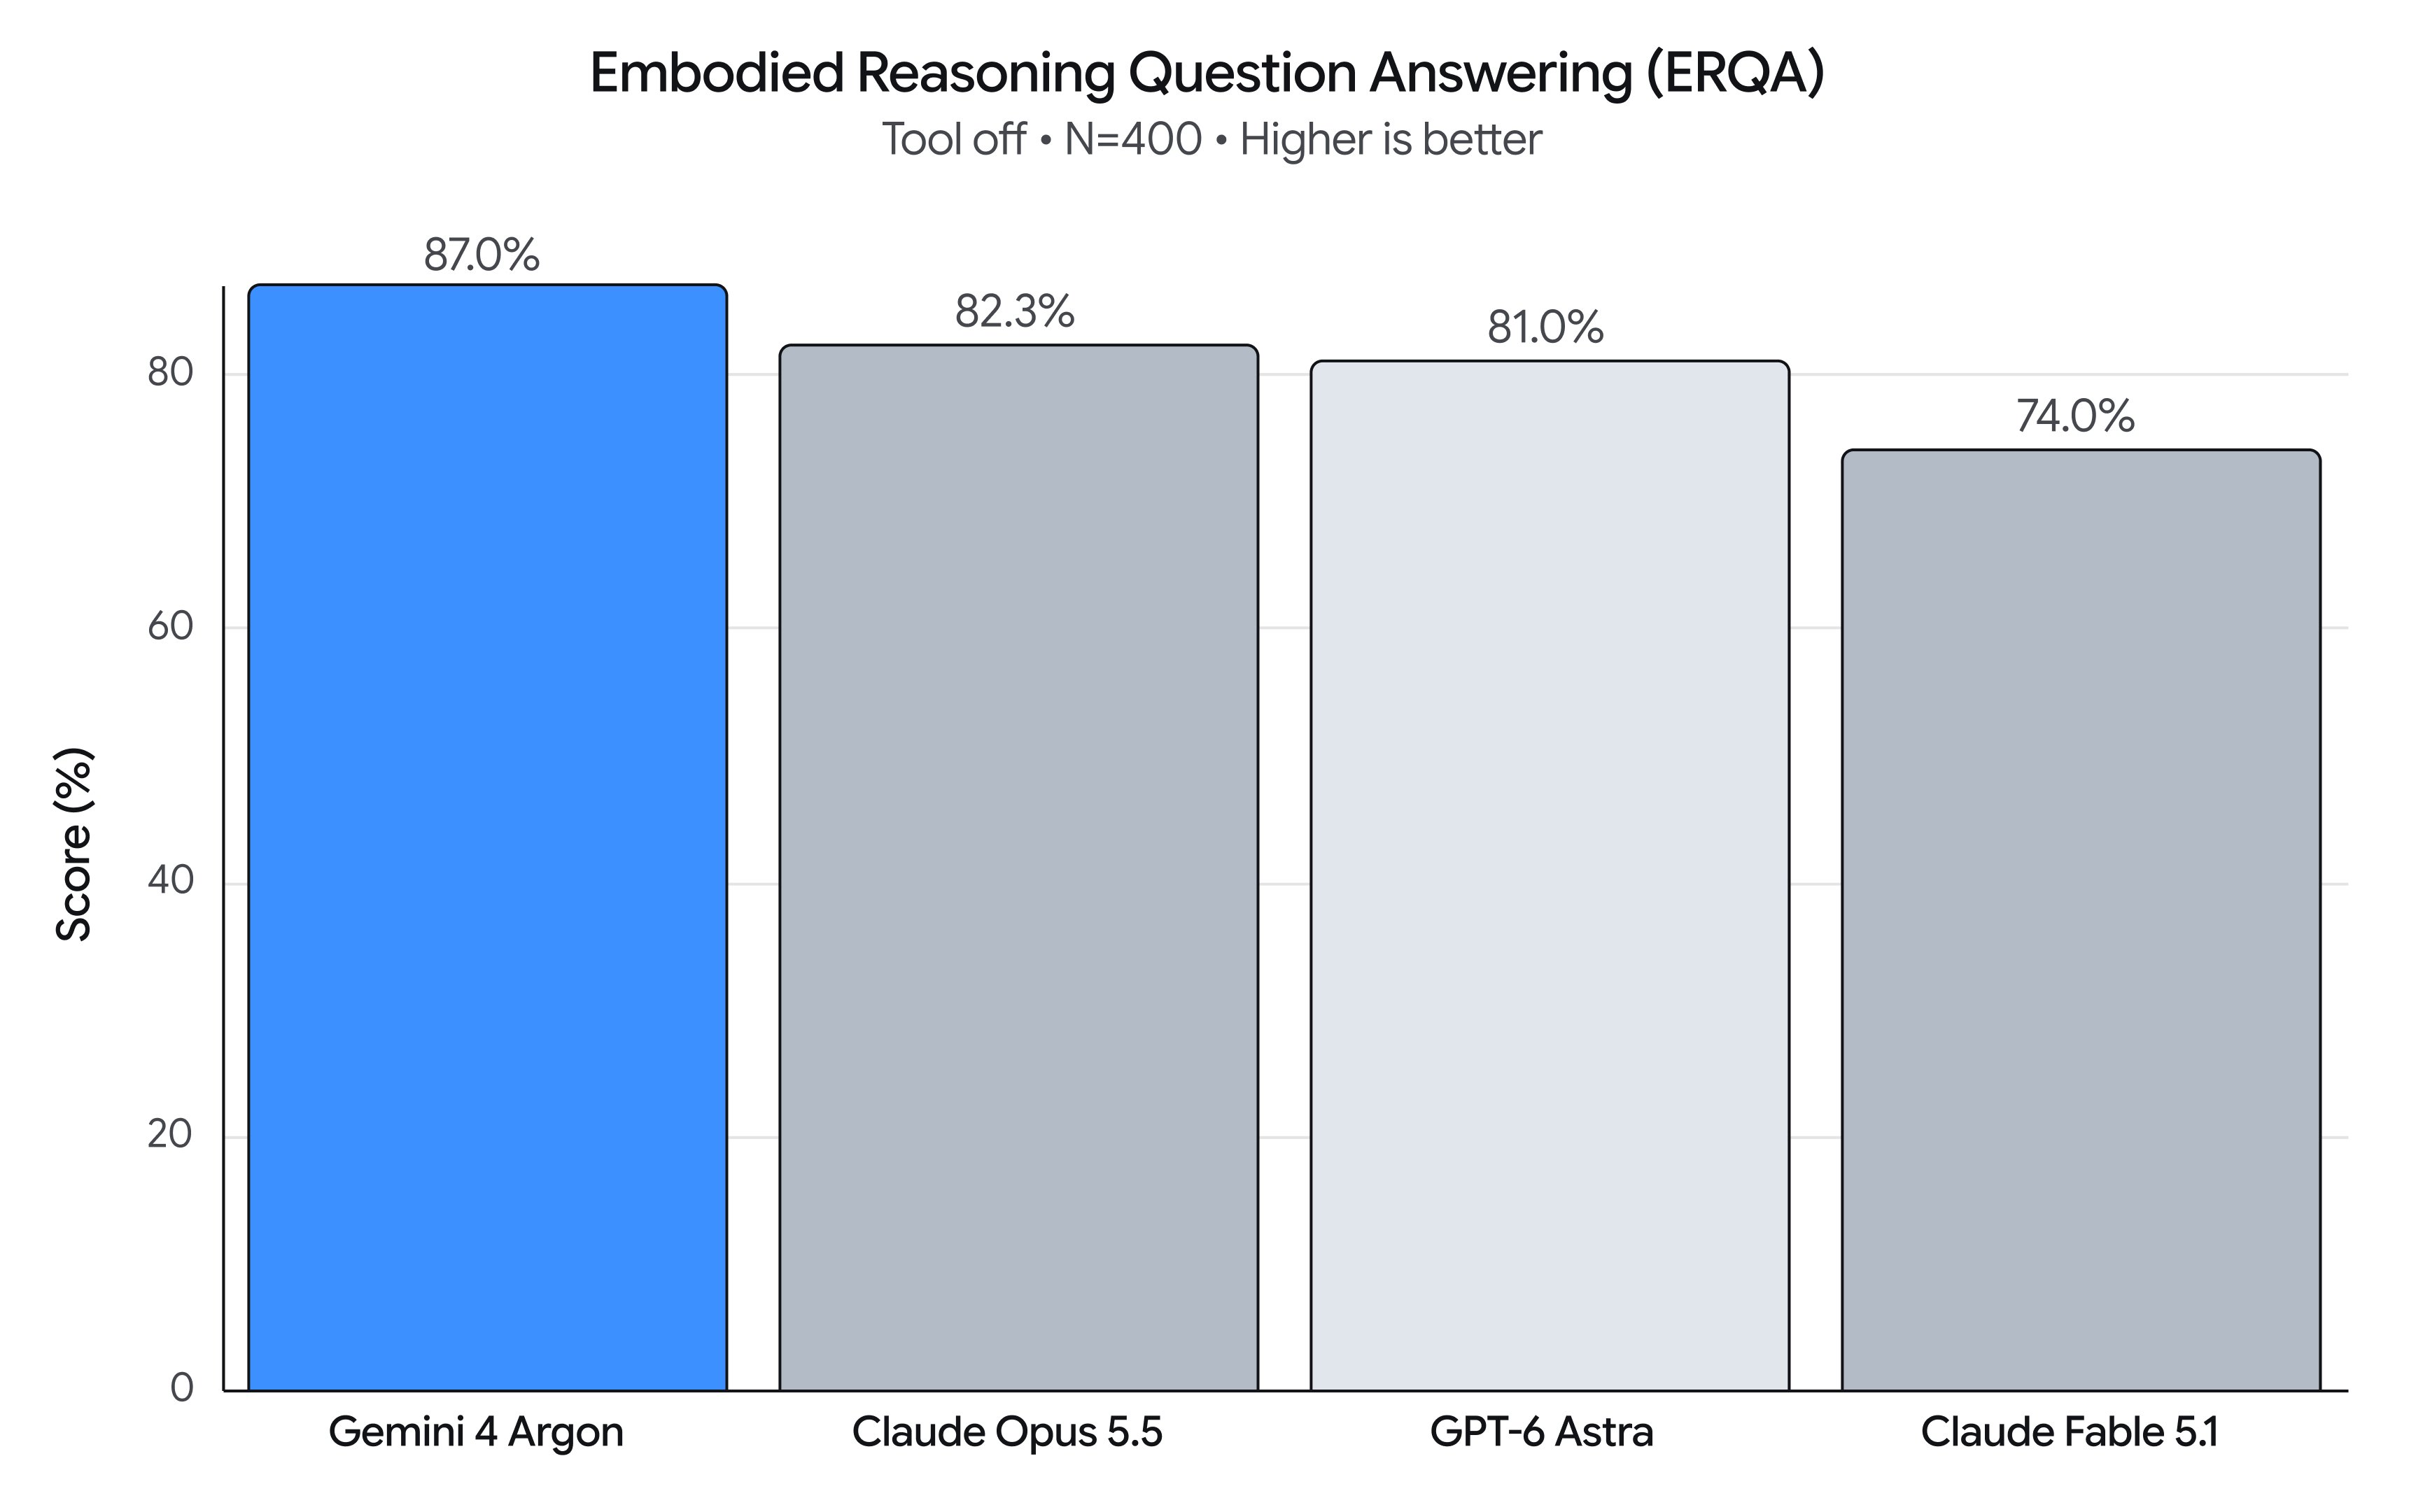
- Argon 在不使用工具的情况下于 ERQA 取得 87.0%,领先 Claude Opus 5.5(82.3%)和 GPT-6 Astra(81.0%);Spot 机器人先在 MuJoCo 中练习,再把易拉罐丢进脚踏式垃圾桶。
- Argon 用一张照片搭建的仿真生成了 4500 多个回合,把真实机器人的成功率从 56% 提升到 75%;该模型可在 AI Studio、Gemini API 付费层级和 Antigravity 中使用。
Google DeepMind 于 10 月 13 日公开了将前沿模型 Gemini 4 Argon 用于机器人开发全流程的应用案例。这篇发布在 Google 开发者博客上的文章,把提示词和结果视频归纳为四个方向:机器人控制、把真实场景转为仿真的 Real2Sim、物理理解,以及研究与自我改进。在衡量模型解决 3D 环境中物理与空间问题能力的具身推理基准 ERQA 上,Argon 不借助工具、仅凭纯推理取得 87%,Google 表示这一成绩超过了所有其他前沿模型。
撰写该文的 Google 首席软件工程师 Kanishka Rao 表示:"Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面实现了阶跃式提升",并称它"为整个机器人技术栈开启新的工作流程,加快迈向物理 AGI 的进程"。Google 公布的 ERQA 图表基于关闭工具条件下的 400 道题。Argon 为 87.0%,Claude Opus 5.5 为 82.3%,GPT-6 Astra 为 81.0%,Claude Fable 5.1 为 74.0%。
最引人注目的案例是 Boston Dynamics 的四足机器人 Spot。腿部 12 个自由度、手臂 6 个自由度的 Spot 学习一项新技能:踩下脚踏式垃圾桶的踏板,把饮料罐扔进去。Argon 先在物理仿真器 MuJoCo 中搭建了包含铰接结构的脚踏式垃圾桶数字孪生,练习三条腿保持平衡的动作,然后才去踩真实的踏板。提示词要求 Spot 在踩下踏板前用前置摄像头确认右前脚位于踏板中央,并由分别负责验证脚和手的两个智能体在松开易拉罐前交叉确认位置。公开的视频中,前置摄像头发现易拉罐离垃圾桶边缘太近,随后手被移向中央。
视频还展示了无需事先训练即可解决陌生任务的零样本控制。Argon 用一台简单的机械臂把倒下的马克杯扶正,并把揉皱的餐巾纸放进杯中。它在腕部摄像头画面上叠加 2 厘米间距的坐标网格,多次调用抓取、放置、移动等动作函数,并根据画面修正下一步动作。在 Google 的视频世界模型 Gemini Omni 中,Argon 操控机器人手,把散落的 5 块拼字游戏字母牌按 A-R-G-O-N 的顺序排好。它没有停留在一条提示词上,而是查看中间生成的画面,重写带时间戳的动作提示词,分 33 步引导视频。
在 Real2Sim 案例中,Argon 观看真实机器人的遥操作记录并构建仿真孪生。它反复调整物体的形状、质量和摩擦,直到 3 台摄像头的画面和指尖触觉传感器数值与真实记录一致。提示词规定机器人指令偏离记录轨迹的幅度在手臂关节不得超过 0.55 弧度、手部关节不得超过 0.65 弧度,并禁止对物体施加外力或关闭碰撞之类的取巧手段。另一个案例把人头戴摄像头拍摄的第一人称视频迁移到 76 自由度的双臂人形机器人上。每只五指手有 22 个自由度,仿真以每秒 500 次的频率计算。仅凭一张钢笔手绘草图,Argon 就生成了人形机器人 Apollo 2 投球击倒按 3-2-1 堆叠的 6 个箱子的场景。Google 表示,Argon 合成了历时 2.80 秒、共 140 步的全身投掷轨迹,在骨盆晃动控制在 3 厘米以内的同时击倒了全部 6 个箱子。
在物理理解领域,Argon 被用作为视频添加事后标注的工具。它接收双臂机器人 ALOHA 2 用一张正方形纸花 136 秒折出狐狸的视频,将其拆分为 1 个总体目标、6 个子任务和 17 个接触级基本动作,并把犹豫和重试的片段标记为在行为克隆中将权重降至 0.15 至 0.25 倍。对于一段人手持夹爪在 60 秒内分拣圆环的视频,它绘制了任务进度曲线,并把轨迹划分为 28 个片段,判断其为推进、停滞或倒退。这正是强化学习中价值函数所承担的角色。经典谜题"在 12 个外观相同的台球中用天平称 3 次找出重量不同的那一个",则由 Argon 连同配有两台 Franka FR3 机械臂的整个仿真环境一起搭建,仅凭摄像头画面完成求解。
用数字体现成果的是研究与自我改进领域。Argon 从一张真实桌面照片出发,搭建了还原 9 件派对道具的 MuJoCo 仿真,定义了包含 77 项任务的课程,并生成了 4500 多个回合。用这些数据微调视觉-语言-动作模型后,真实机器人的成功率从 56% 升至 75%,完成时间从 35 秒缩短到 24 秒。在 6 自由度的小型机械臂 SO-101 上,Argon 一边自我诊断一边重复把乐高积木放进木盒的任务,用时从第 1 轮的 58.9 秒缩短到第 2 轮的 22.9 秒和第 3 轮的 17.4 秒。第 2 轮积木擦到了盒子边缘,第 3 轮则正中落下。Argon 还用一条提示词就把机器人控制论文复现为浏览器版 MuJoCo 实验室,此类案例达到 68 个。
METAL 核实的原文为每个案例都附上了实际使用的完整提示词。文中写明了在仿真中哪些可以调整、哪些不可以,以及在移动真实硬件之前必须经过哪些检查。SO-101 案例的提示词要求在第 1 阶段不移动机器人、只输出计划表,在第 2 阶段用腕部摄像头验证位置,到第 3 阶段才在安全规则范围内直接执行。
METAL 曾报道 Google DeepMind 于 9 月 30 日发布 Gemini 4 Argon 并率先提供给网络防御人员,也介绍过 人形机器人 Apollo 认为厨房家务最难的 DeepMind 视频。如果说两周前的发布聚焦于编码和安全性能,这篇文章则把同一模型定位为机器人开发工具。
从记者的视角看,这次发布值得关注的与其说是 87% 的分数,不如说是发布的形式。Google 没有另外推出机器人专用模型,而是连同提示词一起展示了通用模型编写仿真器、生成训练数据并控制实体机器人的场景。这是在主张用语言模型的编码能力来填补长期被视为机器人开发瓶颈的数据采集和仿真搭建。公开的结果都是 Google 挑选的演示,75% 的成功率也意味着每四次仍有一次失败。
Gemini 4 Argon 面向 Google AI Ultra 订阅用户在 AI Studio 和智能体开发环境 Antigravity 中提供,在 Gemini API 付费层级中则可通过 Interactions API 以 gemini-4-argon 的名称使用。Rao 表示:"我们的目标是通过构建这一核心智能,让机器人能够与人类并肩工作、解决复杂难题。"机器人先在仿真中练习、再自行纠正错误的这些应用案例,能否走出实验室演示、成为现场的标准流程,是接下来要回答的问题。
评论