


이미지: Black Forest Labs
요약
- 블랙포레스트랩스가 7B 규모 오픈웨이트 월드 액션 모델 FLUX 3 Action을 공개했어요.
- 로보랩 성공률 42.92퍼센트로 16B 코스모스 3 나노와 3.3B 파이제로파이브를 모두 앞섰어요.
- GPT-6 아스트라와 붙인 하이브리드는 에피소드 90퍼센트를 풀면서 성공당 비용을 29퍼센트 낮췄어요.
이미지 생성 모델 플럭스로 이름을 알린 블랙포레스트랩스가 9월에 결이 꽤 다른 모델을 내놨어요. 그림을 그리는 모델이 아니라 로봇 팔을 움직이는 모델이에요. 이름은 FLUX 3 Action, 줄여서 F3A고, 파라미터 7B짜리 오픈웨이트 월드 액션 모델이에요. 회사는 가중치만 던져 놓지 않고 사전학습부터 파인튜닝, 추론 최적화까지 정리한 보고서를 같이 공개했어요.
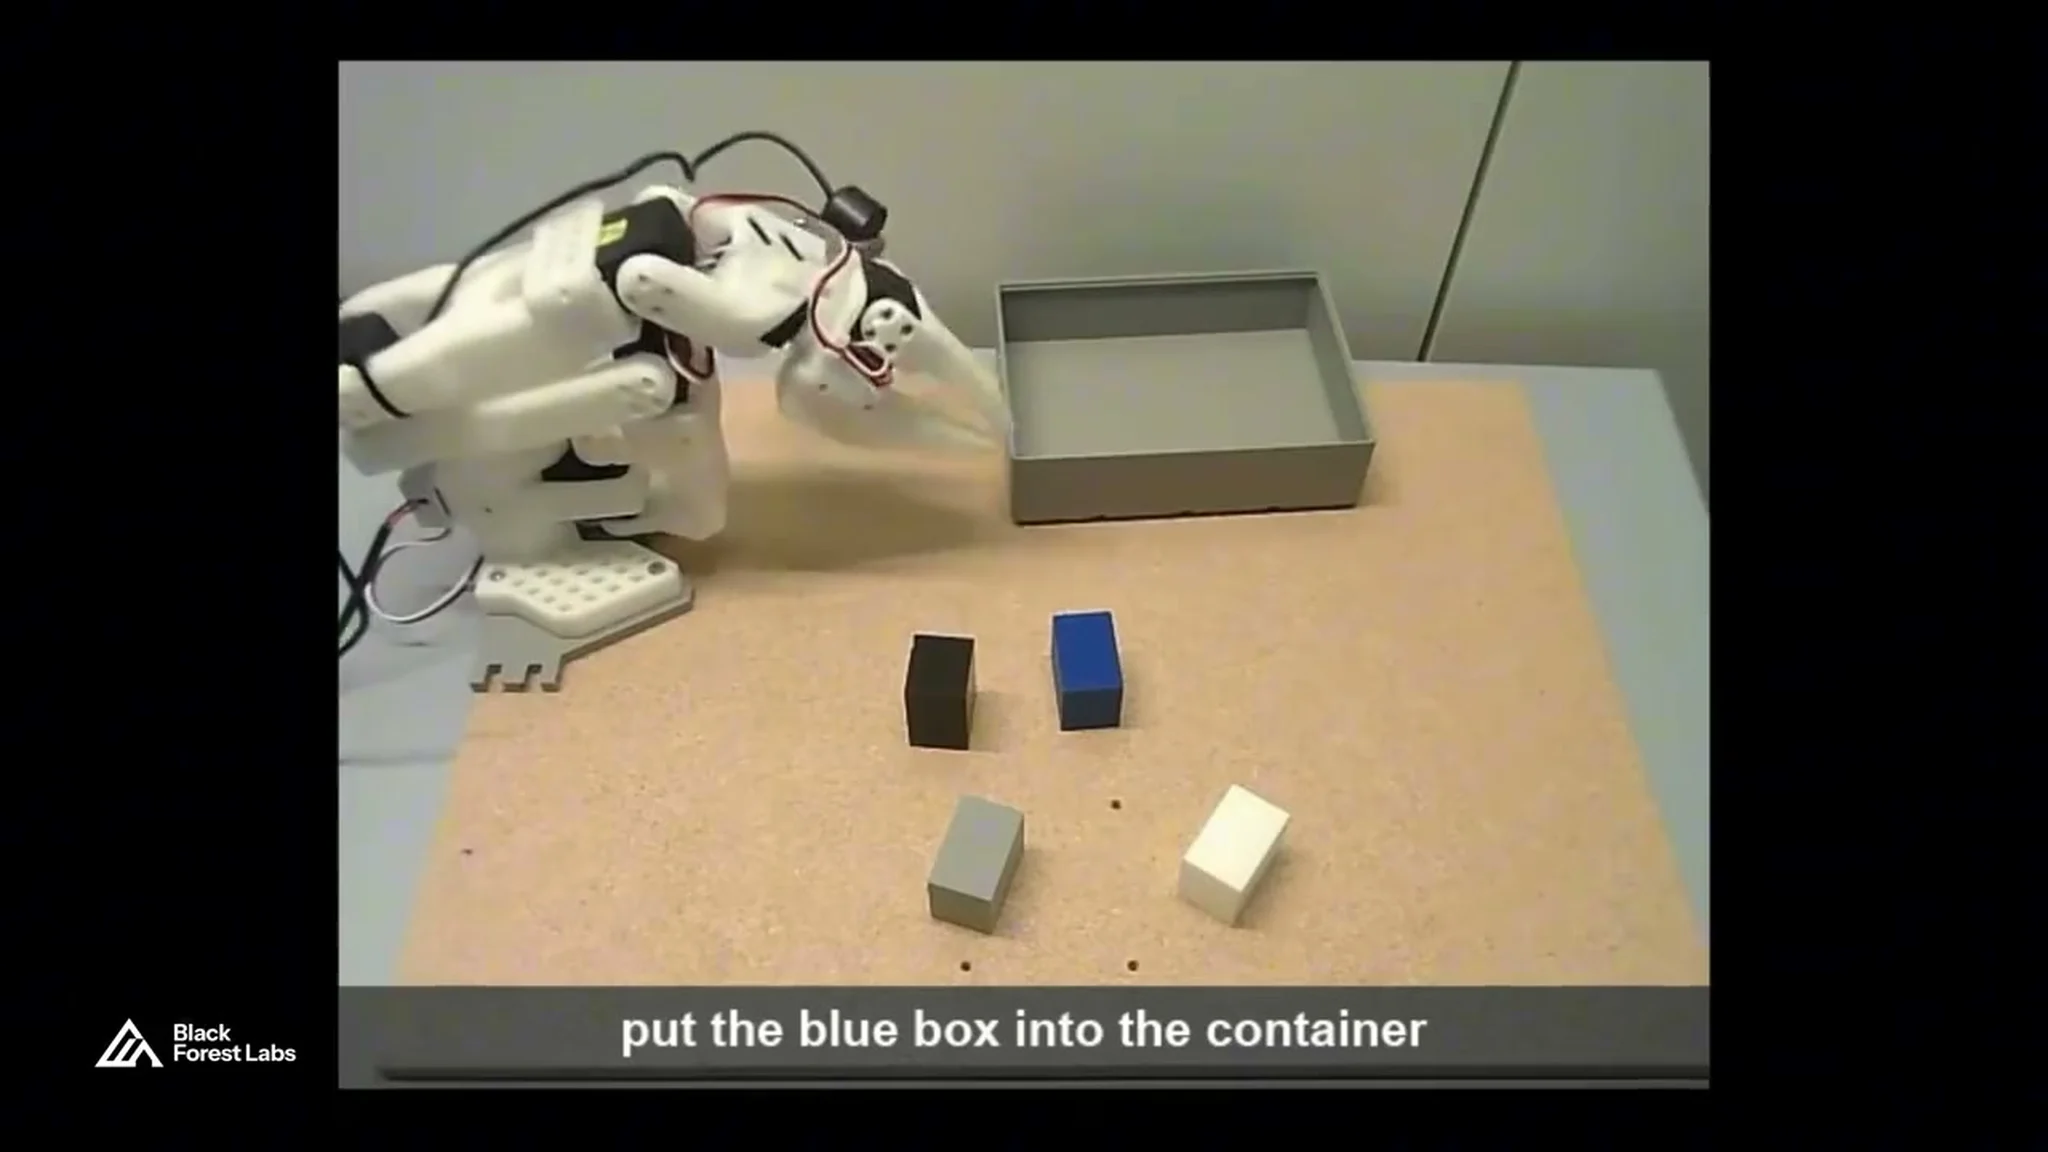
월드 액션 모델이라는 말이 먼저 낯설죠. 작업대에 달린 여러 대의 카메라가 찍는 화면을 보고, 다음 순간의 영상과 로봇의 다음 동작을 한 모델이 동시에 예측하는 방식이에요. 풀어서 설명하면, 월드 액션 모델은 다음에 벌어질 화면과 로봇의 다음 동작을 한 모델이 함께 내놓는 방식이에요. 손을 뻗기 전에 그 장면을 머릿속으로 먼저 그려 보고 움직이는 것과 비슷해요. 영상을 같이 예측하는 덕분에 대량의 영상에서 얻은 세상의 작동 감각이 동작 예측으로 넘어와요.
문제는 그 감각이 공짜가 아니라는 점이었어요. 지금까지 공개된 로봇 정책은 둘 중 하나를 고르게 만들었어요. 영상을 같이 예측하는 월드 액션 모델은 성적이 좋지만 느리고 무겁고, 화면과 말만 보고 바로 동작을 뱉는 비전 언어 액션 모델은 빠르지만 성공률을 크게 내줘요. 운전으로 치면 한쪽은 앞으로 10초를 머릿속에 그려 보고 핸들을 꺾는 운전자고, 다른 쪽은 앞유리만 보고 반사적으로 꺾는 운전자예요. 앞쪽이 더 잘하지만 생각하는 동안 차는 이미 그만큼 지나가 있어요.
숫자로 보면 간극이 분명해요. 엔비디아 코스모스 3 나노는 로보랩 벤치마크에서 36.8퍼센트를 성공하는데 파라미터가 16B예요. 3.3B짜리 파이제로파이브는 28.0퍼센트에 그치고요. B200 GPU에서 FP8으로 돌린 코스모스 3 나노는 로봇 동작 1초를 만드는 데 BF16 파이제로파이브의 약 4.7배 처리 시간을 써요. 잘하는 쪽을 고르면 지연과 하드웨어 비용을 내고, 빠른 쪽을 고르면 성공한 시도 네 번 중 한 번 가까이를 포기하는 구조였어요.
F3A는 그 선택을 없애 버렸어요. 샘플링을 한 번만 하는 7B 체크포인트가 로보랩에서 38.3퍼센트를 기록해 공개된 정책 가운데 가장 높았고, 파이제로파이브보다 작업용과 데이터센터용 GPU에서 1.34배에서 2.28배 빨랐어요. 지연을 조금 양보하면 가이던스 증류 체크포인트가 성공률을 42.2퍼센트까지 올려요. 리더보드 표에 오른 값은 42.92퍼센트로, 16B 모델을 절반도 안 되는 크기로 앞질렀어요. FP8 기준으로는 코스모스 3 나노보다 1.52배에서 3.95배 빨라요. 게다가 한 번에 내다보는 구간이 2.13초로, 1.0초를 보는 파이제로파이브보다 호흡이 두 배 넘게 길어요.
비결은 크게 두 가지예요. 하나는 셀프 플로우라고 부르는 멀티모달 사전학습이에요. 이미지와 영상과 오디오를 섞어 학습하되 토큰의 95퍼센트 이상을 영상이 차지해요. 효과는 대조군이 증명해요. 사전학습 없이 로봇 데이터만으로 학습한 체크포인트는 로보랩에서 1퍼센트도 넘기지 못했는데, 사전학습을 거친 쪽은 11.6퍼센트에서 출발해 12.4퍼센트까지 올라갔어요. 로봇 시연 데이터만으로는 애초에 양이 모자란다는 뜻이에요.
다른 하나는 증류예요. 품질을 올리려고 매 스텝마다 한 번 더 계산하던 가이던스 패스를 학생 모델에 녹여 없애서 1.8배에서 2배를 벌었고, 샘플링 스텝 자체도 하나로 줄였어요. 영상과 동작을 떼어 놓지 않고도 이게 됐다는 점이 중요해요. 기존 해법들은 속도를 얻으려고 둘 사이의 상호작용을 끊거나 GPU를 두 장 쓰는 쪽을 택했거든요.
학습에 들어간 재료도 눈여겨볼 만해요. 동작 정보가 붙은 영상이 전체 학습 샘플의 63.05퍼센트를 차지하는데, 전체 기준으로 게임 녹화가 19.55퍼센트, 손 자세를 표시한 1인칭 영상이 13.54퍼센트, 사람이 손에 들고 쓰는 그리퍼가 14.03퍼센트, 14종 로봇의 원격조작 기록이 15.93퍼센트예요. 나머지 36.95퍼센트는 소리가 딸린 일반 영상이고요. 정작 로봇에서 직접 뽑은 데이터가 전체의 6분의 1 정도라는 뜻이에요.
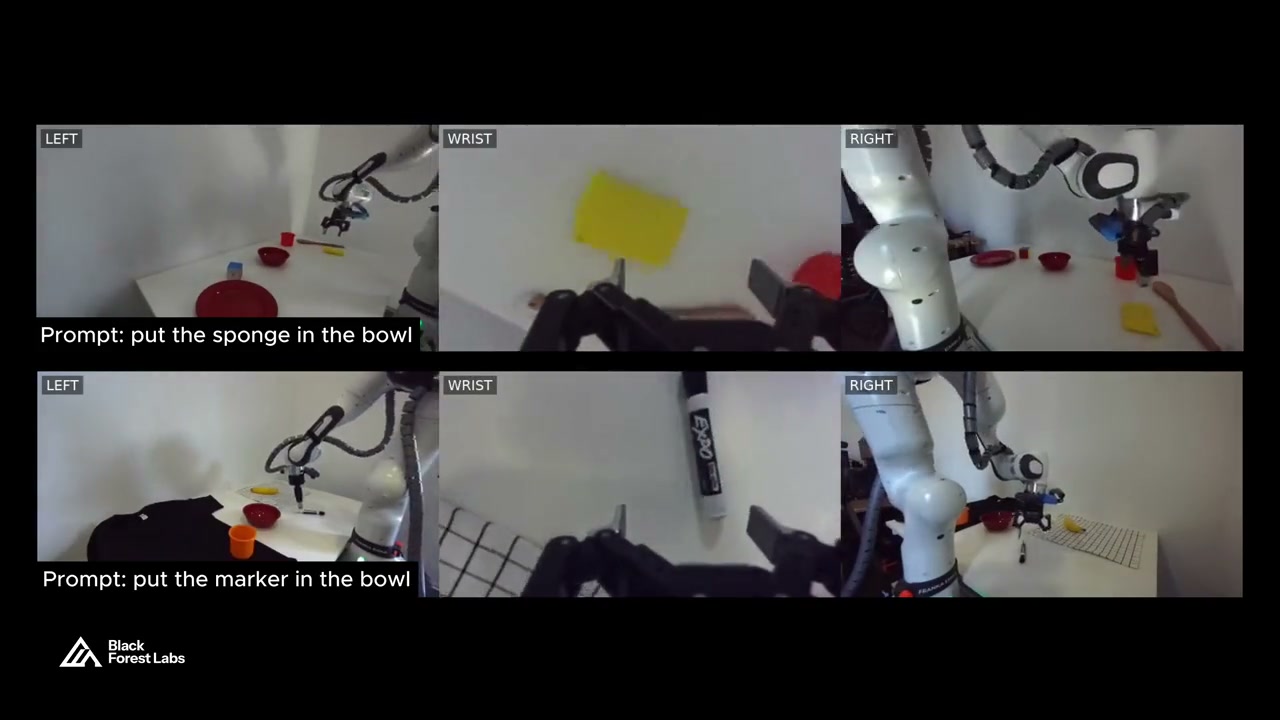
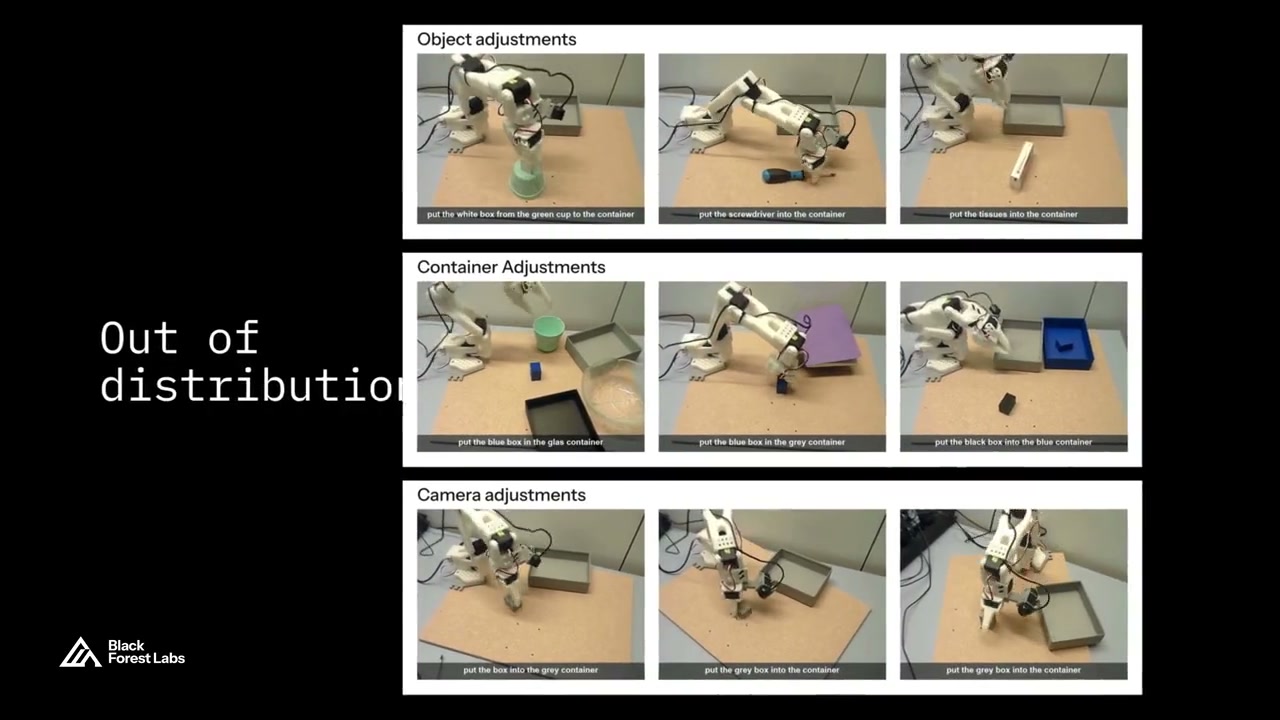
시뮬레이션 성적만으로는 못 믿는 게 로봇 쪽 생리라, 실제 팔로도 검증했어요. 포지트로닉 로보틱스가 자사 실험실의 프랑카 팔에 이 정책을 올려 DROID 과제 10개를 세 번씩 돌렸어요. 모든 모델이 같은 과제, 같은 설정, 시도당 같은 240초를 받았고, 조작자는 어떤 모델이 팔을 움직이는지 모르는 상태였어요. F3A는 30번 시도 중 28번을 끝냈어요. 값싼 SO-101 팔에도 같은 레시피를 적용해서, 물체와 용기와 카메라 위치를 학습 때와 다르게 바꿔도 작업을 이어 갔고요.
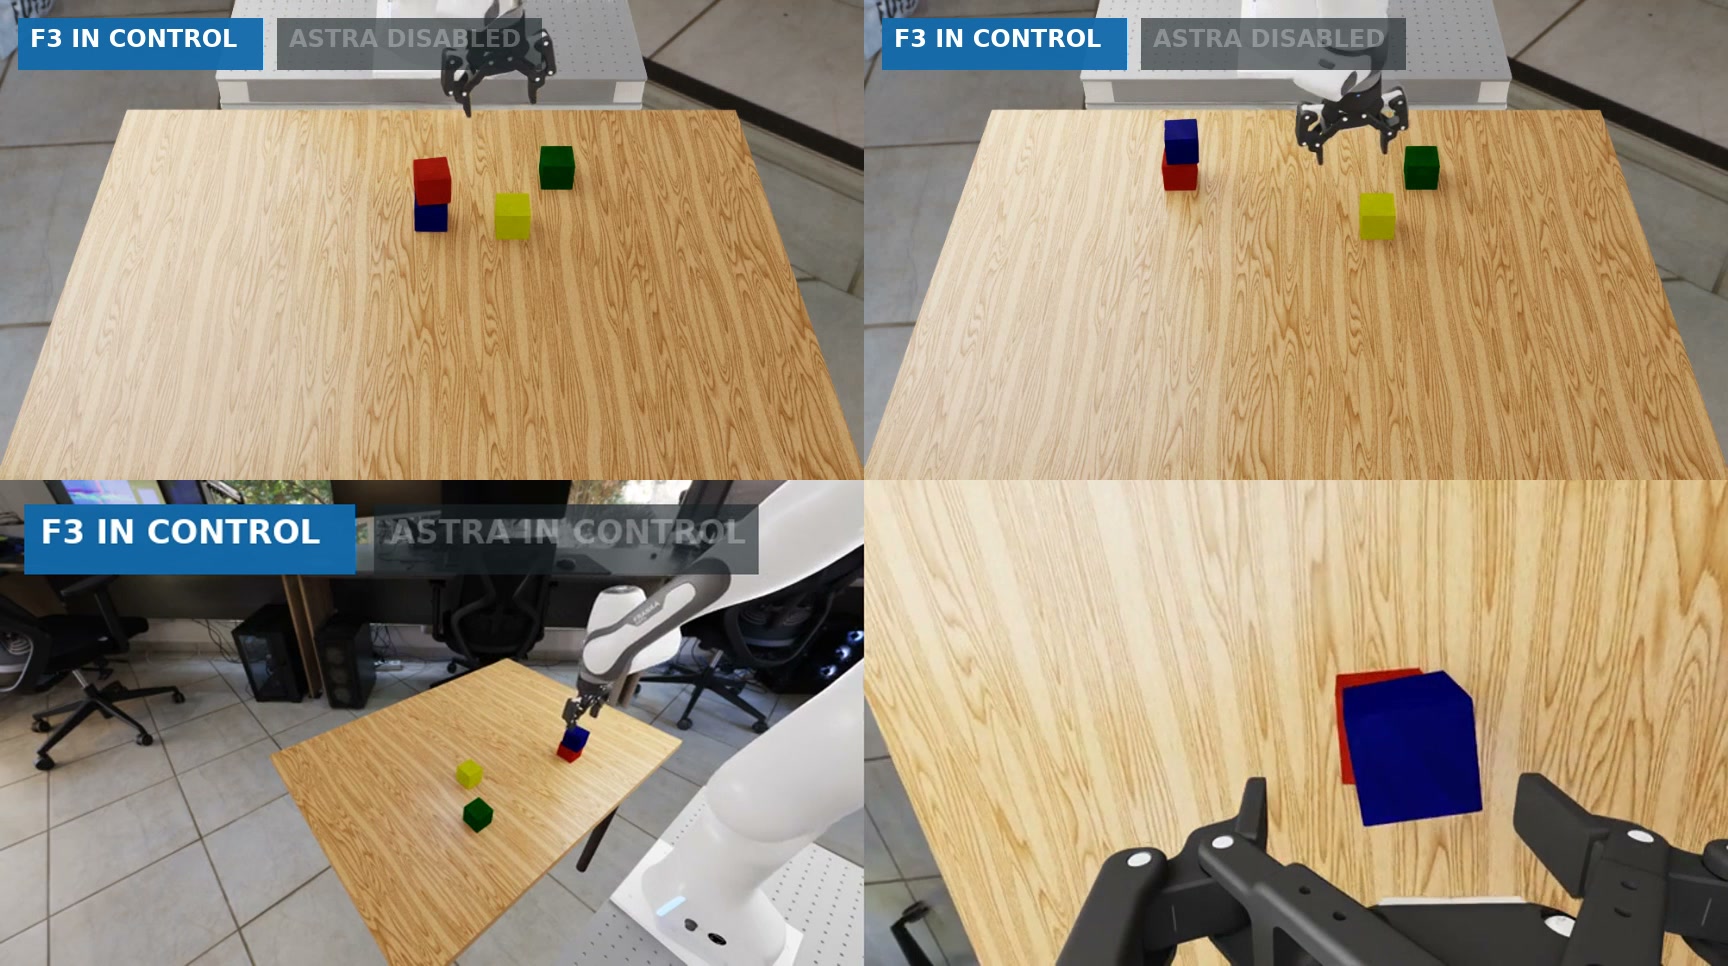
가장 흥미로운 건 추론 모델과 붙여 본 실험이에요. GPT-6 아스트라는 추론을 최대로 쓰면 이 벤치마크의 과제를 전부 풀어요. 대신 호출 한 번이 로봇 동작 1초당 35.77초를 더하고, 성공 한 건에 13.47달러와 평균 16분이 들어요. F3A는 같은 1초를 21.08밀리초에 처리하고, 시간당 3달러짜리 H200 한 장에서 성공당 0.09달러에 2분이 채 안 걸려요. 그 2분의 대부분은 로봇이 움직이는 동안 모델이 놀고 있는 시간이라, 같은 GPU로 롤아웃 47개를 더 돌려도 비용이 그대로예요. 다만 혼자서는 끝내 못 푸는 과제가 남아요.
그래서 아스트라가 평소에는 F3A에 제어를 맡기고 필요할 때만 끼어드는 구조를 짜 봤어요. 매 턴 F3A가 예측을 내면 아스트라가 그중 일부를 실행할지, 한 개에서 다섯 개까지 고칠지, 자기 동작을 제안할지, 멈출지를 고르는 방식이에요. 이 하이브리드는 어떤 액션 정책도 혼자 못 푸는 과제를 포함해 에피소드의 90퍼센트를 해결하면서, 성공당 비용을 8.77달러로, 시간을 8분으로 줄였어요. 같은 구조를 파이제로파이브로 짜면 12.28달러가 나와서 순수 추론의 13.47달러와 별 차이가 없어요. 빠른 정책이 좋아질수록 시스템 전체가 생각을 덜 해도 된다는 뜻이에요.
회사가 게임 데이터를 이만큼 넣은 이유도 보고서 끝에 나와요. 낯선 공간을 목표까지 헤쳐 가거나, 배경에 묻힌 물체를 골라내거나, 다른 행위자가 어떻게 움직일지 예상하고 맞춰 가는 능력은 실제 로봇으로는 안전하게 대량 평가할 수가 없어요. 게임은 그 능력들을 시험하려고 수백만 시간을 들여 설계된 공간인 데다, 병렬로, 실시간보다 빠르게, 아무 위험 없이 돌아가요. 게임을 다루는 에이전트와 사람 대신 소프트웨어를 조작하는 에이전트 사이의 거리는 생각보다 가깝고요.
로봇 모델의 경쟁 축이 크기에서 효율로 옮겨 간 순간이에요. 7B 가중치가 공개돼 있고 소비자용 GPU에서 돌아가는 속도까지 측정돼 나왔으니, 대형 클러스터가 없는 연구실도 같은 출발선에 설 수 있어요. 여기서부터는 누가 더 좋은 파인튜닝 레시피를 찾아내느냐의 싸움이에요.


댓글