


图片:METAL
摘要
- Liquid AI 发布了面向视觉语言模型 LFM2.5-VL-3B 的实验性草稿模型 LFM2.5-VL-3B-DSpark。
- 解码速度在 M5 Max 上最高提升 3.13 倍,在 H100 上最高提升 2.66 倍,而草稿模型只增加 8.9% 的参数。
- 视觉编码和预填充阶段不会被加速,因此端到端提升最高为 2.62 倍和 2.27 倍。
Liquid AI 发布了可挂接在其视觉语言模型 LFM2.5-VL-3B 上的实验性草稿模型 LFM2.5-VL-3B-DSpark。挂上这款视觉模型用草稿模型后,负责逐字生成文本的解码阶段,在单张英伟达 H100 上最高提速 2.66 倍,在苹果 M5 Max MacBook Pro 上最高提速 3.13 倍。若按从提交问题到拿到完整答案的端到端速度计算,分别最高提升 2.27 倍和 2.62 倍。公司表示,输出与原模型单独生成的结果相同。
其原理是推测解码。小型草稿模型预先提出接下来的若干个词元,主模型在一次计算中统一验证。被接受的词元直接采用,从第一个不一致的位置起由主模型重新生成。Liquid AI 在 8 月推出了面向文本模型的 LFM2.5-DSpark,这次把同样的方法扩展到能读图的模型上。
Liquid AI 解释了处理图像也无需更换方法的原因。草稿模型从主模型固定的几层中提取隐藏状态,据此提出下一组词元。图像切片和文本词元在到达这些层之前,已被转换为同样维度的向量。公司在官方博客中写道:"从草稿模型的角度看,输入是文本还是图像并不重要",因此可以直接沿用与文本模型完全相同的推理算法。
草稿模型共有 2.795 亿参数,在 30 亿参数级的主模型之上只增加 8.9%。其中 4 层解码器占 1.93 亿,隐藏状态投影占 2,100 万,马尔可夫头占 6,550 万。团队比较了 3、4、5 层后选定 4 层,训练时一次提出的词元块大小为 9。训练使用混合的视觉语言监督微调数据,共跑了 10 个轮次,公司表示所有消融实验和训练都只在 AMD 硬件上完成。
性能按照 MMSpec 基准在 6 类任务上测量:通用视觉问答、文字视觉问答、图像描述、图表问答、复杂推理和多轮对话。测试条件为批大小 1、温度 0、最多输出 2,048 个词元,答案长度中位数为 90 个词元。在 MacBook 的 MLX 上,各任务解码提速 2.30 到 3.13 倍,端到端提速 1.56 到 2.62 倍。在 M3 Ultra 的 llama.cpp 上,解码提升 1.57 到 2.14 倍,端到端提升 1.30 到 1.77 倍。在 H100 的 SGLang 上,解码提升 2.04 到 2.66 倍,端到端提升 1.64 到 2.27 倍,主模型每次验证平均接受 3.46 到 4.57 个草稿词元。
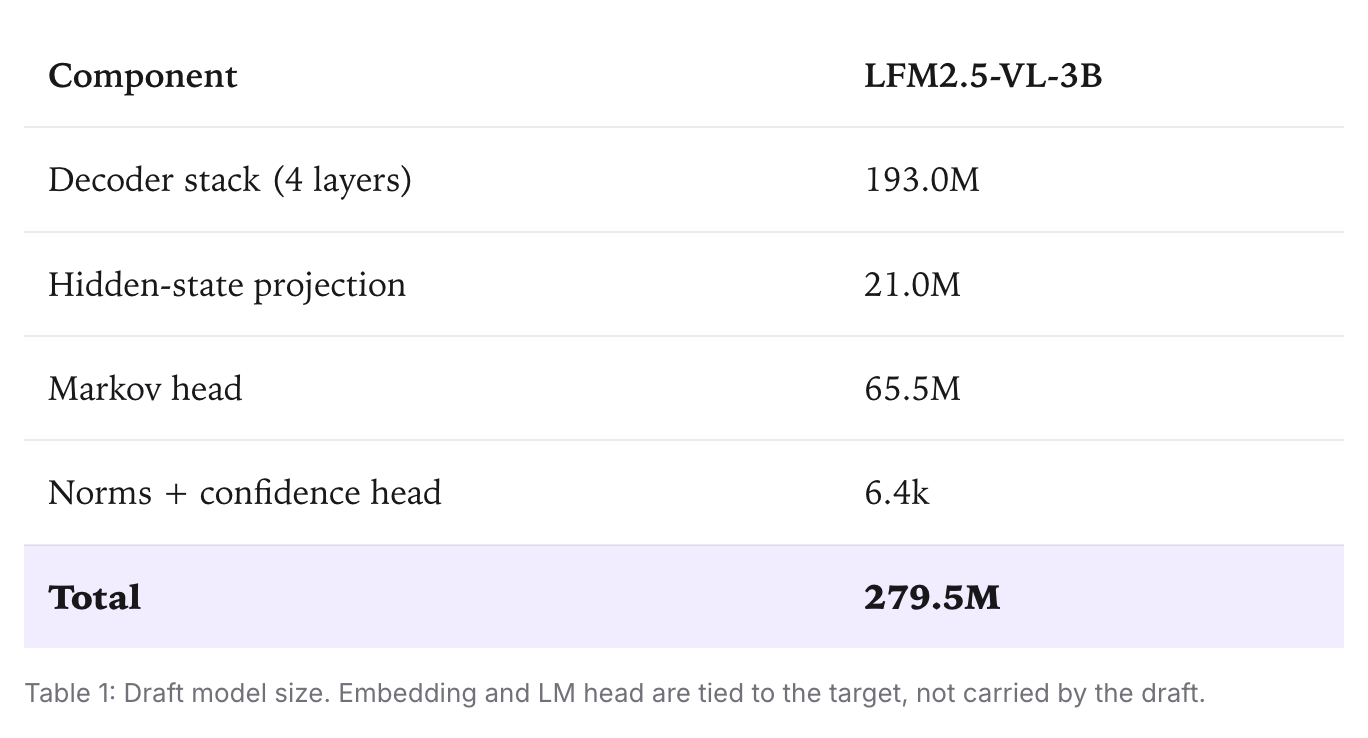
不同任务之间差异明显。模型卡表格显示,提速最大的是 COCO 图像描述任务:M5 Max 上解码 3.13 倍,H100 上 2.66 倍。多轮对话任务最低,H100 上为 2.04 倍,M3 Ultra 上为 1.57 倍。公司分析认为,草稿的命中程度取决于草稿模型和任务类型,而不是硬件或运行环境。
解码提速总是大于端到端提速,背后有结构性原因。视觉语言模型要先让图像通过视觉编码器,再由语言主干在预填充阶段同时读取数百个视觉词元和文本。推测解码无法缩短这一阶段。在算力远弱于数据中心 GPU 的设备上,这一阶段占总时间的比例更高。Liquid AI 用阿姆达尔定律解释了这一点,称"当这些阶段已占去相当一部分总耗时,即便解码大幅加速,端到端延迟也只能得到温和的改善"。
运行条件同样影响速度。提高温度会让概率分散到排名较低的候选词元上,草稿与主模型更容易出现分歧,接受率和吞吐量随之下降。在提高并发的测试中,DSpark 在所有测量区间都保持了吞吐优势,但差距逐渐缩小。本次所有数据均基于 16 位运算,量化模型的加速不在此次发布范围内。
根据 METAL 核实的 Hugging Face 模型卡,该草稿模型以 Safetensors 和 GGUF 格式发布,首日即可在 llama.cpp、MLX-VLM 和 SGLang 中运行。SGLang 需要 v0.5.19 或更高版本,MLX-VLM 需要 v0.7.2 或更高版本。测量使用的是 Liquid AI 汇集公开设备性能数据时所用的基准测试基础设施 Pipette。METAL 此前曾报道 Liquid AI 借助 DSpark 草稿模型把文本模型解码最高提速 3.18 倍。
从工程师的角度看,这次发布的价值在于视觉模型也能只多花一点内存,就更快地给出同样的答案。这种方式无需重新训练主模型,只在旁边挂一个小模型,已经在用 LFM2.5-VL-3B 的服务改几行启动参数就能试用。不过,如果是在设备上针对单张图片给出简短回答的任务,设计阶段就要考虑到,决定体感速度的更多是图像编码和预填充,而非解码。


评论