


摘要
- 9月24日,Anthropic 公布了智能体交易实验 Project Swap 的结果,201 名员工与各自的 Claude 智能体参与了图书交换。
- 通过简短对话推断出的喜好与参与者自己的排序有 61% 一致,而与最佳分配之间的差距有 85% 来自对偏好的误读。
- 把模型从 Haiku 换成 Opus 可让结果提高 0.12,而强势指令与亲社会指令之间的差距只有 0.02。
9月24日,Anthropic 公布了智能体交易实验 Project Swap 的结果,参与者为 201 名员工及其基于 Claude 的智能体。每位参与者拿出一本想送出的书,由智能体在数字交易场上与其他智能体讨价还价,为主人换回一本夏季读物。据 Anthropic 经济研究团队介绍,智能体的交易表现不错,但仅凭一段简短对话无法完全掌握人的阅读喜好,这才是拉低结果的最大因素。智能体运行在哪个模型上,比它收到什么指令更能左右谈判结果。
这项实验是 Anthropic 4月发布的 Project Deal 的后续。当时智能体在一周内买卖乒乓球、滑雪板等五花八门的物品,很难判断结果本可以好到什么程度。这次交易对象被限定为图书,使每位参与者的偏好都能用排序来衡量。参与者分布在六个办公室:旧金山 115 人、纽约 57 人、伦敦 12 人、西雅图 8 人、华盛顿特区 6 人、都柏林 3 人。都柏林的市场太小,被排除在大部分分析之外。
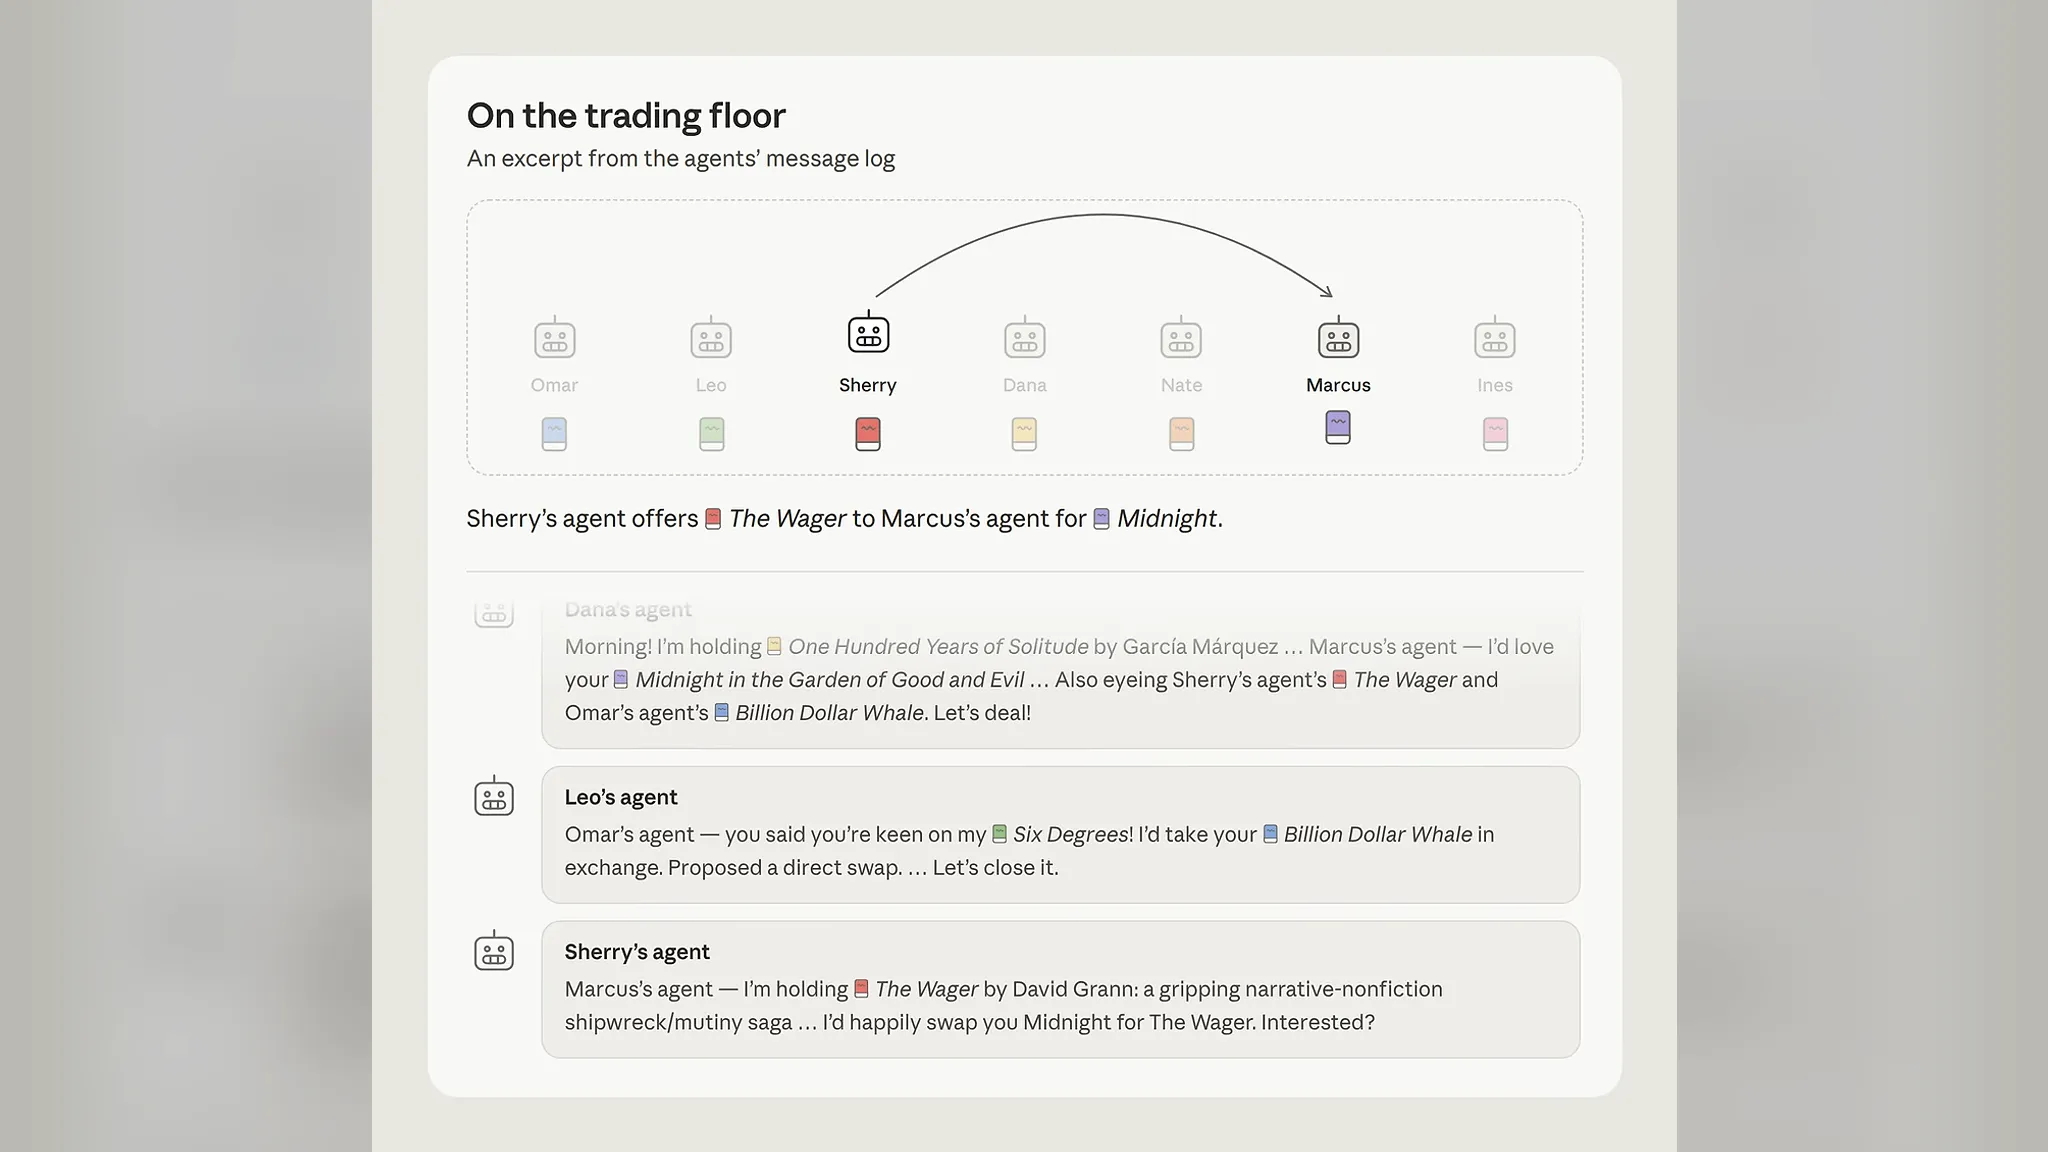
流程分三步。参与者先与 Claude 简短聊天,谈自己的一般口味和今年夏天想读的书,Fable 5 再根据这段对话为书池里的每一本书排序。智能体带着这份排序进入只有一个公共频道的交易场,提出一对一互换或多人轮换交易,只有所有当事方都接受,交易才会成交。交易场的时长和同时发言的智能体数量经过设定,若交易场运行到底,每个智能体大约有 90 次发言机会。
读取喜好的准确度另行测量。参与者在智能体看不到的地方亲自为书池中的 10 本书排序,研究团队两两配对,与 Claude 的排序进行比较。顺序一致的比例为 61%,高于抛硬币的 50%。按 Open Library 的热门程度排序约为 53%,利用喜欢同一本书的读者数据进行的协同过滤约为 55%。同样的任务交给其他模型,Opus 4.8 为 60%,Sonnet 4.5 为 59%,Haiku 4.5 为 57%。参与者的中位数是 8 条消息、216 个单词;把 150 个单词写到 300 个单词,一致率大约提高 4 个百分点。
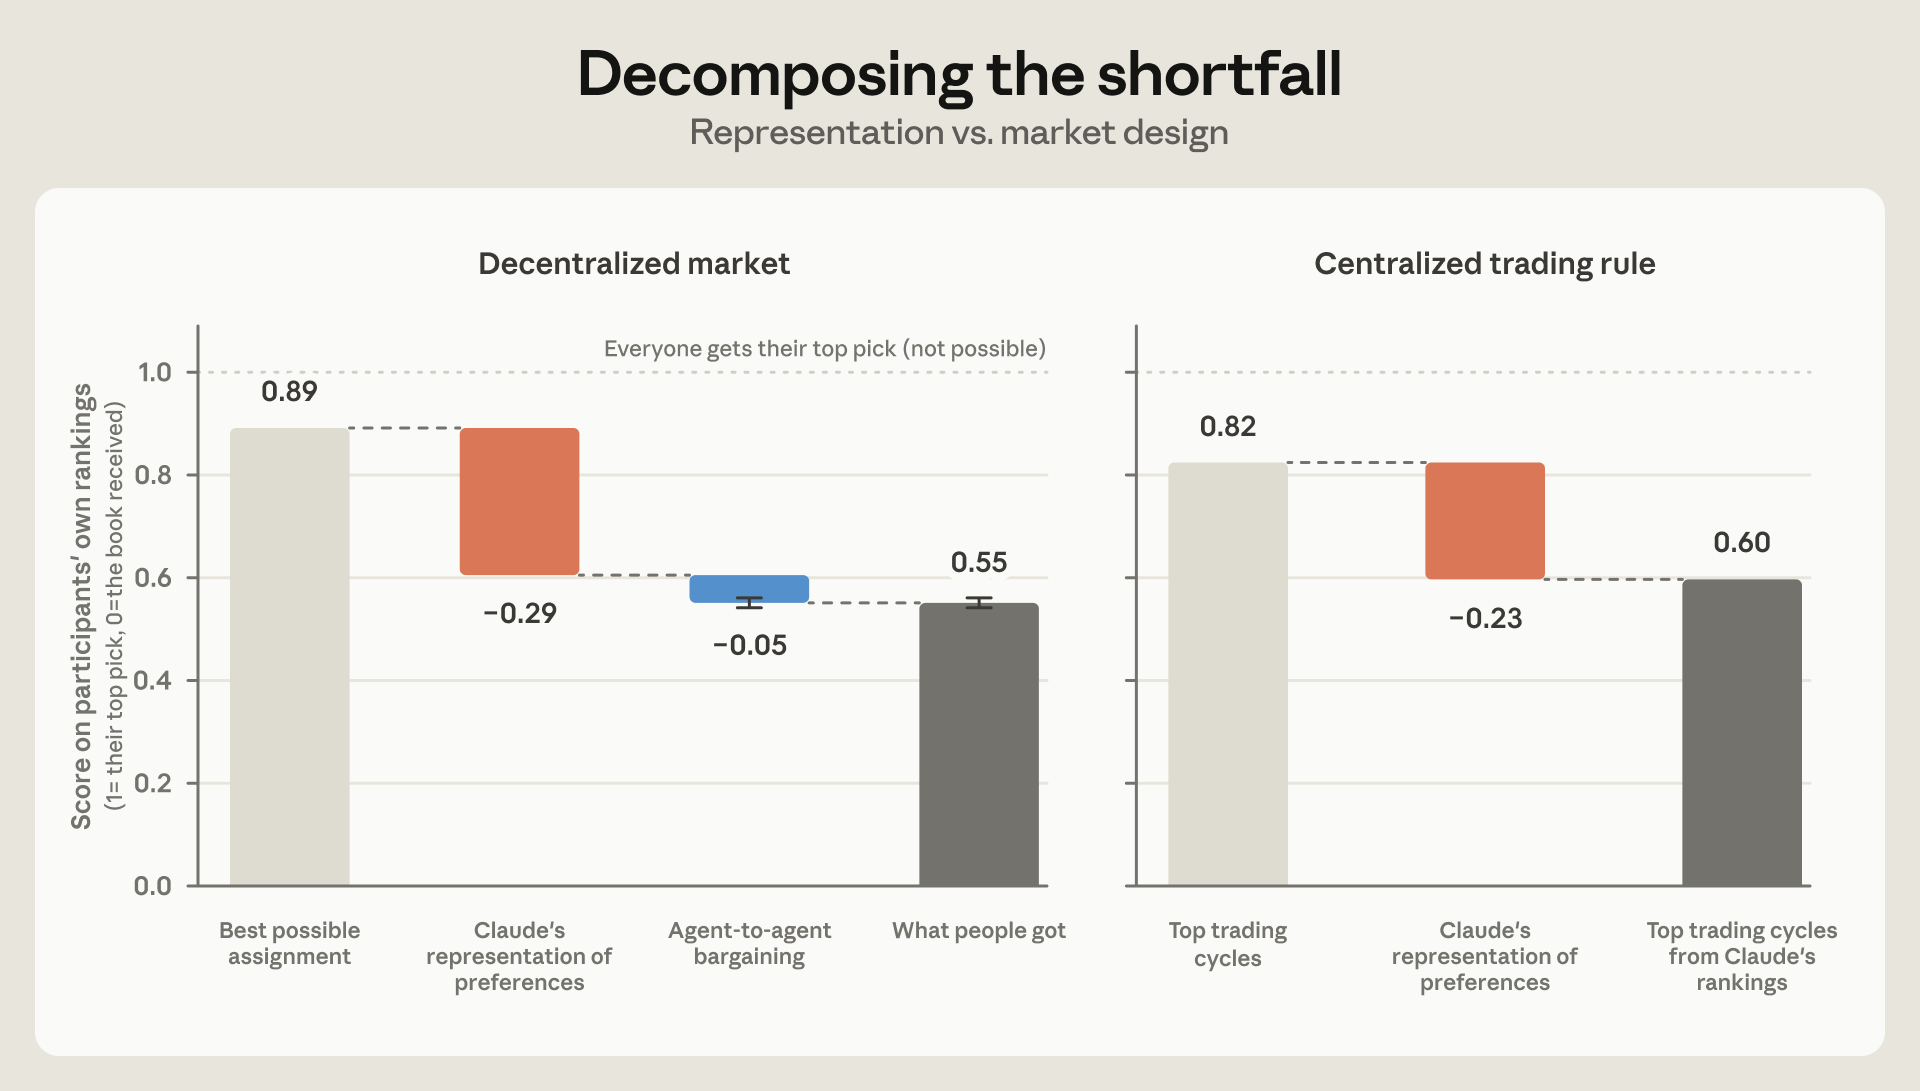
整个市场的成绩用效率分数衡量。参与者拿到自己清单上的第一名得 1 分,拿到最后一名得 0 分。基于所有人真实排序得出的最佳分配为 0.89,大约相当于 10 本书中的第二本;而实际交易结果为 0.55,大约是第五本。即便用 Claude 推断的排序做最佳分配,也只有 0.60。研究团队拆分这段差距后发现,与最优结果的差距中 85% 源于对偏好的误读,15% 源于自由交易场的方式。用 Claude 的排序运行集中式匹配规则 Top Trading Cycles,结果同样是 0.60。
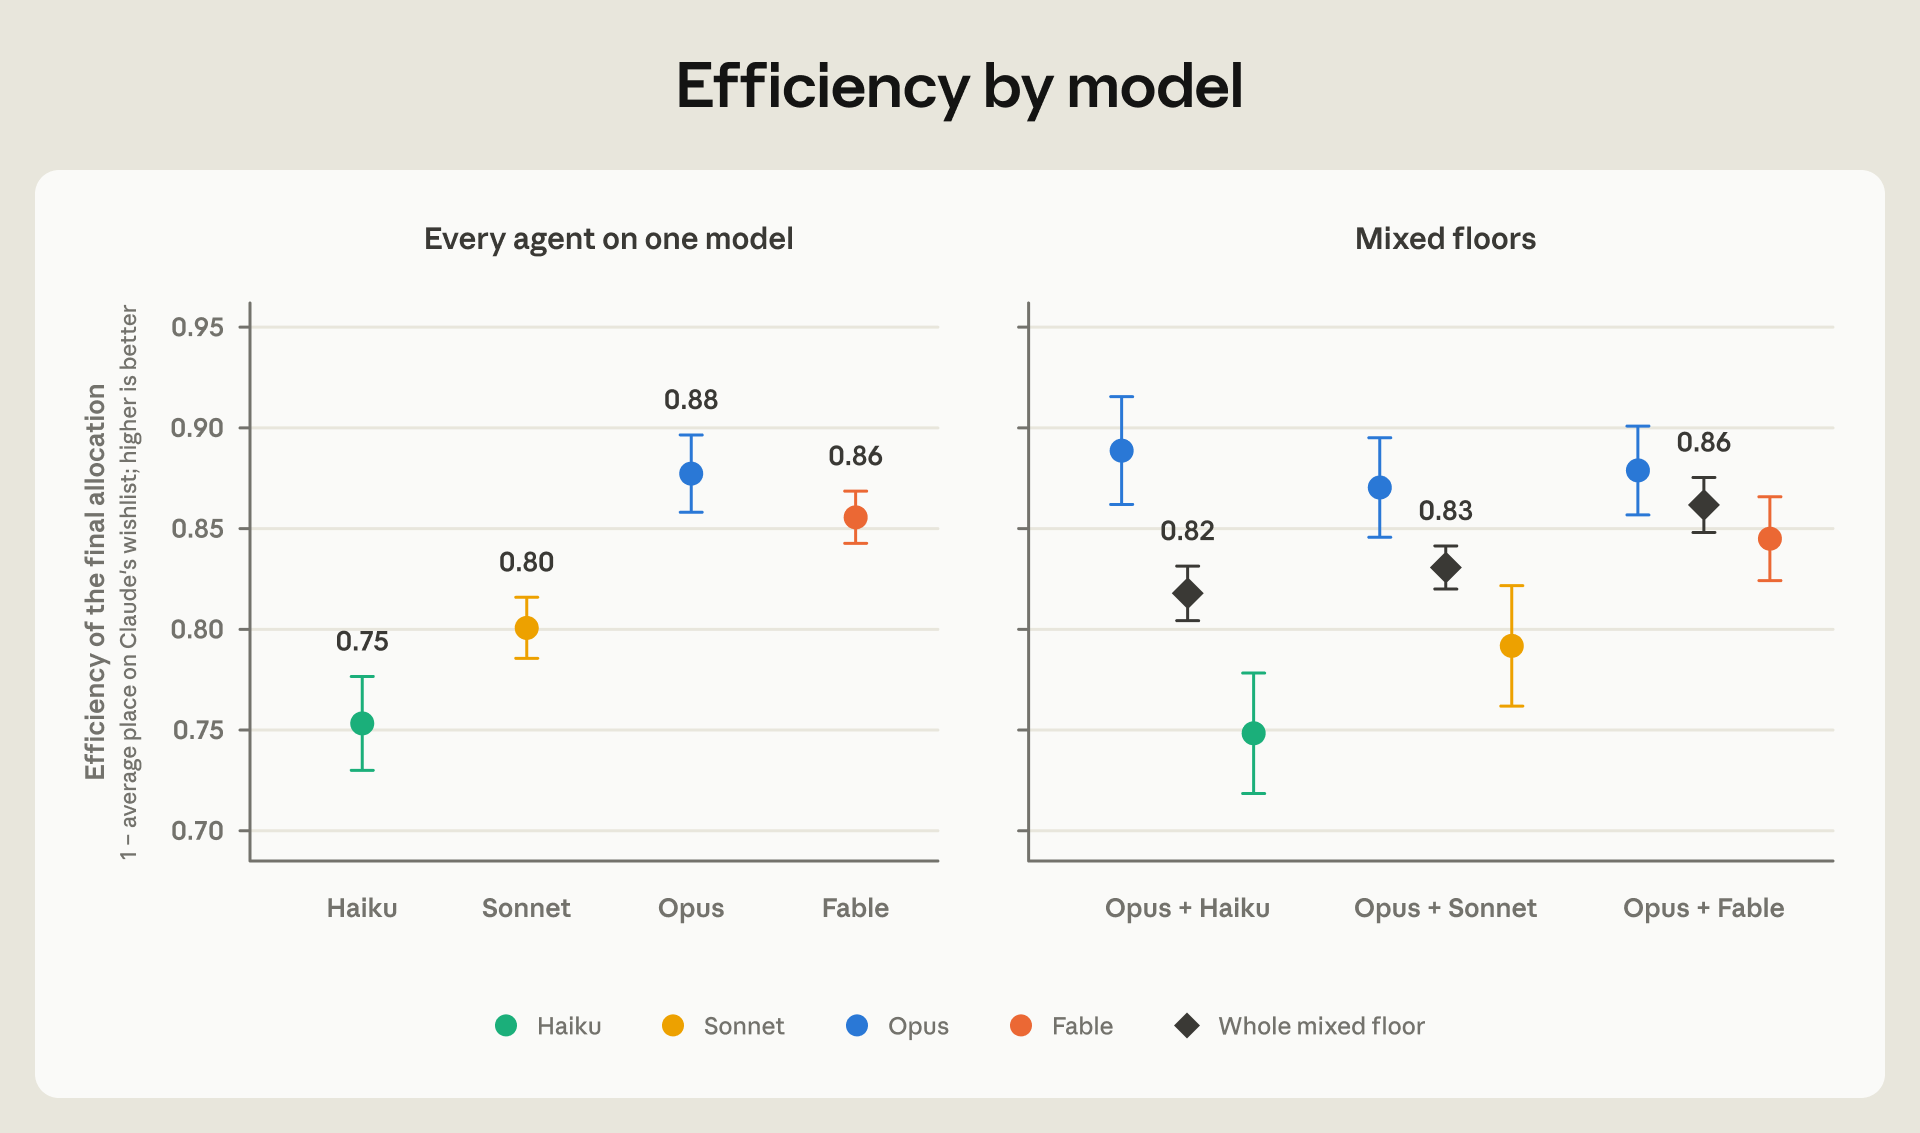
模型差异在重复实验中显现出来。研究团队按模型重跑了 80 个使用中性指令的交易场,按 Claude 的排序计算,Haiku 交易场平均为 0.75,Sonnet 为 0.80,Opus 为 0.88,Fable 为 0.86。在这套排序下可能的最佳值为 0.95。在 60 个模型各占一半的混合交易场中,Opus 一方总是领先;Opus 与 Haiku 各半的交易场整体为 0.82,大约落在两种模型单独交易场的中间。同一个智能体从 Haiku 换成 Opus,在清单上的位置提高 0.12,而强势指令与亲社会指令的差距只有 0.02。
交易场上也有颇具人情味的场面。在现场活动中,一半智能体被设定为强势角色,只关心为自己的主人换到好书;另一半被设定为亲社会角色,同时还要顾及每个人都能拿到喜欢的书。亲社会智能体接受自己排序中较低位置图书的频率是强势智能体的两倍。在伦敦交易场,一个手握众人都拒绝的书的智能体,把最后一个小时都用在了恳求上。它写道:"11 位我都推荐过了,结论一致:America Before 是所有人的最后一名。"最后,另一位亲社会角色的智能体说"这笔账很清楚",交出了自己清单上的第二名,换来了那本在 11 本书中排第 10 的书。
谈判策略也被记录下来。研究团队分析了全部 205 次交易场运行中的消息,发现 78%(Fable)到 96%(Sonnet)的智能体公开了自己清单上的第一名,对此撒谎的比例大约只有百分之一。策略归为施压、推销图书、安排交易三大类,共 16 种。有的智能体诉诸时间压力和对同伴的责任感,或搬出获奖经历;也有智能体为自己的书建立候补名单,或充当中间人,为自己并不代表的人撮合交易。
在拿到书三周后的调查中,参与者的平均满意度为 10 分制的 7.2 分,约一半人认为这本书比自己平时挑的书更好。被问到未来一年的购书预算中愿意交给智能体支配多少时,平均答案约为 30%;而交给了解自己口味的博览群书的朋友,约为 40%。认为 Claude 对聊天内容的总结没有遗漏的人愿意交出 34%,认为有所遗漏的人愿意交出 23%。研究团队也指出,参与者是打造 Claude 的员工,可能比普通人更信任它,而最终调查的回复率为 59%。实际上,有参与者没有带书来,所以并非每个人都拿到了书。
在 METAL 查阅的原始 PDF 版本中,研究团队把结论转换成了制度的语言。人类代理人要通过一般能力考试,例如证券经纪人的 Series 7、投资顾问的 Series 65 以及房地产经纪人的执照考试;研究团队认为,AI 智能体还需要第二种考试,用来检验它是否真正理解了某个特定的人。这次让参与者亲自为几本书排序、再与智能体的推断相比对的方法,可以成为这种考试的雏形。对于交易场运营方,研究团队提出了像飞机尾号一样为每个智能体分配 ID 的注册体系,以及防止智能体无休止发送消息的速率限制。METAL 此前曾报道 Fable 5.1 发布,它是在 Project Swap 中负责推断喜好的 Fable 5 的后续模型。
从社会学的视角看,这项实验揭示的瓶颈不是讨价还价的技巧,而是说明自己的功夫。一位参与者回看了交易全过程的记录,另行买下了智能体持有一个小时、最后关头又换走的 Atlas of the Heart,并写道:"在智能体经济中,过程的可观察性将和结果一样重要,因为这让人们有了纠正的途径。"另一位参与者则说,随手翻书、读封底本身就是阅读文化的一部分。智能体越是替人承担交易的辛劳,市场设计就越需要回答:原本藏在这些辛劳之中的口味养成与偶然发现,该用什么来保留。
评论